Sekiz sayfalık bir XLSX paketini sekiz çalışan iş parçacığında ayrıştıran bir Delphi yükleyicisi, tek çekirdeğin pek üstüne çıkmayan bir CPU grafiği gösterebilir; iş parçacığı sayısını ikiden sekize taradığınızda kronometre neredeyse yerinden kıpırdamaz. İki iş parçacığıyla yükleme düz bir seri döngüden bile yavaş çıkabilir. Ayrıştırma kodu kendi başına kilit almaz, sayfalar da veri paylaşmaz; bekleme kaynak kodda hiç geçmeyen bir yerde olur: her çalışanın her eleman adı, öznitelik değeri ve hücre için çağırdığı bellek yöneticisinin içinde
İş parçacığı sayısı herkesin önce uzandığı düğmedir. Tahsise bağlı kodda neredeyse hiçbir şeyi oynatmaz. Eğriyi oynatan, her hücrenin kaça mal olduğudur: hücre başına yığın tahsisi sayısı
HotXLS Open işlemini üç aşamaya nasıl böler
HotXLS, çok sayfalı bir XLSX paketinin çalışma sayfalarını varsayılan olarak çalışan iş parçacıklarında ayrıştırır. TXLSXWorkbook.ParallelParse True ile başlar, ParallelParseThreads ise 0 ile; bu, işletim sisteminin bildirdiği her mantıksal işlemci başına bir çalışan demektir ve çalışan sayısı hiçbir zaman ayrıştırılacak sayfa sayısını aşmaz. Open'ın üç aşamasından yalnızca biri o çalışanlarda koşar. Aşama A seridir: çalışma kitabı parçasını, paylaşılan dizeleri ve stilleri okur, her sayfayı adı ve görünürlüğüyle oluşturur ve her sayfanın ilişkiler dosyasını ayrıştırır; böylece köprü ve tablo hedefleri daha o anda çözülmüş olur. Bir çalışan işe başladığında danıştığı her arama tablosu tamamlanmıştır ve yalnızca okunur
Aşama B her çalışma sayfasını bir çalışana verir. Çalışanlar sayfa indekslerini paylaşılan bir sayaçtan interlocked artırımla alır; böylece bir büyük ve yedi küçük sayfalı bir çalışma kitabı zamanlayıcı olmadan kendi kendine dengelenir: küçük bir sayfayı bitiren, sıradaki indeksi alıverir. Saf biçimde paylaşılamayan parça ZIP kapsayıcısıdır; çünkü bir deflate akışı durumu bir bloktan sonrakine taşır ve iki iş parçacığı aynı açıcıyı (decompressor) ilerletemez. Bu yüzden her çalışan kendi sayfa girdisi üzerinde kendi açıcısını açar ve XML'i doğrudan kendi okuyucusuna akıtır. Paylaşılan tek kaynak dosya tanıtıcısıdır ve etrafındaki kilit, her seferinde sıkıştırılmış baytların tek bir seek-and-read işlemini kapsar. Açma ve ayrıştırma birlikte paralel koşar ve hiçbir çalışma sayfasının XML'i bellekte tamamen açılmış halde tutulmaz. Ayrıştırma bitince çalışan girdisini sonuna kadar okur; böylece ZIP boyut ve CRC denetimleri yine çalışır
Aşama C, her sayfaya asılı duran parçalar için tek iş parçacığına döner: yorumlar ve zincirli yorumlar, çizimler ve grafikler, tablolar ve yazıcı ayarları. Çoğu çalışma kitabında bunlar hücre XML'inin yanında küçük kalır
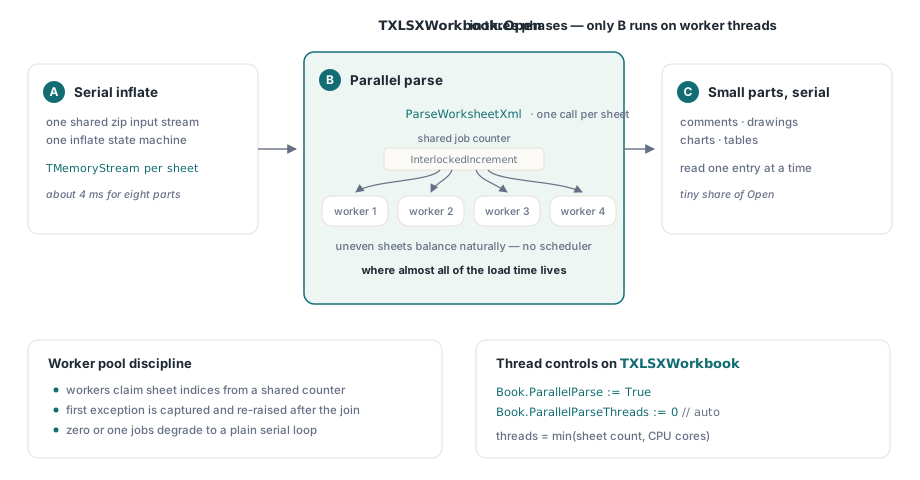
Hatalar çağıran iş parçacığına döner. Bir sayfa ayrıştırma sırasında istisna fırlattığında grup yeni indeks dağıtmayı bırakır, hâlâ koşan çalışanları bekler ve sonra başarısız olan en küçük numaralı sayfanın istisnasını Open'dan yeniden fırlatır; böylece rapor sayfa sırasını izler ve çağıran taraf bir çalışan iş parçacığından kaçan istisnayla hiç uğraşmaz. RecoveryMode True iken ayrıştırılamayan sayfa atlanır, Diagnostics'e bir uyarı düşer ve kalan sayfalar normal yüklenir. ParallelParse'ı False yapmak aynı ayrıştırıcıyı sayfalar üzerinde teker teker çalıştırır ve birebir aynı sonucu üretir
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    // İki değer de varsayılan; açıkça yazmak seçimi
    // kod incelemesinde görünür tutar
    Book.ParallelParse := True;
    Book.ParallelParseThreads := 0;  // 0 = mantıksal CPU başına bir çalışan, sayfa sayısıyla sınırlı
    Book.RecoveryMode := False;      // ayrıştırılamayan sayfa Open'dan istisna fırlatır
    if Book.Open('quarterly-ledger.xlsx') <> 1 then
      raise Exception.Create('open failed');
    // burada her sayfa tamamen yüklü; hücreleri her zamanki gibi okuyun
  finally
    Book.Free;
  end;
end;
Fazladan iş parçacığı tahsis ağırlıklı bir ayrıştırıcıyı neden yavaşlatır?
Çalışma sayfası ayrıştırması çoğunlukla küçük tahsislerden oluşur ve Delphi'nin varsayılan bellek yöneticisi iş parçacıklarını bunlarda sıraya sokar. Saf bir XML okuyucusu her eleman adı için bir dize, her öznitelik adı ve değeri için birer dize daha, hücre için bir Variant ve metni için bir dize üretir. Varsayılan bellek yöneticisi küçük blokları boyuta göre gruplanmış havuzlarda tutar ve her havuzu bir kilitle korur. Kilidi dolu bulan iş parçacığı geri çekilir ve yeniden denemeden önce uyur. Sekiz çalışanın tamamı aynı bir avuç minik boyutu istediğinde aynı havuzlarda çarpışıp dururlar ve kaynakta bağımsız görünen iş parçacıkları art arda koşar hale gelir
Bu, girişteki iki belirtiyi de açıklar. Uyuyan iş parçacığı CPU yakmadığı için CPU süresi duvar saati süresine yakın kalır; temposunu çekirdekler değil havuz kilitleri belirlediği için de iş parçacığı taraması düz kalır. İki iş parçacığı teke düpedüz yenilebilir: artık her tahsis, kilidin çekirdekler arasında gidip gelmesinin bedelini öder; seri döngü ise hiç çekişmez
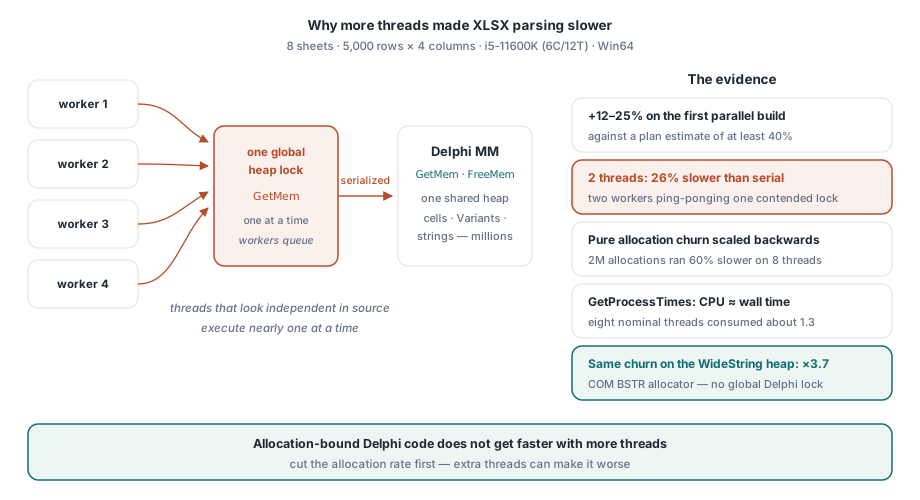
Windows'ta bir dize türü bunun dışında kalır. WideString bir COM BSTR'dir; Delphi bellek yöneticisi yerine sistemin OLE dize tahsisçisi tarafından ayrılır, dolayısıyla WideString trafiği Delphi havuzlarında hiç sıraya girmez. HotXLS hücre metnini WideString olarak saklar; bu, paralel yükleme için seri yoldakinden çok daha önemlidir
Çekişmeyi kendi çalışma kitaplarınızda ölçmek
Bir yüklemenin tahsise bağlı olup olmadığını iki sayı söyler: çalışan sayısı arttıkça duvar saati süresinin nasıl değiştiği ve sürecin aynı aralıkta ne kadar CPU tükettiği. Sekiz çalışan sözde meşgulken CPU süresi bölü duvar süresi 1,0 civarında kalıyorsa, ayrıştırmıyor, sıra bekliyorlardır. Aşağıdaki tarama aynı dosyayı birden sekize kadar çalışanla açar ve iki rakamı da basar. Kendi test projeniz için bir ölçüm düzeneğidir; yalnızca TXLSXWorkbook üyeleri HotXLS'ten gelir
uses
  Winapi.Windows, System.SysUtils, System.Math, System.Diagnostics;

// Kendi yardımcınız: bu sürecin user + kernel CPU süresi, milisaniye cinsinden
function ProcessCpuMs: Int64;
var
  Created, Exited, Kernel, User: TFileTime;
begin
  GetProcessTimes(GetCurrentProcess, Created, Exited, Kernel, User);
  Result := (Int64(Kernel) + Int64(User)) div 10000;  // 100 ns tik -> ms
end;

procedure SweepThreads(const FileName: string);
var
  N: Integer;
  Book: TXLSXWorkbook;
  SW: TStopwatch;
  Cpu0, Cpu: Int64;
begin
  for N := 1 to 8 do
  begin
    Book := TXLSXWorkbook.Create;
    try
      Book.ParallelParseThreads := N;  // 1 düz seri döngüyü çalıştırır
      Cpu0 := ProcessCpuMs;
      SW := TStopwatch.StartNew;
      if Book.Open(FileName) <> 1 then
        raise Exception.CreateFmt('open failed: %s', [FileName]);
      SW.Stop;
      Cpu := ProcessCpuMs - Cpu0;
      Writeln(Format('%d workers: %d ms wall, CPU/wall %.2f',
        [N, SW.ElapsedMilliseconds, Cpu / Max(Int64(1), SW.ElapsedMilliseconds)]));
    finally
      Book.Free;
    end;
  end;
end;
Taramayı birkaç kez çalıştırın ve her çalışan sayısı için en iyi değeri tutun; çünkü ilk koşu soğuk disk önbelleğinin de bedelini öder. CPU/duvar 1 civarındayken düz bir duvar süresi eğrisi, tavanın bellek yöneticisi olduğu anlamına gelir. CPU/duvar çalışan sayısına doğru tırmanırken duvar süresi düşmeye devam ediyorsa dosya ayrıştırmaya bağlıdır ve fazladan çalışanlar yerini hak ediyordur
Düz eğri sıradaki soruya götürür: hangi tahsisler sorumlu? Çağrıları boyuta göre sayan bir bellek yöneticisi sarmalayıcısı, profiler olmadan bunu birkaç dakikada yanıtlar. Aşağıdaki sürüm yalnızca GetMem'i sayar; FreeMem ve ReallocMem'i özgün yöneticiye işaret eder halde bırakır, trafiğin nereden geldiğini görmeye bu yeter
// Kendi test düzeneğinize eklediğiniz tanılama; HotXLS'in parçası değil
var
  OldMM, NewMM: TMemoryManagerEx;
  AllocCount, TinyCount: Int64;

function CountingGetMem(Size: NativeInt): Pointer;
begin
  AtomicIncrement(AllocCount);
  if Size <= 32 then
    AtomicIncrement(TinyCount);  // izlemeye değer küçük blok trafiği
  Result := OldMM.GetMem(Size);
end;

procedure InstallCounter;
begin
  GetMemoryManager(OldMM);
  NewMM := OldMM;
  NewMM.GetMem := CountingGetMem;
  SetMemoryManager(NewMM);
end;

procedure RemoveCounter;
begin
  SetMemoryManager(OldMM);
end;
Sayacı Open'dan hemen önce kurun, hemen sonra kaldırın ve AllocCount'u dosyadaki hücre sayısına bölün. Derlemeden derlemeye izlenecek rakam bu hücre başına değerdir; 32 bayt ve altındaki blokların payı da kısa dizelerin baskın olup olmadığını gösterir. Bir hücre nesnesi havuzu yazmadan önce buna bakın: her hücre nesnesi tek bir tahsistir, oysa o hücre ayrıştırılırken üretilen kısa ömürlü dizeler onu rahatça birkaç kat geçebilir
Tahsisler çalışma sayfası XML'inde nerede saklanır
<c r="B7" s="3" t="s"><v>42</v></c> gibi bir hücre diskte minicik görünür. Dümdüz bir okuyucu onu yine de bir dizi taze dizeye çevirir: c ve v eleman adları, üç öznitelik adı, üç öznitelik değeri ve metin içeriği. Her UTF-8 belirtecini RTL üzerinden dönüştürmek, nihai WideString var olmadan önce araya bir UnicodeString daha ekler. Bu dizelerin hiçbiri hücreden uzun yaşamaz ve her biri bellek yöneticisine bir gidiş geliştir
HotXLS XML okuyucusu en büyük iki kaynağa saldırır. Çalışma sayfası XML'indeki eleman adları çok küçük bir söz dağarcığından gelir (row, c, v, f, is); bu yüzden okuyucu daha önce karşılaştığı adların kısa bir önbelleğini tutar, her yeni adın ham baytlarını o önbellekle karşılaştırır ve eşleşmede önbellekteki dizeyi döndürür. Önbellekteki kopyalar bilerek AnsiString'dir. AnsiString referans sayımlıdır; önbellekteki bir örneği vermek bir sayaç artırımına mal olur, tahsise hiç mal olmaz. WideString adlardan oluşan bir önbellek hiçbir şey kazandırmazdı: WideString'in referans sayımı yoktur ve her atama yeni bir sistem tahsisi yapar
Öznitelik adları, öznitelik değerleri ve hücre metni öbür yoldan gider. Okuyucu UTF-8'i doğrudan tarama arabelleğinden iki geçişte çözer: ilki UTF-16 kod birimlerini sayar, ikincisi tam o uzunlukta bir kez ayrılmış bir WideString'i doldurur. Bu, belirteç başına tek tahsistir ve Delphi havuzları yerine sistem dize tahsisçisine düşer. A gibi karakter referansları ve öntanımlı varlıklar çözme başlamadan önce tarayıcı tarafından çözülür; böylece çözücü yalnızca sade UTF-8 görür. Geçerli UTF-8 olmayan bayt dizilerinde çözücü, RTL dönüşümünün düşüreceği ya da değiştireceği yerde suçlu baytları teker teker aynen geçirir; böylece hasarlı bir dosya bozuk noktanın çevresinde yine okunabilir ASCII verir. Geçerli girdi iki yolda da aynı metne çözülür
İki hamle de kendi Delphi ayrıştırma kodunuza taşınır. Dizeleri önbelleğe almak yalnızca dize türü referans sayımlıysa tahsis kazandırır; doğrudan hedef türe çözmek ise kullanışlı RTL dönüşüm işlevlerinin her çağrıda yarattığı geçici nesneyi ortadan kaldırır
Hangi çalışma kitapları kazanır, hangi ayarlar seçilmeli
Paralel ayrıştırma çalışma sayfası düzeyinde çalışır; dolayısıyla sonucun büyük kısmını çalışma kitabının biçimi belirler. En iyi durum, benzer boyutta birkaç sayfadır; bir şablon çalışma sayfasını bölge ya da ay başına bir kez kopyalayarak elde ettiğiniz dosyalar da buna dahil. Tek dev sayfadan oluşan bir çalışma kitabı, ParallelParseThreads ne derse desin tek çalışanda ayrıştırılır; o biçime akışlı doğrudan okuyucu daha iyi oturur, çünkü çalışma kitabının tamamını bellekte hiç kurmaz. Yorumlara, grafiklere ve çizimlere harcanan süre seri Aşama C'de kalır. Ayrıştırılacak sıfır ya da bir sayfası olan dosya grubu atlar ve düz seri döngüyü çalıştırır
Yalnızca bazı sayfalar önemliyse Open'ı çağırmadan önce adlarını SelectedSheets'e yazın. Öbür sayfalar yine adları ve görünürlükleriyle ama hücresiz oluşturulur, çalışanlar onları geçer ve kullanıcı açarsa LoadSheet birini sonradan doldurur
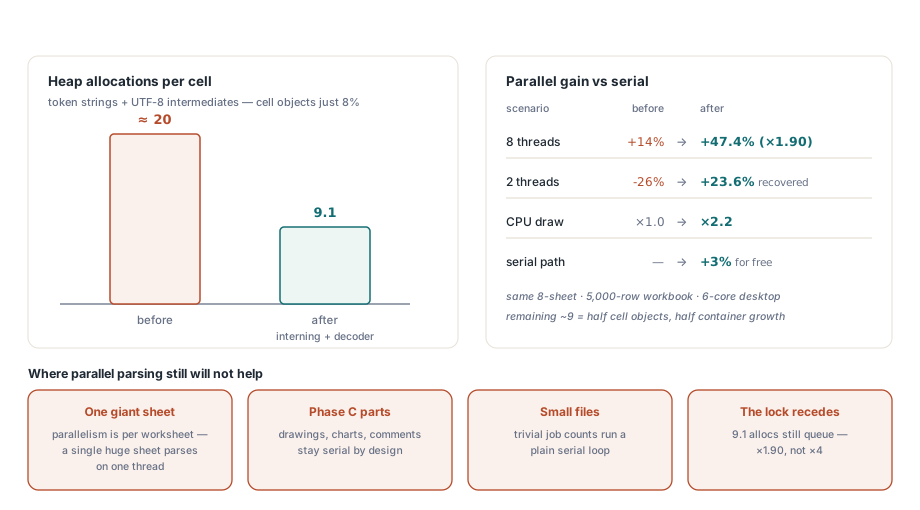
Aynı anda tek çalışma kitabı açan masaüstü araçları ve toplu işler için ParallelParse'ı açık bırakın. Bu varsayılan daha güvenli olandır: sonuçlar seri yolla aynıdır ve bir gün bir iş parçacığı sorusu çıkarsa tek bir özellik onu kapatır. Zaten birkaç çalışma kitabını eşzamanlı açan bir sunucu farklıdır. Her istek iş parçacığı da tahsis yapıyordur; bu yüzden her ek ayrıştırma çalışanı aynı bellek yöneticisi havuzlarına bir rakip daha ekler. Orada ParallelParseThreads'i 2 yapın ve ancak yukarıdaki tarama, o sunucuda normal yükü altında çalıştırıldığında fazladan çalışanların kendini ödediğini gösterdikten sonra yükseltin. Hücre başına daha az tahsis tavanı yükseltir ama kaldırmaz. Hücre nesneleri ve kapsayıcı büyümesi hâlâ Delphi havuzlarından geçer; sekiz çalışandan gelen kazancın sekiz katın epey altında kalmasının nedeni budur. Stil yeniden kullanımından toplu satır geri çağrılarına yükleme-kaydetme araç setinin geri kalanı için Delphi'de büyük çalışma kitabı performansı rehberine bakın
Çalışan grubu, ParallelParse ile ParallelParseThreads anahtarları ve tahsise kıt XML okuyucusunun hepsi HotXLS Delphi Excel Bileşeni ile gelir; bileşen XLS, XLSX ve ODS dosyalarını makinede Excel kurulu olmadan doğrudan Delphi ve C++Builder kodundan okur ve yazar