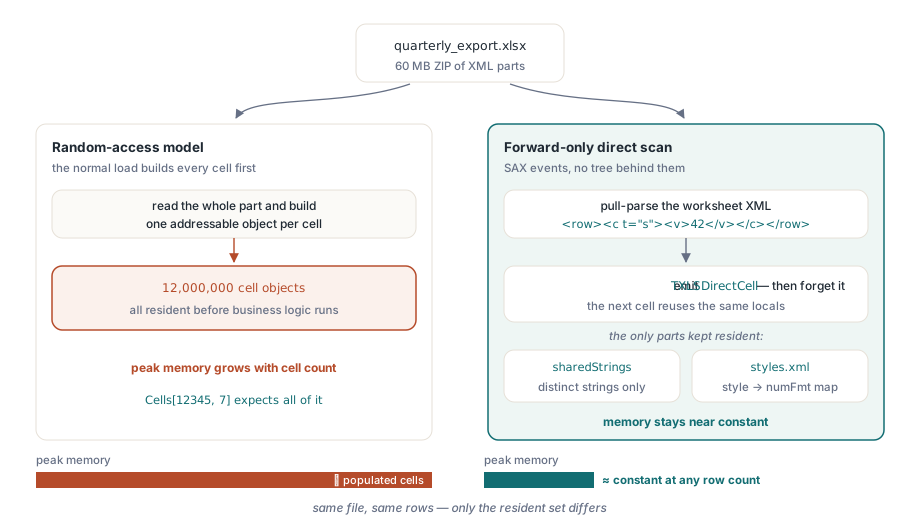
Bir milyon satırlık ve bir düzine (dozen) sütunluk bir elektronik tablo, bir veritabanı raporlama işinden gelen gayet sıradan bir dışa aktarımdır. Tüm çalışma kitabını (workbook) bir TXLSWorkbook içine yükleyerek her zamanki yolla açtığınızda işlem, ilk iş mantığı satırınız çalışmadan önce o on iki milyon hücrenin her birini canlı bir nesne olarak somutlaştırmak (materialise) zorundadır. Diskteki dosya altmış megabaytlık sıkıştırılmış bir XML olabilir. Genişlediği nesne ağacı bunun birkaç katıdır ve hepsinin aynı anda yerleşik (resident) olması gerekir çünkü model tasarımı gereği rastgele erişimlidir (random-access). Yukarıdan aşağıya okumak ve çöpe atmak niyetinde olduğunuz bir rapor için, bu hiç ihtiyaç duymadığınız bir yapıya harcanan çok büyük bir bellektir
Aynı dosyadan geçen ikinci bir yol daha vardır. Bir model inşa etmek yerine, çalışma sayfası XML'ini hücre hücre yalnızca ileriye doğru (forward only) tararsınız ve baktıktan sonra her hücrenin akıp gitmesine izin verirsiniz. Hiçbir şey birikmez. İster bin, ister on milyon satır olsun bellek neredeyse sabit kalır, çünkü okuyucu hiçbir zaman şu anda ayrıştırdığı (parsing) parça ve birkaç küçük arama tablosundan (lookup tables) fazlasını tutmaz. HotXLS doğrudan okuyucusu (direct reader) bunu yapar ve bu makalenin geri kalanı neden küçük kaldığı ve buna karşılık size ne verdiği hakkındadır
Bellek içi model neden ölçeklenmez
Bir XLSX dosyası, ECMA-376'nın tanımladığı XML parçalarından oluşan bir ZIP paketidir. Her çalışma sayfası kendi parçasıdır, xl/worksheets/sheetN.xml; içindeki her satır, <c> hücre öğelerini taşıyan bir <row> öğesidir. Olağan yükleme yolu o parçayı okur ve her hücre için adreslenebilir bir nesne kurar; böylece sonra Cells[12345, 7] sorup sabit zamanda yanıt alabilirsiniz. Rastgele erişim, çalışma kitabı modelinin tüm anlamıdır ve düzenlemeyi, formül değerlendirmeyi ve stillendirmeyi elverişli kılan da tam olarak budur
Maliyeti ise rastgele erişimin her şeyin aynı anda mevcut olmasını gerektirmesidir. Sadece kısmen oluşturduğunuz bir yapı içerisine dizin (index) koyamazsınız. Dolayısıyla tam bir yüklemenin (full load) en yüksek belleği (peak memory) hücre sayısının bir işlevidir ve milyonlarca dolu hücreye (populated cells) sahip bir sayfada bu işlev (function), özellikle de paylaşılan bir makinede (shared machine) aynı anda birkaç iş yürütülüyorsa hizmetinizin (service) olmak istemeyeceği bir yere iner. Gerçekte ihtiyaç duyduğunuz erişim düzeni ardışıksa (sequential), rastgele erişim için ödeme yapmak kullanmayacağınız bir yetenek (capability) için ödeme yapmaktır
Ağaç oluşturmayan yalnızca ileri (forward-only) SAX taraması
Doğrudan okuyucu ZIP paketini açar ve SAX tarzı bir çekme ayrıştırıcısı (pull parser) ile her çalışma sayfası bölümünü yürütür (walks). Buradaki SAX, ayrıştırıcının ayrıştırma olaylarını karşılaştıkça (bir başlangıç öğesi, bir metin akışı, bir bitiş öğesi) raporladığı ve ardından devam ettiği anlamına gelir. Arkasında hiçbir düğüm (node) ağacı bırakmaz. Okuyucu geçerli satırı ve sütunu r özniteliklerinden (attributes) izler, olaylar geldiğinde hücrenin türünü, stil dizinini (style index), değerini ve formül metnini toplar ve kapanış </c> etiketi görüldüğünde bir hücre yayar (emits) ve onu unutur. Sonraki hücre aynı bir avuç (handful) yerel değişkeni (variables) yeniden kullanır
Hücreler arasında hiçbir şey tutulmadığından, bellek ayak izi (memory footprint) hücre sayısıyla artmaz (grow). Tutunmaya değer olan mülk (property) budur. İki yüz satırlık bir sayfa ve yirmi milyon satırlık bir sayfa okuyucuya aynı yerleşik belleğe mal olur ve aralarındaki fark yalnızca taramanın ne kadar süreceğidir. Modelin başyazı (headline) özelliği olan rastgele erişimden vazgeçersiniz ve karşılığında hücre sayısının geçemeyeceği bir bellek tavanı (ceiling) alırsınız
Ne yerleşik (resident) kalır ve neden o iki parça
Tarama tamamen durumsuz (stateless) değildir ve istisnalar (exceptions) öğreticidir (instructive). Kendi başına bir hücre, onlar olmadan (without them) yorumlamaya (interpret) yetecek kadar bilgi taşımadığından, süre boyunca bellekte tutulması gereken iki küçük tablo (tables) vardır
Birincisi paylaşılan dize (shared string) tablosudur. SpreadsheetML'de, bir metin hücresi kendi metnini depolamaz. t="s" ve çalışma kitabındaki her farklı (distinct) dizenin (string) tekilleştirilmiş (deduplicated) tek bir listesi olan xl/sharedStrings.xml'in (sharedStrings.xml) içine bir indeks (index) olan sayısal bir yük (payload) taşır. Bu, aynı etiketlerin binlerce satırda tekrarlandığı dosyalar için iyi bir alan (space) takasıdır, ancak okuyucunun bu dize tablosunu en baştan (up front) yüklemesi ve yerleşik tutması gerektiği anlamına gelir çünkü herhangi bir sayfadaki herhangi bir hücre içindeki (in it) herhangi bir girdiye (entry) atıfta (reference) bulunabilir. Tablo, hücre sayısına göre değil farklı dize (distinct strings) sayısına göre boyutlandırılmıştır (sized), bu nedenle devasa sayfalarda (enormous sheets) bile mütevazı (modest) kalır
İkincisi, styles parçasından gelen sayı-biçimi eşlemesidir. Sayısal bir hücre ile tarih hücresi telde bayt baytına aynıdır: ikisi de düz bir sayıdır, çünkü SpreadsheetML'de bir tarih yalnızca seri gün sayımıdır. İkisini ayıran tek şey hücrenin stilidir; bu stil, xl/styles.xml içindeki cellXfs üzerinden bir sayı-biçimi kimliğine işaret eder. Bir tarihi ham seri sayı olarak değil tarih olarak raporlamak için okuyucu o stil-biçim tablosunu yükler ve yerleşik tutar. Dosyadaki geri kalan her şey, baytların çoğunu oluşturan fiili hücre verisi, depolanmadan akıp geçer
Her hücre bir tür (kind) ve bir değer raporlar
Üretilen her hücre bir TXLSDirectCell kaydı olarak gelir. Sayfa dizinini ve adını, 1 tabanlı satır ve sütunu, anlamsal bir Kind değerini, Variant olarak Value'yu, başındaki eşittir işareti olmadan Formula metnini ve ham StyleIndex'i taşır. Tür; xdkNumber, xdkString, xdkBoolean, xdkDate ya da xdkError'dan biridir; böylece hücrenin ne anlama geldiğine göre, özniteliklerden yeniden türetmek yerine dallanabilirsiniz. Bir formül hücresi, önbelleğlenmiş sonucunun türünü bildirir, yanında formül metniyle; böylece hesaplanmış bir toplam, nasıl üretildiğini de söyleyen bir sayı olarak ulaşır

type
  TReportScan = class
    procedure OnCell(Sender: TObject; const Cell: TXLSDirectCell;
      var Abort: Boolean);
  end;

procedure TReportScan.OnCell(Sender: TObject; const Cell: TXLSDirectCell;
  var Abort: Boolean);
begin
  case Cell.Kind of
    xdkString:  AccumulateLabel(Cell.Row, Cell.Col, VarToStr(Cell.Value));
    xdkNumber:  AddToTotals(Cell.Col, Double(Cell.Value));
    xdkDate:    NoteWhen(Cell.Row, VarToDateTime(Cell.Value));
    xdkBoolean: FlagRow(Cell.Row, Boolean(Cell.Value));
    xdkError:   LogBadCell(Cell.Row, Cell.Col, VarToStr(Cell.Value));
  end;
end;
Bir tarihi sayıdan ayırt etmek
Tarih sorusu daha yakından bakmayı hak eder, çünkü naïf tarayıcıların çoğu tam burada yanılır. Sayısal bir hücrede tarih türü yoktur. 46000 seri değerini taşıyan bir hücre bir miktar, bir fiyat ya da 17 Şubat 2025 olabilir ve dosya bunu size yalnızca hücrenin stili üzerinden ulaşılan sayı-biçimi kimliğiyle söyler. ECMA-376, anlamı her uyumlu üreticide sabit olan bir gömülü biçim kimlikleri bloğu ayırır ve tarih taşıyan kimlikler iki aralıkta durur: standart tarih ve saat biçimleri için 14-22 ve [h]:mm:ss gibi geçen süre biçimleri için 45-47. DetectDates açıkken (varsayılan olarak açıktır) okuyucu her sayısal hücrenin stilini biçim kimliğine çözer ve kimliği o ayrılmış aralıklara düşen hücre, Value'su bir Delphi TDateTime'ına dönüştürülmüş olarak xdkDate raporlanır. Özel biçimler de denetlenir, biçim kodundaki tarih ve saat belirteçlerine bakılarak; ama güvenilir omurga ayrılmış aralıklardır. DetectDates'i kapatın: styles tablosu hiç yüklenmez, her sayısal hücre xdkNumber olarak gelir ve tarama oransal olarak daha da hafifler
Sayfaları atla ve erken iptal et
Sıralı tarama (Sequential scanning), rastgele erişimin eşleşemeyeceği sessiz bir avantaja sahiptir: durabilirsiniz. OnSheet olayı her çalışma sayfasının (worksheet) açılmasından önce tetiklenir (fires) ve size iki anahtar (switches) verir. SkipSheet ayarladığınızda bu bölümün (part) tamamı hiçbir zaman ayrıştırılmaz (parsed) ki bu, çok sayfalı (multi-sheet) bir çalışma kitabında geri kalanını okumak için ödeme yapmadan (paying to read) yalnızca ilgilendiğiniz sayfaları tarama şeklinizdir (how you scan). Abort ayarladığınızda tüm tarama hemen (immediately) sona erer (ends). OnCell olayının (event) kendine ait bir Abort'u vardır, bu nedenle milyonlarca kalan (remaining) hücreyi okumadan, aradığınızı -belirli bir satır, nöbetçi bir değer (sentinel value), bir başlık bloğunun (header block) sonu- bulduğunuz an durdurabilirsiniz (halt). Sadece ileri yönlü (forward-only) bir taramada iptal etme (abort) gerçekten (genuinely) ücretsizdir, çünkü atladığınız iş henüz gerçekleşmemiş (had not happened yet) olandır

procedure TReportScan.OnSheet(Sender: TObject; SheetIndex: Integer;
  const SheetName: WideString; var SkipSheet: Boolean; var Abort: Boolean);
begin
  // Yalnızca "Data" sayfasını tara; geri kalanını okunmamış bırak
  SkipSheet := SheetName <> 'Data';
end;
Bir işleyici (handler) olmadan hücreleri sayma
Tek bir özellik vurgulanmayı hak eder, çünkü sık sorulan bir soruyu tek bir ucuz çağrıya indirger. Okuyucu, geçtiği her dolu hücreyi sayar ve bunu bir OnCell işleyicisi bağlı olsun ya da olmasın yapar; sayım, yayından bağımsızdır. Yani tek bir soru sorabilirsiniz, bu çalışma kitabı gerçekte kaç dolu hücre içeriyor, ve cevabı hiç geri çağırım yapmadan, yalnızca bir tarama bedeliyle alırsınız. ReadFile ve ReadStream bu toplamı Int64 olarak döndürür; aynı sayı sonrasında CellCount özelliği olarak da erişilebilir durumdadır. -1 döndüğünde dosya ya açılamamıştır ya da bir OOXML paketi değildir
var
  Reader: TXLSDirectReader;
  Populated: Int64;
begin
  Reader := TXLSDirectReader.Create;
  try
    // No OnCell handler: a pure populated-cell census, still near-constant memory
    Populated := Reader.ReadFile('quarterly_export.xlsx');
    if Populated < 0 then
      raise Exception.Create('Not a readable XLSX package')
    else
      Writeln(Format('%d populated cells (CellCount = %d)',
        [Populated, Reader.CellCount]));
  finally
    Reader.Free;
  end;
end;
Tam (full) tarama için, işleyiciyi bağlar (attach the handler) ve ReadFile işlevini tıpkı (exactly) aynı yolla çağırırsınız. Tam bir yüklemeyle olan zıtlık meselenin ta kendisidir (the whole point): quarterly_export.xlsx (quarterly_export.xlsx) dosyasını bir çalışma kitabına yüklemek, her hücreyi yerleşik (resident) bir nesneye genişletecek (expand) ve tüm grubu (the lot) tutacakken, doğrudan (direct) okuyucu yalnızca paylaşılan (shared) dizeleri (strings) ve stil tablosunu tutar (keeps) ve on iki milyon hücre her defasında bir tane olmak üzere OnCell'inizden geçer. Hücre başına çalışan aritmetik geride hiçbir şey bırakmaz, dolayısıyla en yüksek (peak) bellek, satır sayısına göre değil çalışma kitabının farklı dize (distinct-string) sayısına (count) göre belirlenir (set)
Görev, büyük bir çalışma kitabını bir kez okumak ve onu ayıklamak veya özetlemek olduğunda doğrudan okuyucu doğru araçtır. Bunun yerine tam modelin (full model) rastgele erişimine ihtiyaç duyduğunuzda ancak büyük dosyalarda davranmasını (behave) istediğinizde, Delphi'deki büyük çalışma kitabı performansı hakkındaki notlarımızdaki ayarlama (tuning) bu yolu (path) kapsar. Ve büyük bir çıktı (output) üretmek üzere yön (direction) tersine çevrildiğinde, sunucu toplu işleri (server batch jobs) için akışlı yazma (streaming-write) kılavuzu, yazma işlemi için aynı sabit bellek (constant-memory) disiplinini uygular. Üçü de bu blogda (blog) başka yerlerde ele alınan okuma, yazma, formül (formula) ve format (formatting) API'lerinin yanında Delphi ve C++Builder için HotXLS Bileşeninin bir parçası (part) olarak sevk edilir (ship)