Договор, экспортированный из текстового процессора с не поставленной галочкой «tagged PDF», на экране всё ещё выглядит структурированным: жирный заголовок кегля 24, нумерованные пункты, разлинованное расписание вознаграждения. Сконвертируйте его в перевёрстываемый HTML, и расписание вернётся настоящей <table>, а заголовок — <p> с в точности тем же статусом, что у сноски. Такой вывод корректен. ISO 32000-1 §14.8 даёт PDF ровно одно место, где можно сказать «этот прогон текста — заголовок», дерево структуры, и непомеченный файл его не имеет. Кегль и жирность — наборные решения, и конвертер, превращающий каждую крупную жирную строку в <h1>, повысит в ранге и выносные цитаты, и итоговые суммы таблиц, и название компании в шапке письма
Вопрос, который стоит задать любому конвейеру PDF-to-HTML: откуда в его выводе взялись каждый заголовок, элемент списка и таблица и насколько каждому можно верить на раскладке телефона, в скринридере или поисковом индексе. Заголовки и таблицы отвечают по-разному. Шаг экспорта добавляет свои решения о разрывах строк, кодировке символов и памяти
Откуда берутся заголовки и списки
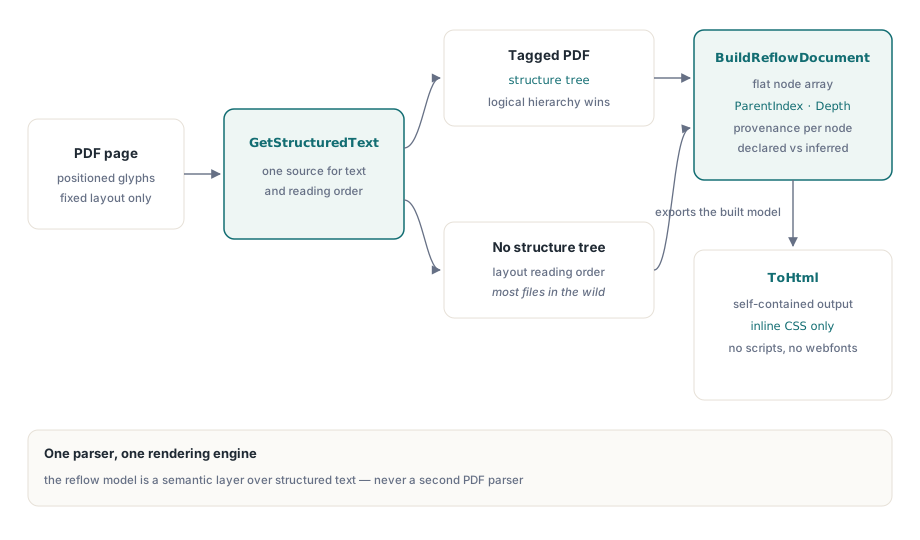
PDFium Component строит модель рефлоу вызовом TPdf.BuildReflowDocument, и тот метод берёт каждое слово, блок и семантическую подсказку из GetStructuredText — того же слоя структурированного текста, что разобран в статье о структурированных текстовых блоках и порядке чтения. За ним нет ни второго парсера, ни второго экстрактора текста. Для каждой страницы запрошенного диапазона он собирает блоки в порядке физической раскладки. GetStructuredText уже сопоставил каждый блок с тегированным содержимым страницы по перекрытию площади, а BuildReflowDocument копирует найденную роль на блок: H до H6 становятся заголовками со своим уровнем, LI, Lbl и LBody — элементами списка, Figure — рисунком, чей текст — альтернативное описание, а Caption — подписью
Следуют два следствия, и оба легко наблюдаемы. Порядок блоков всегда идёт за раскладкой страницы, даже в помеченном файле: теги решают, чем блок является, а геометрия — куда он идёт. И на странице без тегов каждый блок — абзац. Заголовки и списки никогда не угадываются по кеглю
Каждый узел несёт поле Source типа TPdfReadingOrderSource: rosStructure, когда роль пришла из дерева структуры, rosHeuristic — когда только из раскладки. Экспортированный HTML повторяет это атрибутами data-source="structure" или data-source="inferred" на каждом элементе, а документный TPdfReflowDocument.Source равен rosStructure, только когда каждая страница диапазона была помечена. Таблицы всегда rosHeuristic: они приходят из геометрического обнаружения, а не из тегов Table. Если нижестоящий шаг трактует заголовки как навигационные ориентиры, проверяйте сперва это поле: помеченный документ даёт ориентиры, выбранные автором
Плоский массив узлов вместо дерева объектов
TPdfReflowDocument.Nodes — дерево, сплющенное в прямом порядке обхода: один динамический массив записей TPdfReflowNode, каждая с ParentIndex и Depth. Узлы страниц сидят на глубине 0 с родителем -1. Абзацы, заголовки, рисунки, подписи, списки и таблицы висят на странице на глубине 1, элементы списка — на глубине 2 под своим списком, а ячейки таблиц доходят до глубины 3 под строкой. Соседние элементы списка делят один узел списка; любой другой блок или таблица между ними начинают новый список
Плоская раскладка — решение о переносимости. Рекурсивная запись, содержащая динамический массив самой себя, компилируется под Delphi, C++Builder и Free Pascal, но все трое обходятся с рекурсивными управляемыми типами по-разному за границей пакета или DLL. Плоский массив простых записей ведёт себя одинаково во всех трёх, и его можно прогнать через stream одним циклом for без рекурсии
uses
  SysUtils, PDFium;

var
  Pdf: TPdf;
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Node: TPdfReflowNode;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'contract.pdf';
    Pdf.LoadDocument;

    Options := TPdfReflowOptions.Default;   // все страницы, таблицы включены, CSS включён
    Doc := Pdf.BuildReflowDocument(Options);

    for I := 0 to High(Doc.Nodes) do
    begin
      Node := Doc.Nodes[I];
      case Node.Kind of
        prnkHeading:
          Writeln(Format('%sH%d [%s] %s', [StringOfChar(' ', Node.Depth * 2),
            Node.HeadingLevel,
            BoolToStr(Node.Source = rosStructure, True), Node.Text]));
        prnkTable:
          // на узле таблицы RowSpan/ColumnSpan держат число строк и колонок таблицы
          Writeln(Format('%stable %dx%d, page %d, confidence %.2f',
            [StringOfChar(' ', Node.Depth * 2), Node.RowSpan, Node.ColumnSpan,
             Node.PageNumber, Node.Confidence]));
      end;
    end;

    Writeln(Format('%d node(s), %d table(s), %d character(s), pages %d-%d',
      [Length(Doc.Nodes), Doc.TableCount, Doc.CharacterCount,
       Doc.FirstPage, Doc.LastPage]));
  finally
    Pdf.Free;
  end;
end;
На непомеченном договоре из вступления тот цикл не напечатает ни одной строки H и по одной строке таблицы на каждое найденное расписание вознаграждения. Прогоните его на помеченной копии того же документа — и заголовки появятся с True рядом. FirstPage и LastPage в опциях по умолчанию 0, что значит первую и последнюю страницу документа; диапазон за пределами числа страниц бросает EPdfError прежде, чем будет прочитана хоть одна страница
Почему текст таблиц не появляется дважды?
Обнаружение таблиц идёт на каждой странице после сбора структурированного текста, а значит слова внутри таблицы существуют дважды: раз как текстовые блоки, раз как ячейки. Выдать и то и другое — и каждая таблица в HTML будет сопровождена собственным содержимым снова, уже россыпью абзацев, — ровно то, что выдаёт наивное слияние «добавим таблицы к тексту»
Модель решает это геометрически. Текстовый блок, чей bounding box лежит хотя бы наполовину внутри границ найденной таблицы, выбрасывается, а его место занимает узел таблицы. Затем таблицы чередуются с оставшимися блоками по вертикальной позиции (выше на странице — раньше, с направлением слева направо как тай-брейком, когда верхние края расходятся меньше чем на полпункта), так что таблица ложится между абзацем над ней и абзацем под ней вместо присоединения в конец страницы
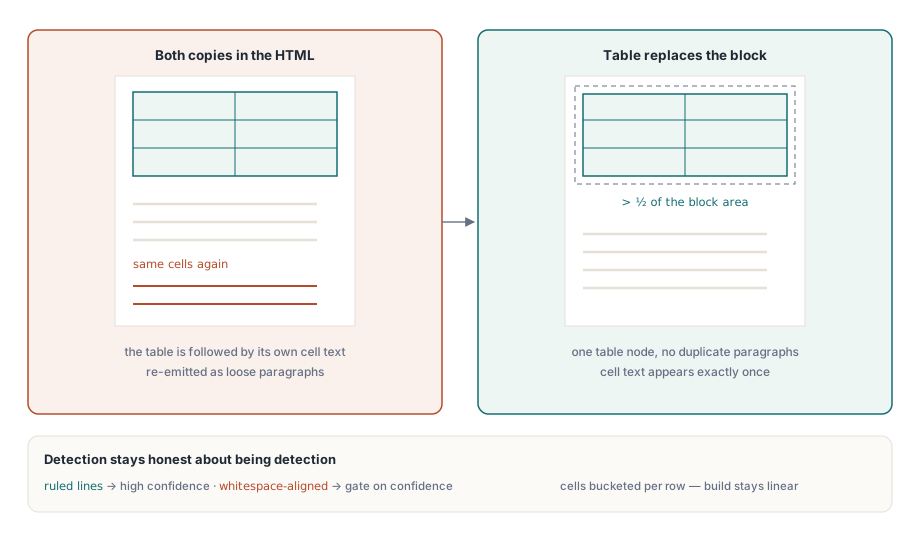
У порога в полплощади есть зримый край. Блок, сидящий на границе таблицы и вылезающий по большей части наружу, выживает целым, так что строка текста может изредка появиться и в последней строке, и в следующем за ней абзаце. Это правильная сторона для ошибки. Порог, низкий настолько, чтобы убрать каждый пересекающийся блок, заодно удалит основной текст, лишь коснувшийся bounding box таблицы, а продублированную строку заметить и простить куда легче, чем пропавшее предложение
Найденные таблицы вдобавок несут достоверность, и две стратегии обнаружения попадают в разные полосы. Таблица, найденная по линейкам, набирает от 0.88 до 1.0 в зависимости от того, сколько ячеек держат текст. Таблица, выведенная чисто из выравнивания пробелами, — от 0.58 до 0.88. Узел таблицы держит тот балл в Confidence, каждая ячейка повторяет его, а HTML пишет его атрибутом data-confidence на элементе <table>. Таблицы ниже TableOptions.MinConfidence (по умолчанию 0.5) не создаются вовсе, а когда таблица отвергнута, её слова просто остаются в модели обычными абзацами
Для поискового индекса или мобильного читательского вида неверная таблица стоит дёшево, а верно найденная — большое улучшение, так что оставьте дефолты. Для архивной конвертации, где выдуманная сетка вокруг двухколоночного адресного блока хуже отсутствия сетки, ограничьте обнаружение таблицами с линейками:
Options := TPdfReflowOptions.Default;
Options.DetectTables := True;
Options.TableOptions.DetectWhitespaceTables := False; // только таблицы с линейками
Options.TableOptions.MinConfidence := 0.9;            // отбрасываем и разреженные сетки
Options.TableOptions.MaxTables := 200;                // потолок на весь документ
Options.TableOptions.MaxCells := 50000;               // потолок на весь документ

Doc := Pdf.BuildReflowDocument(Options);
if Doc.TableCount = 0 then
  Writeln('No ruled tables; all page text is emitted as paragraphs');
Внутри сборки рефлоу MaxTables и MaxCells считаются по всему диапазону страниц, а не на страницу, так что выписка на 300 страниц с разлинованной таблицей на каждой требует MaxTables не меньше 300, иначе сборка остановится с EPdfError на первой таблице за лимитом. Дефолты — 1000 таблиц и 100000 ячеек
Про саму сторону обнаружения, включая тонкие залитые прямоугольники, нарисованные как рамки, и продолжение таблиц между страницами, см. статью об обнаружении и извлечении таблиц
Экспортируем HTML, которому ничего не нужно
TPdfReflowDocument.ToHtml обходит уже построенную модель и больше никогда не трогает PDFium, поэтому двойной экспорт той же модели даёт ту же строку. Со взведённым FullDocument (дефолт) результат — полная страница: doctype, <meta charset="utf-8">, мета-тег viewport, <title> из записи Title документа (или «PDF document», когда та пуста) и атрибут lang из языка документа. Без FullDocument вы получаете единственный фрагмент <div class="pdf-reflow"> для вставки в свой шаблон
Опциональная таблица стилей из IncludeCss — один встроенный блок <style>: читательская колонка в 72rem, каждая страница PDF белой карточкой при включённом IncludePageSections, схлопнутые рамки таблиц и media query ниже 40rem, снимающий поля карточки и ужимающий текст таблиц. Ни скрипта, ни веб-шрифта, ни внешнего URL — именно это позволяет файлу жить внутри письма, справочника в духе CHM или песочницы браузерного контрола. Уровни заголовков вне 1–6 пишутся как h2, ячейки шапки становятся th, а ячейки с RowSpan или ColumnSpan выше 1 получают rowspan и colspan. Включение IncludeGeometry добавляет data-left, data-top, data-right и data-bottom в пунктах PDF — удобно для подсветки поискового попадания обратно на отрисованной странице
PreserveLineBreaks заслуживает обдуманного выбора. Разрыв строки внутри PDF-абзаца сделан под одну фиксированную ширину колонки; утащите его на экран в 360 пикселей, и каждая строка завернётся дважды — та самая рваная кромка, ради устранения которой существует рефлоу. Для прозы держите выключенным (дефолт). Включайте для документов, где разрыв несёт смысл, — адресов, стихов, листингов кода, — и тогда вместо пробела пишется <br>
Для длинного документа сборка всей страницы в одну WString с последующим кодированием удваивает пик памяти. WriteHtml вместо этого транслирует ту же разметку в TPdfReportWriter, пишущий ASCII с каждым не-ASCII символом в виде числовой символьной ссылки, так что байты валидны независимо от того, как угадает кодировку принимающая сторона:
uses
  Classes, SysUtils, PDFium, FPdfAsync, FPdfReport;

procedure ExportReflowHtml(Pdf: TPdf; const FileName: string;
  const Token: IPdfCancellationToken);
var
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Limits: TPdfReportLimits;
  Stream: TFileStream;
  Writer: TPdfReportWriter;
begin
  Options := TPdfReflowOptions.Default;
  Options.MaxNodes := 500000;
  Options.MaxCharacters := 20000000;
  Doc := Pdf.BuildReflowDocument(Options, Token);   // состояние страницы восстанавливается после

  Limits := TPdfReportLimits.Default;
  Limits.MaxCharacters := 64 * 1024 * 1024;  // потолок байтов вывода, максимум 64 МиБ
  Limits.MaxItems := Options.MaxNodes;       // один элемент на узел, максимум 1048576

  Stream := TFileStream.Create(FileName, fmCreate);
  try
    Writer := TPdfReportWriter.Create(Limits, Stream);  // stream остаётся у вызывающего
    try
      Doc.WriteHtml(Writer);
    finally
      Writer.Free;
    end;
  finally
    Stream.Free;
  end;
end;
WriteHtml проверяет больше, чем ToHtml. Он отказывает модели с числом узлов выше Options.MaxNodes, следит за Options.MaxCharacters на записываемом тексте, ограничивает вложенность аргументом MaxDepth (по умолчанию 64) и проверяет, что каждый ParentIndex указывает на более ранний узел. Последняя проверка важна, если ваш код фильтрует или переписывает Nodes перед экспортом: правленый массив с родителем вперёд по массиву бросит EPdfReportLimit вместо разметки с непарными тегами
Бюджеты, отмена и состояние страницы
PDF — недоверенный вход, и кривой или враждебный файл может объявить тысячи страниц мелкого текста. BuildReflowDocument сверяет бюджеты символов, узлов, таблиц и ячеек перед добавлением каждого узла, так что файл, за них вышедший, останавливается с EPdfError и сообщением, называющим бюджет («Reflow node budget exceeded», например), пока потребление памяти ещё ограничено. И MaxCharacters, и MaxNodes обязаны быть положительными; дефолты — 10 000 000 символов и 1 000 000 узлов
Опциональный IPdfCancellationToken проверяется перед каждой страницей, между блоками, перед каждой таблицей и перед каждой строкой таблицы. Передайте Token источника TPdfCancellationTokenSource, принадлежащего вашей форме, позовите Cancel из обработчика кнопки, и сборка бросит EPdfOperationCancelled на ближайшей из тех контрольных точек. Ловите его отдельно от EPdfError, чтобы пользовательская отмена не попала в журнал как сломанный файл. Каким бы исключением сборка ни кончилась, частичного результата не возвращается; если сбой случился позже внутри WriteHtml, файл назначения держит усечённую страницу, так что удаляйте его в собственном обработчике исключений
Состояние страницы — та деталь, на которую опирается GUI-код. Сборка посещает каждую страницу диапазона сдвигая PageNumber, а try/finally возвращает страницу вызывающего на место и при успехе, и при отказе по бюджету, и при отмене. Просмотрщик, запустивший экспорт, пока пользователь читает страницу 340, обнаружит её текущей и после возврата экспорта
Куда рефлоу встаёт
Вывод рефлоу хорош как вход для поискового индексирования, доступных читательских видов, показа на телефоне и миграции содержимого в CMS. Он нарочно выбрасывает абсолютное позиционирование, точные шрифты, векторную графику и геометрию страниц — за вычетом опциональных координат data-*. Когда задаче нужно, чтобы страница выглядела одинаково, рендерьте; когда нужно, чтобы слова читались где-то ещё, перевёрстывайте
Поскольку заголовки и списки приходят только из тегов, качество HTML следует за качеством тегирования выше по потоку. Документы, прошедшие проверки из статьи о валидации дерева структуры PDF/UA, дают модели с настоящей иерархией заголовков, а то же тегированное содержимое ведёт читательские возможности из статьи о построении доступного читателя
Рефлоу, структурированный текст, извлечение таблиц и рендеринг работают с одним и тем же объектом TPdf в Delphi, C++Builder и Lazarus; записи опций, исключения и репорт-райтер задокументированы на странице продукта PDFium Component для Delphi