Двухколоночная конференц-статья, отсортированная по вертикальной позиции, возвращается с первой строкой вроде Abstract We measure the 2 Related work Earlier studies: первые слова левой колонки и первые слова правой, склеенные из-за того, что обе сидят на одной базовой линии. В парсере ничего не сломалось. Страница PDF предлагает два защитимых порядка для своего текста — последовательность, которой поток контента его рисует, и позицию каждого глифа на странице, — и во многих раскладках эти два порядка расходятся. Экстрактор, возвращающий позиционированные блоки вместо одной строки, позволяет увидеть, какой порядок вы получили, и переключиться, если для страницы перед вами он не тот
Что возвращает GetStructuredText
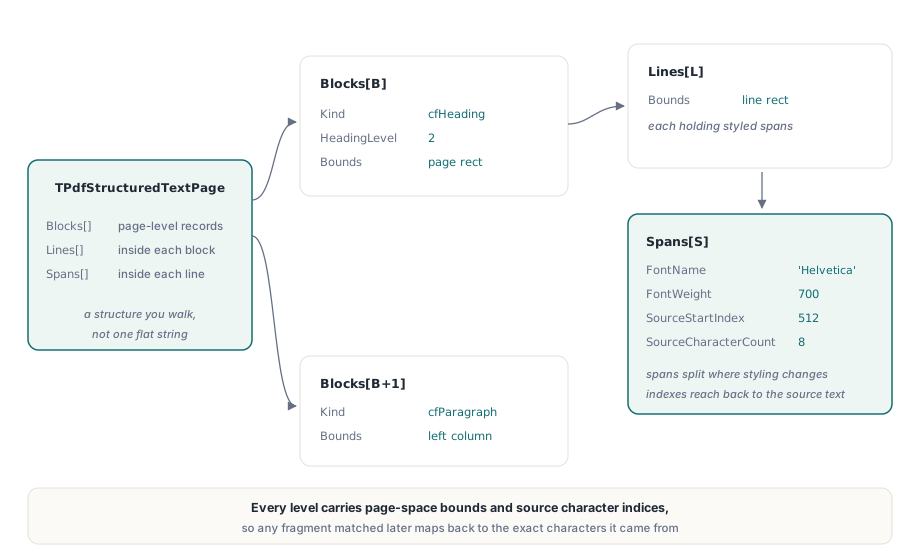
TPdf.GetStructuredText в PDFium Component возвращает TPdfStructuredTextPage для текущей страницы: массив блоков, каждый блок — массив строк, каждая строка — массив стилевых спанов. Каждый уровень несёт собственный Text и прямоугольник Bounds в page-space, в PDF-пунктах, поэтому заголовок, единственную строку или жирную фразу можно локализовать на странице без второго запроса. Запись страницы добавляет Width, Height, CharacterCount и два счётчика качества, описанных ниже
Сплющенный Page.Text строится из блоков, а не из сырого символьного потока. Строки внутри блока склеиваются одиночным CRLF, блоки разделяются пустой строкой, значит дамп Page.Text как чистого текста уже показывает, где экстрактор провёл границы блоков. Это делает его самым быстрым, что стоит напечатать, когда страница читается странно
Всем этим рулит маленькая запись опций. TPdfStructuredTextOptions.Default ставит ReadingOrder в roPhysicalLayout, включает IncludeFontInfo и IncludeSemantics и ставит MaxCharacters в 1 000 000. Поле порядка чтения — то, что больше всего меняет форму вывода
Как два порядка чтения строят строки и блоки
roContentOrder сохраняет последовательность рисования производителя, тогда как roPhysicalLayout перестраивает порядок из позиций глифов, и разница проявляется сперва в том, как образуются строки. В порядке контента символы берутся в том порядке, каком страница их рисует. Новая строка начинается на явном разрыве строки или когда следующий символ больше не перекрывает текущую строку вертикально. Строка присоединяется к блоку прямо перед ней, только если обе перекрываются горизонтально минимум на пятую часть более узкой ширины, а вертикальный зазор — не больше примерно двух с четвертью высот строк; иначе она открывает новый блок. Блоки остаются в порядке рисования
Физическая раскладка выбрасывает последовательность рисования. Каждый символ с известным боксом сортируется по вертикальному центру бокса — верх страницы первым, затем по левому краю. Символы, чьи вертикальные протяжённости перекрываются достаточно, делят строку, и тот тест смотрит только на высоту. Горизонтальная дистанция в нём не участвует. Затем каждая строка присоединяется к тому существующему блоку где угодно на странице, который подходит ей лучше всего по тому же правилу перекрытия-и-зазора, а готовые блоки сортируются по верхнему краю, с левым краем как тай-брейком в пределах полпункта
Второе правило — откуда берётся открывающий пример. Когда две колонки статьи делят базовую сетку, первая строка левой колонки и первая строка правой перекрываются вертикально, поэтому физическая раскладка кладёт их на одну строку. Зазор на переплёте шире четверти размера шрифта, поэтому экстрактор вставляет один пробел и продолжает. Каждая строка корпуса поступает так же, слитые строки перекрывают друг друга по горизонтали, и весь двухколоночный корпус становится одним широким блоком, читающимся прямо через переплёт
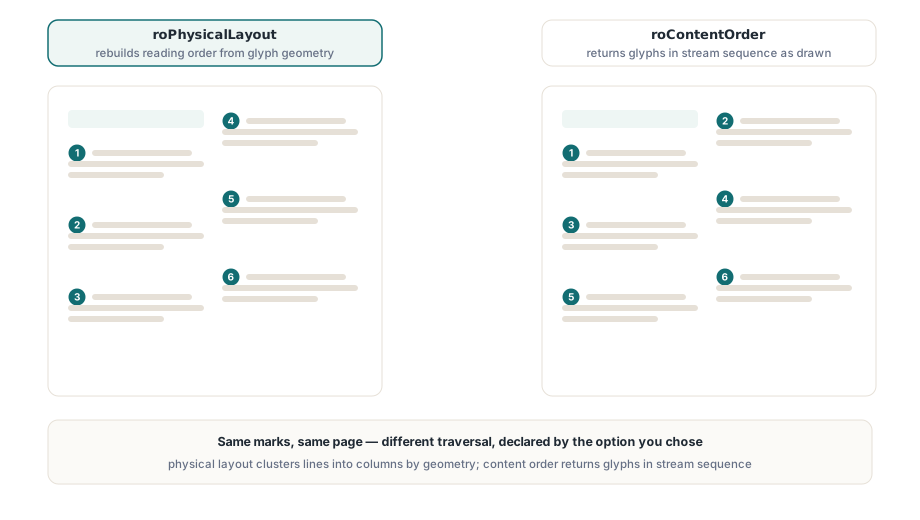
Порядок контента хорошо справляется с такой страницей всякий раз, когда производитель записал колонку одну раньше колонки две, — а процессоры и наборные системы обычно делают именно это. Строки левой колонки стопкуются в блоки, первая строка правой колонки не имеет с ними горизонтального перекрытия и открывает свежий блок, и блоки выходят в авторском порядке. Физическая раскладка отрабатывает своё на другом типе страниц: счета, выписки, формы и слайды, где метка и её значение сидят на одной базовой линии, и чтение ряда слева направо — ровно то, что нужно. Это и режим для страниц с бессмысленной последовательностью рисования: текст, покрашенный шрифт за шрифтом, или страница, собранная из множества мелких наложений
Для смешанной коллекции разделяйте выбор по типу документа. Статьи, отчёты и руководства из известного авторского инструмента идут через roContentOrder; формы и транзакционные документы остаются на дефолте roPhysicalLayout. Приведённая ниже рутина печатает блоки одной страницы в порядке контента, помечая заголовки, когда файл тегирован
uses
  SysUtils, PDFium;

procedure DumpBlocks(Pdf: TPdf; PageNumber: Integer);
var
  Options: TPdfStructuredTextOptions;
  Page: TPdfStructuredTextPage;
  B, L: Integer;
begin
  Pdf.PageNumber := PageNumber;                 // страницы с единицы
  Options := TPdfStructuredTextOptions.Default;
  Options.ReadingOrder := roContentOrder;      // производители колонка за колонкой

  Page := Pdf.GetStructuredText(Options);
  if Page.Source = rosStructure then
    Writeln('block kinds come from the structure tree')
  else
    Writeln('block kinds are inferred from layout');

  for B := 0 to High(Page.Blocks) do
  begin
    if Page.Blocks[B].Kind = cfHeading then
      Writeln(Format('[%d] H%d  %s',
        [B, Page.Blocks[B].HeadingLevel, Page.Blocks[B].Text]))
    else
    begin
      Writeln(Format('[%d] x=%.0f..%.0f, %d line(s)',
        [B, Page.Blocks[B].Bounds.Left, Page.Blocks[B].Bounds.Right,
         Length(Page.Blocks[B].Lines)]));
      for L := 0 to High(Page.Blocks[B].Lines) do
        Writeln('      ', Page.Blocks[B].Lines[L].Text);
    end;
  end;
end;
Как обнаружить строку, перебежавшую переплёт?
Слитая строка выдаёт себя спанами. GetStructuredText открывает новый спан всякий раз, когда следующий символ не прямой преемник предыдущего в исходной символьной последовательности страницы, вдобавок к сменам стиля, разобранным ниже. Внутри одной колонки соседние слова обычно соседние и в источнике. На переплёте слитой строки исходный индекс прыгает на сотни символов, а горизонтальный зазор между двумя спанами намного шире любого словного пробела
Эти два сигнала вместе дают надёжный тест, и его можно прогнать на дефолтном выводе, прежде чем решать, не нужен ли странице порядок контента. Снимок символьных данных, который читает GetStructuredText, кэшируется на страницу, восемь страниц по умолчанию, поэтому повторный запрос той же страницы с другим ReadingOrder перегруппирует данные, уже сидящие в памяти, вместо повторного извлечения страницы
// LineCrossesGutter — помощник, который вы добавите сами: он помечает строку с двумя
// соседними спанами, далёкими друг от друга на странице и не смежными в
// исходной символьной последовательности
function LineCrossesGutter(const Line: TPdfStructuredTextLine;
  MinGap: Double): Boolean;
var
  S: Integer;
  Prev, Cur: TPdfStructuredTextSpan;
begin
  Result := False;
  for S := 1 to High(Line.Spans) do
  begin
    Prev := Line.Spans[S - 1];
    Cur := Line.Spans[S];
    if (Prev.SourceStartIndex < 0) or (Cur.SourceStartIndex < 0) then
      Continue;                                 // блоки alternate-text
    if (Cur.Bounds.Left - Prev.Bounds.Right > MinGap) and
       (Cur.SourceStartIndex <>
        Prev.SourceStartIndex + Prev.SourceCharacterCount) then
      Exit(True);
  end;
end;

function ExtractWithFallback(Pdf: TPdf): TPdfStructuredTextPage;
var
  Options: TPdfStructuredTextOptions;
  B, L, Lines, Crossing: Integer;
begin
  Options := TPdfStructuredTextOptions.Default;   // roPhysicalLayout
  Result := Pdf.GetStructuredText(Options);

  Lines := 0;
  Crossing := 0;
  for B := 0 to High(Result.Blocks) do
    for L := 0 to High(Result.Blocks[B].Lines) do
    begin
      Inc(Lines);
      if LineCrossesGutter(Result.Blocks[B].Lines[L], 18) then
        Inc(Crossing);
    end;

  // четверть строк, пересекающих зазор, похожа на колонки, а не на ряд формы
  if (Lines > 0) and (Crossing * 4 >= Lines) then
  begin
    Options.ReadingOrder := roContentOrder;
    Result := Pdf.GetStructuredText(Options);
  end;
end;
Восемнадцать пунктов — четверть дюйма: заметно шире словного пробела в основном тексте и уже большинства переплётов. Порог «одна из четырёх» держит счёт с несколькими рядами метка-и-сумма на физической раскладке, тогда как настоящий двухколоночный корпус, где пересекается почти каждая строка, переключается. Если производитель записал страницу ряд за рядом поперёк обеих колонок, исходные индексы остаются смежными, тест никогда не срабатывает, и ни один порядок не разведёт колонки за вас; той странице нужен режим колонок readable-content API, описанный в материале о чтении двух колонок с простирающимся заголовком
Что меняет IncludeSemantics, а что оставляет в покое?
IncludeSemantics помечает блоки; он их не переставляет. С включённой опцией GetStructuredText читает readable content страницы и даёт каждому блоку вид того фрагмента, который тот перекрывает наибольшей площадью. Доступные виды: cfParagraph, cfHeading с HeadingLevel, cfListItem, cfTableCell, cfCaption, cfFigure, cfLink, cfOther для любого другого тега и cfPlain, когда не совпало ничего. Каждый блок также подхватывает Language и StructElementIndex, привязывающий его к элементу дерева структуры
Поле Source говорит, откуда пришла метка: rosStructure, когда у страницы есть пригодное дерево структуры в смысле ISO 32000-1 §14.7, rosHeuristic, когда виды были выведены. Page.Source даёт тот же ответ для страницы в целом. Заголовок, отчитанный с rosStructure, — заголовок, потому что автор его тегировал; отчитанный с rosHeuristic — образованная догадка, и индексирующий конвейер, взвешивающий заголовки, должен обращаться с ними по-разному. Порядок блоков в обоих случаях всё равно исходит из ReadingOrder. Семантический проход пользуется дефолтами readable-content, поэтому настройка колонок через ReadableContentOptions до GetStructuredText не дотягивается
У фигур есть одно дополнительное правило. На тегированной странице элемент Figure или alternate text, не сопоставленный ни с одним текстовым блоком, дописывается собственным блоком, держащим альтернативное описание своим текстом. У такого блока одна строка и один спан с SourceStartIndex равным -1, ибо ни один глиф страницы его не произвёл. Код, маппящий спаны обратно в символы, обязан пропускать это значение — поэтому тест переплёта выше его и проверяет. Сами проверки дерева структуры разобраны в материале о валидации дерева структуры PDF/UA
Спаны, bounds и дорога обратно к символам
Каждый TPdfStructuredTextSpan несёт свой текст, свои bounds, FontName, FontSize, FontWeight и Angle, плюс SourceStartIndex и SourceCharacterCount. Со включённым IncludeFontInfo спан кончается там, где меняется любое из четырёх стилевых значений, поэтому предложение с тремя жирными словами посередине приезжает тремя спанами, и акцент можно восстановить из FontWeight, а не гадать по именам шрифтов. С выключенным IncludeFontInfo стилевые поля остаются пустыми, и спаны рвутся только там, где прервана исходная последовательность
Угол важен на страницах со штампами. Диагональная watermark DRAFT живёт в том же координатном пространстве, что основной текст, и в физической раскладке её буквы могут попасть на пересекаемые ими по вертикали строки корпуса. Спаны с ненулевым Angle легко выбросить, прежде чем склеивать текст для индексации
Два исходных поля — то, что превращает поисковое попадание в нечто рисуемое. Они индексируют символьную последовательность страницы, поэтому фраза, найденная в блоке, напрямую конвертируется в боксы символов для подсветки — подходом из материала о визуальном выделении строк текста боксами символов. Когда цель — reflow или HTML-форма страницы, те же блоки кормят модель reflow и её HTML-экспорт
Бюджет символов и два счётчика качества
MaxCharacters отвергает страницу целиком, когда символов в ней больше дозволенного. GetStructuredText проверяет счёт прежде, чем выделить какие-либо рабочие массивы, и переполненная страница поднимает EPdfError с сообщением Structured text character budget exceeded; частичная страница не возвращается никогда. Значение должно быть положительным. Посимвольный снимок страницы, который читает метод, имеет собственный дефолтный потолок в 1 000 000 символов и 100 000 текстовых объектов, отчитываемый как Text snapshot budget exceeded, так что MaxCharacters выше миллиона более крупную страницу не пропустит
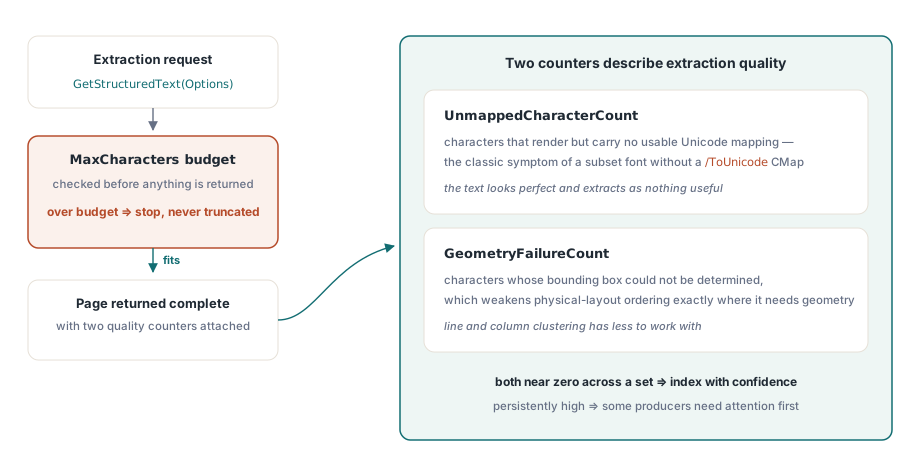
UnmappedCharacterCount считает символы, для которых PDFium вообще не смог произвести значение Unicode. Такие символы появляются как U+FFFD в каждом поле Text. Обычная причина — сабсет-шрифт с пользовательской кодировкой и без CMap /ToUnicode — случай, который описывает ISO 32000-1 §9.10.2, где текст рендерится правильно и не может быть надёжно извлечён. Счётчик меряет только недостающие маппинги: глиф, чья запись /ToUnicode называет неверную кодовую точку, считается смаппленным, поэтому страница правдоподобно выглядящей абракадабры всё ещё может отчитать ноль
GeometryFailureCount считает символы без пригодного бокса, исключая разрывы строк. В порядке контента такие символы просто следуют за соседями. В физической раскладке им нечего сортировать — нет позиции, поэтому их кладут после каждого позиционированного символа, и они оказываются прицеплены к нижней строке страницы. Страница с ненулевым геометрическим счётчиком и странными фрагментами на последней строке показывает ровно это
// LogRejected и LogQuality — ваши собственные рутины логирования
function ExtractForIndex(Pdf: TPdf; PageNumber: Integer;
  out Page: TPdfStructuredTextPage): Boolean;
var
  Options: TPdfStructuredTextOptions;
begin
  Result := False;
  Pdf.PageNumber := PageNumber;
  Options := TPdfStructuredTextOptions.Default;
  Options.MaxCharacters := 200000;              // лимит приёма для этого конвейера
  try
    Page := Pdf.GetStructuredText(Options);
  except
    on E: EPdfError do
    begin
      LogRejected(PageNumber, E.Message);       // бюджет символов или снимка
      Exit;
    end;
  end;

  if Page.UnmappedCharacterCount * 20 > Page.CharacterCount then
    LogQuality(PageNumber, Format('%d of %d characters have no Unicode value',
      [Page.UnmappedCharacterCount, Page.CharacterCount]));
  if (Options.ReadingOrder = roPhysicalLayout) and
     (Page.GeometryFailureCount > 0) then
    LogQuality(PageNumber, Format('%d characters without a box; check the last line',
      [Page.GeometryFailureCount]));
  Result := True;
end;
Если страница нужна вам только как строка, извлечение текста из PDF-документов разбирает более простые вызовы, а чтение и запись помеченного контента BDC и MCID уходит уровнем ниже дерева структуры. Модель структурной страницы, readable-content ридер и reflow-экспорт едут в компоненте для Delphi и Lazarus, описанном на странице продукта PDFium Component