Таймаут распознавания 5000 мс у in-process вызова Tesseract не означает, что вызов вернётся через пять секунд. С большим мультиязычным набором моделей вызывающий поток может оставаться внутри нативной библиотеки заметно дольше этой отметки: monitor прогресса, который следит за дедлайном, опрашивается во время распознавания слов, а загрузка моделей и анализ раскладки страницы происходят до первого опроса. Этот зазор, cancel-callback с однобайтовым C-типом возврата и итератор, раздающий память, которую вы не должны освобождать, — вот настоящая работа по привязке C API Tesseract к Delphi. Остальное — обвязка
Подключение Tesseract DLL к текстовому слою HotPDF
HotPDF открывает in-process путь как HPDFCreateTesseractDLLOCREngine в юните HPDFTesseractRecognition. Фабрика грузит DLL Tesseract, экспортирующий C API, управляет TessBaseAPIInit2, TessBaseAPIRecognize и result iterator и возвращает IHPDFOCREngine. THotPDF.ApplyLoadedOCRTextLayer принимает этот движок и добавляет к отсканированным страницам невидимый searchable Unicode-текстовый слой — тот же вызов, через который проходят все OCR-движки HotPDF
Фабрика валидирует заранее. Файл DLL и каталог tessdata должны существовать. Идентификатор языка может содержать только ASCII-буквы, цифры, _ и +, и каждой модели в комбинации вроде chi_sim+eng нужен соответствующий файл .traineddata. Все 21 обязательный экспорт должны разрешиться, прежде чем вы получите движок. Ошибки конфигурации поднимают EArgumentException, причём отсутствующий экспорт или модель называется по имени; DLL, который не грузится, поднимает EOSError с кодом ошибки Windows и подсказкой проверить архитектуру и зависимости
uses
  SysUtils, HPDFDoc, HPDFTesseractRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // Win64-приложению нужен 64-битный DLL; имя файла зависит от вашей сборки,
  // а зависимые DLL лежат в той же папке
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract.dll',
    'C:\OCR\tessdata', 'chi_sim+eng');   // берёт THPDFTesseractOptions.Default
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;   // 300 DPI, MinimumConfidence 0.5
    // Пустой список страниц означает все страницы; страницы, где текст уже есть, пропускаются
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' words accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFTesseractOptions.Default ставит PageSegMode в tpsAuto, EngineMode в temDefault, TimeoutMilliseconds в 60000 и MaxPixels в 16777216. Этот пиксельный бюджет кусается раньше, чем ожидают. Страница US Letter при дефолтных 300 DPI рендерится в 2550 × 3300 пикселей, около 8.4 миллиона — влезает. Поднимите ту же страницу до 600 DPI: получится 5100 × 6600, примерно 33.7 миллиона пикселей, и движок отвергнет её с сообщением Invalid Tesseract DLL OCR request or pixel budget прежде, чем Tesseract вообще увидит изображение. Либо поднимите MaxPixels (потолок 67108864), либо оставайтесь на 300 DPI — для основного текста их достаточно; каждая сторона также ограничена 32767 пикселями
DLL грузится через LoadLibraryEx с флагами поиска для собственной папки DLL плюс безопасных директорий по умолчанию. Поэтому библиотеки изображений, от которых зависит Tesseract, могут лежать рядом, и вам никогда не придётся трогать PATH или полагаться на текущий каталог. HotPDF не поставляет и не скачивает OCR-рантайм или какие-либо языковые модели; и то и другое разворачиваете вы
Что меняет DLL-путь по сравнению с tesseract.exe
Тот же распознаватель доступен и через внешний адаптер tesseract.exe, который пишет BMP и разбирает TSV. Оба адаптера кормят один текстовый конвейер, так что отображение координат, фильтрация по уверенности и коммит «всё или ничего» ведут себя одинаково. Различается то, как пиксели заходят, как выходят слова и что происходит, когда распознаватель ведёт себя плохо
| Аспект | Адаптер tesseract.exe | Адаптер Tesseract DLL |
|---|---|---|
| Фабрика | HPDFCreateTesseractOCREngine | HPDFCreateTesseractDLLOCREngine |
| Пиксели на входе | BMP-файл в приватном временном каталоге | 8-битный grayscale-буфер в памяти |
| Слова на выходе | Пословный TSV с потолком 64 МиБ | Result iterator, UTF-8 на слово |
| Базовые линии | В TSV их нет; конвейер оценивает их сам | Пробрасываются из TessPageIteratorBaseline |
| Сегментация страницы и режим движка | Перегрузка THPDFTesseractOptions, уходит как --psm и --oem | THPDFTesseractOptions, уходят в TessBaseAPISetPageSegMode и TessBaseAPIInit2 |
| Пиксельный бюджет | MaxPixels, когда переданы опции | MaxPixels всегда, плюс 32767 пикселей на сторону |
| Таймаут | Жёсткий: дочерний процесс терминируется | Кооперативный: Tesseract должен сам заметить |
| Изоляция сбоев и памяти | Отдельный процесс | Нет, делит ваше адресное пространство |
Одна цена остаётся у DLL. Каждый вызов Recognize создаёт собственный экземпляр API и гоняет TessBaseAPIInit2, то есть языковые модели инициализируются для каждой страницы. Файловый кэш смягчает перезагрузку, но с большим мультиязычным набором моделей это всё равно крупнейшая фиксированная цена страницы, и она тратится из бюджета дедлайна распознавания. In-process движок RapidOCR DLL делает противоположный выбор и держит свои ONNX-модели резидентными на весь срок жизни движка, тогда как пограничные проблемы (C ABI, заёмные буферы, нативная работа, которую нельзя прервать) принадлежат к тому же семейству
Так кто из них идёт в продакшен? Для десктопной утилиты или пакетного задания, проходящего несколько сотен сканов, DLL подходит лучше: нет запуска процесса на страницу, нет временного битмапа на диске, и есть настоящие базовые линии для наклонённых строк. Долго живущий сервер, принимающий PDF от чужих людей, должен оставаться на tesseract.exe: нативный краш или разошедшееся выделение памяти там валит один дочерний процесс, а не ваш сервис
Почему Delphi не может скопировать структуру monitor Tesseract?
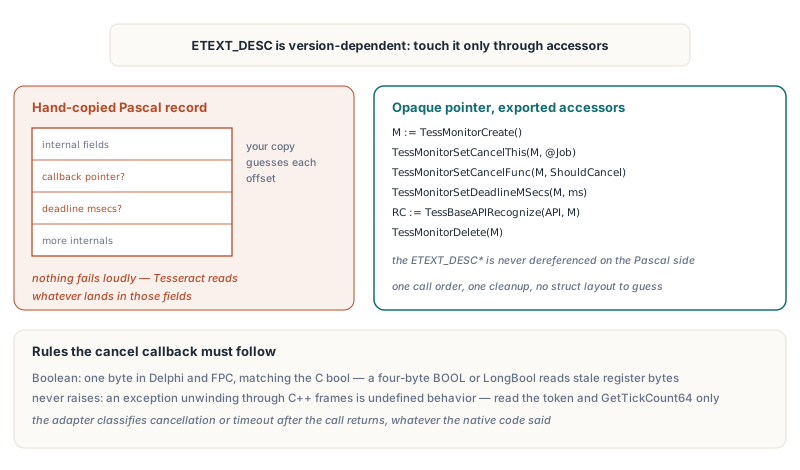
Delphi не может безопасно отзеркалить monitor прогресса Tesseract, потому что ETEXT_DESC несёт внутренние поля, меняющиеся между сборками Tesseract. Запись, переведённая вручную из одного заголовка, кладёт cancel-callback и дедлайн по тем смещениям, что были в этом заголовке. Прогоните её против другой сборки — и Tesseract прочитает ваш указатель на callback из поля, которое теперь означает что-то другое, или вообще не найдёт дедлайн, и распознавание просто дойдёт до конца
Поэтому адаптер HotPDF держит monitor как непрозрачный указатель и трогает его только через экспортируемые функции: TessMonitorCreate, TessMonitorSetCancelThis, TessMonitorSetCancelFunc, TessMonitorSetDeadlineMSecs и TessMonitorDelete. Набросок ниже — ваш собственный биндинг, а не API HotPDF; его объявления совпадают с теми, что адаптер разрешает через GetProcAddress
type
  // C: typedef bool (*TessCancelFunc)(void *cancel_this, int words);
  TTessCancelFunc = function(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
  TTessMonitorCreate = function: Pointer; cdecl;   // ETEXT_DESC*, никогда не разыменовывается
  TTessMonitorDelete = procedure(Monitor: Pointer); cdecl;
  TTessMonitorSetCancelFunc = procedure(Monitor: Pointer; Func: TTessCancelFunc); cdecl;
  TTessMonitorSetCancelThis = procedure(Monitor, CancelThis: Pointer); cdecl;
  TTessMonitorSetDeadlineMSecs = procedure(Monitor: Pointer; MSecs: Integer); cdecl;
  TTessBaseAPIRecognize = function(Handle, Monitor: Pointer): Integer; cdecl;

  // Ваше состояние задания, не тип HotPDF
  TOCRJob = record
    CancelRequested: Boolean;
    DeadlineTick: UInt64;
  end;
  POCRJob = ^TOCRJob;

function ShouldCancel(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
begin
  // Исполняется на стеке Tesseract: читать флаг и часы, исключения не поднимать
  Result := (CancelThis = nil) or POCRJob(CancelThis)^.CancelRequested or
    (GetTickCount64 >= POCRJob(CancelThis)^.DeadlineTick);
end;

// Использование (указатели функций разрешены через GetProcAddress):
//   Monitor := MonitorCreate();
//   try
//     MonitorSetCancelThis(Monitor, @Job);
//     MonitorSetCancelFunc(Monitor, ShouldCancel);
//     MonitorSetDeadlineMSecs(Monitor, RemainingMs);
//     RC := BaseAPIRecognize(API, Monitor);
//   finally
//     MonitorDelete(Monitor);
//   end;
В наброске callback типизирован как Boolean — один байт и в Delphi, и в Free Pascal, что совпадает с C bool в TessCancelFunc. Четырёхбайтовые Windows BOOL и Delphi LongBool выглядят взаимозаменяемыми и являются другим типом: когда одна сторона пишет один байт, а другая читает четыре, старшие три байта — это то, что было в регистре до того, и false может приехать как true. TessPageIteratorBoundingBox возвращает int, объявленный на стороне Pascal как Integer, поэтому читайте C-тип каждого возвращаемого значения, вместо того чтобы предполагать одно правило на весь API
Callback к тому же никогда не поднимает исключений. Delphi-исключение, разматывающееся через C++-кадры Tesseract, — неопределённое поведение. Callback HotPDF читает только токен отмены и монотонное значение GetTickCount64, а адаптер превращает исход в диагностику отмены или таймаута после возврата TessBaseAPIRecognize. Эту проверку он выполняет независимо от того, был ли нативный код возврата 0
Какими нативными указателями владеет сторона Delphi?
Адаптер Tesseract DLL в HotPDF владеет тремя нативными объектами на каждый запрос (экземпляр API, monitor и result iterator) и заимствует всё остальное. Каждый вызов Recognize создаёт свой набор и освобождает его в блоке finally в фиксированном порядке: TessResultIteratorDelete, затем TessMonitorDelete, затем TessBaseAPIDelete. Освобождение интерфейса движка вызывает FreeLibrary для DLL
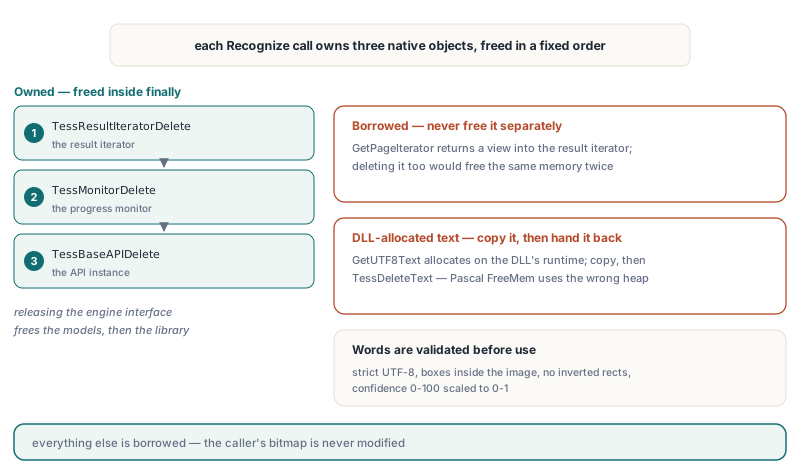
TessResultIteratorGetPageIteratorвозвращает представление внутрь result iterator, а не новый объект. Адаптер использует его дляTessPageIteratorBoundingBoxиTessPageIteratorBaselineи никогда не освобождает; удалить его вдобавок значило бы отпустить ту же память дваждыTessResultIteratorGetUTF8Textвозвращает строку, выделенную собственным рантаймом DLL. Адаптер декодирует её и возвращает обратно черезTessDeleteTextв блокеfinally, потому что паскалевскийFreeMemосвободил бы её на чужой куче- Текст слова проходит строгую UTF-8-декодировку с предварительной проверкой длины. Слово с управляющими символами, кривым UTF-8, боксом вне изображения, перевёрнутым прямоугольником или уверенностью вне диапазона 0–100 валит запрос; адаптер его не латает
- Текст на запрос ограничен 1048576 UTF-16-кодовыми единицами, а число слов должно влезать в бюджет, который
ApplyLoadedOCRTextLayerспускает с каждой страницей
Уверенность приходит как 0–100 и масштабируется в 0–1, так что THPDFOCRTextLayerOptions.MinimumConfidence означает одно и то же для всех движков. Когда Tesseract сообщает базовую линию, обе её точки пробрасываются дальше, а для преимущественно вертикального слова шириной бокса служит высота текста. Без базовой линии текстовый конвейер откатывается к геометрической оценке — ровно как для TSV-входа
Проверка диапазона enum-опций до того, как они доедут до DLL
Фабрика копирует сырые байты PageSegMode и EngineMode в Integer, прежде чем проверять их диапазон. Компилятор вправе считать, что enum-переменная всегда держит объявленное значение, поэтому проверка вроде Ord(X) > Ord(High(T)), написанная прямо по enum, может быть свёрнута в константный false. Эти ординалы доезжают до DLL как простые целые: THPDFTesseractPageSegMode повторяет нумерацию сегментации страницы Tesseract от 0 до 13, а THPDFTesseractEngineMode — нумерацию режимов движка от 0 до 3. Запись опций, очищенная FillChar, прочитанная из потока или заполненная из C++Builder через приведение к целому, может нести байт вроде 200, и валидация копии превращает это в EArgumentException ещё на фабрике. Фабрика также отвергает tpsOSDOnly и tpsAutoOnly, которые не возвращают ни одного слова, и требует osd.traineddata для tpsAutoOSD и tpsSparseTextOSD
Что на самом деле гарантирует таймаут распознавания?
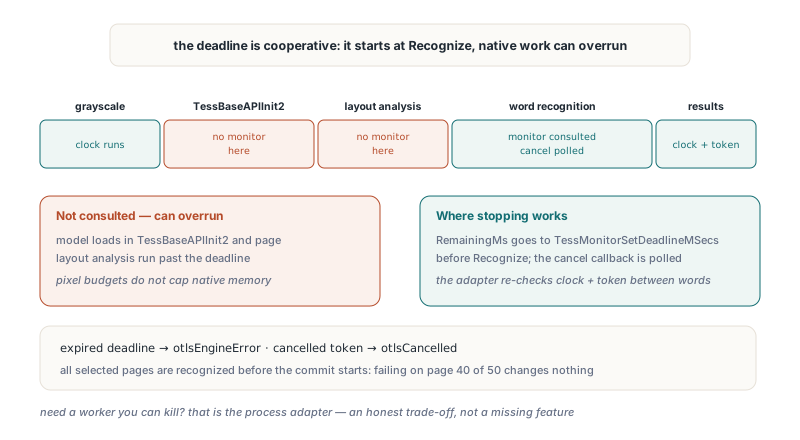
Таймаут Tesseract DLL кооперативный: HotPDF может остановить свою работу и попросить Tesseract остановиться, но не может заставить нативный код вернуться. Часы стартуют при входе в Recognize, так что конверсия в градации серого и инициализация моделей тратят тот же бюджет, что и само распознавание. Адаптер проверяет истёкшее время и токен отмены каждые 64 строки при конверсии в grayscale, после инициализации и перед каждым словом при проходе результатов. Прямо перед TessBaseAPIRecognize он передаёт оставшиеся миллисекунды в TessMonitorSetDeadlineMSecs
Зазор сидит внутри нативных вызовов. Tesseract сверяется со своим monitor только во время распознавания слов, поэтому внутри TessBaseAPIInit2 или анализа раскладки страницы медленная загрузка модели или патологическая раскладка может пересидеть дедлайн прежде, чем таймаут будет доложен. Пиксельный и текстовый бюджеты тоже не ограничивают собственное потребление памяти нативной библиотекой. Когда нужен воркер, который можно убить напрямую, инструмент для этого — процессный адаптер
Сегментация страницы — там, где DLL-адаптер окупается на неудобном входе. Формы, этикетки и отсканированные таблицы с разрозненными полями часто лучше распознаются с tpsSparseText, чем с автоматической сегментацией, которая пытается собрать колонки и абзацы, которых нет. Таймаут ниже для страницы формы короткий, и ему всё равно приходится покрывать инициализацию моделей
procedure OCRFormPages(Doc: THotPDF; const Pages: array of Integer);
var
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  LayerOptions: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default;
  TessOptions.PageSegMode := tpsSparseText;  // разрозненные поля, без сборки колонок
  TessOptions.EngineMode := temLSTMOnly;     // нужны LSTM-модели в tessdata
  TessOptions.TimeoutMilliseconds := 20000;  // включает инициализацию моделей
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract.dll',
    'C:\OCR\tessdata', 'eng+deu', TessOptions);

  LayerOptions := THPDFOCRTextLayerOptions.Default;
  LayerOptions.MinimumConfidence := 0.6;
  if not Doc.ApplyLoadedOCRTextLayer(Pages, Engine, LayerOptions, Info) then
    case Info.Status of
      otlsCancelled:
        Writeln('OCR cancelled, document unchanged');
      otlsEngineError:
        if Pos('timed out', string(Info.Diagnostic)) > 0 then
          Writeln('Tesseract timed out, document unchanged')
        else
          Writeln('Tesseract failed: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
Таймаут всплывает как otlsEngineError с текстом Tesseract DLL OCR timed out в диагностике. Токен, заданный через THPDFOCRTextLayerOptions.CancellationToken, всплывает как otlsCancelled. В обоих случаях ApplyLoadedOCRTextLayer распознаёт все выбранные страницы, прежде чем начать коммит, так что сбой на странице 40 из 50 оставляет загруженный документ ровно как был. tpsSingleLine, tpsSingleBlock и tpsSparseText меняют только сегментацию; ни один из них не выпрямляет кривой скан
Free Pascal и Lazarus: протухшие пиксели и потерянный китайский
Обе фабрики Tesseract работают в Windows-сборках Free Pascal и Lazarus Win32 и Win64, как только Lazarus-пакет пересобран под целевую архитектуру; общий порт разобран в HotPDF на Free Pascal и Lazarus Win64. Обработка входа — вот где FPC ведёт себя иначе
LCL TBitmap, записываемый через scanlines, может обновить сырое изображение, не обновив Windows-хендл битмапа, и тогда GetDIBits по этому хендлу вернёт старые пиксели. Симптом сбивает с толку: текст, нарисованный прямо на битмапе, распознаётся, а страница, отрендеренная через scanlines, не даёт ни слова. В FPC DLL-адаптер читает снимок с учётом формата через CreateIntfImage, который уважает пиксельный формат и порядок строк сырого изображения. Сборка Delphi держит путь GetDIBits на приватной 24-битной копии, и ни одна сборка не модифицирует битмап вызывающего
Адаптер tesseract.exe встречает другую проблему. TStringList в FPC хранит ANSI-строки, поэтому присваивание декодированного UTF-8 TSV-текста в Lines.Text теряет все китайские символы и символы supplementary-плоскостей, которые системная ANSI-кодовая страница не может представить. FPC-путь держит TSV как UTF-8-байты, отрезает BOM на байтовом уровне и сам декодирует каждое слово в UnicodeString. DLL-адаптер с проблемой не встречается вообще, поскольку декодирует каждое слово прямо из итератора
Адаптер Tesseract DLL поставляется вместе с процессными адаптерами и встроенным OCR-движком в HotPDF для Delphi, C++Builder и Free Pascal. Редакции и загрузки перечислены на странице HotPDF Delphi PDF component