Пайп, который никогда не докладывает end-of-file, — странная ошибка для OCR-фичи. Один поток вашего приложения читает стандартный вывод хелпер-программы и ждёт, когда ReadFile упадёт с ERROR_BROKEN_PIPE. Другой поток стартует tesseract.exe через CreateProcess с bInheritHandles в True, потому что именно так отдают дочернему процессу файл для его стандартного вывода ошибок. Write-конец пайпа хелпера был наследуемым, поэтому Tesseract теперь владеет его копией, и читающий поток виснет, пока Tesseract не закончит свою страницу — а при 300 DPI скане с двумя загруженными языковыми моделями это не быстро
Внешний распознаватель приносит больше, чем зависание: что видит ребёнок, что делать с наполовину валидным выводом, как превратить пиксельные боксы в searchable PDF-текст. Встроенный template-matching OCR нарочно покрывает машинопечатные ASCII-буквы и цифры. Имена с диакритикой, китайские договоры и смешанные языковые архивы требуют обученных языковых моделей, и Tesseract — обычный кандидат, потому что это консольная программа, которую можно поставить рядом с вашим исполняемым файлом
Подключение Tesseract к OCR-текстовому слою HotPDF
HotPDF заворачивает локально установленный исполняемый файл Tesseract в IHPDFOCREngine через HPDFCreateTesseractOCREngine в юните HPDFTesseractRecognition. Вы передаёте этот движок в THotPDF.ApplyLoadedOCRTextLayer, который рендерит каждую запрошенную страницу, гоняет Tesseract по разу на страницу, фильтрует слова и пишет невидимый Unicode-текстовый слой для всех запрошенных страниц одной транзакцией — или ни для одной. Отображение координат, поворот, фильтрация по уверенности и коммит — конвейер, который встроенный движок уже использует; меняется только распознавание
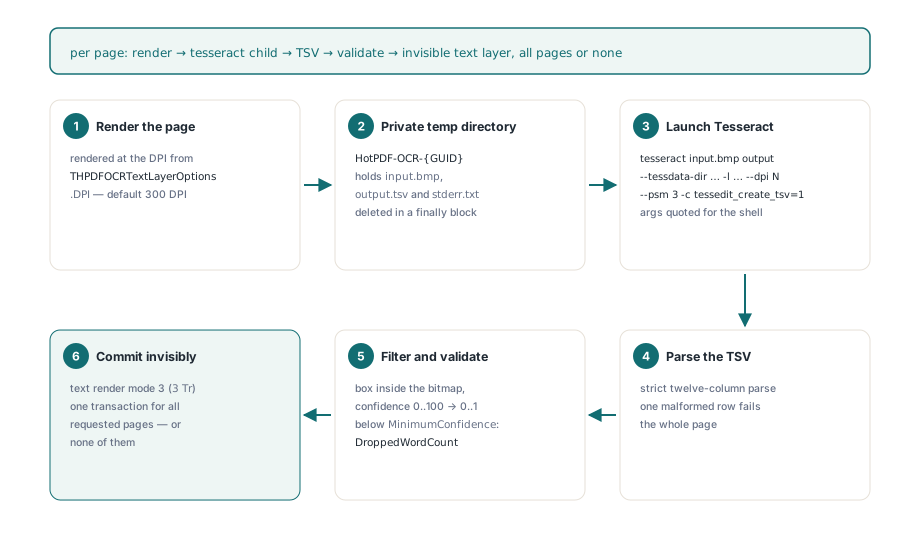
Фабрика поднимает EArgumentException до того, как тронута хоть одна страница. Исполняемый файл и каталог tessdata должны существовать, таймаут должен лежать между 1 и 3600000 миллисекунд, а язык может содержать только ASCII-буквы, цифры, _ и +, потому что он попадает в командную строку: eng+chi_sim легитимно, значение с кавычками или пробелами — инъекция, ждущая своего часа. Второй перегруз принимает запись THPDFTesseractOptions. Его Default даёт --psm 3, --oem 3, 60 секунд на страницу и потолок 16777216 пикселей, и он отвергает tpsOSDOnly и tpsAutoOnly — два режима, не возвращающие ни одного слова
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFTesseractRecognition;

function MakeSearchable(const SourceFile, TargetFile: string;
  Token: THPDFCancellationToken): Boolean;
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default; // psm 3, oem 3, 60 с, 16777216 px
  TessOptions.TimeoutMilliseconds := 120000;    // действует на каждую страницу
  // поднимает EArgumentException для отсутствующего исполняемого файла или папки tessdata,
  // кривого идентификатора языка или опций вне их диапазонов
  Engine := HPDFCreateTesseractOCREngine(
    'C:\OCR\Tesseract\tesseract.exe',
    'C:\OCR\Tesseract\tessdata',
    'eng+chi_sim',                              // модели, склеенные через '+'
    TessOptions);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default; // 300 DPI, MinimumConfidence 0.5
    Options.CancellationToken := Token;
    // пустой список страниц значит все; страницы, где текст уже есть, пропускаются
    Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
    if Result then
    begin
      Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
        ' words kept, ', Info.DroppedWordCount, ' below the threshold');
      Doc.SaveLoadedDocument(TargetFile);
    end
    else
      case Info.Status of
        otlsCancelled:      Writeln('Cancelled, document unchanged');
        otlsEngineError:    Writeln('Engine: ', string(Info.Diagnostic));
        otlsBudgetExceeded: Writeln('Budget: ', string(Info.Diagnostic));
      else
        Writeln(string(Info.Diagnostic));
      end;
  finally
    Doc.Free;
  end;
end;
Сделайте пиксельную арифметику один раз. Страница A4 при 300 DPI — около 2481 на 3508 пикселей, грубо 8.7 миллиона — влезает. Страница A3 при том же разрешении — около 3508 на 4961, близко к 17.4 миллиона, поэтому она валится с диагностикой пиксельного бюджета, и прогон кончается otlsEngineError. Перегруз, принимающий один лишь таймаут, пиксельного потолка не применяет вовсе. Для сервиса, принимающего файлы извне, держите перегруз с опциями и нарочно поднимайте MaxPixels (до 67108864) или опускайте THPDFOCRTextLayerOptions.DPI, когда ожидаются большие форматы
На страницу движок создаёт приватный каталог HotPDF-OCR-{GUID} под temp-путём, сохраняет битмап как input.bmp и запускает tesseract input.bmp output --tessdata-dir … -l … --dpi N --psm 3 -c tessedit_create_tsv=1, добавляя --oem, когда задан режим движка. Пути квотируются по правилам Windows для обратных слешей и встроенных кавычек, а --dpi несёт разрешение рендера, чтобы Tesseract никогда его не угадывал. Tesseract и его файлы .traineddata в комплект не входят; развернуть их — работа приложения. На наших собственных Linux-тестовых машинах распознаватель запускается из пользовательского бандла бинарника, замыкания его shared-библиотек и папки tessdata, потому что опора на /usr/bin/tesseract работает только там, где кто-то поставил системный пакет
Почему одна кривая строка TSV опустошает всю страницу?
Адаптер Tesseract валит всю страницу на первой кривой строке, потому что частично разобранный список слов даёт текстовый слой, расходящийся с изображением, и ничто в сохранённом PDF не скажет, какие слова пропали. Вывод должен декодироваться как строгий UTF-8 без встроенных NUL. Первая строка должна равняться двенадцатиколоночному заголовку Tesseract от level до text — после отрезания опционального BOM. Каждая строка должна делиться ровно на двенадцать полей, и деление останавливается после одиннадцатого таба, поэтому таб внутри распознанного текста попадает в текстовое поле вместо создания тринадцатой колонки, которую затем отвергнет проверка управляющих символов ниже
Словами являются только строки уровня 5; строки страницы, блока, абзаца и линии пропускаются, как и слова пустые или из одних пробелов. Слово с управляющим символом (ниже U+0020 или от U+007F до U+009F) валит страницу. Остальным нужны целочисленная геометрия, уверенность, разобранная с инвариантным форматированием, чтобы приложение с немецкой локалью всё равно прочло 93.5, бокс целиком внутри битмапа и уверенность от 0 до 100. Одно валидное слово плюс одна кривая строка дают ноль слов
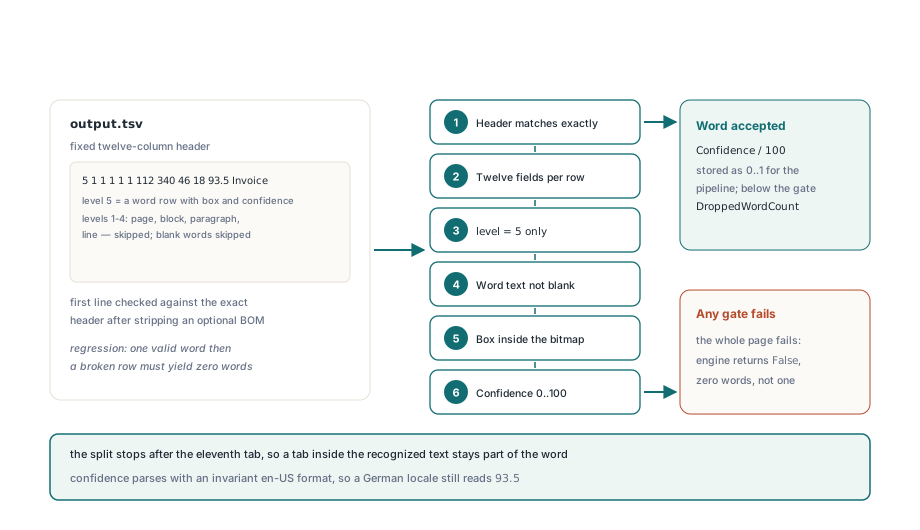
Одна странная строка, стало быть, валит весь прогон и оставляет каждую страницу нетронутой. Это правильный размен. Перезапуск дёшев; searchable PDF, в котором поиск номера счёта не находит единственную важную страницу, всплывает месяцами позже — в чужих руках
Последний шаг тоже встречает дефолт, которого можно не ожидать. Tesseract докладывает уверенность от 0 до 100, конвейер делит на 100, а THPDFOCRTextLayerOptions.MinimumConfidence по умолчанию 0.5, поэтому любое слово ниже 50 попадает в Info.DroppedWordCount вместо страницы. На чистом скане этот пол разумен. На шумном факсе он может снять большую долю текста, поэтому сравнивайте Info.ReceivedWordCount с Info.AcceptedWordCount, прежде чем его опускать
Повторный OCR на файле, где текст уже есть
SkipPagesWithText по умолчанию True, и это ловит людей на второй раз. Положим, партия обработана с eng, а теперь требует eng+deu: каждая страница уже несёт невидимый текст, поэтому Info.SkippedPageCount равен числу страниц. HotPDF помечает записанный им контентный поток как собственный OCR-слой, и ReplaceExistingOCRTextLayer использует эту метку, чтобы распознать эти страницы заново, сбросив старый слой и сохранив исходное содержимое страницы
Options := THPDFOCRTextLayerOptions.Default;
Options.ReplaceExistingOCRTextLayer := True;  // заменить наш прежний слой
Options.UseOptionalContentGroup := True;      // слой с именем 'OCR Text Layer'
Options.CancellationToken := Token;
if Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
  Writeln(Info.ReplacedPageCount, ' replaced, ',
    Info.SkippedPageCount, ' skipped, ',
    Info.RecognizedPageCount, ' recognized')
else
  Writeln(string(Info.Diagnostic));
Файл, прогнанный через OCR драйвером сканера, такой метки не несёт, поэтому его страницы всё ещё считаются страницами с текстом. Выключение SkipPagesWithText сложит второй невидимый слой поверх первого, и каждое попадание в поиске будет показываться дважды. Оставьте такие файлы в покое
Какие хендлы наследует процесс Tesseract?
Дочерний процесс Tesseract наследует от HotPDF ровно два хендла: один, открытый на NUL для стандартного ввода и вывода, и один для stderr.txt в приватном каталоге. Зависание на пайпе выше приходит от самого CreateProcess: bInheritHandles = True требуется для передачи стандартных хендлов, и сам по себе он передаёт каждый наследуемый хендл в хосте — включая пайпы, файлы и события, открытые посторонним кодом. HotPDF использует STARTUPINFOEX со списком атрибутов, несущим PROC_THREAD_ATTRIBUTE_HANDLE_LIST, и флагом EXTENDED_STARTUPINFO_PRESENT. bInheritHandles остаётся True, но пересекают границу только перечисленные хендлы
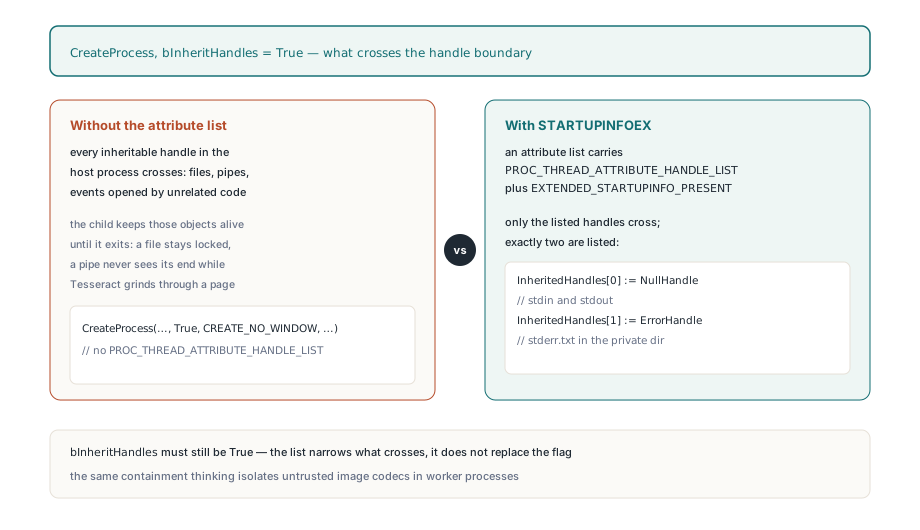
Тот же паттерн принадлежит каждому другому дочернему процессу, который стартует ваше приложение, поскольку одного запускальщика, наследующего всё, достаточно, чтобы повесить каждого читателя пайпов в процессе:
// Паттерн для ваших собственных вызовов CreateProcess (фрагмент: NullHandle, ErrorHandle,
// Exe, CommandLine, WorkDir и ProcessInfo объявлены в другом месте).
// Старые Delphi RTL не объявляют функции списка атрибутов; добавьте свои
// external-объявления из kernel32, если компилятор их не находит
// Проверяйте каждый результат BOOL в продакшен-коде
type
  TStartupInfoExRec = record
    StartupInfo: TStartupInfo;
    AttributeList: Pointer;
  end;
const
  HANDLE_LIST_ATTRIBUTE = $00020002;   // PROC_THREAD_ATTRIBUTE_HANDLE_LIST
  EXTENDED_STARTUP_FLAG = $00080000;   // EXTENDED_STARTUPINFO_PRESENT
var
  Startup: TStartupInfoExRec;
  HandleList: array[0..1] of THandle;
  Size: NativeUInt;
begin
  FillChar(Startup, SizeOf(Startup), 0);
  HandleList[0] := NullHandle;         // создан с bInheritHandle = True
  HandleList[1] := ErrorHandle;        // так же
  Size := 0;
  InitializeProcThreadAttributeList(nil, 1, 0, Size);
  GetMem(Startup.AttributeList, Size);
  InitializeProcThreadAttributeList(Startup.AttributeList, 1, 0, Size);
  UpdateProcThreadAttribute(Startup.AttributeList, 0, HANDLE_LIST_ATTRIBUTE,
    @HandleList[0], SizeOf(HandleList), nil, nil);
  Startup.StartupInfo.cb := SizeOf(Startup);
  // ... задайте dwFlags и hStdInput / hStdOutput / hStdError как обычно ...
  CreateProcess(PChar(Exe), PChar(CommandLine), nil, nil,
    True,                              // всё ещё требуется со списком хендлов
    CREATE_NO_WINDOW or EXTENDED_STARTUP_FLAG,
    nil, PChar(WorkDir), Startup.StartupInfo, ProcessInfo);
  // после выхода ребёнка: DeleteProcThreadAttributeList, FreeMem, CloseHandle
end;
Мостовые скрипты добавляют ещё одну деталь Windows. Python-запускальщик может стартовать второй процесс-интерпретатор, и терминирование созданного вами процесса оставит его жить. Когда движку передан путь к скрипту, как адаптеру RapidOCR ниже, HotPDF стартует ребёнка приостановленным, назначает его job object с JOB_OBJECT_LIMIT_KILL_ON_JOB_CLOSE и затем возобновляет, так что закрытие job завершает всё дерево. Та же идея изоляции движет изоляцией PDF-кодеков изображений в воркер-процессах, где ребёнок недоверенный; здесь ребёнок доверенный, но ваш процесс — не единственный код, держащий в нём хендлы
Отмена, таймауты и коммит «всё или ничего»
IHPDFOCREngine.Recognize возвращает один Boolean, и False покрывает и «Tesseract упал», и «пользователь нажал Cancel». Адаптер опрашивает токен и его таймаут каждые 25 миллисекунд, пока Tesseract работает, и при отмене убирает за собой и возвращает False. Взятое за чистую монету, это прочиталось бы как otlsEngineError, поэтому ApplyLoadedOCRTextLayer при каждом False от Recognize сначала проверяет токен. Распознавание и сборка контента заканчиваются для каждой запрошенной страницы до того, как откроется транзакция документа, поэтому отмена на странице 40 из 50 докладывает otlsCancelled и оставляет все 50 страниц загруженными. Остальные пределы — в том же стиле:
- Таймаут идёт от старта каждого вызова
Recognize, поэтому дефолтные 60000 мс — постраничный лимит - Ребёнок, ещё работающий на таймауте или отмене, терминируется и ждётся до 5 секунд; приватный каталог удаляется в блоке
finally, с повтором удаления до секунды, потому что выходные файлы могут оставаться залоченными недолго после конца процесса output.tsvограничен 64 МиБ, аstderr.txt— 1 МиБ, с проверкой при работающем ребёнке и после его выхода- Слова и UTF-16 кодовые единицы на страницу ограничены остатком
MaxWordsPerPage,MaxTotalWordsиMaxTextCodeUnits; превышение валит прогон вместо усечения списка - Ненулевой код выхода возвращается с до 4096 символами
stderr.txt— быстрейший способ узнать, что файла.traineddataне хватает
Как невидимый текстовый слой выглядит внутри страницы
HotPDF пишет слова в режиме рендеринга текста 3 (ни заливка, ни обводка, ISO 32000-1 §9.3.6), поэтому скан остаётся видимым, пока поиск и копирование работают по словам. Контентный поток открывается BT с 3 Tr; каждое слово получает матрицу Tm на своей базовой линии, размер шрифта как высота бокса в пикселях, умноженная на 72 и делённая на DPI рендера, и масштаб Tz, растягивающий прогон до ширины бокса. Эта растяжка держит подсветку поиска на слове в изображении
В TSV есть боксы, но нет базовых линий, поэтому каждая базовая линия кладётся на пятую часть высоты бокса выше нижнего края. Между соседними словами на строке слева направо в скриптах, разделяемых пробелами, вроде латиницы или кириллицы, растянутый пробел заполняет зазор, поэтому скопированный текст сохраняет разрывы слов; китайский их не получает. Глифы идут через разделяемый невстраиваемый Type0-шрифт с кодировкой Identity-H и сгенерированной CMap ToUnicode, один CID на различный Unicode-скаляр, — так китайский, акцентированная латиница и символы supplementary-плоскостей переживают копирование и поиск. Один прогон держит до 65535 различных скаляров, и поскольку ISO 19005 требует встраивать шрифты, PDF/A-выводу нужен отдельно встроенный соответствующий шрифт. Чтобы проверить результат, сохраните, перезагрузите и прогоните обычный путь из статьи извлечение текста из загруженного PDF в Delphi; если ожидаемые слова вернулись на ожидаемых страницах, слой настоящий
RapidOCR и нативный DLL на том же контракте
Для сканов упрощённого китайского HPDFCreateRapidOCREngine(PythonExecutable, BridgeScript, ModelDirectory, TimeoutMilliseconds) переиспользует тот же процессный раннер и парсер TSV. Путь мостового скрипта следует за исполняемым Python, а язык закреплён за chi_sim. HotPDF поставляет мост как tools/OCR/rapidocr_tsv.py; ему нужны пакеты rapidocr и onnxruntime, локальные ONNX-модели и файл шрифта, он отказывается от автоматических загрузок и пишет TSV в форме Tesseract; перегруз THPDFRapidOCROptions задаёт файлы моделей, число потоков и пиксельный потолок. Универсальная фабрика за обоими адаптерами, HPDFCreateLocalTSVOCREngine в HPDFLocalTSVRecognition, принимает любую программу, берущую аргументы в стиле Tesseract и пишущую двенадцатиколоночный TSV, и наследует список хендлов, таймаут, отмену и бюджеты
HPDFCreateTesseractDLLOCREngine(LibraryPath, TessDataDirectory, Language) грузит C API Tesseract вместо этого in-process, отчитывается как Tesseract (native DLL), заранее проверяет существование каждого запрошенного файла .traineddata и отображает отмену и таймаут на собственный monitor прогресса Tesseract. Он экономит старт процесса и круговой рейс BMP на страницу; исполняемый файл держит краши распознавателя и рост памяти вне вашего адресного пространства. Для десктопной утилиты, работающей по сканам самого пользователя, DLL подходит. Для сервиса, глотающего документы от чужих, консольный движок — безопаснее. Так или иначе распознавание идёт на Windows, по странице за раз, по отрендеренному битмапу, поэтому выпрямляйте и чистите сложные сканы до того, как они доедут до движка
OCR-адаптеры, писатель текстового слоя, рендерер, который их кормит, и извлечение, проверяющее вывод, живут в одном нативном VCL-компоненте для Delphi и C++Builder. Если вашему приложению захвата или архивации нужен searchable PDF на выходе, HotPDF Delphi PDF component покрывает всё, кроме OCR-движка, который вы ставите сами