TerminateThread выглядит как очевидный способ остановить OCR-вызов, который молотит по одной отсканированной странице дольше, чем готов ждать ваш UI. Документация Windows объясняет, почему это не так: если целевой поток держит блокировку кучи процесса, эта блокировка не освободится никогда, и следующее выделение памяти в любом другом потоке может зависнуть навсегда. Когда OCR работает внутри вашего собственного процесса, единственная безопасная остановка — кооперативная, на чекпойнтах между стадиями инференса, и это цена загрузки ONNX-моделей один раз и удержания их тёплыми
Альтернатива, которую пробуют первой большинство Delphi-команд, — дочерний процесс. Python-воркер на страницу можно убить в любой момент, что заманчиво, но каждый вызов стартует интерпретатор, импортирует рантайм и грузит модели детекции и распознавания, прежде чем прочитает хоть один пиксель. Положим, архивное задание обрабатывает 500 страниц: эта стартовая работа выполнится 500 раз, а в развёртывании рядом с нативным исполняемым файлом теперь живёт окружение Python
Searchable PDF из сканов с HPDFCreateRapidOCRDLLOCREngine
HotPDF запускает RapidOCR in-process через HPDFCreateRapidOCRDLLOCREngine, объявленную в юните HPDFRapidOCRRecognition. Фабрика грузит HotPDFRapidOCR.dll, один раз инициализирует ONNX-модели детекции, опциональной классификации угла и распознавания и возвращает IHPDFOCREngine. Этот движок включается в THotPDF.ApplyLoadedOCRTextLayer точно так же, как остальные OCR-движки: документ рендерит каждую страницу, DLL гоняет по ней CPU-инференс, и результат фиксируется как невидимый Unicode-текстовый слой. Никакого Python, никакого дочернего процесса. Адаптер поставляется для сборок Delphi, C++Builder и Windows FPC/Lazarus
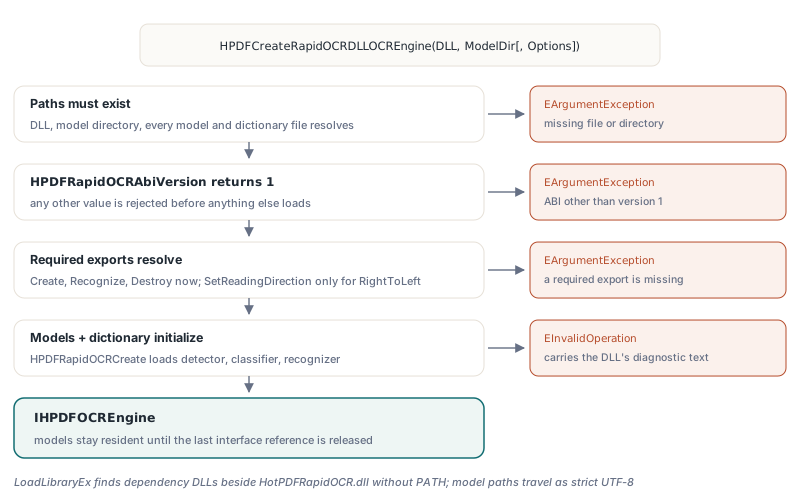
Валидация происходит в фабрике, до того как тронута хоть одна страница. Каждый файл модели и словаря должен найтись, HPDFRapidOCRAbiVersion должна вернуть 1, и нужные экспорты должны существовать, прежде чем HPDFRapidOCRCreate построит модели. Ошибки конфигурации поднимают EArgumentException; модель, отказывающаяся грузиться, поднимает EInvalidOperation с собственным диагностическим сообщением DLL — например, о словаре, не соответствующем модели распознавания
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // Модели грузятся здесь, вне всякого дедлайна распознавания.
  // Относительные имена в THPDFRapidOCRDLLOptions.Default
  // разрешаются относительно каталога моделей
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models');
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;  // 300 DPI, MinimumConfidence 0.5
    // пустой список страниц = все страницы; SkipPagesWithText по умолчанию True
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFRapidOCRDLLOptions.Default называет ch_PP-OCRv3_det_infer.onnx, ch_PP-OCRv3_rec_infer.onnx, ch_ppocr_mobile_v2.0_cls_infer.onnx и ppocr_keys_v1.txt с одним CPU-потоком, лимитом входа в 16777216 пикселей и дедлайном 60000 мс на вызов распознавания. Для других письменностей THPDFRapidOCRDLLOptions.ForLanguage сохраняет эти дефолты и подставляет <profile>/recognition.onnx плюс <profile>/dictionary.txt для одного из девяти профилей — от традиционного китайского и кириллицы до арабского и деванагари. Каждый движок читает один язык; выбирайте профиль на страницу или на документ. Почему модель и словарь всегда путешествуют парой, разобрано в статье о мультиязычных моделях RapidOCR и CTC-словарях в HotPDF
Движок отчитывается как RapidOCR (native DLL) в Info.EngineName. Пишите эту строку в лог. Когда тот же сервис гоняет ещё и внешний процессный адаптер Tesseract OCR или встроенный template-matching OCR, это самый быстрый способ понять, какой распознаватель выдал плохую страницу
Почему C ABI разговаривает только int32_t и байтами UTF-8?
Граница HotPDFRapidOCR.dll использует целые фиксированной ширины, сырые указатели и явные длины в байтах, потому что у Delphi, C++Builder и Free Pascal с MSVC общая только конвенция вызова C. std::string, std::vector или C++-исключение несут раскладку памяти и модель размотки, принадлежащие одному компилятору и одной рантайм-библиотеке, и если позволить любому из них пересечь границу в Pascal-код, дело кончится испорченным стеком или блоком кучи, освобождённым не тем аллокатором
ABI версии 1 — короткий список правил. Каждый экспорт — cdecl и возвращает статус int32_t: 1 при успехе, 0 при неудаче. Каждая функция, способная упасть, принимает буфер диагностики, принадлежащий вызывающему, и его размер в байтах, а DLL пишет туда NUL-терминированное UTF-8-сообщение, обрезанное по размеру. Внутри DLL тело каждого экспорта сидит в try с catch (const std::exception &) и catch (...). Ошибка ONNX Runtime, assert OpenCV или кривой словарь превращаются в статус 0 плюс текст
| Экспорт | Роль | Когда адаптер его разрешает |
|---|---|---|
HPDFRapidOCRAbiVersion | Возвращает 1; любое другое значение отвергается | Сразу после загрузки DLL |
HPDFRapidOCRCreate | Грузит модели детекции, опциональной классификации, распознавания и словарь | В фабрике |
HPDFRapidOCRRecognize | Прогоняет один битмап и выдаёт один callback на строку текста | В фабрике |
HPDFRapidOCRDestroy | Освобождает экземпляр моделей | В фабрике |
HPDFRapidOCRSetReadingDirection | Опциональный порядок строк справа налево | Только когда задан RightToLeft |
Экспорт направления чтения разрешается лениво намеренно, поэтому DLL, собранный без него, всё равно обслуживает любой запрос слева направо. Адаптер грузит библиотеку через LoadLibraryEx с флагами поиска, покрывающими собственную папку DLL плюс безопасные директории по умолчанию; зависимости ONNX Runtime или OpenCV, лежащие рядом с HotPDFRapidOCR.dll, находятся без правки PATH. Пути моделей и словаря пересекают границу как UTF-8, и DLL конвертирует их через MultiByteToWideChar в строгом режиме, прежде чем открывать файлы через wide-char API. Каталог моделей вроде C:\Users\Łukasz или кириллическое имя пользователя открываются нормально
Одно правило живёт в файлах сборки, а не в заголовке. DLL линкует ONNX Runtime и OpenCV статически, и CMake-проект по умолчанию берёт статический release CRT (/MT). Подмешаете статические библиотеки, собранные под /MD, — получите ошибки линковки, если повезёт, и две независимые кучи, если нет. Разворачивайте библиотеки, собранные в том же режиме CRT, что и DLL
Что происходит между TBitmap и строкой текста?
HotPDF передаёт в DLL независимую top-down BGR-копию отрендеренной страницы, а DLL возвращает по одному callback на распознанную строку. Текст в этом callback — заёмный: указатель действителен только до выхода из callback, поэтому адаптер копирует его на месте
В Delphi снимок берётся из приватного TBitmap, принудительно переведённого в pf24bit и прочитанного через GetDIBits с отрицательным biHeight. Это даёт top-down-строки, падденные до выравнивания в четыре байта, и шаг строк уходит в DLL явным аргументом. В FPC адаптер читает через CreateIntfImage. Битмап вызывающего никогда не модифицируется. Проверки размера идут до выделения копии: не более 32767 пикселей по стороне и не более MaxPixels суммарно — по умолчанию 16777216, поднимается до 67108864
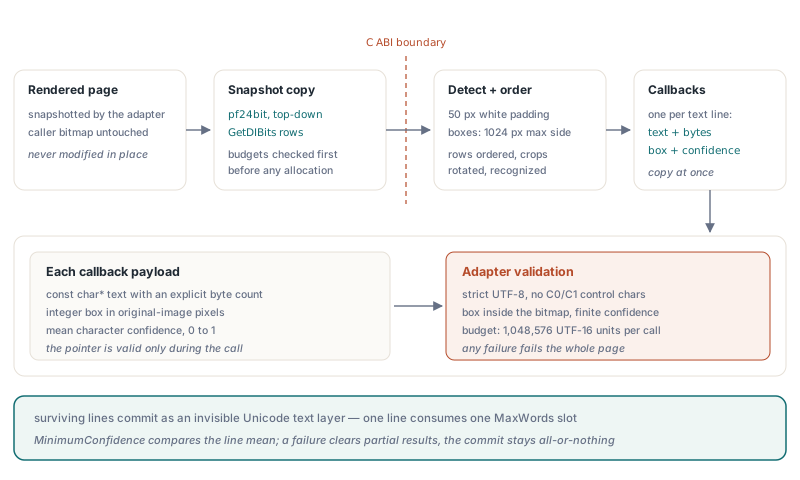
Внутри DLL изображение получает белую рамку в 50 пикселей, текстовые регионы детектируются с масштабированием длинной стороны максимум до 1024 пикселей, а боксы сортируются в горизонтальные строки. При включённом классификаторе угла кроп переворачивается на 180 градусов, только если оценка «вверх ногами» превышает 0.9 — это не даёт слабому предсказанию переворачивать короткие слова. Затем каждая строка приходит как const char*, счётчик байтов, целочисленный бокс в пикселях исходного изображения и средняя уверенность по символам. Адаптер строг к тому, что принимает:
- UTF-8 декодируется с
MB_ERR_INVALID_CHARS, поэтому кривая байтовая последовательность валит страницу, а не подсаживает символы замены в searchable-слой - C0- и C1-управляющие символы отвергаются; строки из одних пробелов пропускаются
- Бокс должен лежать внутри битмапа, а уверенность — быть конечным значением от 0 до 1
- Текст учитывается в
MaxTextCodeUnitsзапроса с жёстким потолком 1048576 UTF-16-единиц на вызов; символы вне базовой многоязычной плоскости стоят две единицы - Pascal-исключение внутри callback перехватывается там же, сохраняется и превращается в возврат 0, что заставляет DLL остановиться; сохранённое сообщение становится
Info.Diagnostic
Две из этих деталей важны, когда вы подгоняете вывод. Единица — строка, а не слово: каждая строка занимает один слот MaxWords, Info.AcceptedWordCount и Info.DroppedWordCount считают строки, и попадание в поиске подсвечивает весь бокс строки. И MinimumConfidence сравнивается со средней уверенностью символов строки, так что один смазанный символ среди двадцати чистых редко топит строку. Порог 0.7 или 0.8 отбрасывает целые строки, но не отдельные символы. Пустая страница завершается успехом с нулём строк, а любая ошибка отбрасывает частичные результаты, так что мультистраничный коммит остаётся «всё или ничего»
Один движок, одна копия моделей, один вызывающий за раз
Каждый движок RapidOCR DLL владеет ровно одним экземпляром моделей на весь срок жизни, и вызовы Recognize на этом движке сериализуются критической секцией. Именно удержание ссылки IHPDFOCREngine держит модели в памяти, поэтому в пакетной работе движок стоит создать один раз и переиспользовать для всех документов
procedure OcrBatch(const Files: TStrings; const OutputDir: string);
var
  Models: THPDFRapidOCRDLLOptions;
  Engine: IHPDFOCREngine;
  Doc: THotPDF;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
  I: Integer;
begin
  Models := THPDFRapidOCRDLLOptions.ForLanguage('ru-RU');
  Models.UseAngleClassifier := False;    // строго вертикальные сканы: модель классификатора не грузится
  Models.Threads := 4;                   // 1..64, зажимается до числа активных процессоров
  Models.TimeoutMilliseconds := 120000;  // на вызов Recognize, кооперативно
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Options := THPDFOCRTextLayerOptions.Default;
  for I := 0 to Files.Count - 1 do
  begin
    Doc := THotPDF.Create(nil);
    try
      Doc.AutoLaunch := False;
      if (Doc.LoadFromFile(Files[I]) > 0) and
        Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
        Doc.SaveLoadedDocument(IncludeTrailingPathDelimiter(OutputDir) +
          ExtractFileName(Files[I]))
      else
        Writeln(Files[I], ': ', string(Info.Diagnostic));
    finally
      Doc.Free;
    end;
  end;
end;  // последняя ссылка отпущена: модели уничтожены, затем DLL выгружен
Threads задаёт сразу число intra-op и inter-op потоков каждой ONNX-сессии в движке, а DLL зажимает его до числа активных процессоров. Два потока, делящие один движок, никогда не гоняют инференс параллельно; второй ждёт. Это ожидание — не слепой EnterCriticalSection. Адаптер пробует лок через TryEnterCriticalSection, спит по 25 мс между попытками и каждый раз проверяет токен отмены и дедлайн, так что стоящий в очереди запрос всё ещё можно отменить
Часы дедлайна стартуют при входе в Recognize, до захвата блокировки. Время в очереди за другой страницей тоже расходует TimeoutMilliseconds. С четырьмя воркерами на одном движке и дедлайном в 60 секунд четвёртая страница может уйти по таймауту, так и не доехав до модели. Вместо этого дайте каждому воркеру собственный движок. Это стоит одной копии моделей в памяти на движок, и эта память покупает предсказуемые таймауты и настоящий параллелизм; делить один движок имеет смысл, только когда запросы редки настолько, что очередь почти никогда не образуется
Почему нативный OCR-вызов нельзя убить посреди инференса?
Нативный вызов RapidOCR нельзя убить посреди инференса, потому что он идёт на вашем потоке, внутри вашего процесса, посреди ONNX Runtime-сессии, у которой нет API прерывания для уже запущенного Run. Отмена в DLL-адаптере кооперативная. DLL вызывает abort-callback до и после детекции, после классификации каждого кропа и после каждой распознанной строки и останавливается на первом чекпойнте, где callback вернул 0. Уже начатый одиночный Run сначала завершается
Насильственные варианты хуже ожидания. TerminateThread оставил бы блокировку кучи CRT, пул потоков ONNX Runtime и любое состояние OpenCV в том виде, в каком они застыли в момент убийства. Вызов FreeLibrary, пока вызов ещё исполняется, размапливает код, лежащий на стеке. Ни то, ни другое нельзя сделать безопасно, поэтому адаптер даже не пытается. Истёкший дедлайн возвращается как otlsEngineError с диагностикой о таймауте; отменённый токен — как otlsCancelled:
// Токен создаёт вызывающий и отдаёт UI-потоку,
// который зовёт Token.Cancel, когда пользователь жмёт Stop
function OcrWithStop(Doc: THotPDF; const Engine: IHPDFOCREngine;
  Token: THPDFCancellationToken): Boolean;
var
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Options := THPDFOCRTextLayerOptions.Default;
  Options.CancellationToken := Token;
  Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
  if not Result then
    case Info.Status of
      otlsCancelled:
        // останов на следующем чекпойнте стадии или строки; документ не тронут
        Writeln('Cancelled');
      otlsEngineError:
        // включает кооперативное истечение дедлайна и нативные диагностики
        Writeln('Engine: ', string(Info.Diagnostic));
      otlsBudgetExceeded:
        // достигнут лимит страницы, пикселей, слов или контента в Options
        Writeln('Budget: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
Это настоящий компромисс между процессными адаптерами и in-process DLL, и ни одна сторона не выигрывает каждую строку:
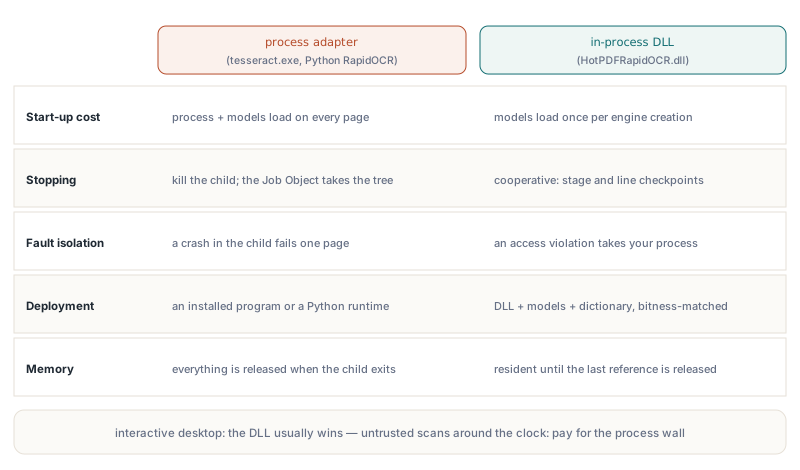
- Стартовая цена: адаптеры Tesseract и Python RapidOCR на каждой странице запускают процесс и грузят модели; DLL грузит модели один раз на движок
- Остановка: дочерний процесс можно завершить принудительно, причём Python-воркер живёт внутри kill-on-close Job Object, так что с ним уходит всё дерево процессов; DLL останавливается на чекпойнтах стадий и строк
- Изоляция сбоев: падение
tesseract.exeвалит одну страницу; access violation внутри DLL валит ваш процесс - Развёртывание: процессным адаптерам нужна установленная программа или окружение Python; DLL нужна сама, её модели и словарь, под разрядность приложения
- Память: процессный адаптер освобождает всё при выходе дочернего процесса; DLL-движок держит модели резидентно, пока не уйдёт последняя ссылка на интерфейс
Берите DLL для интерактивного десктопного приложения, которое распознаёт по странице за раз и нуждается в отзывчивой кнопке Stop, возвращающейся в пределах одной стадии инференса. Для сервера, круглосуточно глотающего недоверенные сканы, заплатите стартовую цену на страницу и оставьте процессную границу: специально собранное изображение, валящее распознаватель, должно стоить одну страницу — и с дочерним процессом так и есть
Сборка HotPDFRapidOCR.dll и выбор моделей
HotPDFRapidOCR.dll собирается из C++-исходников в Native/RapidOCR с помощью MSVC, C++17, Windows SDK и CMake 3.20 или новее. Хелпер tools/Build-HotPDFRapidOCR.ps1 принимает каталоги нативных исходников, ONNX Runtime и OpenCV плюс -Platform Win32 или Win64 и пишет результат в Lib/Native/RapidOCR/<Platform>/. Поставляете обе разрядности — собирайте обе. 32-битное Delphi-приложение не может загрузить 64-битный DLL, и статические библиотеки, которые вы разворачиваете, должны совпадать и по целевой архитектуре, и по режиму CRT
У моделей свои правила совместимости. Детектор — это DB text detector. Распознаватель принимает CTC-модели в раскладке NCHW с фиксированной высотой входа 32 или 48, а при объявленной динамической высоте использует 48. Формат модели должен быть понятен статически слинкованному ONNX Runtime; более новые экспорты вроде PP-OCRv5 могут требовать более новый рантайм, и нечитаемая модель валит инициализацию с диагностикой. tools/Install-RapidOCRModels.ps1 ставит пакеты PP-OCRv3 и PP-OCRv4, проверенные по закреплённым хешам SHA256, с общими детектором и классификатором под именами файлов, которых ждёт Default. Оставайтесь на этих пакетах, если только не контролируете и сборку рантайма тоже
Словарь должен быть UTF-8 без BOM, ровно в порядке символов модели, и число его записей должно совпадать с числом выходных классов модели. CRLF-концы строк допустимы. Когда модель несёт собственный список символов в метаданных, инициализация модели сверяет каждую запись и её позицию с файлом словаря, так что словарь одной лишь правильной длины всё равно провалится. DLL никогда не скачивает отсутствующую модель
HotPDF поставляет нативный RapidOCR-адаптер вместе с процессными OCR-адаптерами, страничным рендерером, который их кормит, и писателем невидимого Unicode-текстового слоя — всё внутри одного нативного VCL-компонента для Delphi и C++Builder. Для софта захвата и архивации, который должен выдавать searchable PDF на машинах без установленного Python, HotPDF Delphi PDF component оставляет для развёртывания только DLL и её файлы моделей