Русский счёт, прогнанный через распознаватель, который загрузил кириллическую модель, но всё ещё читает китайский словарь символов, возвращается строками абсолютно корректных ханьских иероглифов. Каждая строка — корректный UTF-8, каждая попадает в текстовый слой, и поиск любого слова, напечатанного на странице, не находит ничего. Модель свою работу сделала: CTC-распознаватель не выдаёт символы, только номера классов, и файл словаря — единственное, что отображает класс 1204 в глиф
Рядом лежат три родственные ошибки, и демо на латинице не показывает ни одной из них: каждая строка теряет последний символ, английский текст приходит без пробелов между словами, а арабские текст-боксы возвращаются в порядке слева направо. За каждой стоит правило словаря, граница цикла или порядок сортировки, которые легко сделать почти правильными. Все четыре начинаются в одной точке: на шаге, который превращает языковой тег в модель и словарь
Пресеты языков RapidOCR в HotPDF: один тег — одна закреплённая пара
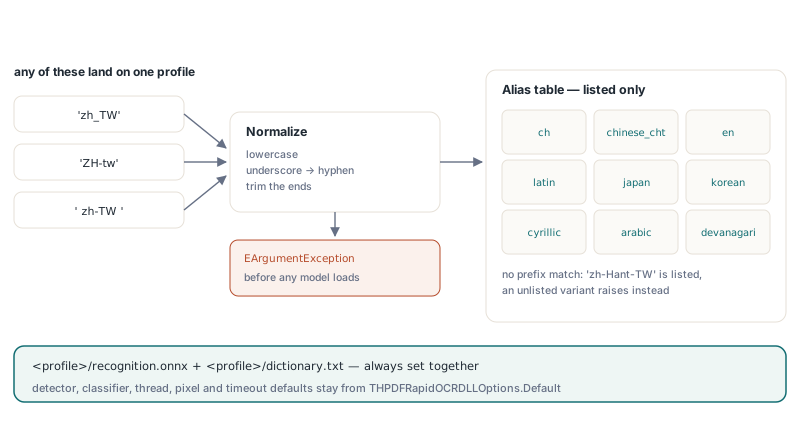
В HotPDF THPDFRapidOCRDLLOptions.ForLanguage превращает языковой тег в опции, указывающие на <profile>/recognition.onnx и <profile>/dictionary.txt в каталоге моделей. Всё остальное приходит из THPDFRapidOCRDLLOptions.Default: общий детектор, опциональный классификатор угла наклона, один поток, бюджет 16777216 пикселей на запрос и таймаут 60 секунд. Тег приводится к нижнему регистру, подчёркивания становятся дефисами, окружающие пробелы обрезаются, так что 'zh_TW', 'ZH-tw' и ' zh-tw ' сходятся к одному профилю
Сопоставление идёт по явному списку псевдонимов, без префиксных правил. 'zh-Hant-TW' и 'zh-MO' принимаются, потому что перечислены; 'pt-AO' — нет, и ForLanguage поднимает EArgumentException до того, как откроется хоть один файл. Эта строгость намеренная. Префиксное правило тихо отправило бы 'zh-Hant-SG' или какой-нибудь будущий тег профилю, совпадающему по первым двум буквам, а у китайского первые две буквы не говорят, какая это письменность
| Профиль | Языки | Примеры тегов | Порядок боксов в строке |
|---|---|---|---|
ch | Упрощённый китайский и английский | zh, zh-CN, zh-Hans, chi_sim | Слева направо |
chinese_cht | Традиционный китайский | zh-TW, zh-HK, zh-Hant, chi_tra | Слева направо |
en | Английский | en, en-US, en-GB, eng | Слева направо |
latin | Французский, немецкий, испанский, португальский, итальянский, нидерландский, турецкий | fr, de, es-419, pt-BR, tr | Слева направо |
japan | Японский | ja, ja-JP, jpn | Слева направо |
korean | Корейский | ko, ko-KR, kor | Слева направо |
cyrillic | Русский, украинский, болгарский, белорусский | ru, ru-RU, uk, bg | Слева направо |
arabic | Арабский, персидский, урду | ar, ar-SA, fa, ur | Справа налево |
devanagari | Хинди, маратхи, непальский | hi, mr, ne | Слева направо |
Адаптер ничего не скачивает. Файлы моделей разворачиваются один раз встроенным хелпером, например tools/Install-RapidOCRModels.ps1 -Destination C:/OCR/models -Language ch,chinese_cht,cyrillic или -Language All для всех девяти профилей. Хелпер кладёт общий детектор и классификатор в корневые имена файлов, которых ждёт Default, а каждый профиль — в свою папку. Создание движка, граница DLL и потоки разобраны в статье про in-process RapidOCR DLL; когда файлы на месте, упрощённо-китайский скан становится searchable вот так
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeChineseScanSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Models: THPDFRapidOCRDLLOptions;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // ch/recognition.onnx + ch/dictionary.txt, общий детектор и классификатор
  Models := THPDFRapidOCRDLLOptions.ForLanguage('zh-CN');
  // модели грузятся здесь; переиспользуйте движок между документами
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Layer := THPDFOCRTextLayerOptions.Default;  // 300 DPI, MinimumConfidence 0.5
    // пустой список страниц = все страницы; SkipPagesWithText не трогает страницы с текстом
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Layer, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines, ', Info.UniqueScalarCount, ' distinct characters');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
Два числа в этом выводе надо читать внимательно. Нативный конвейер отдаёт один результат на обнаруженную строку текста, так что AcceptedWordCount здесь считает строки, и MinimumConfidence сравнивается со средней уверенностью по всей строке: строка со средним 0.45 отбрасывается целиком. UniqueScalarCount — это число различных Unicode-скаляров, которые текстовому слою пришлось отобразить в свой шрифт и таблицу ToUnicode. Страница китайского основного текста должна поднять эту цифру куда выше нескольких десятков скаляров, которых хватает латинской странице; счёт латинского масштаба на китайском скане обычно означает, что загружен не тот профиль
Почему смена только модели распознавания выдаёт мусор?
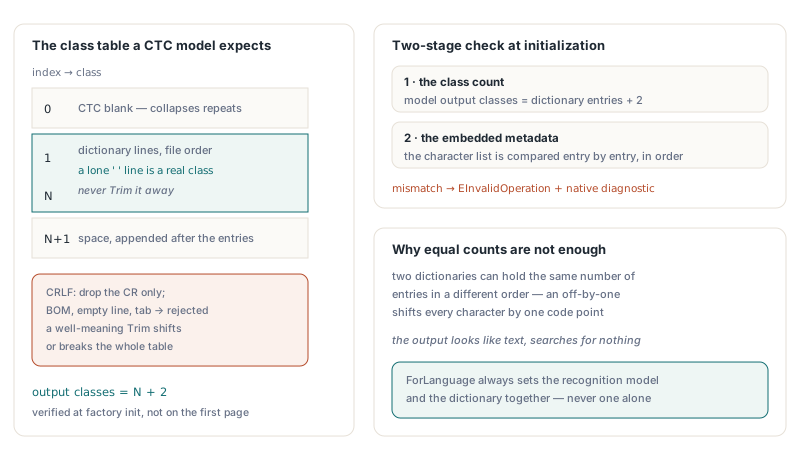
Потому что модель и словарь — две половины одной таблицы поиска, и только словарь знает, что означают индексы. Направьте RecognitionModel на cyrillic/recognition.onnx, пока CharacterDictionary всё ещё указывает на китайский файл, и модель будет выдавать корректные кириллические индексы, которые старый словарь превращает в случайные ханьские иероглифы. ForLanguage всегда задаёт оба поля вместе. Собственные опции должны следовать тому же правилу: никогда не менять одно без другого
Очевидная защита — сравнить размер словаря с шириной выхода модели — необходима, но её одной мало. Два словаря могут держать одинаковое число записей в разном порядке, и смещение на единицу сдвигает каждый символ на одну позицию. Поэтому RapidOCR DLL в HotPDF проверяет дважды, пока фабрика инициализирует распознаватель. Число выходных классов модели должно равняться числу записей словаря плюс два. Затем, если ONNX-файл содержит список метаданных character, каждая строка словаря сравнивается с ним по порядку. Любое несовпадение заставляет HPDFCreateRapidOCRDLLOCREngine поднять EInvalidOperation с нативным диагностическим сообщением, так что ошибка всплывает при старте, а не в архиве у клиента
«Плюс два» берётся из раскладки классов. Класс 0 — это CTC blank, классы с 1 по N — строки словаря в файловом порядке, а финальный класс — пробел. Некоторые словари несут и собственную запись-одиночный пробел, и эта строка должна остаться ровно как есть. Здесь благонамеренный Trim наносит реальный ущерб: он превращает запись-пробел в пустую строку и сдвигает или ломает таблицу. DLL отрезает завершающий возврат каретки, чтобы грузились CRLF-файлы, и отвергает UTF-8 BOM, пустую строку или запись с табуляцией или случайным CR
Если вы поддерживаете собственные словари, предварительная проверка в скрипте сборки или развёртывания поймает эти проблемы раньше движка. Функция ниже — ваш собственный код, написанный так, чтобы повторять правила выше
// Ваш собственный хелпер, не HotPDF API: строит таблицу классов, которую ждёт
// CTC-распознаватель, и отвергает те же дефекты словаря, что и DLL
uses
  SysUtils, IOUtils;

function BuildCTCClassTable(const FileName: string): TArray<string>;
var
  Text, Entry: string;
  Lines: TArray<string>;
  I, Last: Integer;
begin
  Text := TEncoding.UTF8.GetString(TFile.ReadAllBytes(FileName));
  if (Text <> '') and (Text[1] = #$FEFF) then
    raise EArgumentException.Create('Dictionary must be UTF-8 without a BOM');
  Lines := Text.Split([#10]);
  Last := High(Lines);
  if (Last >= 0) and (Lines[Last] = '') then
    Dec(Last);                                   // перевод строки в конце файла
  if Last < 0 then
    raise EArgumentException.Create('Dictionary is empty');
  SetLength(Result, Last + 3);
  Result[0] := '';                               // класс 0: CTC blank
  for I := 0 to Last do
  begin
    Entry := Lines[I];
    if (Entry <> '') and (Entry[Length(Entry)] = #13) then
      SetLength(Entry, Length(Entry) - 1);       // CRLF: отрезать только CR
    if (Entry = '') or (Pos(#9, Entry) > 0) or (Pos(#13, Entry) > 0) then
      raise EArgumentException.CreateFmt('Invalid dictionary line %d', [I + 1]);
    Result[I + 1] := Entry;                      // никогда не Trim: ' ' — это класс
  end;
  Result[Last + 2] := ' ';                       // финальный класс: пробел
  // Length(Result) должен равняться числу классов выхода модели
end;
Жадное CTC-декодирование и три пограничные ловушки
Жадное CTC-декодирование на каждом временном шаге берёт класс с максимальной оценкой, схлопывает подряд идущие повторы в один символ и выбрасывает blank. Именно blank позволяет по-настоящему удвоенной букве выжить. Модель распознавания читает строку текста как последовательность узких вертикальных срезов и для каждого среза выдаёт вероятность каждого класса. Строка с AA中 может дать argmax-последовательность A A blank A 中 space: первые два шага с A схлопнутся в один, blank отделит его от следующего A, и на выходе будет AA中 с сохранённым хвостовым пробелом. Без правила blank book и bok декодировались бы одинаково
Декодер с ошибкой на единицу даёт характерные симптомы, и у каждого свой вид. Остановите внутренний цикл argmax на один класс раньше — и класс пробела никогда не выиграет, поэтому каждая английская или латинская строка вернётся одним длинным словом, а поиск фраз перестанет работать. Остановите внешний цикл на один временный шаг раньше — и у каждой строки исчезнет последний символ, что на двухсимвольной этикетке означает половину текста. Забудьте, что blank сбрасывает сторож повторов, — и удвоенные символы схлопнутся: ll в hello или удвоение в 谢谢. Если пишете декодер для собственного конвейера, эти три случая — готовый компактный тестовый набор. Декодер HotPDF покрывает последний класс и последний шаг, сохраняет повторы, разделённые blank, и отвергает оценки, которые не конечны или лежат вне диапазона от 0 до 1, плюс любое число классов, не сходящееся со словарём
// Иллюстрация для собственного конвейера, не HotPDF API: жадное CTC-
// декодирование с корректными границами. Scores хранит Steps * Classes
// вероятностей, одна строка на временный шаг
function GreedyCTCDecode(const Scores: array of Single;
  Steps, Classes: Integer; const Characters: array of string): string;
var
  Step, C, Best, Previous: Integer;
  BestScore: Single;
begin
  if (Classes < 3) or (Length(Characters) <> Classes) or
    (Length(Scores) <> Steps * Classes) then
    raise EArgumentException.Create('Model output does not match the dictionary');
  Result := '';
  Previous := 0;                            // класс 0 — это CTC blank
  for Step := 0 to Steps - 1 do             // включая последний временный шаг
  begin
    Best := 0;
    BestScore := Scores[Step * Classes];
    for C := 1 to Classes - 1 do            // включая последний класс (пробел)
      if Scores[Step * Classes + C] > BestScore then
      begin
        Best := C;
        BestScore := Scores[Step * Classes + C];
      end;
    if (Best <> 0) and (Best <> Previous) then
      Result := Result + Characters[Best];
    Previous := Best;                       // blank сбрасывает сторож повторов
  end;
end;
Beam search с языковой моделью может разрешить часть неоднозначных срезов, где жадное декодирование ошибается, ценой реальной скорости и второго набора файлов для версионирования. Для печатных документов, отрендеренных при 300 DPI, жадное декодирование — правильный дефолт, а компенсировать то, чего модель не видит, — не работа декодера. То же относится к таблицам подстановки символов. Если модель читает букву с диакритикой как её базовую букву, латание вывода таблицей замен чинит один язык и ломает другой. Неверный символ в searchable-слое хуже отсутствующего: поиск находит не тот документ вместо того, чтобы не найти никакого, поэтому распознанный текст попадает в PDF ровно так, как его выдала модель
Как упорядочиваются текстовые строки для арабского письма справа налево?
DLL сортирует обнаруженные текст-боксы сверху вниз, группирует боксы в одну строку, когда они перекрываются по вертикали минимум на половину высоты меньшего бокса, и упорядочивает каждую строку слева направо — или справа налево, когда задан RightToLeft. Символы внутри распознанной строки никогда не переворачиваются. Группировка в строки важна, потому что детекторы часто режут одну визуальную строку на несколько боксов — например, подпись и значение, разделённые широким зазором, — и простая сортировка по верхней координате перемешала бы их со следующей строкой всякий раз, когда их верхушки расходятся на пиксель-другой
Арабский профиль — единственный, где ForLanguage задаёт RightToLeft := True, и тогда DLL упорядочивает каждую строку по правым краям боксов, начиная от правого поля. Это весь эффект. Текст, который модель возвращает для строки, уже в логическом порядке Unicode — в том порядке, в котором арабский читатель читает и набирает его, — и именно его ждут извлечение текста и поиск в PDF. Разворот строки, чтобы она «выглядела правильно» в отладчике Delphi, сломает поиск, копирование, вставку и скринридеры. Двунаправленный показ и отрисовка глифов — дело PDF-просмотрщика
Один движок обслуживает один языковой профиль, автоматического определения письменности нет. Документу со смешанными письменностями нужен движок на профиль, каждый применяется к своим страницам. ApplyLoadedOCRTextLayer принимает явный список страниц и коммитит каждый вызов отдельной транзакцией, так что сбой на арабских страницах откатит этот вызов, не тронув уже записанный китайский слой
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

function CreateRapidEngine(const Tag: string): IHPDFOCREngine;
var
  Models: THPDFRapidOCRDLLOptions;
begin
  // поднимает EArgumentException для неперечисленного тега, до загрузки любой модели
  Models := THPDFRapidOCRDLLOptions.ForLanguage(Tag);
  Models.MaxPixels := 33554432;          // запас для страниц A3 при 300 DPI
  Result := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
end;

procedure OCRMixedArchive(Doc: THotPDF);
var
  Chinese, Arabic: IHPDFOCREngine;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Chinese := CreateRapidEngine('zh-TW');  // профиль chinese_cht
  Arabic := CreateRapidEngine('ar-SA');   // профиль arabic, RightToLeft = True
  Layer := THPDFOCRTextLayerOptions.Default;
  if not Doc.ApplyLoadedOCRTextLayer([0, 1, 2], Chinese, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
  if not Doc.ApplyLoadedOCRTextLayer([3], Arabic, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
end;
Строка с MaxPixels там не просто так. Дефолтный бюджет 16777216 пикселей на запрос покрывает A4 и US Letter при 300 DPI с запасом. Лист A3 при 300 DPI — это около 3508 на 4961 пикселя, грубо 17,4 миллиона, так что запрос будет отклонён, а Info.Diagnostic сообщит о неверном запросе или пиксельном бюджете. Поднимите MaxPixels до потолка 67108864 или понизьте THPDFOCRTextLayerOptions.DPI для больших форматов. Порядок справа налево идёт через DLL-экспорт HPDFRapidOCRSetReadingDirection, который адаптер ищет только при заданном RightToLeft; сборка DLL без этого экспорта всё равно обслуживает профили слева направо, а попытка создать с ней арабский движок поднимет EArgumentException, назвав недостающий экспорт
Закреплённые пакеты моделей и что должна пройти собственная пара
RapidOCR DLL в HotPDF линкует статически собранный ONNX Runtime, поэтому читает те версии формата ONNX, которые понимает этот рантайм, и ничего новее. Недавние экспорты моделей могут таргетировать более новый формат; такой файл отвергается при создании движка с нативным диагностическим сообщением. Из этой связки следует, почему каждый языковой пакет указывает на один конкретный распознаватель и словарь, которые грузятся и проходят классовые проверки под встроенным рантаймом, и почему пакеты — никогда не «последние»
Install-RapidOCRModels.ps1 держит эту пару под контролем и на диске. Каждый файл в манифесте несёт хеш SHA256. Существующий файл с другим хешем останавливает установку и остаётся на месте — переместить или удалить его решаете вы, а каждая загрузка сначала пишется под временным именем и встаёт на место только после совпадения хеша. Это блокирует тихий вариант словарной проблемы: кто-то вручную копирует более новый recognition.onnx в папку профиля, число классов случайно совпадает, и первый признак беды — клиент, сообщающий, что поиск не находит слова, которые видны невооружённым глазом. Если ставите с -SkipClassifier, задайте UseAngleClassifier := False в опциях, потому что Default ждёт файл классификатора, и создание движка проверяет его существование
Распознаватель также проверяет входную форму модели при загрузке. Он принимает NCHW float-вход с фиксированной высотой 32 или 48 пикселей либо динамическую высоту, которую исполняет как 48. Модель, экспортированная с любой другой фиксированной высотой, проваливает создание движка с сообщением «Unsupported recognition model input or output shape»
Для письменности, которую не покрывает ни один из девяти профилей, RecognitionModel и CharacterDictionary могут указывать на ваши собственные файлы, и все проверки выше остаются в силе. Несовпавшая пара провалит создание движка — в вашем тестовом прогоне. Для страниц, где не подходит ни один профиль RapidOCR, Tesseract-адаптер для searchable PDF включается в тот же вызов ApplyLoadedOCRTextLayer, а для машинопечатных ASCII-форм встроенный template-matching OCR вообще не требует файлов моделей
Языковые пресеты, нативный RapidOCR-адаптер и OCR-текстовый слой входят в HotPDF Delphi PDF Component для проектов на Delphi, C++Builder и Windows FPC/Lazarus