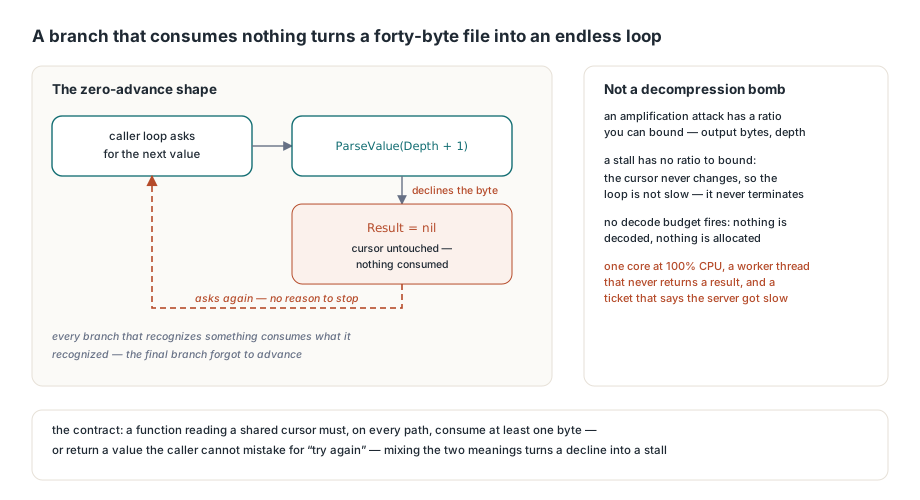
Парсер зависает на битом PDF, когда какая-то ветка читает байт, отказывается его обрабатывать и возвращается, не сдвинув курсор. Вызывающий цикл не видит ни прогресса, ни причины остановиться, поэтому крутится вечно. HotPDF поставлялся ровно с этим дефектом в трёх независимых парсерах, до всех из которых можно добраться входами меньше пятидесяти байт
Это класс denial-of-service, который стоит называть отдельно, потому что он не похож на тот, от которого все уже защищаются. Никакой декомпрессии, никакого роста аллокаций, никакого давления на память, чтобы сработал watchdog. Процесс просто сидит на ста процентах одного ядра с горсткой байт в буфере. Если вы добавили бюджет декодирования после чтения про усиление вложенными фильтрами и PDF-бомбы, здесь он не сработает: ничего не декодируется и ничего не аллоцируется. Другой отказ — другой фикс
Почему файл в сорок байт дороже декомпрессионной бомбы?
Потому что стоимость вообще не связана с размером входа. У атаки-усиления есть коэффициент, который можно ограничить: урежьте выходные байты, урежьте глубину рекурсии — и худший случай станет конечным. У zero-advance цикла ограничивать нечего. Условие цикла — функция курсора, который никогда не меняется, так что это не «медленно», это «не завершается», и никакой лимит по размеру выше по потоку его не поймает. Операционно это тоже уникально гадко. Крэш даёт вам стек, out-of-memory — строку в логе, а зависший парсер — рабочий поток, который никогда не вернёт результат, запрос, который никогда не истечёт по таймауту, потому что ниже по потоку никто не знает, что он начался, и тикет со словами «сервер во вторник стал тормозить». Структурная причина всегда одной формы. У токенизатора или парсера значений есть цепочка веток, зависящих от текущего байта. Каждая ветка, которая что-то распознала, потребляет распознанное. Потом есть финальная ветка — или гард перед цепочкой, — которая возвращается для байтов, которые никто не забрал, и автор думает о ней как о пути ошибки, а не как о шаге сканирования. Пути ошибки возвращаются. Шаги сканирования продвигаются. Когда одна функция должна быть и тем и другим, забывается именно продвижение
Парсер объектов: два разделителя, которые никто не потребил
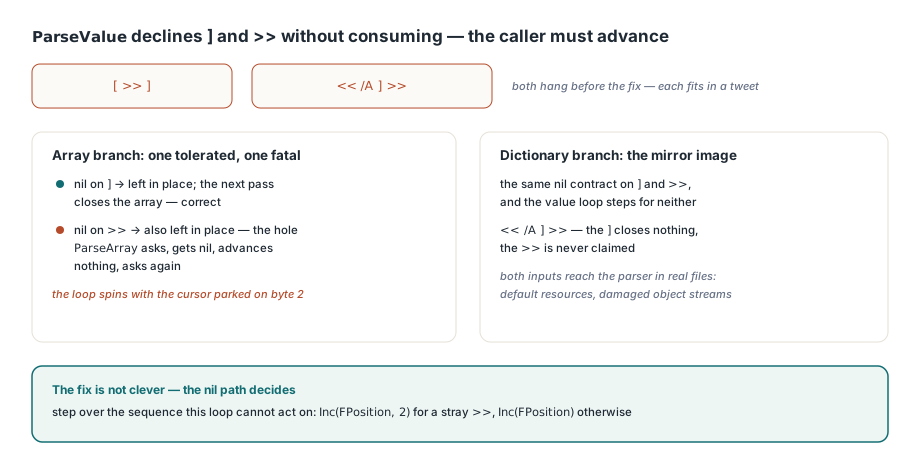
В HPDFParser метод THPDFSpanObjectParser.ParseValue начинает с того, что сразу отклоняет две байтовые последовательности. По ISO 32000-1, раздел 7.3, значение не может начинаться с ] или с >>, потому что они закрывают контейнер, а не открывают значение, так что ParseValue возвращает nil для обеих, не потребляя их. Это корректный контракт, и он целиком перекладывает продвижение на вызывающего. Ветка массива выполнила его наполовину: при nil-результате она проверяла ], оставляла его на месте, чтобы на следующем проходе закрыть массив, и перешагивала всё остальное — кроме того, что проверка была написана так, что случайный >> тоже оставался на месте. Так что [ >> ] зависает: ParseArray просит значение, получает nil, ничего не продвигает и просит снова. У ветки словаря была зеркальная дыра, и << /A ] >> зависает так же. Оба входа достаточно валидны, чтобы добраться до парсера, и достаточно коротки, чтобы влезть в твит
uses
  HPDFObjs, HPDFParser;

procedure ProbeParserStalls;
var
  Stats: THPDFParserViewStatistics;
  Arr: THPDFArrayObject;
  Dict: THPDFDictionaryObject;
begin
  // До исправления ни один из вызовов ниже никогда не возвращался
  Arr := HPDFParserParseSimpleArrayWithStatistics('[ >> ]', Stats);
  Arr.Free;
  WriteLn('array errors=', Stats.ErrorCount, ' valid=', Stats.Valid);

  Dict := HPDFParserParseSimpleDictionaryWithStatistics('<< /A ] >>', Stats);
  Dict.Free;
  WriteLn('dict errors=', Stats.ErrorCount, ' valid=', Stats.Valid);
end;
Фикс нехитрый, и в этом суть: nil-путь должен явно решить, с какой из двух непотреблённых последовательностей текущий цикл способен работать, и перешагнуть другую
Value := ParseValue(Depth + 1);
if Value = nil then
begin
  RecordError;
  // ParseValue возвращает nil и для ']', и для '>>', не потребляя
  // их. ']' закрывает массив на следующем проходе, но случайный '>>'
  // внутри массива нужно перешагнуть, иначе парсинг никогда не продвинется
  if (FPosition < FLength) and StartsWithPair('>', '>') then
    Inc(FPosition, 2)
  else if (FPosition < FLength) and (CharAt(FPosition) <> ']') then
    Inc(FPosition);
  Continue;
end;
Здесь заслуживает внимания ещё одна вещь. THPDFSpanObjectParser.RecordError только инкрементирует ErrorCount в THPDFParserViewStatistics, ничего не ограничивая. Парсер ставит HPDFParserMaximumDepth в 64, чтобы ограничить вложенность, но не имеет эквивалентного потолка на число ошибок, а счётчик, который никто никогда не читает, — это упущенный circuit breaker. Даже с восстановленным продвижением вход, дающий одну ошибку на байт, будет пережёвывать большой объект со скоростью, заслуживающей раннего выхода, а не полного обхода. Проверяйте Valid в статистике после каждого парсинга и относитесь к большому ErrorCount как к причине перестать доверять объекту, а не просто как к диагностике
Та же форма в токенизаторе CMap и в ридере XFDF
HPDFCMapReader.NextToken нёс тот же дефект в своей фолбэк-ветке. Функция возвращает TCMapTok и обрабатывает <, ( и / отдельными ветками; всё остальное проваливается в «читать до пробела или разделителя». Когда стартовый байт сам является разделителем из набора ISO 32000-1, раздел 7.2.2, этот цикл выполняется ноль раз, токен возвращается пустым, и вызывающий просит тот же токен снова. Из шести символов, которые могут туда попасть, только [ перехватывался раньше обработкой bfrange, так что случайный ), >, ], { или } где угодно в ToUnicode CMap был достаточен, чтобы зависла экстракция текста
// ключевое слово или число: читаем до пробела или разделителя
StartP := P;
while (P <= Len) and (not IsCMapWhiteSpace(Text[P]))
  and (not IsCMapDelimiter(Text[P])) do
  Inc(P);
// Разделитель, который не забирает ни одна из веток выше (случайные ')', '>',
// '[', ']', '{' или '}'), оставил бы P на месте и вернул
// пустое ключевое слово, и вызывающий просил бы тот же токен вечно
if P = StartP then
  Inc(P);
AKeyword := Copy(Text, StartP, P - StartP);
Result := ctKeyword;
На стороне XFDF была вариация с другим происхождением и тем же эффектом. HPDFXFDFXml.ParseElement в начале ставит Result := P, пока P ещё указывает на открывающий <, и только потом инкрементирует локальный курсор, так что каждый следующий ранний выход возвращает входную позицию, если только не перезаписывает Result раньше. Объявление doctype по XML 1.0, раздел 2.8, или что угодно ещё без разбираемого имени тега вроде <1a>, уходило по выходу, который никогда не обновлял Result, и цикл дочерних элементов получал ту позицию, которую сам же передал. В цикле атрибутов таких было ещё три: ReadName, пропуск пробелов и обработка = — все отклоняют байт, который не является ни символом имени, ни пробелом, ни одним из =, >, /, и ни одна из них его не потребляла. Соседний ремонт CDATA переложил ответственность, а не добавил гард: секция CDATA по XML 1.0, раздел 2.7, начинается с <, поэтому цикл дочерних элементов раньше передавал её в ParseElement, который читал имя тега из содержимого секции. Распознавать её в цикле дочерних элементов через IsCDATAStart и копировать байты в текстовый буфер до IsCDATAEnd — правильное разделение труда, а старый пропуск был к тому же на один байт короче, потому что маркер — восемь байт, считая от !
Объявленные счётчики, которые переживают данные
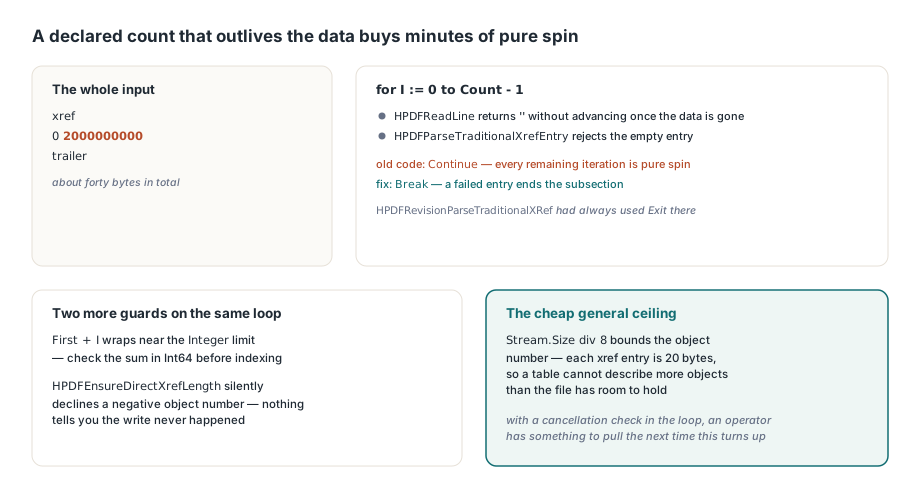
Более поздний релиз выявил ту же картину с противоположной стороны, и это вариант, который с наибольшей вероятностью живёт в вашем собственном коде. Заголовок подсекции перекрёстной ссылки по ISO 32000-1, раздел 7.5.4, — это пара first count, и оба традиционных xref-парсера HotPDF крутили по ней for I := 0 to Count - 1, используя Continue, а не Break, когда запись не разбиралась. Это читается как терпимость к одной плохой строке. На деле нет: HPDFReadLine возвращает пустую строку, не продвигаясь, как только данные закончились, а HPDFParseTraditionalXrefEntry немедленно отвергает пустую запись, так что каждая оставшаяся итерация объявленного счётчика — чистый спин. Арифметика безжалостна: заголовок xref\n0 2000000000\ntrailer плюс минимальная обёртка — это около сорока байт, и они покупают десятки секунд занятого ядра без единой проверки отмены в цикле. Улика лежала в том же юните, потому что HPDFRevisionParseTraditionalXRef всегда использовал Exit в этом месте. Когда две функции разбирают одну грамматику и расходятся во мнении, завершает ли неудачная запись подсекцию, одна из них — форк, который перестал получать фиксы, тот же самый признак, что и в гибридной обработке перекрёстных ссылок, где традиционная таблица и поток описывают одни и те же объекты
if not HPDFParseIntegerPair(Line, First, Count) then
  Exit;
for I := 0 to Count - 1 do
begin
  Entry := HPDFReadLine(XrefData, P);
  // Объявленный счётчик больше таблицы — иначе крутились бы
  // здесь, когда читать уже нечего
  if not HPDFParseTraditionalXrefEntry(Entry, EntryOffset, GenNum, InUse) then
    Break;
  // First приходит из заголовка подсекции, поэтому сумма переполняется
  // при объявленном старте около предела Integer, а хелпер роста
  // молча отказывает отрицательному индексу
  if (First < 0) or (Int64(First) + I > MaxInt) then
    Break;
  ObjNumber := First + I;
  if (ObjNumber < 0) or (Int64(ObjNumber) > Stream.Size div 8) then
    Break;
  HPDFEnsureDirectXrefLength(State, ObjNumber);
  // ... записываем запись ...
end;
Две границы после Break относятся к тому же ремонту. HPDFEnsureDirectXrefLength отказывается расширять массив для отрицательного номера объекта, ничего об этом не говоря, а First + I переполняется при объявленном старте около предела Integer, так что отрицательный индекс доходит до записей ниже. Потолок номера объекта Stream.Size div 8 — дешёвый универсальный ответ: ни одна традиционная таблица перекрёстных ссылок не может описать больше объектов, чем в файле есть места, и любой заголовок, заявляющий обратное, описывает несуществующий файл. Если вы чините руками повреждённую таблицу, та же логика работает с другой стороны — это территория заметок про диагностику и ремонт PDF, правленных вручную
Как доказать, что фикс зависания реально работает?
Запуском старого кода, а не перечитыванием. Зависание — один из немногих классов дефектов, где фикс проверяется бинарным сигналом без всякой инструментации: процесс либо возвращается, либо нет, а рассуждение о потоке управления — ровно тот навык, который породил баг в первую очередь. Механику стоит скопировать. Вытащите до-фиксовую ревизию изменённых юнитов в scratch-каталог, затем скомпилируйте один маленький probe с путём поиска юнитов, ставящим этот каталог впереди реальной библиотеки: dcc32 -U<scratchdir>;<Lib> probe.dpr. Компилятор берёт старые исходники для того, что находит первым, и текущие — для всего остального, так что один бинарник probe гоняет старый парсер против остальной библиотеки. Запустите его под таймаутом — сорока секунд достаточно — и считайте код возврата 124 утверждением. Потом убирайте юниты из scratch-каталога по одному и пересобирайте. Все три зависания воспроизвелись так, каждое приписано конкретному юниту, и все три исчезли, как только исправленный исходник вернулся в путь, ценой одной компиляции на юнит
Две ловушки стоит знать до того, как пробовать. Путь поиска юнитов молчаливо всепрощающ: отдайте -U Unix-путь из шелла вроде $PWD — и компилятор проигнорирует этот каталог без единого слова, а значит, ваш probe скомпилировался против текущих исходников и прошёл по неправильной причине. Сначала конвертируйте путь в нативный Windows-вид. Вторая — scratch-каталог не несёт include-файлы, так что нужен ещё -I<Lib> для HotPDF.inc, иначе сборка падает так, что выглядит как проблема исходника, а не пути. И будьте честны насчёт того, чего метод не даёт: он подтверждает, что конкретный вход перестал висеть на конкретной сборке, и ничего не говорит о входах, о которых вы не подумали. Zero-advance дефекты находятся фаззингом или чтением каждой ветки каждого токенизатора, а не регрессионными тестами, написанными постфактум
Что аудировать в своих парсерах
Многоразовое правило — это контракт, а не пункт чек-листа. Любая функция, читающая общий курсор, должна на каждом пути, включая пути ошибок, либо потреблять минимум один байт, либо возвращать значение, которое вызывающий не спутает с «попробуй ещё раз». Смешение этих двух смыслов в одном nil или одном пустом токене — вот что превращает отказ в зависание. Так что аудируйте форму, а не симптом. Найдите каждый цикл, чьё завершение зависит от курсора, которым владеет другая функция, и спросите, что произойдёт, когда та откажется от текущего байта. Найдите каждую фолбэк-ветку, написанную как «читать до X», и спросите, что она делает, когда курсор уже стоит на X. Найдите каждый цикл, ограниченный счётчиком, пришедшим из файла, а не из данных, и сделайте так, чтобы неудачный элемент завершал цикл вместо пропуска итерации. Где одна грамматика разбирается в двух местах — сдиффьте их, потому что одно из них получит фикс, которого нет у другого. И вставьте проверку отмены в любой цикл, который может крутиться заданное вызывающим число итераций, чтобы у оператора было что дёрнуть, когда следующий такой вылезет в проде
Парсеры, описанные здесь, поставляются в текущем HotPDF Delphi Component для Delphi и C++Builder, со статистиками и лимитами глубины, выставленными наружу, чтобы ваше собственное ужесточение могло на них опереться