HotPDF умеет сохранять загруженный документ в диагностической форме, предназначенной для чтения и редактирования человеком, а затем восстанавливать файл после того, как вы его отредактировали. SaveLoadedDocumentDiagnostic записывает документ с детерминированным порядком ключей словаря, каждый объект — как обычный косвенный объект, без потоков объектов, без потока перекрёстных ссылок и без линеаризации. RepairDiagnosticDocument затем перестраивает байтовые смещения, длины потоков, таблицу перекрёстных ссылок и трейлер, которые сделало недействительными ваше редактирование
Эта пара существует для одного рабочего процесса: понять или исправить то, что на самом деле находится внутри PDF. Каждый разработчик, отлаживавший проблему рендеринга, хотел открыть файл, изменить одно число в одном словаре и посмотреть на результат. В обычном PDF это невозможно, потому что содержимое сжато в потоки объектов, и каждый вставленный вами байт сдвигает смещения, которые таблица перекрёстных ссылок фиксирует с точностью до байта
Чем отличается диагностическое сохранение?
Шесть настроек меняются одновременно. Ключи словарей записываются в детерминированном порядке, поэтому два сохранения одного и того же документа дают сопоставимые файлы. Диагностический режим вывода аннотирует структуру. Принудительно выполняется полная перезапись, поэтому ничего не переносится в виде нетронутой инкрементной ревизии. Линеаризация выключена, поскольку линеаризованный файл организован для просмотра в вебе, а не для чтения человеком. Потоки перекрёстных ссылок выключены, поэтому таблица представляет собой обычный текст. А потоки объектов выключены, поэтому ни один объект не скрыт внутри сжатого контейнера
В результате получается файл, в заголовке которого рядом с обычной сигнатурой %PDF- стоит диагностическая метка, а его тело можно листать в любом редакторе. Объекты идут один за другим, словари читаемы, а потоки содержимого лежат там, где их можно найти. Инструмент восстановления проверяет наличие этой метки и отказывается работать с файлами, где её нет, потому что компактную структуру обычного PDF не должен пытаться интерпретировать восстановитель, работающий по байтовым диапазонам

uses
  HPDFDoc;

var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoice.pdf') <= 0 then
      Exit;
    // Читаемо, один объект на блок, ничего не скрыто в потоках объектов
    Pdf.SaveLoadedDocumentDiagnostic('invoice-diagnostic.pdf');
  finally
    Pdf.Free;
  end;
end;
Почему редактирование ломает файл и что приходится перестраивать?
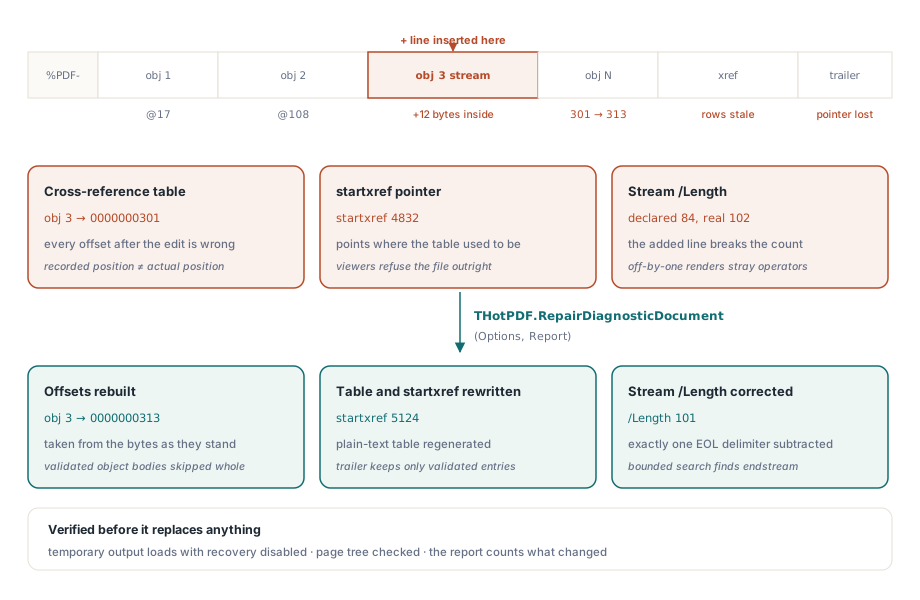
Три вещи в PDF кодируют байтовые позиции или количество байт. Таблица перекрёстных ссылок сопоставляет каждому номеру объекта байтовое смещение. Значение startxref в конце файла указывает на эту таблицу. И каждый словарь потока несёт запись /Length, сообщающую, сколько байт занимает тело потока
Измените один символ в любом месте до конца файла — и все смещения после него окажутся неверны. Добавьте строку в поток содержимого — и его /Length тоже станет неверным. Большинство программ просмотра откажутся открывать такой файл, а те, что восстанавливают его, делают это сканированием, которое скрывает ошибку, а не исправляет её. Восстановление перестраивает все три величины исходя из того, что теперь на самом деле говорят байты
var
  Options: THPDFDiagnosticRepairOptions;
  Report: THPDFDiagnosticRepairReport;
begin
  Options := THPDFDiagnosticRepairOptions.Default;
  Options.VerifyOutput := True;         // загрузить результат перед заменой

  if THotPDF.RepairDiagnosticDocument('invoice-diagnostic.pdf',
       'invoice-fixed.pdf', Options, Report) then
    Writeln(Format('%d objects, %d streams, %d lengths corrected, ' +
      '%d xref rows rebuilt, %d pages verified',
      [Report.ObjectCount, Report.StreamCount,
       Report.RepairedStreamLengthCount, Report.RebuiltXRefEntryCount,
       Report.VerifiedPageCount]))
  else
    Writeln(Format('repair failed (%d): %s',
      [Ord(Report.Status), string(Report.Diagnostic)]));
end;
Копируйте байты, не пересериализуйте
Решение в архитектуре, делающее этот инструмент заслуживающим доверия, состоит в том, что он никогда не загружает документ целиком и не записывает его заново. Он копирует байтовые диапазоны проверенных им объектов, меняет только те значения /Length, что оказались неверны, и перестраивает вокруг них таблицу, трейлер и startxref
Загрузка и пересериализация реализовывались бы гораздо проще, но незаметно меняли бы содержимое. Незнакомый синтаксис объектов нормализовался бы, экранирование строк переписывалось бы в предпочитаемой писателем форме, а уже закодированные полезные данные потоков могли бы перекодироваться. Для инструмента отладки это неприемлемо: вы отредактировали одно число, и diff должен показывать одно число, а не тысячу случайных изменений форматирования. Если вы хотите точно узнать, что изменилось между двумя файлами, это задача сравнения, описанная в статье сравнение двух PDF-файлов по структуре и пикселям

Два правила разбора, предотвращающие ложные объекты
Сканер, работающий по байтовым диапазонам, сталкивается с очевидной ловушкой: текст, похожий на заголовок объекта, может встретиться внутри полезных данных потока или внутри строки. Наивное сканирование выдало бы строку перекрёстных ссылок, указывающую в середину потока содержимого, и итоговый файл оказался бы сломан новым, ещё более запутанным способом
HotPDF избегает этого, пропуская весь байтовый диапазон каждого проверенного объекта по его зафиксированному конечному смещению, так что ничто внутри тела объекта никогда не рассматривается как кандидат. Между объектами допускаются только пробельные символы PDF и комментарии; всё остальное означает, что область не распознана и её байты нельзя переносить в вывод
Длины потоков требуют не меньшей аккуратности. Реальная длина полезных данных не включает разделитель конца строки, который писатель вставляет перед endstream. Когда заявленная длина точно попадает на маркер, это значение принимается. Когда нет, восстановитель выполняет ограниченный поиск пары endstream и endobj и вычитает ровно один разделитель — CR, LF или CRLF. Ошибка здесь на один байт даёт файл, который открывается и отрисовывает страницу с одним лишним оператором в конце потока содержимого
Что разрешено сохранить трейлеру
Перестроенный трейлер — не копия старого. /Size, /Prev и /XRefStm все описывают прежнюю компоновку файла и либо пересчитываются, либо отбрасываются. Выживают только записи, чьи цели были проверены: /Info, /ID и /Encrypt. А /Root обязан разрешаться ровно в один объект Catalog — не в ноль и не в несколько, что как раз и получается в файле, собранном копированием и вставкой блоков объектов
Безопасность вывода обеспечена так, как и должно быть для инструмента, работающего с файлами, которые людям важны. Результат записывается во временный файл в целевом каталоге, затем проверяется загрузкой по обычному пути с отключённым восстановлением перекрёстных ссылок, так что файл, который открывается только благодаря восстановлению, засчитывается как сбой. Только после успешной проверки дерева страниц временный файл атомарно заменяет целевой. Неудавшееся восстановление никогда не перезаписывает существующий вывод
Бюджеты и честные коды сбоев
Работу ограничивают три предела: входные байты, число объектов-кандидатов и максимальный номер объекта — по умолчанию 8 ГиБ, два миллиона и два миллиона. Потолок номера объекта важнее, чем кажется, потому что разреженная таблица с несколькими объектами, пронумерованными в миллиардах, иначе колоссально раздула бы перестроенную таблицу перекрёстных ссылок. Классические таблицы перекрёстных ссылок также отклоняют смещения, для которых потребовалось бы больше десяти десятичных цифр, — это ограничение формата, а не выбор реализации
Сбои сообщают конкретный статус, а не булево значение: неверные аргументы, источник слишком велик, не диагностический файл, превышен лимит объектов, недопустимый объект, дублирующийся объект, отсутствует каталог, недопустимый трейлер, ошибка вывода или сбой проверки. Каждому соответствует своё исправление. Дублирующийся объект означает, что вы дважды вставили блок объекта. Отсутствующий каталог обычно означает, что объект с /Type /Catalog был повреждён. Сбой проверки означает, что структура теперь непротиворечива, но дерево страниц не загружается — как правило, это массив /Kids, отредактированный не в такт со своим /Count
Две практические заметки завершают картину. Храните диагностический файл, а не только восстановленный, чтобы следующая правка начиналась с читаемой основы. И не отправляйте диагностический вывод конечным пользователям: он крупнее обычного сохранения, потому что ничто не сжато в потоки объектов, а производственный путь для компактного файла — это обычный путь сохранения, описанный в статье потоки объектов и инкрементные обновления. Когда цель — найти, что не так, а не изменить это, автоматизированный путь в статье автоматизация preflight-отчётов отвечает быстрее, чем чтение байтов
Диагностическое сохранение, восстановление, preflight-проверка и сравнение работают с одной и той же моделью загруженного документа в Delphi и C++Builder; полный список возможностей — на странице компонента HotPDF Delphi PDF Component