Откройте PDF, созданный Microsoft Word или Excel, перелистайте его и ничего необычного не заметите. Загрузите его в программу на Delphi, запросите количество страниц - число будет верным. Затем пересохраните с включённым шифрованием, и операция завершится ошибкой EListError, или вывод откроется с предупреждением о повреждённой таблице перекрёстных ссылок. Файл никогда не был повреждён. Это файл с гибридными ссылками, и именно та структура, которая позволяет старому просмотрщику его открыть, не даёт загрузчику, который останавливается слишком рано, успешно обработать его
Это один из наиболее распространённых способов, при котором конвейер PDF, прошедший все внутренние тесты, встречает файл, с которым не справляется. Входные данные всегда генерировались внутри компании, поэтому гибридных файлов среди них не было. Первый гибридный файл появляется в тот день, когда клиент пересылает счёт, экспортированный из электронной таблицы
Что в действительности записывают Word и Excel
ISO 32000-1 описывает структуру гибридных ссылок в §7.5.8.4. Приложение, которое хочет использовать функции PDF 1.5, такие как потоки объектов, при этом позволяя PDF 1.4-совместимому ридеру открыть файл, записывает информацию о перекрёстных ссылках дважды. Существует классическая таблица перекрёстных ссылок - строки ASCII фиксированной ширины, завершавшие каждый PDF до версии 1.4, - и поток перекрёстных ссылок, индексирующий остальное. Трейлер классической секции содержит запись /XRefStm, значение которой является байтовым смещением этого потока
Разделение функций сделано намеренно. Объекты, которые необходимы старому ридеру - каталог и дерево страниц - адресуются через классическую таблицу. Объекты, помещённые в сжатые потоки объектов, помечены как свободные в классической таблице записью типа f, поэтому ридер 1.4 пропускает их и никогда не сталкивается со структурой, которую не умеет разобрать. Их реальное расположение хранится только в потоке перекрёстных ссылок. Признак такого файла - его конец: короткая классическая секция, нередко содержащая лишь xref с заголовком подсекции 0 0, чей трейлер указывает на /XRefStm, где находятся реальные данные восстановления
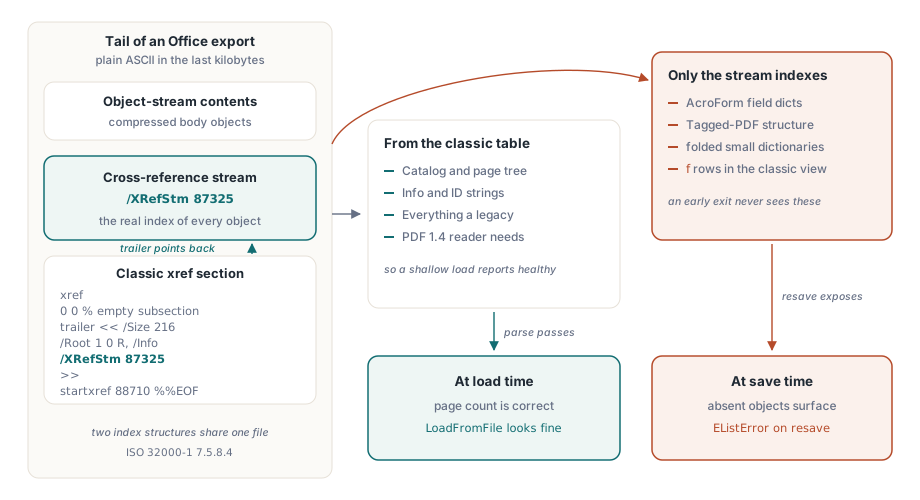
/XRefStm, тогда как стримовая сторона держит настоящий индекс объектовПочему верное количество страниц ничего не доказывает
Поскольку каталог и дерево страниц специально доступны через классическую таблицу, загрузчик, читающий только её, находит /Root, обходит дерево страниц и сообщает правильное количество страниц. Всё, что нужно старому ридеру, присутствует, поэтому файл выглядит корректным. Отсутствующие объекты - те, что упакованы в потоки объектов: словари полей AcroForm, структурные элементы тегированного PDF, длинный хвост мелких словарей, которые никогда не должны были быть видны устаревшему просмотрщику
Пробел не замечается до тех пор, пока что-то не обращается к этим объектам, а полное сохранение обращается ко всем из них. Обход документа для повторного шифрования или перезаписи - именно та операция, которая последовательно запрашивает каждый номер объекта, поэтому симптом проявляется при сохранении, а не при загрузке, вдали от своей причины
Ловушка - детектор, который видит xref и останавливается
Дешёвый способ определить, как индексирован файл, - следовать startxref и проверить первые байты, на которые он указывает. Ключевое слово xref означает классическую таблицу; потоковый объект - поток перекрёстных ссылок. Этот тест верен для любого файла, использующего только одну схему. Он неверен для гибридного файла, чей startxref указывает на классическую секцию исключительно для удовлетворения старых ридеров, тогда как именно в /XRefStm трейлера этой секции реально индексирована большая часть документа. Детектор, возвращающий "классический" при первом встреченном xref, никогда не читает /XRefStm, и каждый объект, находящийся только в потоке, становится невидимым
var
  Pdf: THotPDF;
  PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('Invoice_XLS.pdf');  // количество верное
    // проверьте или отредактируйте загруженный документ здесь
    Pdf.SaveLoadedDocument('Invoice_secured.pdf');     // обходит каждый объект
  finally
    Pdf.Free;
  end;
end;
При наличии детектора с ранним выходом загрузка выглядит корректной, а именно при пересохранении отсутствующие объекты заявляют о себе. Исправление заключается не в том, чтобы читать больше байт в начале; оно в том, чтобы распознать гибридный трейлер и следовать /XRefStm прежде, чем решить, что файл завершён
Порядок слияния обязателен
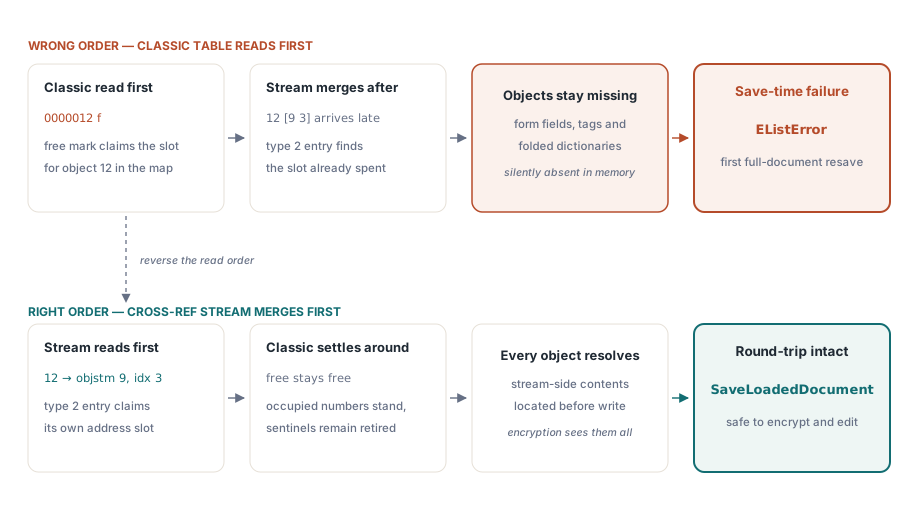
После прочтения обоих индексов их можно объединить только в одном направлении. Поток перекрёстных ссылок должен быть слит первым, а вокруг него заполняются классические записи. Причина - маленький обман в основе формата. Гибридный файл помечает сжатые объекты как свободные в классической таблице, чтобы старые ридеры их игнорировали. Загрузчик, придерживающийся принципа "выигрывает первый увиденный" и читающий сначала классическую таблицу, запишет эти номера объектов как свободные, а затем отбросит записи потока, которые их реально локализуют, поскольку слоты уже заняты. Перевернув порядок, записи типа 2 из потока - каждая содержит номер потока объектов плюс индекс - занимают предназначенные им слоты, а классические записи заполняются вокруг них
Та же дисциплина защищает от воскрешения удалённого объекта более старой ревизией. Инкрементные обновления цепочкой ссылаются назад через /Prev, а запись типа 0 (свободная) - это признак того, что более поздняя секция вывела номер объекта из обращения. Более поздняя, но более старая секция цепочки не должна перезаписывать этот признак устаревшим расположением. Если считать первое вхождение авторитетным для свободных маркеров - удалённый объект остаётся удалённым; при небрежном подходе история файла оживляет содержимое, которое последняя ревизия удалила
Что это означает в HotPDF
Движок разрешает файлы с гибридными ссылками автоматически на каждом пути, где необходимо разобрать данные перекрёстных ссылок. Загрузите документ через LoadFromFile или LoadFromStream, внесите изменения и вызовите SaveLoadedDocument; или выполните однопроходную операцию, например EncryptFile, которая читает входной файл и записывает выходной. В любом случае восстановление читает /XRefStm, сливает секцию потока перед классическими записями и разрешает объекты, находящиеся в потоках, до того как запись перечислит их. Путь шифрования AES-256 - это место, где проблема впервые проявилась, поскольку шифрование документа перезаписывает каждый объект и потому требует, чтобы каждый объект уже был локализован
// Однопроходно: прочитать гибридный вход, записать AES-256 зашифрованную копию
Pdf.EncryptFile('Letter_DOC.pdf', 'Letter_secured.pdf',
  'owner-secret', '', aes256, [prPrint, prFillAnnotations]);
Стоит запомнить одну деталь, находящуюся выше уровня API. Файлы, поступающие из Word, Excel, PowerPoint и длинного списка конвейеров "Сохранить как PDF", как правило, являются гибридными, поэтому загрузчик, тестируемый только на выводе собственного генератора, может никогда не встретить такой файл при тестировании. Наполните тестовые данные документами, экспортированными из реальных приложений Office, а не только файлами, произведёнными вашим собственным кодом
Проверка подозрительного файла
Два способа быстро ответить на вопрос. Откройте файл в hex-просмотрщике и прочитайте байты после последнего startxref; в гибридном файле вы увидите короткую классическую секцию, трейлер которой содержит /XRefStm. Или сравните количество объектов, которое сообщает полный разбор, с наибольшим номером объекта, объявленным в /Size трейлера. Большой разрыв означает, что объекты прячутся в потоках, которые загрузчик не открывал, - это та же недостача, которая позднее превращается в ошибку при сохранении
Хвост типичного экспорта из Excel делает первую проверку наглядной. Всё, что идёт после последнего ключевого слова xref, - обычный ASCII, поэтому сигнатура читается прямо из hex-просмотрщика (смещения условные, комментарии добавлены)
xref
0 0                          % пустой классический раздел: строк нет совсем
trailer
<< /Size 216                 % на единицу больше максимального используемого номера объекта
   /Root 1 0 R
   /Info 15 0 R
   /ID [<5C9A...> <5C9A...>]
   /XRefStm 87325            % смещение байта потока cross-reference
>>
startxref
88710                        % указывает на расположенный выше классический раздел
%%EOF
Раздел 0 0 и есть та самая улика: классическая таблица с нулём записей существует только ради трейлера, а трейлер нужен главным образом ради строки /XRefStm 87325. Детектор, который останавливается на ключевом слове xref, к этому моменту увидел индекс из ничего. Если проверку удобнее заскриптовать, чем разглядывать глазами, помните: маркер всегда лежит в пределах последней пары килобайт файла, поэтому хватает ограниченного чтения с конца
// Возвращает смещение /XRefStm из хвоста файла, либо -1, если
// маркер отсутствует (файл не гибридный, либо это вообще не PDF)
function FindXRefStm(const FileName: string): Int64;
var
  FS: TFileStream;
  Tail: AnsiString;
  Len, P: Integer;
begin
  Result := -1;
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    Len := 2048;                        // трейлер находится в хвосте файла
    if FS.Size < Len then
      Len := Integer(FS.Size);
    FS.Position := FS.Size - Len;       // ограниченное чтение назад: максимум 2 КБ
    SetLength(Tail, Len);
    FS.ReadBuffer(Tail[1], Len);
  finally
    FS.Free;
  end;
  P := Pos(AnsiString('/XRefStm'), Tail);
  if P = 0 then
    Exit;                               // в хвосте нет гибридного маркера
  Inc(P, Length('/XRefStm'));
  while (P <= Len) and (Tail[P] in [' ', #9, #13, #10]) do
    Inc(P);                             // пропустить пробельные символы после ключа
  Result := 0;
  while (P <= Len) and (Tail[P] in ['0'..'9']) do
  begin
    Result := Result * 10 + Ord(Tail[P]) - Ord('0');
    Inc(P);
  end;
end;

// Использование: неотрицательный результат называет байт, с которого начинается поток
if FindXRefStm('Invoice_XLS.pdf') >= 0 then
  Writeln('hybrid-reference file: resave will need the /XRefStm section');
Относитесь к этой пробе как к сортировке, а не как к парсеру: она говорит лишь о том, какие файлы в пакете заслуживают внимания до запуска задания на пересохранение, и ничего больше. Что загрузчик обязан делать с найденным смещением - идти по цепочке секций, класть записи потока поверх классических, учитывать сигнальные свободные записи - разобрано по шагам в нашей парной статье о работе с гибридными PDF из приложений Office
Сторона записи этой истории - как в первую очередь создаются потоки объектов и сжатые перекрёстные ссылки - рассматривается в нашей статье о потоках объектов и инкрементных обновлениях. Когда рассматриваемый гибридный файл также очень большой, методы загрузки из руководства по Direct File API для работы с большими PDF позволяют анализировать его без загрузки всего в память. Оба метода хорошо сочетаются с описанным здесь восстановлением, которое поставляется в составе компонента HotPDF для Delphi и C++Builder вместе с API загрузки, редактирования, шифрования и подписи, рассмотренными в других статьях блога