Подсчёт страниц в отсканированном архиве на 1,4 ГБ должен быть дешёвым. Вызовите LoadFromFile на этом файле, и он перестаёт быть дешёвым: HotPDF разбирает данные перекрёстных ссылок и строит объект в памяти для каждого из нескольких сотен тысяч косвенных объектов документа, а 32-битный воркер упирается в потолок адресного пространства в 2 ГБ где-то посреди этого разбора. Операции, которая была нужна, — подсчёту страниц — вообще не требовался ни один из этих объектов. Ей требовалось дерево страниц и ничего больше. Этот разрыв между тем, что запрашивает задача, и тем, что даёт полная загрузка, — вся причина существования Direct File API
Direct File API даёт коду на Delphi и C++Builder доступ к PDF на уровне файла: подсчёт страниц, копии, расшифровка, инкрементальные добавления — всё это читает с диска ровно то, что реально нужно, вместо восстановления полной модели документа в ОЗУ. Мастерство состоит в том, чтобы сопоставить каждую задачу с самым лёгким уровнем, способным её решить. Сопоставьте правильно, и служба удерживает плоское потребление памяти при любом размере входа. Ошибитесь, и первый же слишком большой файл уложит воркер
Во что вам обходится полная загрузка
LoadFromFile — не враг. Она честно отрабатывает свою память: как только дерево оказывается в ОЗУ, у вас есть произвольный доступ к каждой странице и каждому объекту, а это ровно то, что требуют InsertPagesFromDocument, MovePage и повторная сериализация через SaveLoadedDocument. Для настоящей перестройки структуры короткого пути не существует; чтобы переставить документ, его нужно держать целиком
Проблемы начинаются, когда размеры входных файлов вам не подконтрольны. Загрузки клиентов, вывод сканеров и архивы десятилетней давности игнорируют всё, что предполагал ваш тестовый корпус. Загружайте каждый вход безусловно, и потолок памяти будет задан одним-единственным крупнейшим файлом, который кто-либо когда-либо пришлёт. Время разбора следует за числом объектов, а резидентная память устанавливается на уровне в несколько раз больше размера файла, если учесть структуры объектов и декодированные потоки, так что гигабайт на диске может означать несколько гигабайт в резидентной памяти
Перекомпиляция под 64 бита поднимает потолок адресного пространства, но не отменяет счёт. Воркер по-прежнему сжигает секунды CPU и кратный размеру файла объём ОЗУ, чтобы ответить на вопрос, на который собственная структура файла могла бы ответить за миллисекунды. При конкурентности арифметика становится враждебной: четыре крупные загрузки, идущие одновременно, делят один бюджет памяти, и пропускная способность проваливается ровно тогда, когда очередь наиболее глубока и это меньше всего можно себе позволить
Чтение файла через дескриптор
Уровень «только для чтения» открывает файл как дескриптор, отвечает на структурные вопросы о нём и закрывает его. Никакого дерева объектов, никакого рендеринга страниц, никакой памяти, растущей вместе с входом
var
  Pdf: THotPDF;
  Handle, PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Handle := Pdf.DAOpenFileReadOnly('archive-2026-06.pdf', '');
    if Handle > 0 then
    try
      PageCount := Pdf.DAGetPageCount(Handle);
      RouteByPageCount('archive-2026-06.pdf', PageCount);
    finally
      Pdf.DACloseFile(Handle);
    end;
  finally
    Pdf.Free;
  end;
end;
Три привычки удерживают этот уровень честным. Во-первых, проверяйте возвращаемое значение. Неположительный дескриптор означает, что открытие провалилось, и вызов DAGetPageCount на мёртвом дескрипторе — это тот вид бага, что остаётся скрытым до того дня, когда клиент пришлёт повреждённый файл. Во-вторых, сопровождайте каждое успешное открытие вызовом DACloseFile внутри блока finally; служба, теряющая дескрипторы, не падает — она просто гниёт, а это хуже. В-третьих, уважайте то, что параметр пароля реально делает. DAOpenFileReadOnly принимает пароль, но для зашифрованных входов тихо откатывается к полному разбору, чтобы прочитать число страниц, так что гарантия плоской памяти испаряется. Направляйте защищённые файлы сначала через DecryptFile, и остальная часть конвейера останется дешёвой
Тот же зонд заодно служит шлюзом сортировки. Файлы приходят с неверной меткой, недогруженными или переименованными из совершенно другого формата, и проверка DAOpenFileReadOnly отклоняет всё это прямо на входе за миллисекунды, с ошибкой, привязанной к виновному файлу. Альтернатива — позволить мусорному файлу заехать глубоко в воркер очереди и взорваться там, где распутывание того, какой именно вход это вызвал, может стоить целого дня
Копирование, расшифровка и шифрование целых файлов
Второй уровень перемещает и трансформирует целые файлы, никогда не раскрывая их внутреннее устройство. Именно на эти вызовы больше всего опираются конвейеры приёмки
// Структурная копия: проверка-и-перемещение без разбора дерева объектов
Status := Pdf.DACopyFile('incoming\statement.pdf', 'verified\statement.pdf');
LogDirectFileStatus('copy', Status);

// Расшифровка при копировании: путь Direct File к защищённым входам
Status := Pdf.DecryptFile('incoming\protected.pdf',
  'verified\plain.pdf', 'batch-password');
LogDirectFileStatus('decrypt-copy', Status);

// Шифрование при копировании: защита вывода без полной загрузки
Status := Pdf.EncryptFile('verified\statement.pdf',
  'outbound\statement.pdf', 'owner-secret', '', aes256, [prPrint]);
LogDirectFileStatus('encrypt-copy', Status);
Каждый вызов оправдывает своё место. DACopyFile — это проверенная копия из карантинного каталога в управляемое хранилище: он открывает и индексирует структуру PDF по ходу дела, так что усечённый или не-PDF вход провалится прямо здесь, а не тремя стадиями ниже. DecryptFile записывает расшифрованную копию по прямому пути перезаписи AES-256, который пропускает дерево объектов всякий раз, когда вход это позволяет, — аналог для больших файлов потока расшифровки «загрузка-и-пересохранение», рассмотренного в статье о шифровании AES-256. EncryptFile выполняет то же движение в обратную сторону, применяя защиту паролем во время копирования на уровне файла с параметрами типа ключа и разрешений, которые уже использует путь в памяти
Добавление изменений вместо перезаписи
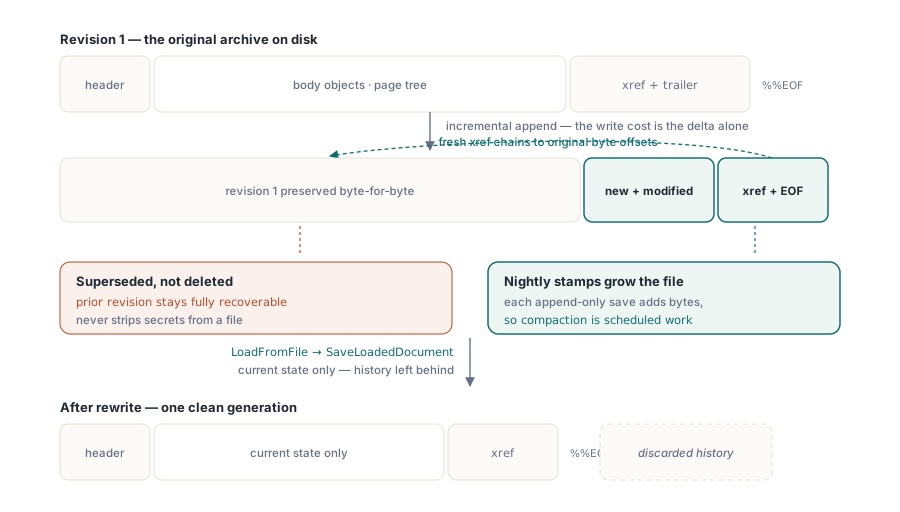
Инкрементальное обновление, определённое в ISO 32000-1 §7.5.6, — это третий уровень. Исходные байты остаются на своих местах на диске, а любые новые или изменённые объекты дописываются после них, за ними следует свежий раздел перекрёстных ссылок, сцепляющийся обратно с оригиналом. Для архива на 900 МБ, которому нужно добавить одну страницу, стоимость записи — это дельта, а не весь файл
// Добавляем страницу аудита в большой архив без его перезаписи
Pdf.BeginIncrementalUpdate('archive-2026-06.pdf');
Pdf.AddPage;
Pdf.CurrentPage.SetFont('Arial', [], 10);
Pdf.CurrentPage.TextOut(50, 760, 0, 'Processed by intake service 2026-06-11');
Pdf.SaveIncrementalUpdate('archive-2026-06-stamped.pdf');  // исходные байты + дельта
Здесь важны два пункта дисциплины. BeginIncrementalUpdate обязан указывать на исходный файл, поскольку дописанные данные перекрёстных ссылок сцепляются обратно со смещениями байтов внутри него. И модель по замыслу только для добавления: каждое инкрементальное сохранение увеличивает файл, никогда не уменьшая его. Документ, штампуемый каждую ночь, будет расти без ограничений, пока периодическая повторная сериализация — загрузка его и запись обратно через SaveLoadedDocument — не сожмёт его. Та же самая природа «только для добавления» и делает инкрементальное обновление единственным безопасным способом коснуться документа с цифровой подписью — ограничение, рассмотренное в статье о цифровых подписях и PAdES. Лежащий в основе механизм перекрёстных ссылок получает собственное рассмотрение в статье об object streams и инкрементальных обновлениях
В сохранениях только для добавления есть ловушка, ускользающая от большинства ревью. Исходные байты остаются в файле, читаемые для любого, кто захочет посмотреть. Инкрементальное обновление, которое «заменяет» страницу, не удаляет старую; оно вытесняет её в текущей ревизии, пока предыдущая ревизия остаётся там же, полностью восстановимая. Так что инкрементальные обновления — неправильный инструмент для вычищения чувствительного содержимого. Чтобы по-настоящему сбросить историю, которую получатель никогда не должен увидеть, нужна полная повторная сериализация: LoadFromFile, за которой следует SaveLoadedDocument, записывающая только текущее состояние и оставляющая погребённые ревизии позади
Сопоставление уровня и операции
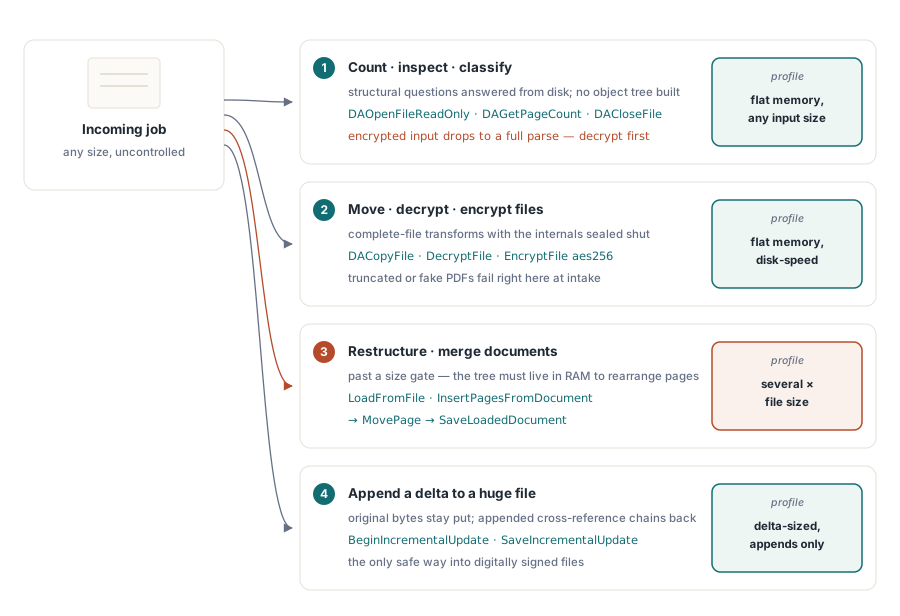
Логика выбора достаточно коротка, чтобы держать её в голове, и окупается закодировать её как явное решение о маршрутизации в начале конвейера, вместо того чтобы позволять каждой задаче импровизировать свой собственный путь. Нужная вам операция определяет уровень:
- Подсчёт, инспекция или классификация открывает дескриптор:
DAOpenFileReadOnly,DAGetPageCount,DACloseFile - Перемещение, расшифровка или шифрование целого файла остаётся на уровне файла с
DACopyFile,DecryptFileилиEncryptFile - Перестройка страниц или слияние документов требует полной загрузки:
LoadFromFile, затемInsertPagesFromDocumentилиMovePage, затемSaveLoadedDocument - Добавление небольшой дельты в огромный или подписанный файл вызывает
BeginIncrementalUpdateи сохраняет
Смешанным конвейерам полезно ставить порог по размеру перед путём полной загрузки. Направляйте всё, что превышает несколько сотен мегабайт, через уровни Direct File, и оставляйте полную загрузку для настоящей перестройки структуры на 64-битном воркере с реальным бюджетом памяти. Порог превращает падение из-за нехватки памяти в решение о маршрутизации, которое вы можете видеть и настраивать
Какой бы уровень ни обрабатывал задачу, пишите её результат под временным именем и переименовывайте на место только после того, как результат прошёл проверку. Наполовину записанный файл, лежащий под финальным именем, выглядит для следующей стадии конвейера в точности как хороший, а вызовы Direct File делают проверку дешёвой: подтверждение вывода — это однострочный зонд дескриптора
Direct File API поставляется как часть HotPDF Delphi Component для Delphi и C++Builder. Страница продукта ссылается на полный справочник функций, включая показанные здесь вызовы инкрементального обновления