Первый объект линеаризованного PDF обязан называть точную длину файла, в котором лежит, до байта, и обязан уложиться в первые 1024 байта. ISO 32000-1 в приложении F называет эту запись /L, а читалке, обнаружившей расхождение с реальным размером файла, предписано обращаться с документом как с обычным PDF и игнорировать все линеаризационные подсказки. Поэтому писатель должен напечатать длину файла, который ещё не дописал, — рядом со смещением hint-потока, концом первой страницы и положением таблицы перекрёстных ссылок ближе к концу файла. Все четыре числа сдвигаются, как только что-нибудь перед ними меняет размер
Плата за это — Fast Web View. Обычный PDF держит таблицу перекрёстных ссылок в конце, поэтому браузер, получивший 200-страничный отсканированный отчёт, не найдёт страницу 1, пока не придёт последний байт; линеаризованный файл выносит страницу 1 и небольшую секцию перекрёстных ссылок вперёд, и клиент с HTTP-запросами диапазонов рисует первую страницу рано. Дальше — сторона записи. Картина со стороны чтения — в объяснении линеаризации PDF и Fast Web View
Как HotPDF раскладывает линеаризованный файл
HotPDF пишет линеаризованный вывод, когда THotPDF.LinearizeOutput равен True, и файл следует физическому порядку, предписанному приложением F, часть за частью. После заголовка идут словарь параметров линеаризации, затем секция перекрёстных ссылок первой страницы с её трейлером, каталог с остальными объектами уровня документа, первичный hint-поток, первая страница со всеми нужными ей объектами, оставшиеся страницы по порядку, общие объекты поздних страниц, всё прочее и наконец главная таблица перекрёстных ссылок
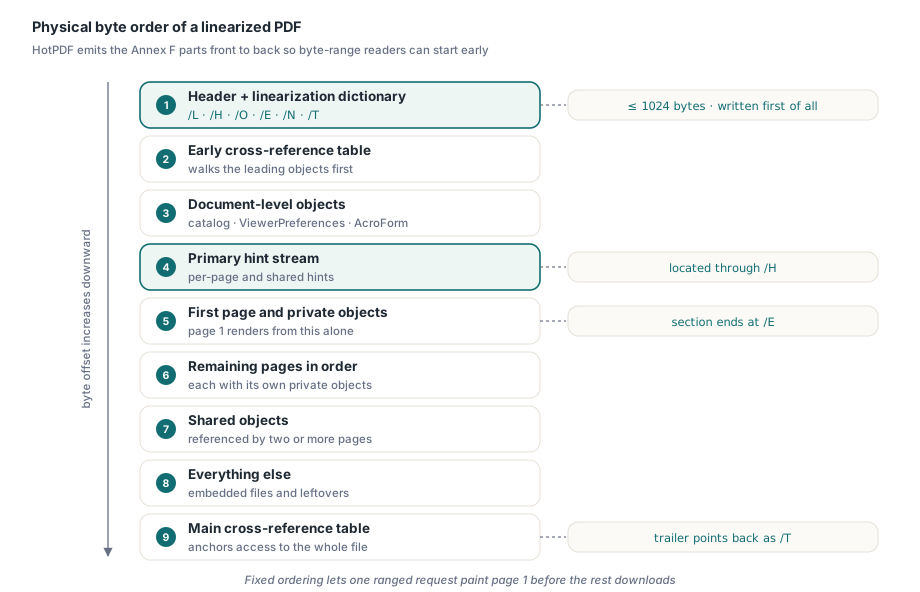
В модели документа ничего не говорит о том, к какой части принадлежит объект. Писатель выводит это из графа ссылок при сохранении в EndDoc: идёт от каждого объекта страницы и считает, сколько страниц достигают каждого косвенного объекта. Объект, которого достигает одна страница, попадает в её секцию. Объект, которого достигают несколько, — общий, с одним поворотом, который мимолётное чтение спецификации упускает: если среди использующих его страниц есть страница 1, объект всё равно идёт в секцию первой страницы, потому что страница 1 должна отрисовываться из одних лишь начальных байтов. В общей части ждут только объекты, общие исключительно для поздних страниц. Каталог — что бы ни указывали его записи /ViewerPreferences, /OpenAction, /Threads и /AcroForm — и словарь шифрования защищённого документа составляют группу уровня документа. Узлы дерева страниц задвигаются в хвостовую часть, чтобы они никогда не разували первую страницу
Откройте вывод в hex-редакторе — и нумерация покажется вывернутой. Передний блок, от словаря линеаризации до hint-потока, несёт самые старшие номера объектов в файле, а всё после него нумеруется с 1. Маленькая секция перекрёстных ссылок спереди покрывает ровно этот старший блок, а главная таблица — от 1 до N
Ловушка инициализации записей в списках разбиения
Такие списки естественно пишутся как запись с динамическим массивом плюс отдельный счётчик, и эта форма прячет ловушку Delphi. Компилятор инициализирует управляемые поля локальной записи. Обычный Integer рядом с ними не получает ничего. Под Win32 слот стека часто случайно содержит ноль, так что первая вставка попадает в индекс 0 и все тесты проходят; под Win64 в слоте может лежать мусор, и первая вставка пишет в произвольный индекс
type
  TPartList = record
    Values: TArray<Integer>;  // управляемое: обнуляется компилятором
    Count: Integer;           // неуправляемое: что было в стеке, то и осталось
  end;

procedure Append(var List: TPartList; Value: Integer);
begin
  if List.Count = Length(List.Values) then
    SetLength(List.Values, List.Count * 2 + 16);
  List.Values[List.Count] := Value;
  Inc(List.Count);
end;

procedure BuildParts;
var
  FirstPage, Shared: TPartList;
begin
  FirstPage := Default(TPartList);   // обязательно, не косметика
  Shared := Default(TPartList);
  Append(FirstPage, 12);
  Append(Shared, 40);
end;
Писатель HotPDF присваивает Default каждому списку разбиения до первого касания. Зелёный прогон под Win32 ничего не говорит о том, была ли инициализирована такая запись
Почему раскладка обязана сойтись до записи первого байта?
Потому что передняя часть файла держит смещения, указывающие на заднюю, и число цифр в этих смещениях сдвигает всё, что позади. Трейлер первой страницы несёт запись /Prev с байтовым смещением главной таблицы перекрёстных ссылок. Напишите это смещение как 99998, потом обнаружьте, что таблица реально легла на 100003, — и трейлер вырастает на одну цифру. Секция перекрёстных ссылок первой страницы растёт вместе с ним, каждый объект позади сдвигается на байт, и главная таблица теперь сидит на 100004. Один проход угадывает это только по счастливой случайности
HotPDF разрывает круг двумя ходами. Словарь параметров кладётся в фиксированный слот в 384 байта, добитый пробелами, так что /L, /H, /E и /T берут сколько угодно цифр, не сдвигая ни одного объекта; понадобься тексту словаря больше 384 байт, запись подняла бы исключение, а не двигала файл. Остаётся /Prev — единственная свободная переменная, и она прогоняется через цикл неподвижной точки. Каждый объект сначала сериализуется в считающий поток, который запоминает длины и не хранит байтов. Проход раскладки затем назначает смещения секция за секцией и сообщает, куда легла бы главная таблица, и этот ответ становится входом следующего прохода. Цикл останавливается, когда предложенное смещение перестаёт двигаться, и сдаётся исключением после восьми попыток
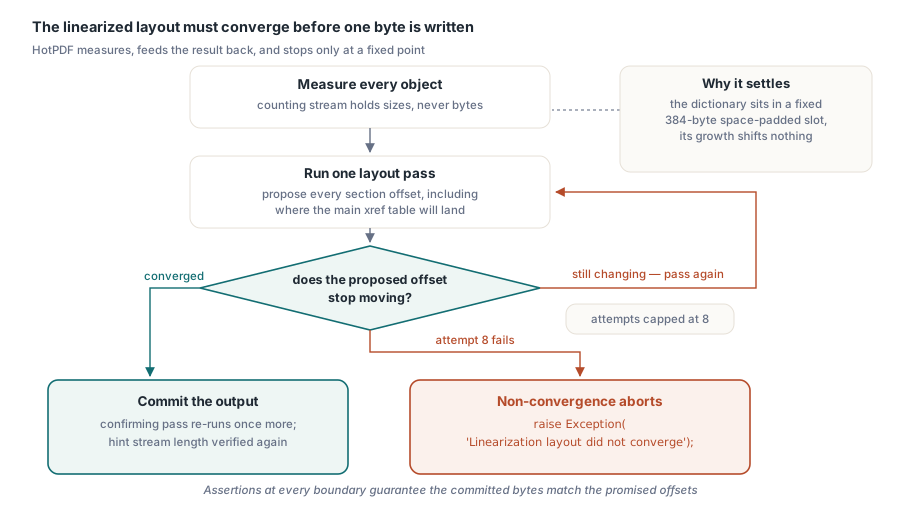
Сдвигает что-либо только изменение числа цифр, так что третий проход нужен лишь возле границы степени десятки, как в случае с 99998. После сходимости писатель делает один подтверждающий проход, пересобирает hint-поток с реальными смещениями и проверяет, что его длина не изменилась: смещения сидят в полях фиксированной ширины, поэтому черновая версия и финальная обязаны совпасть. Затем вывод идёт прямо в целевой поток без буферизованной второй копии, и на каждой границе секции записанные байты сверяются с обещанным смещением. Расхождение поднимает исключение из EndDoc
Hint-таблицы и места, где приложение F читается двояко
Первичный hint-поток несёт две таблицы. Hint-таблица смещений страниц записывает для каждой страницы, сколько объектов держит её секция, какова длина секции в байтах и от каких общих объектов она зависит. Hint-таблица общих объектов перечисляет длину каждой группы общих объектов. Имея обе, читалка может запросить страницу 37 напрямую, а запись /S потока даёт позицию внутри потока, где начинается таблица общих объектов
Две детали приложения F, раздел F.4, легко испортить. Первая: смещения в hint-таблицах — логические, посчитанные так, будто первичного hint-потока не существует. Объект первой страницы и первый общий объект физически лежат после hint-потока, поэтому писатель вычитает длину hint-объекта, прежде чем записывать их смещения. Писатель, записывающий физические смещения, уводит каждый последующий range-запрос ровно на размер hint-объекта
Вторая — настоящая двусмысленность. Текст F.4 описывает каждую таблицу как один непрерывный битовый поток со старшим битом вперёд и перечисляет группы первой страницы и группы поздних страниц двумя отдельными последовательностями. Ходящие по свету hint-потоки добивают каждую колонку до границы байта и считают группы общих объектов одним объединённым списком, и именно эту форму, как известно, принимают читалки, потребляющие подсказки. HotPDF пишет выровненное на байты объединённое расположение. Это правильная сторона: таблица, удовлетворяющая букве F.4, но рассинхронизированная для читающих её клиентов, отказывает ровно там, где линеаризация должна была окупиться, а загрузка файла целиком проблему никогда не покажет
Включение линеаризованного вывода из Delphi
На стороне API переключатель — один Boolean. LinearizeOutput по умолчанию False, и писатель сверяется с ним, когда EndDoc сериализует документ, так что задайте его вместе с прочими опциями вывода до BeginDoc и не трогайте дальше. Каждый описанный выше отказ (несходимость, слишком большой словарь параметров, несовпадение на границе, потолок 4 ГиБ, разобранный ниже) всплывает исключением из EndDoc, что делает запасной путь простым
procedure WriteReport(const FileName: string; Linearize: Boolean);
var
  PDF: THotPDF;
begin
  PDF := THotPDF.Create(nil);
  try
    PDF.FileName := FileName;
    PDF.Version := pdf17;
    PDF.LinearizeOutput := Linearize;   // задаётся до BeginDoc
    PDF.BeginDoc;                       // создаёт страницу 1
    PDF.CurrentPage.TextOut(72, 72, 0, 'Quarterly summary');
    PDF.AddPage;
    PDF.CurrentPage.TextOut(72, 72, 0, 'Details');
    PDF.EndDoc;                         // здесь происходят раскладка и запись
  finally
    PDF.Free;
  end;
end;

procedure PublishReport(const FileName: string);
begin
  try
    WriteReport(FileName, True);
  except
    on E: Exception do
    begin
      LogWarning('Linearization failed: ' + E.Message);  // ваш собственный логгер
      WriteReport(FileName, False);                      // вместо него обычный PDF
    end;
  end;
end;
Запасной путь даёт обычный PDF, который открывает любой просмотрщик; теряется только быстрая первая страница. Для конвейера отчётов размен очевиден: медленная первая отрисовка — раздражение, а отсутствие отчёта — инцидент
Сторона развёртывания важнее кода. Линеаризация окупается, только когда сервер чтит HTTP-запросы Range; эндпоинт, отдающий файл целиком, покупает вам более медленную запись и больший файл безо всякой выгоды. Держите LinearizeOutput выключенным для файлов, которые уходят по почте, вложениями или скачиваются до того, как их кто-то откроет. Включайте для документов, которые браузер открывает прямо по URL, — после проверки, что ответ несёт Accept-Ranges: bytes
Почему LinearizeOutput выключает потоки объектов?
Потому что каждая запись hint-таблицы описывает диапазон байтов, а объект, упакованный в контейнер /ObjStm, собственного диапазона не имеет: он существует лишь как срез другого сжатого потока, который надо получить и распаковать целиком. Со включённым LinearizeOutput HotPDF пишет традиционные текстовые таблицы перекрёстных ссылок и распакованные косвенные объекты, даже если задан ещё и UseXRefStream или UseObjectStreams. Линеаризованный путь главенствует при сохранении, так что вашему коду нечего разрешать
Цена — размер файла: маленькие словари, которые поток объектов сжал бы вместе, теперь остаются россыпью. Если компактный вывод важнее задержки первой страницы, компромисс разобран в потоках объектов и инкрементальных обновлениях HotPDF. Office-экспортёры упираются в то же напряжение с другой стороны, поэтому некоторые из них выдают раскладку, описанную в гибридных потоках перекрёстных ссылок в PDF из Office
Линеаризации нужен ещё и PDF 1.2 или новее. С более низкой Version HotPDF поднимает документ до 1.2 при сохранении. С установленным StrictVersionLock вместо этого поднимается исключение: версия, зафиксированная намеренно, не должна меняться за спиной
Потолок 4 ГиБ для линеаризованного вывода
Hint-таблицы хранят смещения и длины в 32-битных полях, поэтому линеаризованный файл не может адресовать ничего за 4 ГиБ, и HotPDF отказывается его создавать, а не пишет заворачивающиеся смещения. Потолок — из ширины полей, определённой приложением F
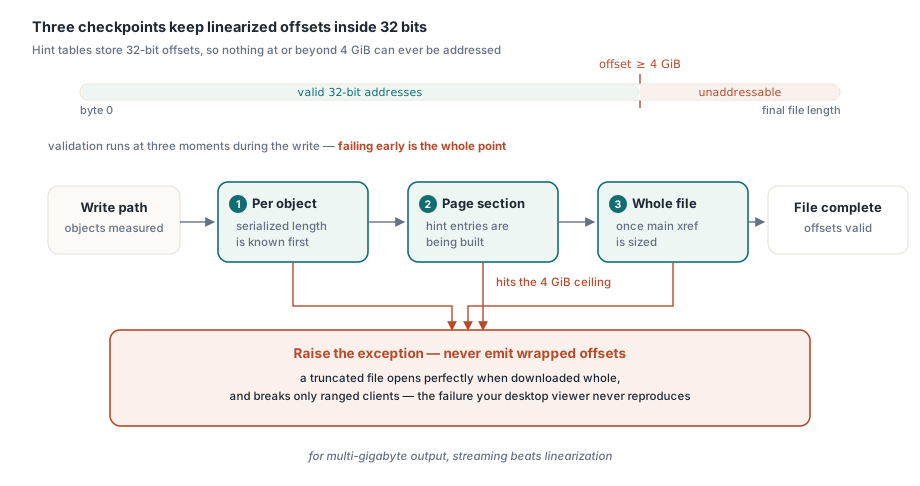
Проверка срабатывает в трёх точках, все — до того, как первый байт дойдёт до приёмника: на каждом объекте, как только известна его сериализованная длина; на длине каждой секции страницы, пока строятся hint-записи; и на итоговой длине файла, когда размер главной таблицы перекрёстных ссылок определён. Завернувшиеся смещения — худший из способов отказа: просмотрщик, скачивающий файл целиком, может игнорировать подсказки, а клиент диапазонов прыгнет на чужие байты, поэтому настольное тестирование этот отказ никогда не воспроизводит. Для многогигабайтного вывода смотрите в сторону потокового маршрута из Direct File API для больших PDF-конвейеров
Проверка, линеаризован ли входящий файл
THotPDF.IsLoadedLinearized сообщает, объявляет ли загруженный документ себя линеаризованным. Проверка происходит до разбора: HotPDF читает до 1024 байтов с нулевой позиции источника, находит первый объект и ищет внутри него /Linearized со значением 1. Комментарии, литеральные и hex-строки пропускаются, так что имя внутри строки не считается, а сканирование останавливается на stream или endobj. Принимается только 1 или эквивалент вроде 1.0
Ответ кэшируется при загрузке, потому что к моменту вопроса прикладного кода парсер уже сдвинул позицию потока, а LoadFromFile уже освободил свой исходный поток
Флаг сообщает то, что заявляет файл. Приложение F добавляет второе условие: /L должен совпадать с фактической длиной файла, а инкрементальное обновление, дописанное после линеаризации, это совпадение ломает, так что читалки откатываются к обращению с файлом как с обычным. Конвейер, принимающий файлы от редакторов, дописывающих свои сохранения, может сравнить оба числа сам
// Ваш собственный помощник, не часть HotPDF: сверяет /L с реальным размером
// Упрощённый разбор; предполагает одиночный пробел после /L
function DeclaredLengthMatches(const FileName: string): Boolean;
var
  FS: TFileStream;
  Head: AnsiString;
  ActualSize: Int64;
  P, Q: Integer;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    ActualSize := FS.Size;
    SetLength(Head, 1024);
    SetLength(Head, FS.Read(Head[1], 1024));
  finally
    FS.Free;
  end;
  P := Pos(AnsiString('/L '), Head);
  Result := P > 0;
  if not Result then
    Exit;
  Inc(P, 3);
  Q := P;
  while (Q <= Length(Head)) and (Head[Q] in ['0'..'9']) do
    Inc(Q);
  Result := StrToInt64Def(string(Copy(Head, P, Q - P)), -1) = ActualSize;
end;

procedure InspectUpload(const FileName: string);
var
  PDF: THotPDF;
begin
  PDF := THotPDF.Create(nil);
  try
    if PDF.LoadFromFile(FileName) <= 0 then
      Exit;
    if not PDF.IsLoadedLinearized then
      Writeln('Not linearized')
    else if not DeclaredLengthMatches(FileName) then
      Writeln('Linearized, but modified after linearization')
    else
      Writeln('Ready for Fast Web View');
  finally
    PDF.Free;
  end;
end;
LinearizeOutput и IsLoadedLinearized входят в HotPDF Delphi Component для Delphi и C++Builder; страница продукта документирует, как они взаимодействуют с потоками перекрёстных ссылок, потоками объектов и фиксацией версии