Obiectul cu numărul 1 nu este pagina 1. Acest singur fapt încurcă mai mult cod de prelucrare PDF decât orice alt aspect al formatului, iar înțelegerea motivului cere să priviți dincolo de ce vă arată un vizualizator, până în graful de obiecte pe care îl citește el de fapt
Un fișier PDF este o colecție de obiecte indirecte numerotate. Fiecare obiect poartă un număr de obiect și un număr de generație, iar celelalte obiecte îl indică printr-o referință scrisă ca N G R: 3 0 R înseamnă versiunea curentă a obiectului 3. Paginile se numără printre aceste obiecte, dar secvența lor de afișare nu are nicio legătură cu locul în care stau în fișier sau cu numerele pe care le poartă. Ordinea de afișare este determinată în întregime de arborele /Pages, o structură înlănțuită cu rădăcina în catalogul documentului. Dacă ignorați arborele și parcurgeți obiectele în ordine numerică, veți asambla paginile în ordinea greșită pentru o parte însemnată dintre fișierele reale
Arborele de pagini: ce stabilește de fapt ordinea
Orice PDF începe cu un catalog de document (ISO 32000-2 §7.7.2). Catalogul conține o intrare /Pages care indică nodul rădăcină al arborelui de pagini. Acel nod rădăcină este un dicționar cu /Type /Pages, un tablou /Kids de referințe indirecte și un /Count care dă numărul total de pagini-frunză de sub el. Ordinea de afișare este parcurgerea în adâncime, de la stânga la dreapta, a acelui arbore, punct
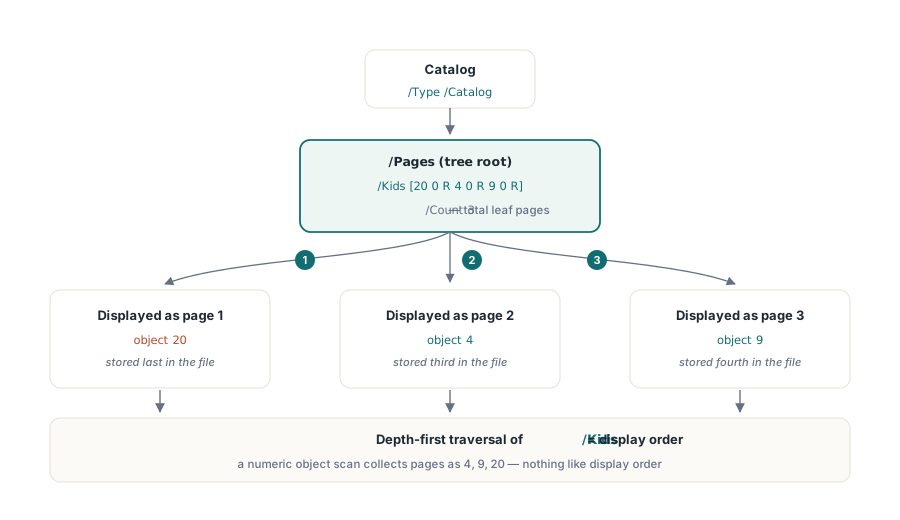
Un fișier minimal de trei pagini face lucrurile concrete:
%PDF-1.7

1 0 obj
<< /Type /Catalog /Pages 2 0 R >>
endobj

2 0 obj
<< /Type /Pages /Kids [20 0 R  4 0 R  9 0 R] /Count 3 >>
endobj

% Obiectul 4 este stocat al treilea în fișier, dar este pagina 2 în ordinea de afișare
4 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 5 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% Obiectul 9 este stocat al patrulea, dar este pagina 3
9 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 10 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% Obiectul 20 este stocat ultimul, dar este pagina 1; decide Kids[0], nu numărul de obiect
20 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 21 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj
Tabloul /Kids arată [20 0 R 4 0 R 9 0 R], deci obiectul 20 este pagina 1, obiectul 4 este pagina 2, iar obiectul 9 este pagina 3. Numerotarea obiectelor este irelevantă. Orice cod care iterează obiectele în ordine numerică și le adună pe cele cu /Type /Page va produce secvența greșită pentru acest fișier
De ce produc generatoarele dispuneri nesecvențiale? Din câteva motive. O bibliotecă ce prealocă numere de obiect pentru toate paginile înainte de a le scrie conținutul le va numerota în ordinea creării, apoi va scrie octeții propriu-ziși în orice ordine îi convine serializatorului. Un instrument de îmbinare care coase documente laolaltă renumerotează obiectele din fiecare document sursă pentru a evita coliziunile; obiectele-pagină renumerotate ajung împrăștiate în tabelul de obiecte combinat, în timp ce noul tablou /Kids al rădăcinii păstrează secvența corectă de afișare. Actualizările incrementale adaugă obiecte noi la finalul fișierului, cu numere proaspete, așa că o pagină adăugată ca revizie trăiește aproape de finalul fluxului de octeți chiar dacă îi revine poziția 1 din ordinea de afișare
Arbori plați și subarbori imbricați
Specificația permite două forme pentru arborele de pagini. Generatoarele simple produc o structură plată: un singur nod rădăcină /Pages al cărui tablou /Kids nu conține decât obiecte-frunză /Page. Aceasta se parcurge ușor: un singur nivel, o singură trecere
Documentele mari folosesc în mod curent, în schimb, un arbore echilibrat. Tabloul /Kids al nodului rădăcină /Pages conține noduri /Pages intermediare, fiecare dintre ele purtând la rândul lui un tablou /Kids propriu. Valoarea /Count de pe fiecare nod intermediar raportează numărul total de pagini-frunză din subarborele lui, așa că un vizualizator poate sări peste subarbori întregi când ajunge la o pagină după index, fără să parseze fiecare obiect. Un document de 1 000 de pagini structurat ca arbore echilibrat, cu 10 pagini per nod-frunză, poate localiza pagina 750 prin căutare binară, cu trei sau patru consultări de dicționar, în loc să parcurgă 750 de intrări /Kids
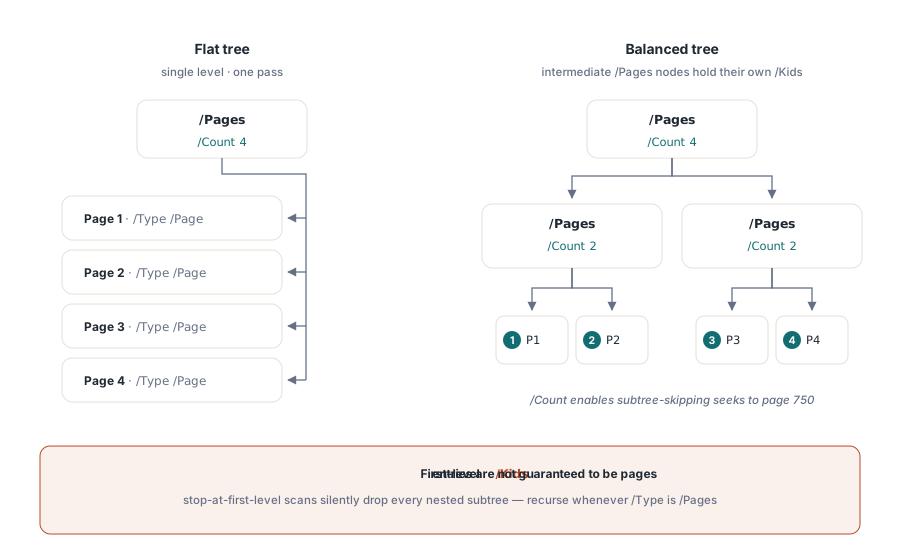
Consecința pentru codul de prelucrare: nu puteți presupune că primul nivel din /Kids conține obiecte /Page. Fiecare copil trebuie verificat. Dacă /Type-ul lui este /Pages, coborâți recursiv în el. Dacă /Type-ul lui este /Page, este o frunză. Oprirea la primul nivel pierde în tăcere subarbori întregi în orice document în care generatorul a ales imbricarea. De ce aleg de la bun început unii scriitori arbori adânci, la ce renunță instrumentele de aplatizare și cum se manifestă în practică o valoare /Count coruptă găsiți în articolul nostru însoțitor despre forma arborelui de pagini, gradul de ramificare și integritatea /Count
Atributele de pagină moștenite
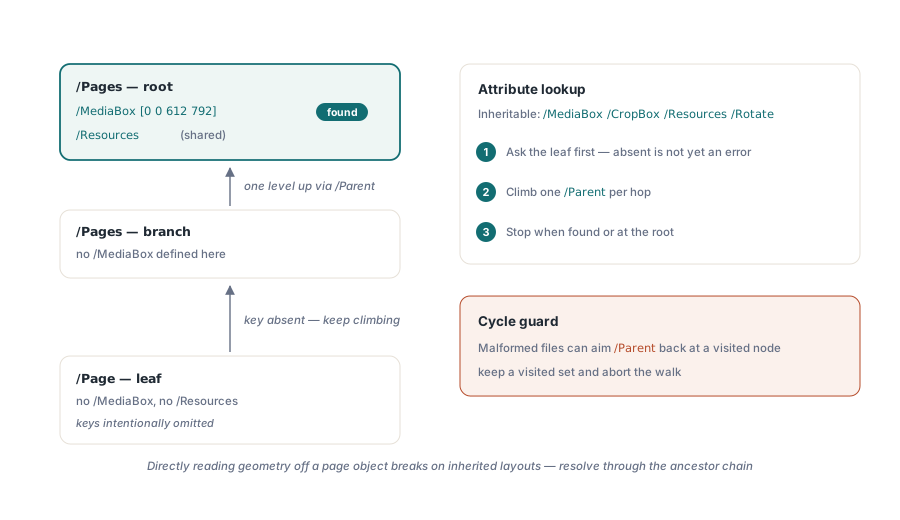
Arborele de pagini poartă și un mecanism de partajare a resurselor. Anumite atribute de pagină, /MediaBox, /CropBox, /Resources și /Rotate, sunt moștenibile (ISO 32000-2 §7.7.3.4). Dacă un dicționar /Page omite unul dintre ele, un cititor urcă pe lanțul /Parent până găsește atributul sau ajunge la rădăcină. Plasarea unui dicționar de fonturi partajat în nodul rădăcină /Pages, în loc de copierea lui în fiecare pagină-frunză, poate reduce simțitor dimensiunea fișierului pentru documentele care folosesc aceleași caractere tipografice peste tot
Regula moștenirii creează o subtilitate pentru codul care citește proprietățile paginii. Citirea lui /MediaBox direct dintr-un obiect /Page și tratarea cheii lipsă drept eroare este greșită; cheia poate fi pur și simplu moștenită. Codul care rezolvă corect geometria paginii trebuie să urmeze lanțul părinților. Are nevoie și de o protecție împotriva ciclurilor: un fișier corupt poate avea o referință /Parent care trimite înapoi la un nod deja vizitat, ceea ce ar bucla la nesfârșit fără o verificare a obiectelor vizitate
Tabelul xref și fluxurile de referințe încrucișate
Căutarea obiectelor indirecte trece prin tabelul de referințe încrucișate (sau prin succesorul lui, fluxul de referințe încrucișate introdus în PDF 1.5). Xref-ul asociază fiecare număr de obiect cu un offset în octeți în interiorul fișierului. Un cititor conform folosește xref-ul pentru a sări direct la orice obiect; el nu parcurge fișierul secvențial. Acest design cu acces aleatoriu este cel care face posibil saltul rapid între pagini: vizualizatorul citește catalogul, rezolvă referința /Pages prin xref, citește nodul rădăcină /Pages, rezolvă o intrare /Kids și așa mai departe, atingând doar obiectele de care are nevoie
Actualizările incrementale adaugă o nouă secțiune xref la finalul fișierului, cu un trailer care se înlănțuie înapoi la cel anterior. Un obiect actualizat într-o revizie primește o intrare nouă în secțiunea xref adăugată; octeții originali rămân pe loc, dar sunt înlocuiți. Așa rămân verificabile PDF-urile semnate digital chiar și după ce se adaugă revizii cu adnotări sau completări de formular: intervalul de octeți semnat nu este atins niciodată, iar conținutul nou trăiește în secțiunea adăugată. Arborele de pagini poate fi și el actualizat, așa că adăugările sau ștergerile de pagini dintr-o revizie produc o nouă rădăcină /Pages cu un tablou /Kids revizuit, în timp ce vechiul obiect rădăcină ocupă în continuare poziția lui originală în fișier. Fișierele linearizate (optimizate pentru web) adaugă o răsucire în dispunerea octeților: obiectele paginii 1 sunt mutate fizic în fața fișierului, ca un vizualizator să poată afișa prima pagină în timp ce restul încă se descarcă, și totuși arborele de pagini rămâne singura autoritate asupra ordinii — se schimbă doar offseturile consemnate în xref
Ce se strică fără parcurgerea arborelui
Modul de eșec al abordărilor prin parcurgerea obiectelor este tăcut. Documentul rezultat pare plauzibil: are numărul corect de pagini, iar fiecare pagină conține conținut recognoscibil. Doar ordinea este greșită, și greșită într-un fel care depinde de generator, de numărul de revizii și de faptul dacă vreo pagină a fost îmbinată din surse externe. Un corpus de test cu fișiere produse de un singur instrument poate trece complet; fișierele venite de la un alt instrument sau dintr-un flux de îmbinare vor pica. Această inconsecvență este motivul pentru care remediile euristice nu rezistă niciodată. Pentru o parcurgere a exact acestei defecțiuni într-un document real al unui client — simptom, diagnostic greșit și remediul prin parcurgere — vedeți studiul nostru de caz despre depanarea ordinii paginilor
Fișierele cu actualizări incrementale sunt deosebit de predispuse la asta, pentru că paginile adăugate sau rearanjate în revizii ulterioare poartă numere de obiect mari, în timp ce ordinea de afișare este controlată de tabloul /Kids actualizat. O parcurgere care prelucrează obiectele în ordine numerică va așeza acele pagini cu numere târzii la final, indiferent de locul în care spune arborele că le este locul
Remediul nu este complicat. Porniți de la catalog, rezolvați referința /Pages, parcurgeți recursiv tabloul /Kids și emiteți frunzele în ordinea în care le întâlniți. Aceasta este ordinea de afișare prin definiție, indiferent de numerele de obiect, de offseturile în octeți sau de structura fișierului. Majoritatea bibliotecilor PDF mature expun un număr de pagini și un accesor de pagină după index care fac deja acest lucru corect; riscul stă în codul care ocolește modelul de pagini al bibliotecii și atinge direct stratul de obiecte
O anomalie structurală care merită tratată explicit: valoarea /Count de pe un nod /Pages intermediar poate fi greșită în fișierele malformate. Dacă vă bazați pe /Count pentru verificarea limitelor și apoi vă opriți înainte de o parcurgere completă, veți omite pagini în tăcere atunci când numărul este subevaluat. Folosirea lui /Count doar ca indiciu de performanță pentru prealocarea capacității sau pentru căutarea binară, și derivarea numărului real din parcurgere, este modelul mai sigur pentru documentele importante