Simptomul a apărut într-un utilitar de copiere de pagini construit peste HotPDF Delphi Component: cererea paginii 1 dintr-un document de trei pagini producea constant pagina 2. Verificarea logicii de indexare nu a găsit nimic greșit. Apelul folosea un index logic numerotat de la 0, aritmetica era corectă, condițiile la limită erau în regulă. Și totuși ieșea de fiecare dată pagina greșită
Defectul nu era deloc în codul de copiere. Era în felul în care HotPDF își construia tabloul intern de pagini la încărcarea fișierului
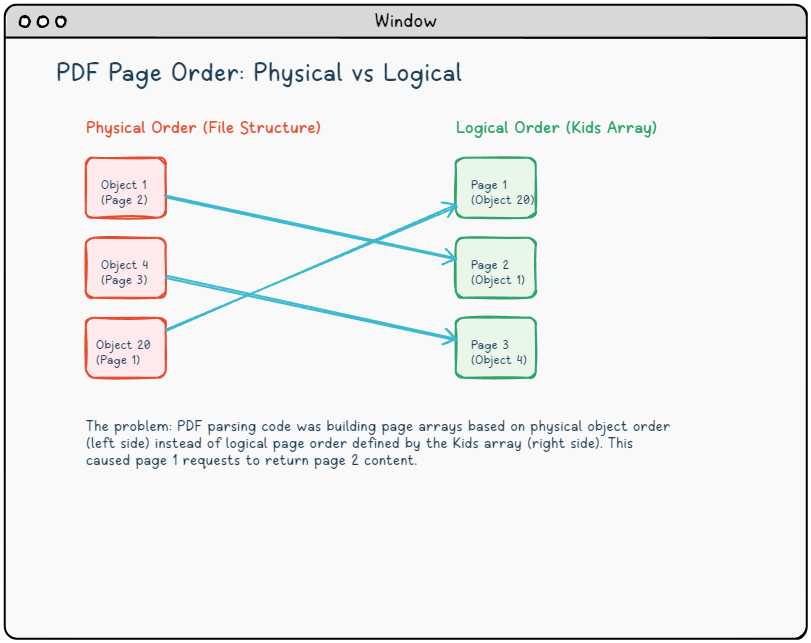
Două ordonări, o singură sursă de confuzie
Un fișier PDF este o colecție de obiecte indirecte, fiecare identificat printr-un număr de obiect. Structura fișierului nu impune acelor numere nicio obligație de a reflecta ordinea de citire. Obiectul 1 poate ține pagina 2; obiectul 20 poate ține pagina 1. Ce definește de fapt ordinea de citire este arborele de pagini: o ierarhie de dicționare /Pages ale căror tablouri /Kids listează referințe de pagini în secvența în care ar trebui să le afișeze un vizualizator (ISO 32000-1 §7.7.3)
Documentul care declanșa defectul avea această structură de arbore de pagini:
{ Rădăcina arborelui Pages, obiectul 16 }
16 0 obj
<<
  /Type /Pages
  /Count 3
  /Kids [20 0 R   { pagina logică 1 }
         1 0 R    { pagina logică 2 }
         4 0 R]   { pagina logică 3 }
>>
endobj
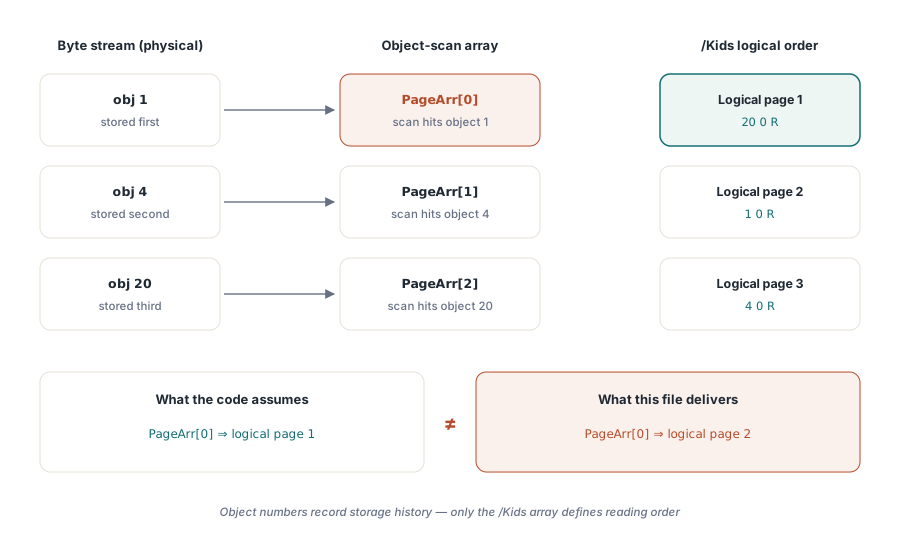
Fișierul se întâmpla să listeze obiectul 1 și obiectul 4 înaintea obiectului 20 în fluxul de octeți. Orice analizor care itera prin obiectele indirecte în ordinea din fișier și le ștampila într-un PageArr pe măsură ce găsea dicționare de tip pagină ajungea cu obiectul 1 la indexul 0, obiectul 4 la indexul 1 și obiectul 20 la indexul 2. Pagina logică 1 stă la PageArr[2]. Cererea indexului de pagină 0 aduce în schimb pagina logică 2
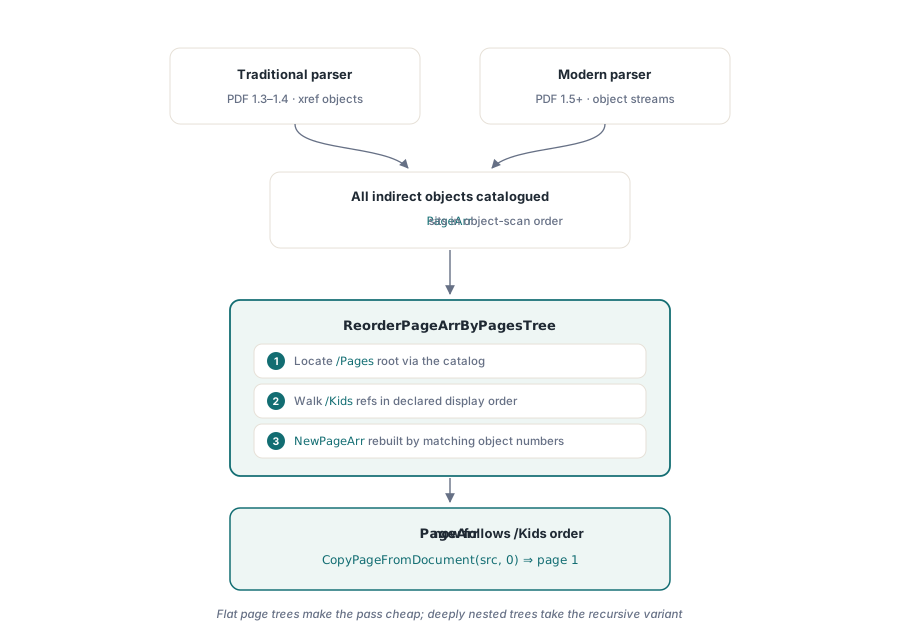
Exact asta făceau ambele trasee interne de analiză din HotPDF. Traseul tradițional, folosit pentru fișiere PDF 1.3/1.4, și traseul modern, folosit pentru documente cu fluxuri de obiecte (PDF 1.5+), construiau fiecare PageArr parcurgând obiectele indirecte în ordinea fizică din fișier, în loc să urmeze lanțul /Kids
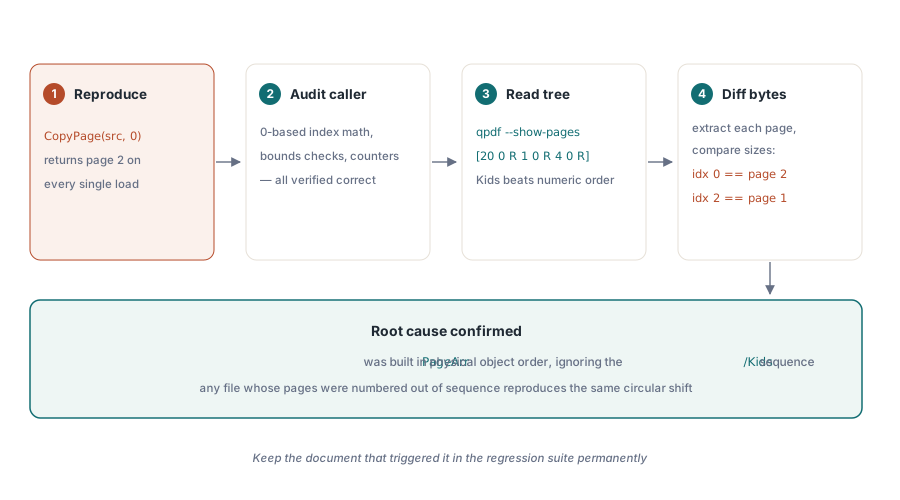
Confirmarea ipotezei
Înainte de a atinge vreo remediere, nepotrivirea trebuia dovedită, nu presupusă. Utilitarul de linie de comandă qpdf face asta simplu:
{ shell }
qpdf --show-pages input.pdf
{ Ieșirea arată ordinea Kids: 20 0 R, apoi 1 0 R, apoi 4 0 R }

qpdf --show-object="16 0 R" input.pdf
{ Arată dicționarul Pages cu /Kids în ordinea de citire }
Extragerea fiecărei pagini individual și verificarea dimensiunilor de fișier au confirmat corespondența: ce producea PageArr[0] era conținutul care aparținea paginii logice 2, iar PageArr[2] ținea pagina logică 1. Deplasarea circulară a fost dovada clară. Asta a explicat și de ce problema apărea la mai multe documente-sursă diferite: orice PDF în care obiectele de pagină se întâmplau să aibă numere de obiect mai mici decât o pagină logică anterioară o declanșa
Există un motiv simplu pentru care PDF-urile ajung în această stare. Salvările incrementale adaugă obiecte actualizate cu numere noi de obiect, lăsând sloturile vechi din tabelul de referințe încrucișate să indice spre nimic. Editoarele care adaugă o copertă o inserează cu un număr mare de obiect, indiferent de poziția ei din tabloul Kids. Unele generatoare scriu pur și simplu paginile într-o ordine convenabilă pentru transmiterea conținutului în flux, nu în secvența logică a paginilor. Formatul PDF nu le cere să facă altfel
Remedierea: urmați tabloul Kids
Abordarea corectă este să construiți PageArr parcurgând lanțul /Kids de la rădăcina catalogului, nu scanând obiectele indirecte. După ce ambele trasee de analiză își încheie trecerea inițială, un pas de postprocesare rezolvă ordinea logică:
procedure THotPDF.ReorderPageArrByPagesTree;
var
  PagesObj  : THPDFDictionaryObject;
  KidsArray : THPDFArrayObject;
  NewPageArr: array of THPDFDictArrItem;
  I, J, PageIndex, KidsIndex: Integer;
  RefObj    : THPDFLink;
  PageObjNum: Integer;
  Found     : Boolean;
begin
  { Localizează dicționarul rădăcină /Pages prin FRootIndex }
  PagesObj := FindPagesRootFromCatalog;
  if PagesObj = nil then Exit;

  KidsIndex := PagesObj.FindValue('Kids');
  if KidsIndex < 0 then Exit;
  KidsArray := THPDFArrayObject(PagesObj.GetIndexedItem(KidsIndex));

  SetLength(NewPageArr, KidsArray.Items.Count);
  PageIndex := 0;

  for I := 0 to KidsArray.Items.Count - 1 do
  begin
    RefObj     := THPDFLink(KidsArray.GetIndexedItem(I));
    PageObjNum := RefObj.Value.ObjectNumber;

    Found := False;
    for J := 0 to Length(PageArr) - 1 do
    begin
      if PageArr[J].PageLink.ObjectNumber = PageObjNum then
      begin
        NewPageArr[PageIndex] := PageArr[J];
        Inc(PageIndex);
        Found := True;
        Break;
      end;
    end;
    { Kids care nu sunt pagini (noduri /Pages intermediare) nu se potrivesc; se sar }
  end;

  if PageIndex > 0 then
  begin
    SetLength(PageArr, PageIndex);
    for I := 0 to PageIndex - 1 do
      PageArr[I] := NewPageArr[I];
  end;
end;
Apelul se pune la finalul fiecărui traseu de analiză, după ce toate obiectele au fost catalogate, dar înainte să fie servită vreo operație pe pagini:
{ Traseul tradițional }
ListExtDictionary(THPDFDictionaryObject(IndirectObjects.Items[I]), FPageslink);
ReorderPageArrByPagesTree;
Break;

{ Traseul modern (fluxuri de obiecte) }
if TryParseModernPDF then
begin
  Result := ModernPageCount;
  ReorderPageArrByPagesTree;
  Exit;
end;
Pasul de reordonare este O(n * m), unde n este numărul de Kids, iar m lungimea curentă a lui PageArr, dar pentru orice document cu arbore de pagini plat (toate frunzele la adâncimea 1, ceea ce acoperă covârșitoarea majoritate a PDF-urilor din lumea reală) ambele au aceeași valoare, iar costul este neglijabil. Arborii de pagini adânc imbricați cer o parcurgere recursivă, nu abordarea pe un singur nivel arătată aici; implementarea de producție tratează acel caz separat
Folosirea lui CopyPageFromDocument după remediere
Cu ReorderPageArrByPagesTree la locul lui, indicii logici de pagină funcționează cum vă așteptați. CopyPageFromDocument, de nivel mai înalt, primește un index logic numerotat de la 0 și copiază pagina corectă în documentul destinație:
var
  Source, Dest: THotPDF;
begin
  Source := THotPDF.Create(nil);
  Dest   := THotPDF.Create(nil);
  try
    Source.LoadFromFile('source.pdf');

    Dest.FileName := 'extracted.pdf';
    Dest.BeginDoc;

    { Copiază pagina logică 0 (prima pagină pe care o vede utilizatorul) }
    Dest.CopyPageFromDocument(Source, 0, 0);

    Dest.EndDoc;
  finally
    Source.Free;
    Dest.Free;
  end;
end;
CopyPageFromDocument interoghează intern ordinea din arborele de pagini, în loc să se bazeze pe indexul brut din PageArr, deci se comportă corect chiar și pe documente în care ordinea fizică și cea logică diverg. Pentru operații în lot, InsertPagesFromDocument acceptă un tablou de indici logici și îi copiază într-o singură trecere
Ce dezvăluie asta despre analiza PDF
Specificația PDF este explicită: ordinea logică a paginilor este definită de tabloul /Kids al arborelui de pagini, nu de numerele de obiecte sau de pozițiile în octeți (ISO 32000-1 §7.7.3.2). Orice analizor care folosește o altă ordonare drept scurtătură va produce rezultate corecte pe majoritatea documentelor pe care le vede, pentru că majoritatea generatoarelor scriu paginile în ordinea naturală și atribuie numere de obiecte secvențiale. Defectul se ascunde până când cineva încarcă un PDF editat incremental, reorganizat de altă unealtă sau generat de software care a ales altă dispunere
Testarea numai față de PDF-uri generate de dumneavoastră ratează complet această clasă de probleme. Remedierea unei regresii de ordonare a paginilor are, prin urmare, nevoie de un corpus de documente din surse variate: salvări incrementale, documente scanate cu coperți inserate, PDF-uri produse de unelte care liniarizează sau optimizează diferit graful de obiecte. Un document care a declanșat defectul original ar trebui să rămână permanent în suita de regresie
Pagina HotPDF Delphi Component acoperă întregul API pentru operațiile pe pagini, inclusiv CopyPageFromDocument, InsertPagesFromDocument și MovePage