Dicționarul Catalog dintr-un PDF are exact o cheie de navigare obligatorie: /Pages. Acea cheie trebuie să indice spre un obiect indirect de tip /Pages, care la rândul lui ține tabloul /Kids și numărul total /Count de pagini. Luați acel indicator și niciun cititor conform nu mai poate localiza vreo pagină din fișier. ISO 32000-1 §7.7.2 este neechivoc în această privință: Catalogul trebuie să aibă o intrare /Pages, iar obiectul referit trebuie să aibă tipul /Pages. Fișierele care încalcă această cerință nu sunt doar neconforme; sunt stricate structural într-un fel pe care majoritatea analizoarelor îl tratează prost
Ce spune de fapt specificația
Un PDF conform minimal are cel puțin trei obiecte. Obiectul 1 este Catalogul, obiectul 2 este rădăcina Pages, iar de la obiectul 3 în sus sunt dicționare Page individuale. Catalogul indică spre rădăcina Pages; rădăcina Pages își listează copiii în /Kids; fiecare Page poartă o referință înapoi prin /Parent. Întregul lanț este bidirecțional prin proiectare, deci un analizor poate porni din oricare capăt și poate ajunge la orice pagină în timp O(log n), pentru arbori echilibrați
% Structură conformă minimală (ISO 32000-1 §7.7.2)
1 0 obj
<< /Type /Catalog /Pages 2 0 R >>
endobj

2 0 obj
<< /Type /Pages /Kids [3 0 R 4 0 R] /Count 2 >>
endobj

3 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792] /Contents 5 0 R /Resources << >> >>
endobj

4 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792] /Contents 6 0 R /Resources << >> >>
endobj
Arborele Pages poate fi imbricat. Un document cu mii de pagini grupează de obicei paginile în obiecte-nod intermediare care poartă și ele tipul /Pages, fiecare cu propriul /Kids și cu un /Count care reflectă subarborele de sub el. /Count al nodului rădăcină este întotdeauna egal cu numărul total de pagini. Acel număr este ce afișează vizualizatoarele în câmpul cu numărul de pagini înainte să fi analizat vreo pagină, pentru că citirea unui întreg din obiectul 2 este mult mai ieftină decât parcurgerea întregului arbore
Cum arată un fișier fără Pages
Fișierele cărora le lipsește dicționarul Pages provin de obicei de la generatoare PDF care scriu obiectele de pagină direct, fără să le asambleze într-un arbore, sau dintr-o corupere care elimină nodul rădăcină lăsând intacte obiectele-frunză Page. Catalogul dintr-un astfel de fișier fie nu are deloc cheia /Pages, fie ține o referință către un obiect care nu mai există în tabelul de referințe încrucișate
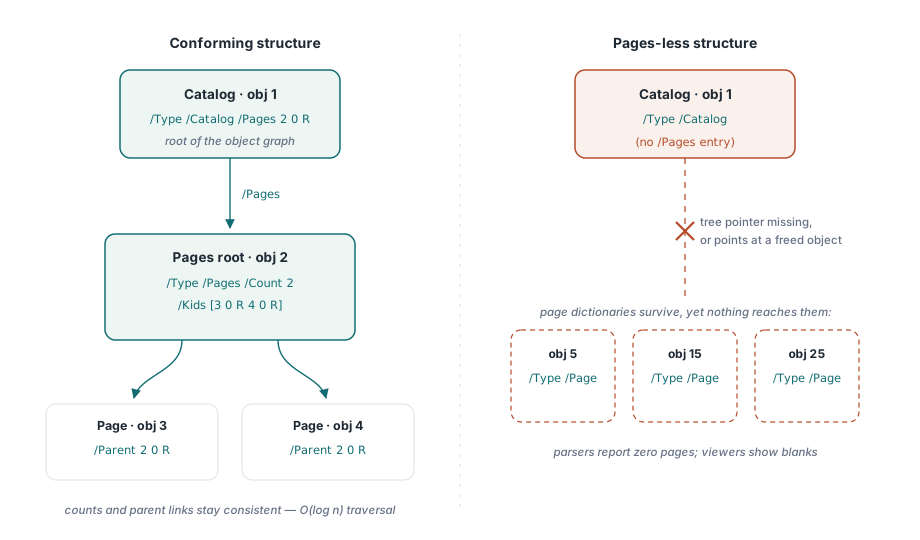
/Pages, în timp ce un fișier fără Pages abandonează obiecte de pagină intacte, fără nicio intrare navigabilă din Catalog% Neconform: Catalog fără referință /Pages
1 0 obj
<< /Type /Catalog >>
endobj
% Obiectele de pagină există, dar sunt inaccesibile din Catalog
5 0 obj
<< /Type /Page /MediaBox [0 0 612 792] /Contents 6 0 R /Resources << >> >>
endobj
15 0 obj
<< /Type /Page /MediaBox [0 0 612 792] /Contents 16 0 R /Resources << >> >>
endobj
25 0 obj
<< /Type /Page /MediaBox [0 0 612 792] /Contents 26 0 R /Resources << >> >>
endobjUn analizor care respectă specificația va citi Catalogul, va încerca să rezolve /Pages, nu va găsi nimic (sau o referință moartă) și fie va ridica o eroare, fie va raporta zero pagini. Ce nu trebuie să facă este să continue ca și cum fișierul ar avea zero pagini și să reușească în tăcere; asta produce o ieșire goală care pare corectă uneltelor automate și greșită oricărui om care o deschide
De ce cad analizoarele
Majoritatea analizoarelor PDF își alocă tabelul intern de pagini la încărcare, pe baza valorii /Count din rădăcina Pages. Când acea rădăcină lipsește, analizorul fie citește zero, nu alocă nimic și apoi dereferențiază un pointer nul prima dată când vreun cod cere pagina 1, fie citește gunoi și alocă un buffer complet greșit. Niciunul dintre rezultate nu este elegant. Violarea de acces la 0x008E5D78 care apare în jurnalele de cădere de la prelucrarea unui astfel de fișier este exact asta: o dereferențiere de pointer nul în traseul de acces la pagini, declanșată de absența structurii pe care analizorul a presupus că va exista mereu
Presupunerea de proiectare de la bază este rezonabilă. Covârșitoarea majoritate a PDF-urilor existente au un dicționar Pages. Analizoarele care sar peste verificarea de existență ca să economisească câteva instrucțiuni nu sunt nesăbuite; optimizează pentru cazul obișnuit. Fișierele care pedepsesc acea optimizare sunt destul de rare încât codul de producție s-ar putea să nu întâlnească vreunul până când chiar îl întâlnește, moment în care căderea este și reproductibilă, și derutantă, dacă inginerul nu a citit §7.7.2
Recuperare fără arbore Pages
Dacă un analizor trebuie să trateze aceste fișiere, nu să le respingă, recuperarea urmează un drum previzibil: scanați fiecare obiect indirect din tabelul de referințe încrucișate, adunați-le pe cele cu /Type /Page și sortați-le după numărul de obiect. Ordinea numerelor de obiect nu este garantată în specificație să corespundă ordinii de citire, dar în practică generatoarele care omit arborele Pages tind să emită paginile secvențial, deci ordinea după numărul de obiect este corectă mai des decât nu
Verificarea în sine este ieftină. Înainte de a parcurge indicatorul /Pages al Catalogului, confirmați că indicatorul există, că se rezolvă la un obiect real și că /Type al obiectului rezolvat este egal cu /Pages. Dacă oricare dintre aceste trei condiții cade, treceți la scanarea liniară. Scanarea este mai lentă decât parcurgerea arborelui pentru documente mari, pentru că citește antetul fiecărui obiect în loc să urmeze o cale echilibrată, dar funcționează, iar pentru un fișier deja malformat corectitudinea trece înaintea vitezei
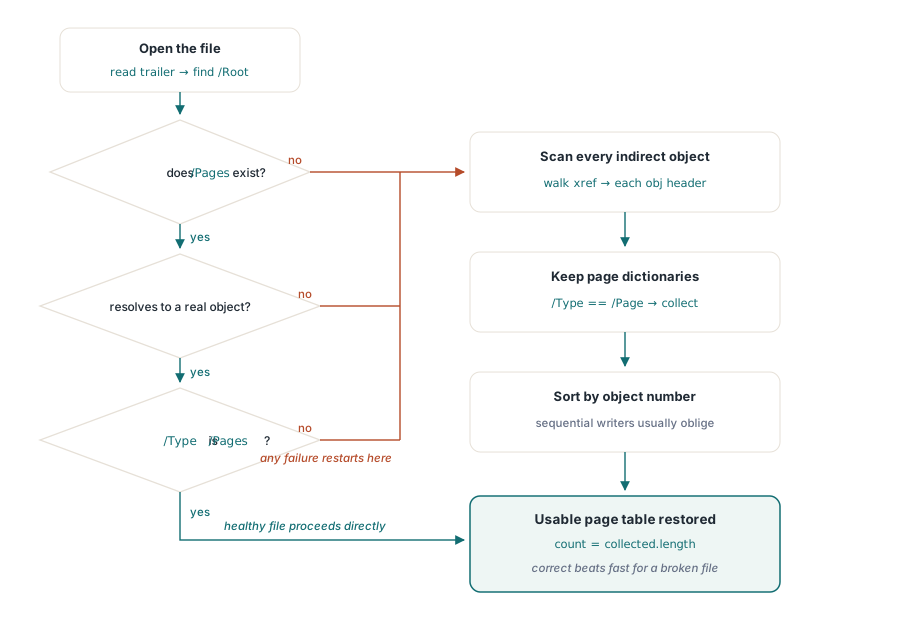
/Pages, iar orice eșec dirijează analizorul într-o scanare liniară care reconstruiește tabelul de pagini după numărul de obiectUn caz-limită pe care scanarea liniară nu îl rezolvă automat: ordinea paginilor. Fără un tablou /Kids care să definească secvența, ordinea „corectă” rămâne nedefinită de specificație. Ordinea după numărul de obiect este valoarea implicită pragmatică; dacă fișierul este destul de important încât să fie prelucrat cu grijă, merită efortul suplimentar de a verifica dacă obiectele Page poartă un /StructParents explicit sau referințe de adnotări care sugerează o secvență de citire
Implicații pentru generatoarele de PDF
Pentru oricine scrie un generator de PDF, nu un analizor, lecția este îngustă: emiteți întotdeauna rădăcina Pages înainte de a închide fișierul. Un Catalog fără intrarea /Pages nu este un PDF valid sub nicio revizie a specificației. Generatoarele care construiesc obiectele de pagină din mers și asamblează arborele la finalizare (abordarea folosită de majoritatea scriitorilor în flux) sunt în regulă atât timp cât finalizarea chiar rulează. Modul de eșec obișnuit este o excepție sau o revenire timpurie care întrerupe scrierea înainte ca trailerul să fie complet, lăsând în urmă un fișier care se deschide în unele vizualizatoare (care au euristici de recuperare) și eșuează în altele (care nu au)
PDF/A și PDF/UA impun constrângeri suplimentare asupra arborelui de pagini, dincolo de ce cere specificația de bază, dar niciunul nu relaxează cerința /Pages. Un validator care verifică conformitatea cu ISO 19005 sau ISO 14289 va prinde un dicționar Pages lipsă ca încălcare a specificației de bază, înainte să ajungă măcar la regulile specifice profilului