O objeto número 1 não é a página 1. Esse único fato derruba mais código de processamento de PDF do que qualquer outra parte do formato, e o motivo só aparece quando você para de olhar para o que um visualizador renderiza e passa a olhar para o grafo de objetos que o visualizador realmente lê
Um arquivo PDF é uma coleção de objetos indiretos numerados. Cada um carrega um número de objeto e um número de geração, e outros objetos apontam para ele com uma referência escrita como N G R — 3 0 R significa a versão atual do objeto 3. Páginas são objetos como qualquer outro, mas onde elas ficam no arquivo e quais números carregam não dizem nada sobre a ordem de exibição. A ordem vem da árvore /Pages. Varra os objetos em ordem numérica e você vai montar as páginas na sequência errada para uma boa fatia dos arquivos reais
A árvore também é onde mora muita coisa menos óbvia. A forma dela decide quão rápido um visualizador pode saltar para a página 8.214, os nós internos entregam discretamente tamanho de página e fontes para as folhas abaixo deles, e os totais /Count que tornam toda a estrutura rápida não são garantidos por absolutamente nada. Vamos passar pelos três, começando pela ordem em si
A árvore de páginas decide a ordem
Todo PDF tem um catálogo de documento (ISO 32000-2 §7.7.2), e a entrada /Pages do catálogo aponta para o nó raiz da árvore de páginas. Essa raiz é um dicionário com /Type /Pages, um array /Kids de referências indiretas e um /Count dando o número de páginas folha abaixo dele. A ordem de exibição é uma caminhada em profundidade, da esquerda para a direita, nessa árvore. Essa é a regra inteira
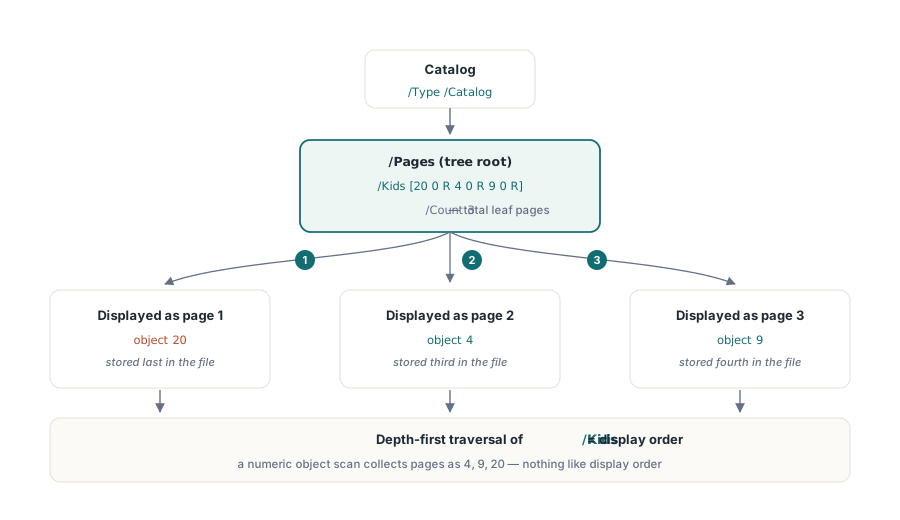
Um arquivo mínimo de três páginas torna isso concreto:
%PDF-1.7

1 0 obj
<< /Type /Catalog /Pages 2 0 R >>
endobj

2 0 obj
<< /Type /Pages /Kids [20 0 R  4 0 R  9 0 R] /Count 3 >>
endobj

% O objeto 4 é gravado terceiro no arquivo, mas é a página 2 na ordem de exibição
4 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 5 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% O objeto 9 é gravado quarto, mas é a página 3
9 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 10 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% O objeto 20 é gravado por último, mas é a página 1; o Kids[0] decide, não o número do objeto
20 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 21 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj
O array /Kids lê [20 0 R 4 0 R 9 0 R], então o objeto 20 é a página 1, o objeto 4 é a página 2 e o objeto 9 é a página 3. Código que itera objetos em ordem numérica e coleta tudo com /Type /Page erra esse arquivo. Pior: a saída ainda parece plausível — contagem de páginas certa, conteúdo reconhecível em cada página, sequência errada
Geradores produzem layouts assim por motivos comuns. Uma biblioteca que reserva os números de objeto de todas as páginas de antemão numera por ordem de criação e depois grava os bytes na ordem que servir ao seu serializador. Uma ferramenta de merge renumera os objetos de cada documento de origem para evitar colisões, então os objetos de página acabam espalhados pela tabela de objetos combinada enquanto o novo array /Kids da raiz guarda a sequência correta. E atualizações incrementais anexam objetos novos no fim do arquivo com números novos, então uma página adicionada em uma revisão vive perto do fim do fluxo de bytes mesmo quando pertence à posição 1
O último caso é o que morde. Um corpus de testes produzido por uma única ferramenta pode passar por completo, e então arquivos de um fluxo de merge, ou documentos que passaram por algumas revisões, saem embaralhados. Correções heurísticas não se sustentam, porque a falha depende do gerador e do histórico de edições do arquivo. O conserto de verdade é curto: comece no catálogo, resolva o /Pages, percorra o /Kids recursivamente e emita as folhas na ordem em que aparecem. Nosso estudo de caso de depuração de ordem de páginas segue exatamente esse sintoma por um diagnóstico errado até a causa raiz, com o código de travessia recursiva e passos qpdf para conferir o resultado
O fan-out é uma decisão de desempenho
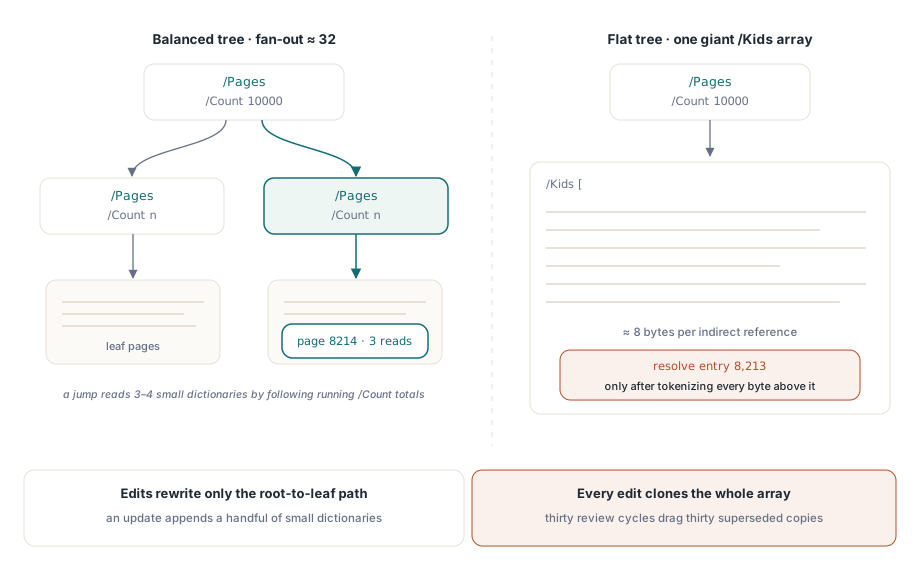
A especificação permite duas formas. Geradores simples emitem uma árvore plana, um único nó raiz /Pages cujo /Kids não guarda nada além de folhas /Page. Nada obriga um writer a aninhar, e um documento de 10.000 páginas com 10.000 referências de folha em um único array está em conformidade. A PDF Reference recomenda mesmo assim uma árvore balanceada para documentos grandes, e os geradores mainstream seguem esse conselho com um fan-out modesto — tipicamente algumas dezenas de filhos por nó intermediário, em que cada nó intermediário tem seu próprio /Kids e seu próprio /Count
O motivo é o que um visualizador precisa ler antes de poder mostrar qualquer coisa. Tome um salto direto para a página 8.214 daquele arquivo de 10.000 páginas. Com uma árvore plana o visualizador precisa interpretar a raiz primeiro, e a raiz é um array enorme: a oito bytes por referência indireta, aproximadamente, é um objeto de 80 KB que precisa ser tokenizado de ponta a ponta antes que a entrada 8.213 resolva. Com uma árvore balanceada de fan-out 32, o mesmo salto lê a raiz, compara totais /Count acumulados para escolher o filho certo e desce. Três ou quatro dicionários pequenos, algumas centenas de bytes cada. Esse acesso aleatório O(log n) é o que a árvore foi projetada para oferecer, e é toda a razão de o /Count existir em nós intermediários — um leitor pode pular uma subárvore inteira sem abrir um único objeto dentro dela
A forma da árvore também define o custo de edição. Uma atualização incremental que insere uma página precisa reescrever todo nó cujo /Kids ou /Count mudou, ou seja, o caminho do pai da nova folha até a raiz. Numa árvore balanceada esse caminho é um punhado de dicionários pequenos anexados ao arquivo. Numa árvore plana o "caminho" é o array gigante da raiz, duplicado por inteiro a cada revisão. Um contrato que passa por trinta ciclos de revisão e anotação pode acabar carregando trinta cópias superadas do mesmo array de 80 KB no fluxo de bytes dele
Para código de processamento, o aninhamento tem uma consequência mais direta. Você não pode assumir que o primeiro nível do /Kids contém páginas, então cada filho precisa ser checado: /Type /Pages significa recursar, /Type /Page significa folha. Código que para no primeiro nível funciona em todo arquivo plano que encontra, e então descarta silenciosamente subárvores inteiras na primeira vez que um gerador decide aninhar
Nós internos carregam atributos herdados
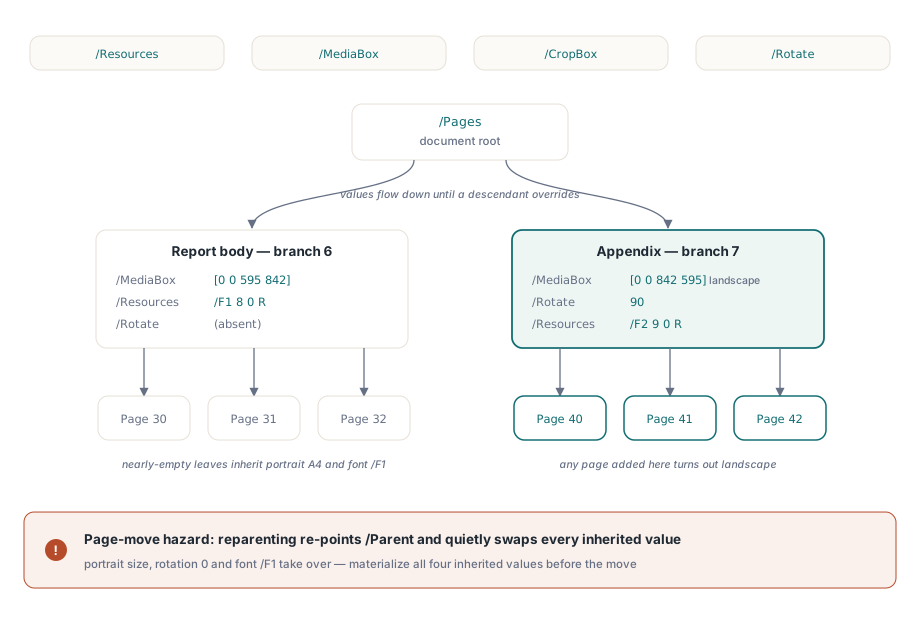
Nós intermediários fazem mais que encaminhar buscas. Quatro atributos de página são herdáveis (ISO 32000-2 §7.7.3.4): /Resources, /MediaBox, /CropBox e /Rotate. Qualquer deles pode ficar em um nó /Pages, onde se aplica a toda folha abaixo, a menos que um descendente o sobrescreva. Um writer que produz um relatório com um apêndice em paisagem pode expressar esse layout na própria árvore:
5 0 obj   % raiz do documento
<< /Type /Pages /Count 6 /Kids [6 0 R  7 0 R] >>
endobj

6 0 obj   % corpo do relatório: A4 retrato, fonte do corpo
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [30 0 R  31 0 R  32 0 R]
   /MediaBox [0 0 595 842]
   /Resources << /Font << /F1 8 0 R >> >> >>
endobj

7 0 obj   % apêndice: A4 paisagem, rotacionado, fonte própria
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [40 0 R  41 0 R  42 0 R]
   /MediaBox [0 0 842 595] /Rotate 90
   /Resources << /Font << /F2 9 0 R >> >> >>
endobj

40 0 obj  % página do apêndice: herda tamanho, rotação e fontes
<< /Type /Page /Parent 7 0 R /Contents 43 0 R >>
endobj
Os objetos 40 a 42 são quase vazios. Tamanho de página, rotação e recursos de fonte chegam todos do nó 7, o que mantém o arquivo compacto e autogerenciável: adicione uma quarta página sob o nó do apêndice e ela sai em paisagem sem ninguém tocar em nada
Também significa que as propriedades de uma página não estão todas na página. O objeto 40 não tem chave /MediaBox nenhuma, e isso é perfeitamente legal — um leitor que trata a chave ausente como entrada malformada vai rejeitar arquivos válidos. A busca precisa subir a cadeia de /Parent até achar a entrada ou chegar à raiz. Essa caminhada precisa de uma proteção contra ciclos. Um arquivo corrompido pode carregar uma referência /Parent apontando de volta para um nó já visitado, e sem um conjunto de objetos visitados a busca gira para sempre
O mesmo mecanismo cria o clássico risco de mover páginas. Diga que uma ferramenta move o objeto 40 para o corpo do relatório editando os dois arrays /Kids e reapontando o /Parent para o nó 6. O movimento é estruturalmente válido, mas o objeto 40 agora herda o /MediaBox em retrato, rotação nenhuma e a fonte /F1 — enquanto o content stream dele ainda seleciona /F2, que não resolve mais. A página encolhe, desgira e perde o texto em uma única edição. Código de reordenação que se sustenta grava os valores resolvidos dos quatro atributos herdáveis no dicionário da página antes de reparentá-la. Se você já arrastou uma página em um editor e a viu mudar de tamanho ou orientação, esse é o mecanismo que você viu
Achatar: legal, comum, ocasionalmente caro
Muitas ferramentas vão para o outro lado. Writers mínimos emitem uma árvore de um nível porque é simples, e muitos utilitários de merge e split reconstroem qualquer árvore que leem em um único array /Kids plano, já que saída balanceada é trabalho extra e saída plana sempre está em conformidade. Uma reconstrução correta precisa resolver a herança ao mesmo tempo. Todo atributo que uma folha herdava precisa ser copiado para a folha, ou içado para a nova raiz se é uniforme no documento inteiro; pule esse passo e a saída muda de geometria exatamente como no caso da página movida
Para documentos típicos, achatar é inofensivo. Ele machuca na escala, das duas formas já descritas: o array da raiz vira um objeto grande que toda abertura e todo salto de página interpreta por inteiro, e toda edição estrutural o reescreve completo. O que achatar não destrói é o compartilhamento por referências indiretas. Uma árvore plana em que todas as 10.000 páginas apontam para o mesmo objeto de dicionário /Resources continua deduplicada — a única coisa perdida é a opção de deixar a entrada de fora da página e deixar um ancestral fornecê-la
Quando o /Count mente
O /Count é pura contabilidade. Ele precisa ser igual ao número de páginas folha na subárvore do nó, e nada no formato de arquivo garante isso. Dois padrões de corrupção respondem pela maioria das contagens mentirosas vistas na natureza
O primeiro é a contagem velha deixada para trás por uma atualização incremental. Um editor insere uma página, reescreve o pai imediato com um /Kids novo e um /Count atualizado, anexa os dois ao arquivo — e nunca toca nos ancestrais:
% Revisão original
12 0 obj
<< /Type /Pages /Count 9 /Kids [13 0 R  14 0 R  15 0 R] >>
endobj

14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 3
   /Kids [50 0 R  51 0 R  52 0 R] >>
endobj

% Revisão acrescentada: uma página inserida no ramo do meio
% O objeto 14 é superado; o objeto 12 nunca é reescrito
14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 4
   /Kids [50 0 R  51 0 R  90 0 R  52 0 R] >>
endobj
A árvore agora tem dez folhas, mas a raiz ainda diz nove. Um visualizador que confia na raiz mostra nove no contador de páginas dele. Um que usa contagens internas para busca binária de um salto de página calcula o índice errado para toda página depois do ponto de inserção. Uma travessia completa acha dez. Três respostas diferentes, um arquivo
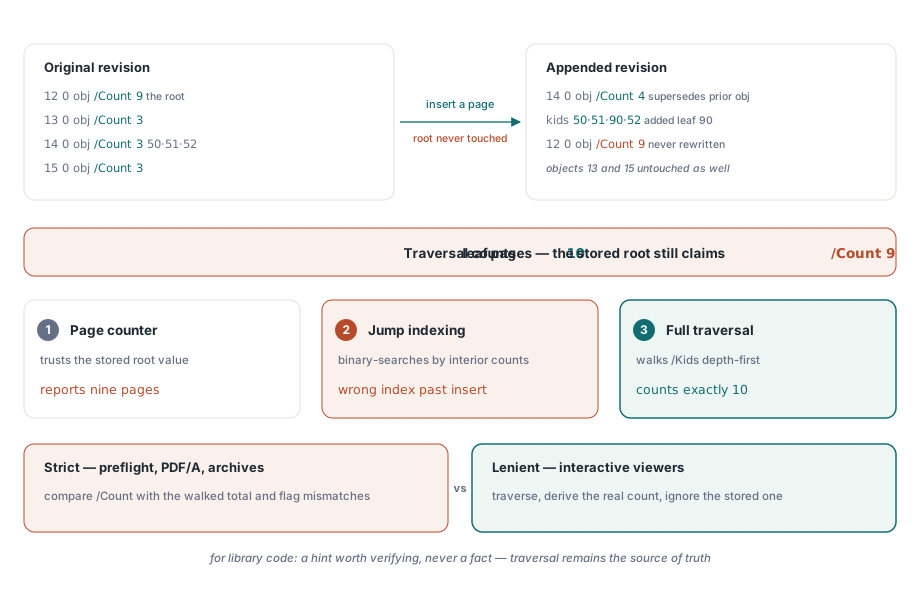
Há um jeito mais silencioso de ser mordido pelo mesmo arquivo. Código que lê a contagem da raiz, começa a percorrer a árvore e para quando coletou aquela quantidade de páginas nunca verá a página dez. Sem exceção, sem aviso, só um documento que está uma página abaixo. Usar o /Count como limite de laço ou checagem de limites é o erro; a caminhada precisa rodar até a árvore se esgotar, diga o que disser o número armazenado
O segundo padrão é a contagem que nunca poderia estar certa: negativa, zero em um nó populado, ou absurdamente enorme. Elas vêm de fuzzing, de dano de transmissão e ocasionalmente de bugs de aritmética em editores. São perigosas especificamente para código que confia no /Count para alocação. Dimensionar um array a partir de um /Count de -3 levanta um erro de intervalo quando muito, e fazê-lo a partir de um /Count de dois bilhões é uma alocação de negação de serviço. Trate o valor como entrada não confiável, como todo outro número no arquivo
Os parsers se dividem em dois campos nesse tema. Consumidores estritos — ferramentas de preflight, validadores PDF/A, pipelines de arquivamento — comparam o /Count com o resultado da travessia e rejeitam ou sinalizam o arquivo. Visualizadores interativos são quase universalmente tolerantes: percorrem, derivam a contagem real e ignoram silenciosamente a armazenada, que é exatamente por que um arquivo com contagem velha pode circular por anos sem reclamação até encontrar um parser mais estrito dentro de algum fluxo automatizado. Para código de biblioteca, achamos que o meio-termo é o padrão certo. Use o /Count como dica para pré-alocação, e para pular subárvores depois de verificado, e deixe a travessia permanecer a fonte da verdade
Em produção essas falhas raramente se anunciam como problemas de árvore. Aparecem como páginas embaralhadas, uma página faltando no fim de um merge, ou uma página que muda de tamanho ou orientação depois de uma reordenação. O estudo de caso de depuração rastreia um relatório assim de volta pela árvore. Para a anatomia do arquivo em volta (objetos, dados de referência cruzada, trailers), a visão geral da estrutura de arquivos PDF é o ponto de partida
O HotPDF Delphi Component trata de tudo isso internamente: percorre árvores aninhadas de qualquer profundidade, resolve atributos herdados quando páginas são copiadas ou movidas, e confere o /Count contra a contagem real de folhas em vez de confiar nele, então índices de página na API dele sempre significam páginas lógicas