O sintoma clássico parece um off-by-one: uma rotina de cópia de páginas pede a página 1 de um documento de três páginas e recebe consistentemente a página 2. A lógica de indexação passa na verificação. A chamada usa um índice lógico de base zero, a aritmética está correta, as condições de contorno estão certas. Ainda assim a página errada sai toda vez
A causa não está no código de cópia. Está em como o loader constrói o array de páginas, e é uma das armadilhas mais fáceis de cair na análise de PDF
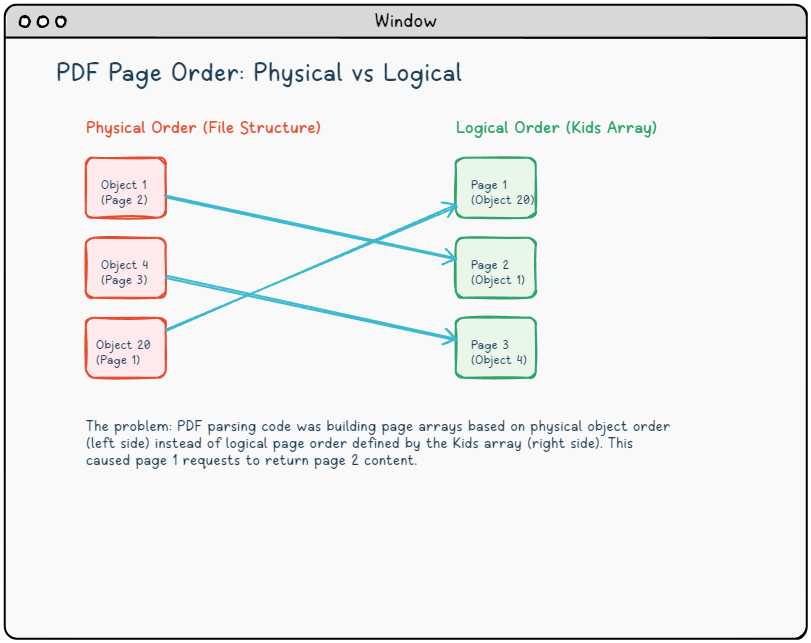
Duas ordenações, uma fonte de confusão
Um arquivo PDF é uma coleção de objetos indiretos, cada um identificado por um número de objeto. A estrutura do arquivo não impõe nenhuma obrigação de esses números refletirem a ordem de leitura. O objeto 1 pode guardar a página 2; o objeto 20 pode guardar a página 1. O que de fato define a ordem de leitura é a árvore de páginas: uma hierarquia de dicionários /Pages cujos arrays /Kids listam referências de páginas na sequência que um visualizador deve exibi-las (ISO 32000-1 §7.7.3)
Aqui está uma árvore de páginas que expõe a armadilha:
{ raiz da árvore Pages, objeto 16 }
16 0 obj
<<
  /Type /Pages
  /Count 3
  /Kids [20 0 R   { logical page 1 }
         1 0 R    { logical page 2 }
         4 0 R]   { logical page 3 }
>>
endobj
O arquivo por acaso listava o objeto 1 e o objeto 4 antes do objeto 20 no fluxo de bytes. Qualquer parser que iterasse pelos objetos indiretos na ordem do arquivo e os estampasse em um PageArr à medida que encontrasse dicionários do tipo página acabaria com o objeto 1 no índice 0, o objeto 4 no índice 1 e o objeto 20 no índice 2. A página lógica 1 fica em PageArr[2]. Pedir o índice de página 0 busca a página lógica 2 no lugar
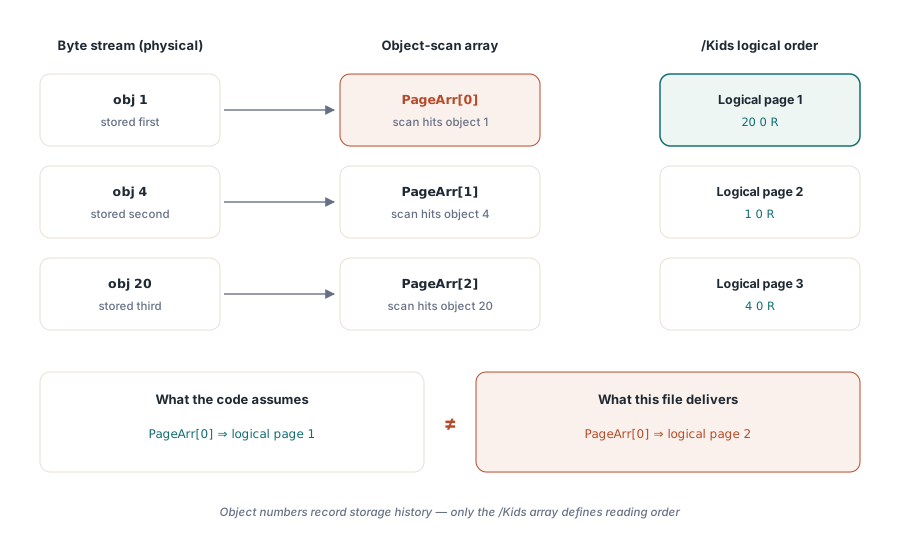
Confirmando a hipótese
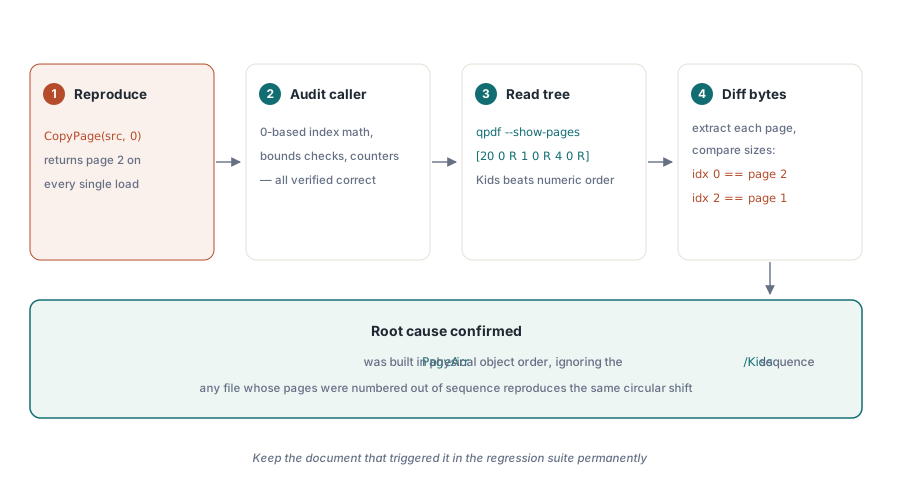
Antes de mudar qualquer código, prove a incompatibilidade em vez de assumi-la. A ferramenta de linha de comando qpdf torna isso direto:
{ shell }
qpdf --show-pages input.pdf
{ A saída revela a ordem de Kids: 20 0 R, depois 1 0 R, depois 4 0 R }

qpdf --show-object="16 0 R" input.pdf
{ Mostra o dicionário Pages com /Kids na ordem de leitura }
Extrair cada página individualmente e comparar os tamanhos dos arquivos confirma o mapeamento: o que o PageArr[0] de uma varredura de objetos produz é o conteúdo pertencente à página lógica 2, e o PageArr[2] guarda a página lógica 1. A rotação circular é a prova do crime. Isso também explica por que o sintoma aparece em muitos documentos-fonte diferentes: qualquer PDF em que os objetos de página por acaso tenham números de objeto menores que o de uma página lógica anterior dispara o problema
Há um motivo direto para os PDFs acabarem nesse estado. Uma atualização incremental mantém os números de objeto dos objetos que altera, mas tudo o que ela adiciona — uma página de capa inserida no início, por exemplo — recebe um número novo acima de tudo que já existe no arquivo, enquanto sua referência vai para o início do array Kids. Ferramentas que mesclam ou reorganizam documentos renumeram objetos na ordem que lhes convier. Alguns geradores simplesmente escrevem as páginas em uma ordem conveniente para o streaming de conteúdo em vez da sequência lógica de páginas. O formato PDF não exige que nenhum deles faça diferente
A abordagem correta: seguir o array Kids
Construa a lista de páginas percorrendo a cadeia /Kids a partir da raiz do catálogo, não varrendo objetos indiretos. A caminhada precisa recursar, porque um documento grande geralmente divide as páginas dele entre nós /Pages intermediários, e deve se proteger contra uma árvore malformada que aponte de volta para um dos próprios ancestrais. No esboço abaixo, TPdfDict e TPdfArray representam os tipos de dicionário e array que o seu parser usar:
type
  TPageList = array of TPdfDict;

procedure CollectPages(Node: TPdfDict; var Pages: TPageList;
  Depth: Integer = 0);
var
  Kids: TPdfArray;
  Child: TPdfDict;
  I: Integer;
begin
  if Depth > 64 then  // um ciclo ou uma árvore patologicamente profunda
    raise EPdfError.Create('Page tree too deep or cyclic');
  Kids := Node.GetArray('Kids');
  if Kids = nil then
    Exit;
  for I := 0 to Kids.Count - 1 do
  begin
    Child := Kids.ResolveDict(I);  // segue a referência indireta
    if Child = nil then
      Continue;
    if Child.GetName('Type') = 'Pages' then
      CollectPages(Child, Pages, Depth + 1)  // nó intermediário
    else
    begin
      SetLength(Pages, Length(Pages) + 1);   // folha: próxima página na ordem de exibição
      Pages[High(Pages)] := Child;
    end;
  end;
end;

// Uso: comece pela entrada /Pages do catálogo
SetLength(Pages, 0);
CollectPages(Catalog.ResolveDict('Pages'), Pages);
if Length(Pages) <> Catalog.ResolveDict('Pages').GetInteger('Count') then
  LogWarning('Page tree /Count disagrees with the pages actually found');
Dois detalhes são deliberados. Uma folha sem entrada /Type ainda é tratada como página, porque alguns escritores a omitem e os visualizadores abrem esses arquivos mesmo assim. E a comparação final com o /Count não custa nada, mas captura árvores truncadas ou editadas à mão antes que um chamador indexe nelas
Se você carrega documentos com o HotPDF, essa ordenação já está resolvida quando o documento carrega: os índices de página seguem a ordem de exibição da árvore de páginas, nós /Pages aninhados incluídos, então o índice 0 é sempre a primeira página que um visualizador mostra. A caminhada acima importa quando o seu próprio código analisa a estrutura do PDF diretamente
Copiando por índice lógico com CopyPageFromDocument
Como o HotPDF resolve a ordem das páginas no carregamento, índices lógicos de página significam o que os chamadores esperam. O CopyPageFromDocument de nível mais alto recebe um índice lógico de base zero e copia a página correta para o documento de destino:
var
  Source, Dest: THotPDF;
begin
  Source := THotPDF.Create(nil);
  Dest   := THotPDF.Create(nil);
  try
    Source.LoadFromFile('source.pdf');

    Dest.FileName := 'extracted.pdf';
    Dest.BeginDoc;

    { Copia a página lógica 0 (a primeira que o usuário vê) }
    Dest.CopyPageFromDocument(Source, 0, 0);

    Dest.EndDoc;
  finally
    Source.Free;
    Dest.Free;
  end;
end;
Como o índice é um índice de ordem de exibição, o CopyPageFromDocument se comporta corretamente até contra documentos em que a ordem física e a lógica divergem. Para operações em lote, o InsertPagesFromDocument aceita um array de índices lógicos e os copia em uma passada
O que isso revela sobre a análise de PDF
A especificação do PDF é explícita: a ordem lógica das páginas é definida pelo array /Kids da árvore de páginas, não por números de objeto ou offsets de bytes (ISO 32000-1 §7.7.3.2). Qualquer parser que use uma ordenação diferente como atalho produzirá resultados corretos na maioria dos documentos que ver, porque a maioria dos geradores escreve as páginas na ordem natural e atribui números de objeto sequenciais. O erro se esconde até alguém carregar um PDF que foi editado incrementalmente, reorganizado por outra ferramenta, ou gerado por um software que escolheu um layout diferente
Testar apenas contra PDFs gerados por você mesmo perde essa classe de problema por completo. O tratamento da ordem de páginas precisa de um corpus de teste com documentos de fontes variadas: salvamentos incrementais, documentos escaneados com páginas de capa inseridas, PDFs produzidos por ferramentas que linearizam ou otimizam o grafo de objetos de forma diferente. Qualquer documento cuja ordem física e lógica divergem merece um lugar permanente nesse corpus
A página do Componente HotPDF cobre a API completa para operações de página, incluindo CopyPageFromDocument, InsertPagesFromDocument e MovePage