Um PDF cortado no meio de um download pode se recusar a abrir mesmo quando quase todas as páginas chegaram, mas um manual de 2.000 páginas salta para a página 1.500 instantaneamente. Os dois comportamentos decorrem da estrutura de arquivo do PDF, como o HotPDF Delphi Component a escreve: um cabeçalho, um corpo de objetos numerados, uma tabela de referência cruzada (xref) de offsets de bytes e um trailer, os dois últimos armazenados no final
A ISO 32000-2 §7.5.1 descreve a mesma anatomia de quatro partes para todo PDF, de um recibo de uma página a um acervo escaneado. As partes sempre ficam na mesma ordem descendo o arquivo, e se conectam numa cadeia fixa: o trailer nomeia o catálogo e diz onde a tabela xref começa, a tabela xref diz onde cada objeto começa, e os objetos apontam uns para os outros por número. Os trechos abaixo vêm de um arquivo Hello World de 610 bytes cujos offsets foram conferidos byte a byte; o arquivo completo, anotado palavra-chave por palavra-chave, está em como um PDF é por dentro, e o que um visualizador faz com essas partes a caminho dos pixels está em como um PDF funciona quando um leitor o abre
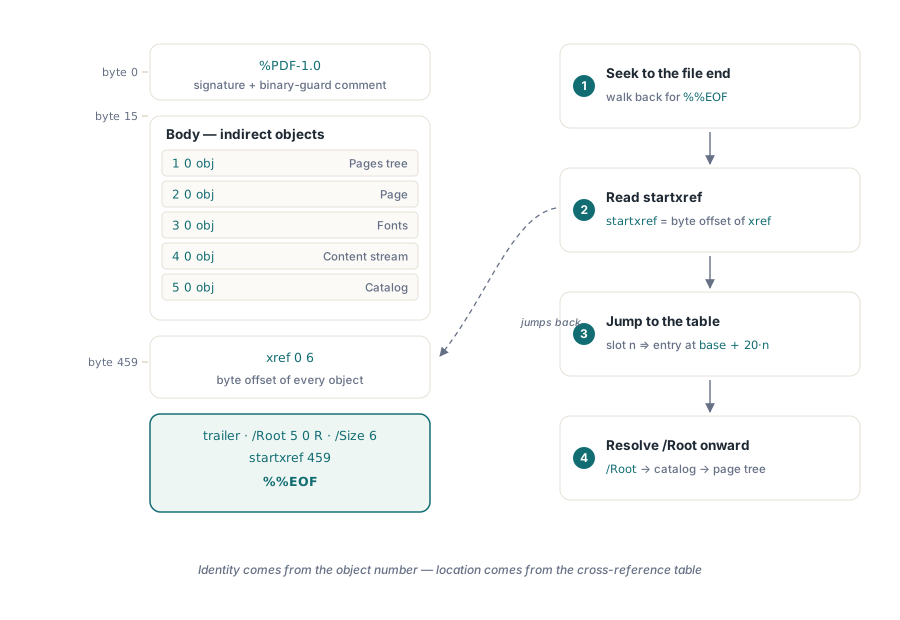
O cabeçalho do PDF tem duas linhas, e a segunda importa
A primeira linha, como %PDF-1.7, é um comentário no que a sintaxe concerne, mas os leitores a tratam como a assinatura do arquivo e extraem a versão dela; o tratamento de versão é flexível na prática, então trate o número como uma dica de quais recursos esperar. A segunda linha é a que as pessoas excluem por acidente e depois passam uma tarde depurando. A carga útil dela é de pelo menos quatro bytes acima do ASCII 127 (ISO 32000-1 §7.5.2), lá para que qualquer coisa que mova o arquivo em modo texto o reconheça como binário e pare de reescrever fins de linha. Streams comprimidos contêm bytes que batem com um carriage return ou um line feed por coincidência; reescreva-os e o comprimento do stream registrado no dicionário deixa de bater com os bytes no disco. Todo escritor sério ainda emite o comentário porque a falha que ele previne é silenciosa e total
O corpo: objetos numerados e os oito tipos de objeto do PDF
O corpo é uma sequência plana de objetos indiretos, cada um empacotado como N G obj ... endobj com um número de objeto e um número de geração. O que transforma essa lista plana na estrutura interna do PDF é o token de referência N G R: 2 0 R significa "objeto 2, geração 0, onde quer que ele more no arquivo". Qualquer valor também pode ser escrito no lugar como um objeto direto. No trecho, o dicionário /Resources da página é direto, enquanto a fonte que ele nomeia é indireta, então cem páginas podem compartilhar o objeto 4 em vez de carregar cem cópias:
1 0 obj
<< /Type /Catalog /Pages 2 0 R >>          % o catálogo aponta para a árvore de páginas
endobj
...
3 0 obj
<< /Type /Page
   /Parent 2 0 R
   /MediaBox [0 0 612 792]
   /Resources << /Font << /F1 4 0 R >> >>   % dicionário direto, fonte indireta
   /Contents 5 0 R
>>
endobj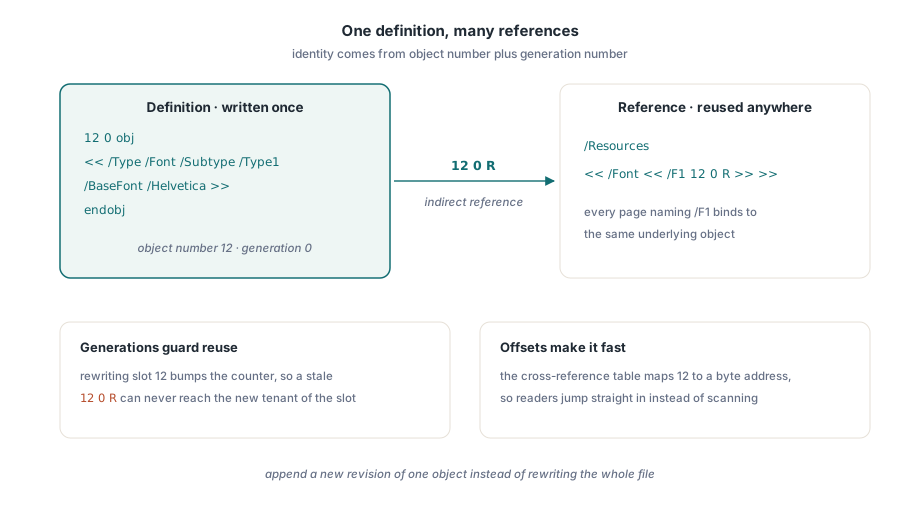
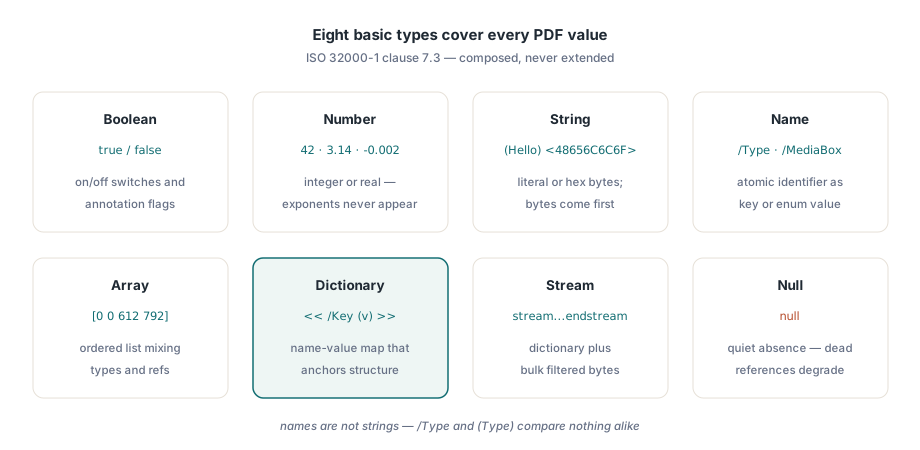
A ISO 32000-1 §7.3 mantém o vocabulário curto: todo valor em um PDF é um de oito tipos básicos. Booleans e números são os escalares, e o PDF não tem notação exponencial, então 1e6 nunca aparece num arquivo em conformidade. Strings guardam bytes, escritos como (Hello, World!) ou em hex como <48656C6C6F>. Names como /Type ou /Helvetica são comparados byte a byte, então escrever (Helvetica) onde o /BaseFont espera um name é um erro de tipo mesmo com os caracteres batendo. Arrays guardam qualquer coisa em ordem, como o MediaBox. Dictionaries mapeiam names para valores e carregam a maior parte da estrutura. Um stream é um dictionary mais bytes brutos, lar do conteúdo de página, das fontes e das imagens. O oitavo tipo é null, e uma referência a um objeto que não existe resolve para ele em vez de levantar um erro, o que deixa um arquivo danificado se degradar em vez de falhar por completo
O número de geração existe para a reutilização. Quando uma edição deleta um objeto, o número dele vai para a free list, e se uma edição posterior reutilizar o número, a geração sobe um, então um 12 0 R obsoleto não pode resolver silenciosamente para o novo 12 1 obj. Quase todo objeto que você encontrar está na geração 0. A resolução começa no catálogo, objeto 1 no trecho, cuja entrada /Pages leva à árvore de páginas; nós internos reúnem páginas em /Kids, mantêm um /Count e podem passar atributos como /MediaBox para os descendentes deles. Por que essa árvore, e não a ordem física dos objetos, decide a ordem das páginas está coberto em árvores de páginas do PDF e a ordem das páginas
Como a tabela xref localiza um objeto?
A tabela xref transforma um número de objeto em um offset de bytes por aritmética, que é como um manual de 2.000 páginas abre na página 1.500 sem parsear as páginas anteriores. A ISO 32000-1 §7.5.4 fixa toda entrada em exatamente vinte bytes: um offset de dez dígitos contado do início do arquivo, um espaço, uma geração de cinco dígitos, um espaço, uma letra de tipo e um fim de linha de dois bytes, que com LF é um espaço mais o line feed. Como as linhas são uniformes, um leitor indexa direto para a linha do objeto n. A linha 0 6 é um cabeçalho de subseção, e a entrada 0 é sempre livre com geração 65535, encabeçando a lista ligada de números de objetos livres. Todo outro offset precisa aterrissar no primeiro dígito do header N G obj correspondente, como no arquivo de 610 bytes:
xref
0 6                  % 6 entradas, começando no objeto 0
0000000000 65535 f   % entrada 0: cabeça da free list
0000000019 00000 n   % o objeto 1 (catálogo) começa no byte 19
0000000068 00000 n   % o objeto 2 (árvore de páginas) começa no byte 68
0000000125 00000 n   % o objeto 3 (página) começa no byte 125
0000000263 00000 n   % o objeto 4 (fonte) começa no byte 263
0000000333 00000 n   % o objeto 5 (content stream) começa no byte 333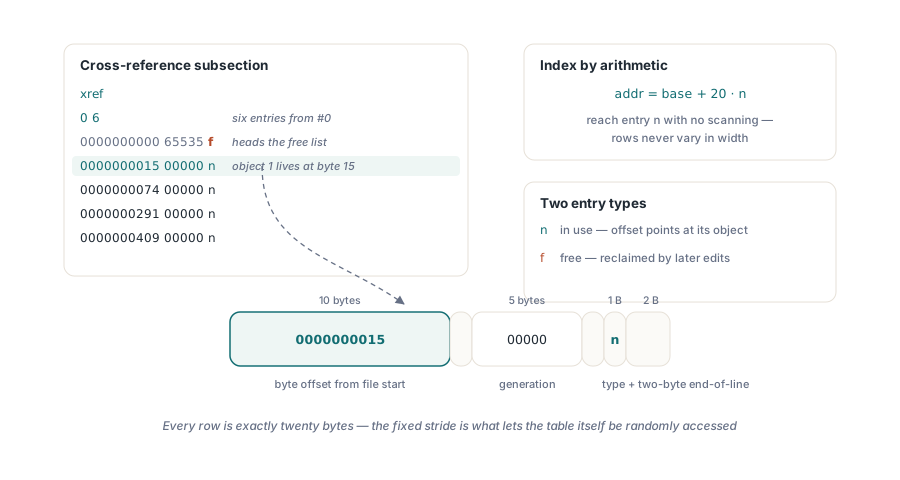
Por que um PDF truncado falha ao abrir?
Um PDF truncado falha porque as duas partes que amarram tudo, a tabela xref e o trailer, são os últimos bytes escritos. O dicionário de trailer carrega /Root, o catálogo, e /Size, o número de entradas xref, um a mais que o maior número de objeto porque o slot zero guarda a entrada livre. Abaixo dele, o startxref dá o offset em bytes da palavra-chave xref e o %%EOF fecha o arquivo:
trailer
<< /Size 6 /Root 1 0 R >>   % contagem de entradas, catálogo do documento
startxref
427                          % offset em bytes da palavra-chave xref
%%EOF
Perca os últimos poucos centenas de bytes e o arquivo tem objetos mas nenhum mapa para eles. Leitores estritos param aí; tolerantes varrem o arquivo inteiro por headers N G obj e reconstruem a tabela, o caminho lento que a xref existe para evitar, e um mapa reconstruído ainda pode perder objetos ou pegar a cópia errada de um editado. Uma transferência em modo texto faz um dano mais silencioso, porque reescrever fins de linha desloca todo objeto. Nós convertemos o arquivo de 610 bytes para fins de linha CRLF e rodamos o qpdf --check (qpdf 12.3.2): ele reportou "file is damaged" e "xref not found" no offset 427, e reconstruiu a tabela varrendo antes de conferir qualquer coisa
Tabela xref clássica ou cross-reference stream?
Desde o PDF 1.5, a xref também pode ser um cross-reference stream (ISO 32000-1 §7.5.8): um objeto indireto de /Type /XRef cujas linhas binárias substituem a tabela de texto e cujo dicionário de stream absorve as entradas do trailer, então a palavra-chave trailer desaparece e o startxref aponta para aquele objeto. Os tipos de linha viram números (0 livre, 1 em um offset de bytes, 2 dentro de um object stream), o /W dá a largura em bytes de cada coluna, e o HotPDF comprime as linhas com Flate e o predictor PNG Up. O HotPDF escreve a forma de stream quando o Version é pdf15 ou posterior, então o exemplo o define explicitamente, e o UseObjectStreams se apoia na mesma chave. Nós deixamos o UseXRefStream desligado para arquivos que precisam abrir em ferramentas da era do PDF 1.4, que não conseguem parsear um xref stream de forma alguma, e o ligamos para documentos grandes onde um índice compacto compensa. Só a cauda do arquivo muda:
uses
  System.SysUtils, HPDFDoc;

procedure SaveWithXRef(const FileName: string; AsStream: Boolean);
var
  PDF: THotPDF;
begin
  PDF := THotPDF.Create(nil);
  try
    PDF.AutoLaunch := False;
    PDF.FileName := FileName;
    PDF.Version := pdf17;            // xref streams precisam de PDF 1.5 ou posterior
    PDF.UseXRefStream := AsStream;   // default False: tabela de texto mais trailer
    PDF.BeginDoc;
    PDF.CurrentPage.TextOut(72, 72, 0, 'Same page, different index');
    PDF.EndDoc;
  finally
    PDF.Free;
  end;
end;

// SaveWithXRef('table.pdf', False);
//   Cauda esperada: xref, 0 N, linhas de vinte bytes,
//   trailer << /Size /Root /Info /ID >>, startxref, %%EOF
// SaveWithXRef('stream.pdf', True);
//   Cauda esperada: N 0 obj << /Type /XRef /Size /Root /Info /ID /W ...
//   /Filter /FlateDecode >> stream ... endstream endobj, startxref, %%EOF
Atualizações incrementais anexam um segundo xref em vez de reescrever
Um PDF pode ser editado sem tocar em nenhum byte já no disco. Objetos alterados e novos são anexados, seguidos de uma seção xref que lista só eles e de um trailer cuja entrada /Prev guarda o offset da tabela anterior. Um leitor segue o startxref até a seção mais nova, caminha pela cadeia /Prev para trás, e deixa a entrada mais nova de cada número de objeto ganhar. A edição abaixo adiciona uma anotação de nota ao arquivo de 610 bytes: o objeto de página 3 é reescrito com um array /Annots sob o mesmo número, e o objeto 6 é novo. Com os comentários removidos e fins de linha LF os offsets são exatos, e o qpdf --check passou no resultado sem erros:
% ... 610 bytes originais, inalterados ...
3 0 obj                          % substitui a página 3, mesmo número de objeto
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792] /Resources << /Font << /F1 4 0 R >> >> /Contents 5 0 R /Annots [6 0 R] >>
endobj
6 0 obj                          % a nova anotação
<< /Type /Annot /Subtype /Text /Rect [72 650 92 670] /Contents (Checked) >>
endobj
xref                             % duas subseções de uma entrada
3 1
0000000610 00000 n
6 1
0000000752 00000 n
trailer
<< /Size 7 /Root 1 0 R /Prev 427 >>
startxref
843
%%EOF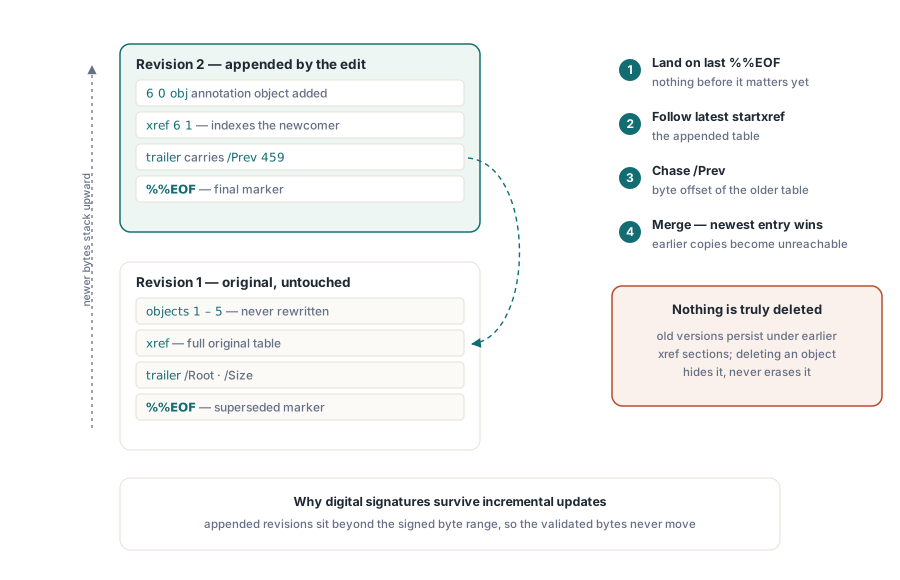
Anexar é o que mantém PDFs assinados verificáveis: uma assinatura cobre uma faixa de bytes, e uma atualização incremental nunca move esses bytes. É também por isso que um PDF carrega histórico recuperável, já que a antiga página 3 ainda está no byte 125, inalcançável mas presente. Arquivos revisados muitas vezes crescem uma longa cadeia /Prev; qpdf revised.pdf flat.pdf re-serializa os objetos alcançáveis sob uma única xref e descarta as revisões antigas, o que no arquivo acima deixou uma tabela xref e nenhum /Prev, ao preço de qualquer assinatura sobre os bytes originais. No HotPDF, uma revisão incremental fica assim:
procedure ReviseInPlace(const Original, Revised: string);
var
  PDF: THotPDF;
begin
  PDF := THotPDF.Create(nil);
  try
    PDF.AutoLaunch := False;
    PDF.BeginIncrementalUpdate(Original);   // mantém os bytes originais ao pé da letra
    PDF.SetLoadedTitle('Quarterly report, revised');
    PDF.SetLoadedAuthor('Finance');
    PDF.SaveIncrementalUpdate(Revised);      // objetos alterados, xref novo, trailer /Prev
  finally
    PDF.Free;
  end;
end;
O layout de quatro partes também dá uma ordem de triagem rápida para um PDF que se comporta mal: confira que o arquivo termina em %%EOF com um startxref plausível, confirme que um ou dois offsets xref aterrissam num header N G obj, e depois siga o /Root para dentro do catálogo e da árvore de páginas. O HotPDF Delphi Component para Delphi e C++Builder escreve tabelas xref clássicas ou cross-reference streams a pedido e anexa revisões incrementais que deixam os bytes anteriores, e as assinaturas sobre eles, intactos