Um timeout de reconhecimento de 5.000 ms numa chamada Tesseract in-process não significa que a chamada volta depois de cinco segundos. Com um conjunto grande de models multi-idioma, a thread chamadora pode ficar dentro da library nativa bem além dessa marca, porque o progress monitor que força o deadline é consultado enquanto palavras estão sendo reconhecidas, e o carregamento de models e a análise de layout da página acontecem antes da primeira consulta. Esse vão, um cancel callback cujo tipo C de retorno é um único byte, e um iterator que entrega memória que você nunca deve liberar são o trabalho real de binding da C API do Tesseract para Delphi. O resto é encanamento
Ligando a DLL Tesseract numa camada de texto do HotPDF
O HotPDF expõe o caminho in-process como HPDFCreateTesseractDLLOCREngine na unit HPDFTesseractRecognition. A factory carrega uma DLL Tesseract que exporta a C API, dirige TessBaseAPIInit2, TessBaseAPIRecognize e o result iterator, e retorna uma IHPDFOCREngine. O THotPDF.ApplyLoadedOCRTextLayer recebe essa engine e adiciona uma camada de texto Unicode invisível e pesquisável às páginas escaneadas, a mesma chamada por que toda engine OCR do HotPDF passa
A factory valida cedo. O arquivo da DLL e o diretório tessdata têm de existir. O identificador de idioma pode conter só letras ASCII, dígitos, _ e +, e todo model numa combinação como chi_sim+eng precisa de um arquivo .traineddata correspondente. Todos os 21 exports requeridos têm de resolver antes de você receber uma engine de volta. Erros de configuração levantam EArgumentException, com export ou model faltante reportado pelo nome; uma DLL que não carrega levanta EOSError levando o código de erro do Windows e uma dica para checar arquitetura e dependências
uses
  SysUtils, HPDFDoc, HPDFTesseractRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // Uma aplicação Win64 precisa de uma DLL de 64 bits; o nome de arquivo depende do seu build,
  // e as DLLs de dependência dele vão na mesma pasta
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract.dll',
    'C:\OCR\tessdata', 'chi_sim+eng');   // usa THPDFTesseractOptions.Default
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;   // 300 DPI, MinimumConfidence 0.5
    // Lista de páginas vazia significa todas as páginas; páginas que já têm texto são puladas
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' words accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
O THPDFTesseractOptions.Default define PageSegMode para tpsAuto, EngineMode para temDefault, TimeoutMilliseconds para 60.000 e MaxPixels para 16.777.216. Esse budget de pixels morde mais cedo do que se espera. Uma página US Letter no default de 300 DPI renderiza para 2.550 × 3.300 pixels, cerca de 8,4 milhões, e cabe. Suponha que você suba a mesma página para 600 DPI: ela vira 5.100 × 6.600, aproximadamente 33,7 milhões de pixels, e a engine rejeita com Invalid Tesseract DLL OCR request or pixel budget antes de o Tesseract ver a imagem. Ou você sobe o MaxPixels (o teto é 67.108.864) ou fica em 300 DPI, que é farto para corpo de texto; cada lado também é limitado a 32.767 pixels
A DLL é carregada com LoadLibraryEx e as flags de busca para a própria pasta da DLL mais os default safe directories. As image libraries das quais o Tesseract depende podem então ficar ao lado dele, e você nunca precisa tocar no PATH nem confiar no diretório corrente. O HotPDF não embute nem baixa uma runtime OCR ou qualquer language model; você provisiona os dois
O que o caminho da DLL muda comparado com o tesseract.exe
O mesmo recognizer também é alcançável através do adapter tesseract.exe externo que escreve um BMP e parseia TSV. Os dois adapters alimentam um mesmo pipeline de camada de texto, então mapeamento de coordenadas, filtragem de confidence e o commit all-or-nothing se comportam igual. O que difere é como os pixels entram, como as palavras saem, e o que acontece quando o recognizer se porta mal
| Aspecto | Adapter tesseract.exe | Adapter DLL Tesseract |
|---|---|---|
| Factory | HPDFCreateTesseractOCREngine | HPDFCreateTesseractDLLOCREngine |
| Pixels entrando | Arquivo BMP num diretório temporário privado | Buffer grayscale 8-bit na memória |
| Palavras saindo | TSV por palavra, limitado a 64 MiB | Result iterator, UTF-8 por palavra |
| Baselines | Não estão no TSV; o pipeline as estima | Passthrough de TessPageIteratorBaseline |
| Page segmentation e engine mode | Overload de THPDFTesseractOptions, enviado como --psm e --oem | THPDFTesseractOptions, enviado ao TessBaseAPISetPageSegMode e ao TessBaseAPIInit2 |
| Budget de pixels | MaxPixels quando options são passadas | MaxPixels sempre, mais 32.767 pixels por lado |
| Timeout | Duro: o processo filho é terminado | Cooperativo: o Tesseract tem de notar |
| Isolamento de crash e memória | Processo separado | Nenhum, compartilha o seu address space |
Um custo fica com a DLL. Cada chamada Recognize cria a própria instância de API e roda TessBaseAPIInit2, então os language models são inicializados a cada página. O file cache tira o peso do reload, mas com um conjunto grande de models multi-idioma isso continua sendo o maior custo fixo por página, e é cobrado do deadline de reconhecimento. A engine DLL RapidOCR in-process faz a escolha oposta e mantém os models ONNX residentes por toda a vida da engine, enquanto os problemas de fronteira (C ABI, buffers emprestados, trabalho nativo que você não pode interromper) pertencem à mesma família
Então qual entra em produção? Para uma ferramenta desktop ou um job em lote trabalhando por algumas centenas de scans, a DLL é o melhor encaixe: sem lançamento de processo por página, sem bitmap temporário em disco, e baselines reais para linhas inclinadas. Um server de longa duração que aceita PDFs de estranhos deve ficar no tesseract.exe, porque um crash nativo ou uma alocação fugida ali derruba um processo filho em vez do seu serviço
Por que o Delphi não pode copiar a struct de monitor do Tesseract?
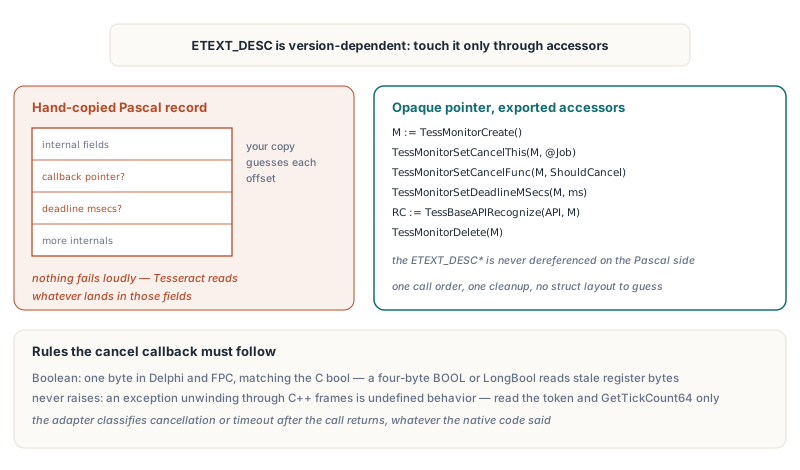
O Delphi não pode espelhar com segurança o progress monitor do Tesseract, porque o ETEXT_DESC carrega campos internos que variam entre builds do Tesseract. Um record traduzido à mão de um header põe o cancel callback e o deadline nos offsets que aquele header usava. Rode contra um build diferente e o Tesseract lê o seu callback pointer de um campo que agora significa outra coisa, ou nunca encontra o deadline, e o reconhecimento simplesmente roda até o fim
O adapter do HotPDF por isso trata o monitor como um pointer opaco e o toca só através de funções exportadas: TessMonitorCreate, TessMonitorSetCancelThis, TessMonitorSetCancelFunc, TessMonitorSetDeadlineMSecs e TessMonitorDelete. O esboço abaixo é código de binding seu, não API do HotPDF; as declarações dele casam com as que o adapter resolve com GetProcAddress
type
  // C: typedef bool (*TessCancelFunc)(void *cancel_this, int words);
  TTessCancelFunc = function(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
  TTessMonitorCreate = function: Pointer; cdecl;   // ETEXT_DESC*, nunca desreferenciado
  TTessMonitorDelete = procedure(Monitor: Pointer); cdecl;
  TTessMonitorSetCancelFunc = procedure(Monitor: Pointer; Func: TTessCancelFunc); cdecl;
  TTessMonitorSetCancelThis = procedure(Monitor, CancelThis: Pointer); cdecl;
  TTessMonitorSetDeadlineMSecs = procedure(Monitor: Pointer; MSecs: Integer); cdecl;
  TTessBaseAPIRecognize = function(Handle, Monitor: Pointer): Integer; cdecl;

  // Estado do seu job, não é um tipo do HotPDF
  TOCRJob = record
    CancelRequested: Boolean;
    DeadlineTick: UInt64;
  end;
  POCRJob = ^TOCRJob;

function ShouldCancel(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
begin
  // Roda na stack do Tesseract: leia uma flag e o relógio, nunca levante exceção
  Result := (CancelThis = nil) or POCRJob(CancelThis)^.CancelRequested or
    (GetTickCount64 >= POCRJob(CancelThis)^.DeadlineTick);
end;

// Uso, com os function pointers resolvidos por GetProcAddress:
//   Monitor := MonitorCreate();
//   try
//     MonitorSetCancelThis(Monitor, @Job);
//     MonitorSetCancelFunc(Monitor, ShouldCancel);
//     MonitorSetDeadlineMSecs(Monitor, RemainingMs);
//     RC := BaseAPIRecognize(API, Monitor);
//   finally
//     MonitorDelete(Monitor);
//   end;
O esboço tipa o callback como Boolean, um byte tanto no Delphi quanto no Free Pascal, o que casa com o bool C do TessCancelFunc. O BOOL Windows de quatro bytes e o LongBool do Delphi parecem intercambiáveis e são um tipo diferente: quando um lado escreve um único byte e o outro lê quatro, os três bytes superiores são o que quer que o register segurasse antes, e um false pode chegar como true. O TessPageIteratorBoundingBox retorna um int, declarado como Integer do lado Pascal, então leia o tipo C de cada valor de retorno em vez de assumir uma regra para a API inteira
O callback também nunca levanta exceção. Uma exceção Delphi fazendo unwinding pelos frames C++ do Tesseract é undefined behavior. O callback do HotPDF lê só o cancellation token e um valor monotônico de GetTickCount64, e o adapter transforma o resultado num diagnóstico de cancelamento ou timeout depois de o TessBaseAPIRecognize retornar. Ele roda essa checagem quer o código de retorno nativo fosse 0 ou não
Quais pointers nativos o lado Delphi possui?
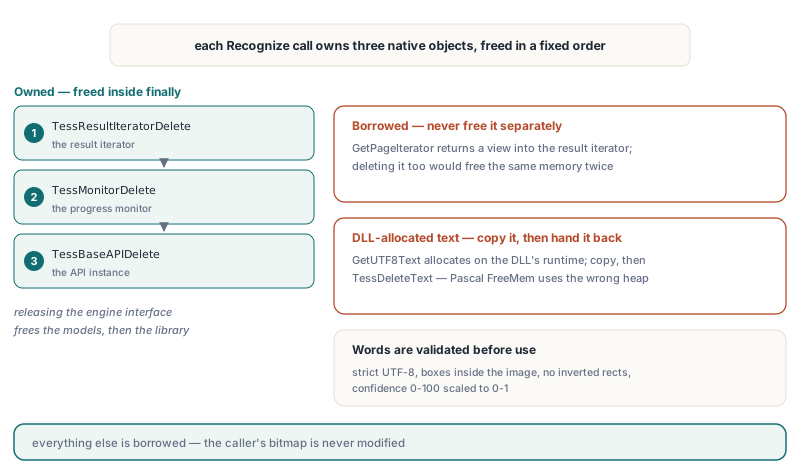
O adapter DLL Tesseract do HotPDF possui três objetos nativos por request (a instância de API, o monitor e o result iterator) e toma emprestado todo o resto. Cada chamada Recognize cria o próprio conjunto e o libera num bloco finally numa ordem fixa: TessResultIteratorDelete, depois TessMonitorDelete, depois TessBaseAPIDelete. Liberar a interface da engine chama FreeLibrary na DLL
- O
TessResultIteratorGetPageIteratorretorna uma vista para dentro do result iterator em vez de um objeto novo. O adapter o usa paraTessPageIteratorBoundingBoxeTessPageIteratorBaselinee nunca o libera; apagá-lo também liberaria a mesma memória duas vezes - O
TessResultIteratorGetUTF8Textretorna uma string alocada pela própria runtime da DLL. O adapter a decodifica e devolve viaTessDeleteTextnum blocofinally, porqueFreeMemPascal a liberaria no heap errado - O texto de palavra passa por decodificação UTF-8 estrita com checagem de comprimento antes. Uma palavra com caracteres de controle, UTF-8 malformado, uma box fora da imagem, um retângulo invertido ou uma confidence fora de 0–100 falha o request; o adapter não remenda
- O texto por request é limitado a 1.048.576 code units UTF-16, e a contagem de palavras tem de caber no budget que o
ApplyLoadedOCRTextLayerrepassa com cada página
A confidence chega como 0–100 e é escalada para 0–1, então o THPDFOCRTextLayerOptions.MinimumConfidence significa a mesma coisa para toda engine. Quando o Tesseract reporta uma baseline, os dois endpoints passam direto, e para uma palavra predominantemente vertical a largura da box é usada como altura do texto. Sem baseline o pipeline da camada de texto cai na estimativa geométrica dele, exatamente como faz para input TSV
Checando faixas de enum options antes de elas chegarem à DLL
A factory copia os bytes crus de PageSegMode e EngineMode para um Integer antes de checar as faixas. Um compilador está no direito de assumir que uma variável enum sempre segura um valor declarado, então um teste como Ord(X) > Ord(High(T)) escrito direto contra o enum pode ser dobrado para uma constante false. Esses ordinais chegam à DLL como inteiros crus: o THPDFTesseractPageSegMode segue a numeração de page segmentation do Tesseract de 0 a 13 e o THPDFTesseractEngineMode a numeração de engine mode de 0 a 3. Um record de options limpo com FillChar, lido de um stream, ou preenchido do C++Builder através de um cast para inteiro pode carregar um byte como 200, e validar a cópia transforma isso num EArgumentException na hora da factory. A factory também rejeita tpsOSDOnly e tpsAutoOnly, que não retornam palavras, e exige osd.traineddata para tpsAutoOSD e tpsSparseTextOSD
O que o timeout de reconhecimento realmente garante?
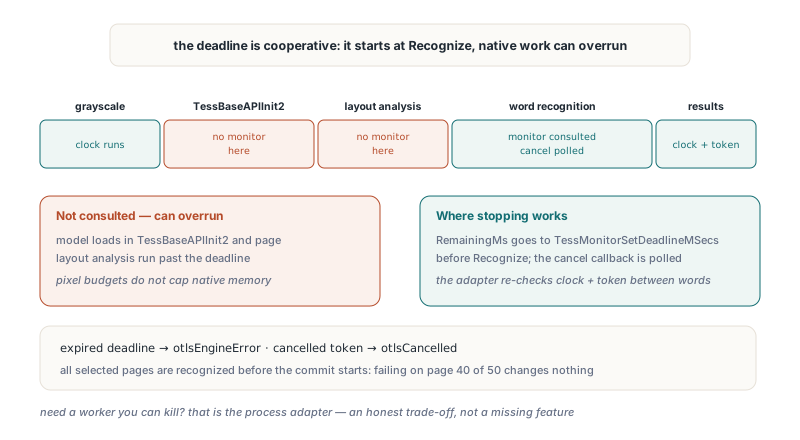
O timeout da DLL Tesseract é cooperativo: o HotPDF pode parar o próprio trabalho e pedir ao Tesseract que pare, mas não pode forçar código nativo a retornar. O relógio começa quando o Recognize começa, então a conversão grayscale e a inicialização de models bebem do mesmo budget que o reconhecimento. O adapter confere tempo decorrido e o cancellation token a cada 64 linhas durante a conversão grayscale, depois da inicialização, e antes de cada palavra enquanto caminha pelos resultados. Logo antes do TessBaseAPIRecognize ele passa os milissegundos restantes ao TessMonitorSetDeadlineMSecs
O vão mora dentro das chamadas nativas. O Tesseract consulta o monitor dele só durante o reconhecimento de palavras, então dentro do TessBaseAPIInit2 ou da análise de layout um carregamento lento de model ou um layout patológico pode passar do deadline antes de o timeout ser reportado. Os budgets de pixel e output também não limitam o uso de memória da própria library nativa. Quando você precisa de um worker que pode ser morto de uma vez, o adapter de processo é a ferramenta
Page segmentation é onde o adapter da DLL compensa em input esquisito. Formulários, etiquetas e tabelas escaneadas com campos espalhados costumam reconhecer melhor com tpsSparseText do que com segmentação automática, que tenta montar colunas e parágrafos que não estão lá. O timeout abaixo é curto para uma página de formulário e ainda assim tem de cobrir a inicialização de models
procedure OCRFormPages(Doc: THotPDF; const Pages: array of Integer);
var
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  LayerOptions: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default;
  TessOptions.PageSegMode := tpsSparseText;  // campos espalhados, sem montagem de colunas
  TessOptions.EngineMode := temLSTMOnly;     // precisa de models LSTM no tessdata
  TessOptions.TimeoutMilliseconds := 20000;  // inclui inicialização de models
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract.dll',
    'C:\OCR\tessdata', 'eng+deu', TessOptions);

  LayerOptions := THPDFOCRTextLayerOptions.Default;
  LayerOptions.MinimumConfidence := 0.6;
  if not Doc.ApplyLoadedOCRTextLayer(Pages, Engine, LayerOptions, Info) then
    case Info.Status of
      otlsCancelled:
        Writeln('OCR cancelled, document unchanged');
      otlsEngineError:
        if Pos('timed out', string(Info.Diagnostic)) > 0 then
          Writeln('Tesseract timed out, document unchanged')
        else
          Writeln('Tesseract failed: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
Um timeout aparece como otlsEngineError com Tesseract DLL OCR timed out no diagnóstico. Um token definido via THPDFOCRTextLayerOptions.CancellationToken aparece como otlsCancelled. Nos dois casos o ApplyLoadedOCRTextLayer reconhece todas as páginas selecionadas antes de começar o commit, então uma falha na página 40 de 50 deixa o documento carregado exatamente como estava. tpsSingleLine, tpsSingleBlock e tpsSparseText mudam só a segmentação; nenhum deles endireita um scan inclinado
Free Pascal e Lazarus: pixels velhos e chinês perdido
Ambas as factories Tesseract funcionam em builds Win32 e Win64 de Free Pascal e Lazarus no Windows depois de o pacote Lazarus ser rebuildado para a arquitetura alvo; o port geral é coberto em HotPDF em Free Pascal e Lazarus Win64. O tratamento de input é onde o FPC se comporta diferente
Um TBitmap LCL escrito via scanlines pode atualizar a raw image dele sem atualizar o handle do bitmap Windows, então GetDIBits nesse handle devolve os pixels velhos. O sintoma desconcerta: texto desenhado direto num bitmap é reconhecido, uma página renderizada via scanlines não produz palavras. No FPC o adapter da DLL lê um snapshot consciente de formato via CreateIntfImage, que respeita o pixel format e a ordem de linhas da raw image. O build Delphi mantém o caminho GetDIBits numa cópia privada de 24 bits, e nenhum dos builds modifica o bitmap do caller
O adapter tesseract.exe encontra um problema diferente. O TStringList do FPC armazena strings ANSI, então atribuir texto TSV UTF-8 decodificado a Lines.Text descarta todo caractere chinês ou de plano suplementar que a página de código ANSI do sistema não represente. O caminho FPC mantém o TSV como bytes UTF-8, remove o BOM a nível de byte e decodifica cada palavra para UnicodeString por conta própria. O adapter da DLL nunca encontra o problema, já que decodifica cada palavra direto do iterator
O adapter DLL Tesseract vem junto dos adapters de processo e da engine OCR integrada no HotPDF para Delphi, C++Builder e Free Pascal. Edições e downloads estão listados na página do HotPDF Delphi PDF component