O TerminateThread parece a forma óbvia de parar uma chamada OCR que ficou triturando uma página escaneada por mais tempo do que a sua UI está disposta a esperar. A documentação do Windows explica por que não é: se a thread alvo segura o lock do heap do processo, esse lock nunca é liberado, e a próxima alocação em qualquer outra thread pode bloquear para sempre. Quando o OCR roda dentro do seu próprio processo, a única parada segura é cooperativa, em checkpoints entre estágios de inferência, e esse é o preço de carregar os models ONNX uma vez e mantê-los quentes
A alternativa que a maioria dos times Delphi tenta primeiro é um processo filho. Um worker Python por página pode ser morto a qualquer momento, o que é atraente, mas cada chamada inicia um interpretador, importa a runtime dele, e carrega models de detecção e reconhecimento antes de ler um pixel. Imagine um job de arquivo com 500 páginas: esse trabalho de start-up roda 500 vezes, e o deploy agora inclui um ambiente Python sentado ao lado de um executável nativo
PDF pesquisável a partir de scans com HPDFCreateRapidOCRDLLOCREngine
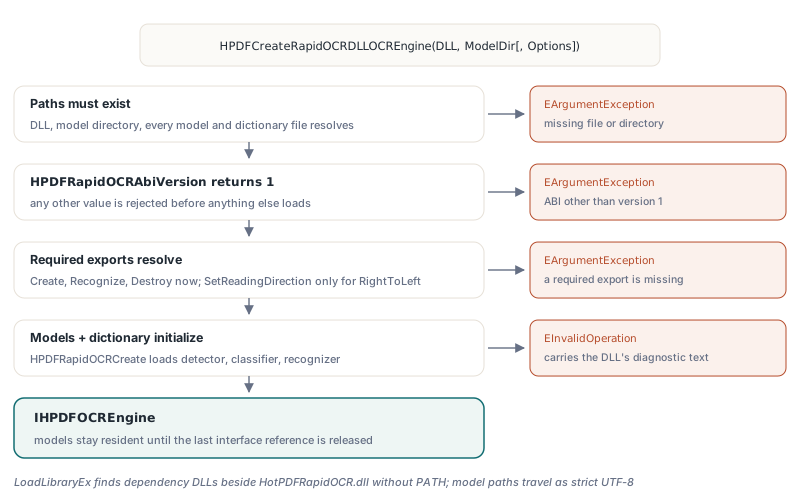
O HotPDF roda RapidOCR in-process através do HPDFCreateRapidOCRDLLOCREngine, declarado na unit HPDFRapidOCRRecognition. A factory carrega a HotPDFRapidOCR.dll, inicializa os models de detecção ONNX, classificação de ângulo opcional e reconhecimento uma vez, e retorna uma IHPDFOCREngine. Essa engine entra no THotPDF.ApplyLoadedOCRTextLayer exatamente como as outras engines OCR: o documento renderiza cada página, a DLL roda inferência de CPU nela, e o resultado é efetivado como uma camada de texto Unicode invisível. Sem Python, sem processo filho. O adapter vem para builds Delphi, C++Builder e FPC/Lazarus no Windows
A validação acontece na factory, antes de qualquer página ser tocada. Todo model e todo arquivo de dictionary têm de resolver, o HPDFRapidOCRAbiVersion tem de retornar 1, e os exports requeridos têm de existir antes de o HPDFRapidOCRCreate construir os models. Erros de configuração levantam EArgumentException; um model que se recusa a carregar levanta EInvalidOperation com o diagnóstico da própria DLL, como um dictionary que não casa com o recognition model
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // Os models carregam aqui, fora de qualquer deadline de reconhecimento.
  // Nomes relativos no THPDFRapidOCRDLLOptions.Default resolvem
  // contra o model directory
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models');
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;  // 300 DPI, MinimumConfidence 0.5
    // lista de páginas vazia = todas as páginas; SkipPagesWithText é True por default
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
O THPDFRapidOCRDLLOptions.Default nomeia ch_PP-OCRv3_det_infer.onnx, ch_PP-OCRv3_rec_infer.onnx, ch_ppocr_mobile_v2.0_cls_infer.onnx e ppocr_keys_v1.txt, com uma thread de CPU, um limite de input de 16.777.216 pixels, e um deadline de 60.000 ms por chamada de reconhecimento. Para outros scripts, o THPDFRapidOCRDLLOptions.ForLanguage mantém esses defaults e troca para <profile>/recognition.onnx mais <profile>/dictionary.txt de um de nove perfis, do chinês tradicional e cirílico até árabe e devanagari. Cada engine lê um idioma; escolha o perfil por página ou por documento. Por que model e dictionary sempre viajam como um par é coberto em models multilíngues RapidOCR e CTC dictionaries no HotPDF
A engine se reporta como RapidOCR (native DLL) no Info.EngineName. Logue essa string. Quando o mesmo serviço também roda o adapter de processo OCR Tesseract externo ou a engine OCR de template matching integrada, essa é a forma mais rápida de dizer qual recognizer produziu uma página ruim
Por que a C ABI só fala int32_t e bytes UTF-8?
A fronteira da HotPDFRapidOCR.dll usa inteiros de largura fixa, pointers crus, e comprimentos de byte explícitos porque Delphi, C++Builder e Free Pascal não compartilham nada com o MSVC além da convenção de chamada C. Um std::string, um std::vector ou uma exceção C++ carrega um layout de memória e um modelo de unwinding que pertencem a um compilador e a uma runtime library, e deixar qualquer um deles cruzar para código Pascal termina em stack corrompida ou um bloco de heap liberado pelo allocator errado
A ABI versão 1 é uma lista curta de regras. Todo export é cdecl e retorna um status int32_t: 1 para sucesso, 0 para falha. Toda função que pode falhar recebe um buffer de diagnóstico de propriedade do caller e o tamanho dele em bytes, e a DLL escreve uma mensagem UTF-8 terminada em NUL truncada para caber. Dentro da DLL, cada corpo de export fica num try com catch (const std::exception &) e catch (...). Um erro do ONNX Runtime, uma asserção do OpenCV ou um dictionary malformado vira status 0 mais texto
| Export | Função | Quando o adapter resolve |
|---|---|---|
HPDFRapidOCRAbiVersion | Retorna 1; qualquer outro valor é rejeitado | Logo depois de a DLL carregar |
HPDFRapidOCRCreate | Carrega os models de detecção, classificação opcional e reconhecimento, e o dictionary | Na factory |
HPDFRapidOCRRecognize | Roda um bitmap e emite um callback por linha de texto | Na factory |
HPDFRapidOCRDestroy | Libera a instância de models | Na factory |
HPDFRapidOCRSetReadingDirection | Ordem de linha opcional da direita para a esquerda | Só quando o RightToLeft está definido |
O export de direção de leitura é resolvido lazily de propósito, então uma DLL buildada sem ele ainda serve todo request da esquerda para a direita. O adapter carrega a library com LoadLibraryEx e flags de busca que cobrem a própria pasta da DLL mais os default safe directories; dependências do ONNX Runtime ou do OpenCV colocadas ao lado da HotPDFRapidOCR.dll são encontradas sem editar o PATH. Paths de model e dictionary cruzam a fronteira como UTF-8, e a DLL os converte com MultiByteToWideChar em modo estrito antes de abrir arquivos via APIs wide-character. Um model directory sob C:\Users\Łukasz ou um nome de usuário cirílico abre normalmente
Uma regra mora nos arquivos de build em vez do header. A DLL linka ONNX Runtime e OpenCV estaticamente, e o projeto CMake usa por default a CRT release estática (/MT). Misture static libraries compiladas contra /MD e você ganha link errors se tiver sorte, e dois heaps independentes se não tiver. Provisione libraries buildadas para o mesmo modo de CRT da DLL
O que acontece entre um TBitmap e uma linha de texto?
O HotPDF entrega à DLL uma cópia BGR top-down independente da página renderizada, e a DLL devolve um callback por linha reconhecida. O texto nesse callback é emprestado: o pointer é válido só até o callback retornar, então o adapter copia na hora
No Delphi o snapshot vem de um TBitmap privado forçado a pf24bit e lido com GetDIBits usando um biHeight negativo. Isso dá linhas top-down com padding para alinhamento de quatro bytes, e o stride viaja para a DLL como argumento explícito. No FPC o adapter lê via CreateIntfImage. O bitmap do caller nunca é modificado. Checagens de tamanho rodam antes de a cópia ser alocada: no máximo 32.767 pixels por lado, e não mais que MaxPixels no total, que tem default 16.777.216 e pode subir para 67.108.864
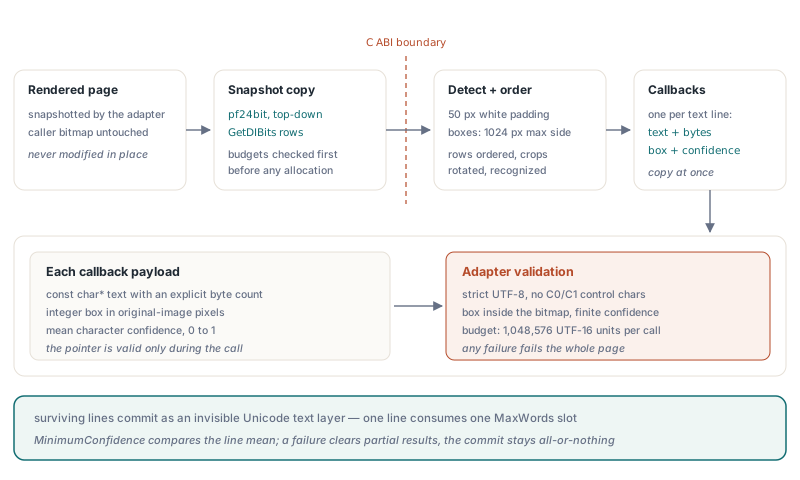
Dentro da DLL a imagem ganha uma borda branca de 50 pixels, as regiões de texto são detectadas com o lado maior escalado a no máximo 1.024 pixels, e as boxes são ordenadas em linhas horizontais. Com o angle classifier habilitado, um crop é girado 180 graus só quando o score de cabeça para baixo excede 0.9, o que impede uma previsão fraca de virar palavras curtas de cabeça para baixo. Cada linha chega então como um const char*, uma contagem de bytes, uma box inteira em pixels da imagem original, e a confidence média de caractere. O adapter é estrito quanto ao que aceita:
- UTF-8 é decodificado com
MB_ERR_INVALID_CHARS, então uma sequência de bytes malformada falha a página em vez de plantar caracteres de substituição numa camada pesquisável - Caracteres de controle C0 e C1 são rejeitados; linhas só com whitespace são puladas
- A box precisa estar dentro do bitmap, e a confidence precisa ser um valor finito de 0 a 1
- O texto conta contra o
MaxTextCodeUnitsdo request, com teto rígido de 1.048.576 unidades UTF-16 por chamada; caracteres fora do Basic Multilingual Plane custam duas unidades - Uma exceção Pascal dentro do callback é capturada ali, armazenada, e transformada em retorno 0, o que faz a DLL parar; a mensagem armazenada vira o
Info.Diagnostic
Dois desses detalhes importam quando você ajusta o output. A unidade é uma linha, não uma palavra: cada linha ocupa um slot de MaxWords, o Info.AcceptedWordCount e o Info.DroppedWordCount contam linhas, e um hit de busca destaca a box da linha inteira. E o MinimumConfidence é comparado contra a confidence média de caractere da linha, então um caractere borrado entre vinte limpos raramente afunda a linha. Subir o threshold para 0.7 ou 0.8 descarta linhas inteiras, nunca caracteres únicos. Uma página em branco tem sucesso com zero linhas, e qualquer falha descarta resultados parciais para que o commit multi-página continue all-or-nothing
Uma engine, uma cópia de models, um caller por vez
Cada engine da DLL RapidOCR tem exatamente uma instância de models por toda a vida dela, e chamadas Recognize nessa engine são serializadas por uma critical section. Segurar a referência IHPDFOCREngine é o que mantém os models na memória, então trabalho em lote deve criar a engine uma vez e reutilizá-la em todos os documentos
procedure OcrBatch(const Files: TStrings; const OutputDir: string);
var
  Models: THPDFRapidOCRDLLOptions;
  Engine: IHPDFOCREngine;
  Doc: THotPDF;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
  I: Integer;
begin
  Models := THPDFRapidOCRDLLOptions.ForLanguage('ru-RU');
  Models.UseAngleClassifier := False;    // scans upright: nenhum model de classifier carregado
  Models.Threads := 4;                   // 1..64, clamped aos processadores ativos
  Models.TimeoutMilliseconds := 120000;  // por chamada Recognize, cooperativo
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Options := THPDFOCRTextLayerOptions.Default;
  for I := 0 to Files.Count - 1 do
  begin
    Doc := THotPDF.Create(nil);
    try
      Doc.AutoLaunch := False;
      if (Doc.LoadFromFile(Files[I]) > 0) and
        Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
        Doc.SaveLoadedDocument(IncludeTrailingPathDelimiter(OutputDir) +
          ExtractFileName(Files[I]))
      else
        Writeln(Files[I], ': ', string(Info.Diagnostic));
    finally
      Doc.Free;
    end;
  end;
end;  // última referência liberada: models destruídos, depois a DLL descarregada
O Threads define as contagens de threads intra-op e inter-op de toda sessão ONNX na engine, e a DLL clampa para a contagem de processadores ativos. Duas threads compartilhando uma engine nunca rodam inferência em paralelo; a segunda espera. Essa espera não é um EnterCriticalSection cego. O adapter tenta o lock com TryEnterCriticalSection, dorme 25 ms entre tentativas, e confere o token de cancelamento e o deadline a cada vez, então um request na fila ainda pode ser cancelado
O relógio do deadline começa quando o Recognize é iniciado, antes de o lock ser tomado. Tempo na fila atrás de outra página conta contra o TimeoutMilliseconds. Com quatro worker threads numa engine e um deadline de 60 segundos, a quarta página pode dar timeout sem nunca chegar ao model. Em vez disso, dê a cada worker a própria engine. Custa uma cópia dos models na memória por engine, e essa memória compra timeouts previsíveis e paralelismo real; compartilhar uma engine só faz sentido quando os requests são raros o bastante para quase nunca enfileirar
Por que uma chamada OCR nativa não pode ser morta no meio da inferência?
Uma chamada RapidOCR nativa não pode ser morta no meio da inferência porque ela roda na sua thread, dentro do seu processo, no meio de uma sessão ONNX Runtime que não tem API de interrupção para um Run em curso. O cancelamento no adapter da DLL é cooperativo. A DLL chama um callback de aborto antes e depois da detecção, depois da classificação de cada crop, e depois de cada linha reconhecida, e para no primeiro checkpoint em que o callback retorna 0. Um único Run que já começou termina primeiro
As opções forçadas são piores que esperar. Um TerminateThread deixaria o heap lock da CRT, a thread pool do ONNX Runtime e qualquer estado do OpenCV na condição em que estivessem na hora. Chamar FreeLibrary enquanto uma chamada ainda executa desmapeia código que está na stack. Nenhuma das duas pode ser tornada segura, então o adapter nunca tenta. Um deadline expirado volta como otlsEngineError com diagnóstico de timeout; um token cancelado volta como otlsCancelled:
// O Token é criado pelo caller e compartilhado com a thread da UI,
// que chama Token.Cancel quando o usuário aperta Stop
function OcrWithStop(Doc: THotPDF; const Engine: IHPDFOCREngine;
  Token: THPDFCancellationToken): Boolean;
var
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Options := THPDFOCRTextLayerOptions.Default;
  Options.CancellationToken := Token;
  Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
  if not Result then
    case Info.Status of
      otlsCancelled:
        // para no próximo estágio ou checkpoint de linha; documento intacto
        Writeln('Cancelled');
      otlsEngineError:
        // inclui expiry cooperativo de deadline e diagnósticos nativos
        Writeln('Engine: ', string(Info.Diagnostic));
      otlsBudgetExceeded:
        // um limite de página, pixel, palavra ou conteúdo nas Options foi atingido
        Writeln('Budget: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
Esse é o trade-off real entre os adapters de processo e a DLL in-process, e nenhum lado vence todas as linhas:
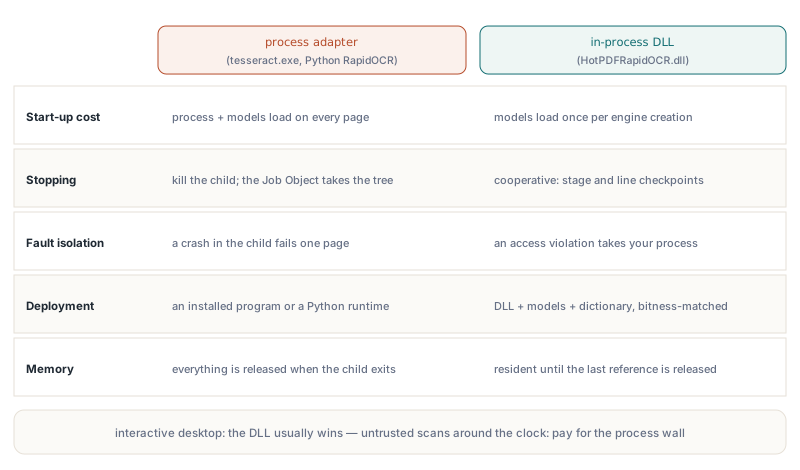
- Custo de start-up: os adapters Tesseract e RapidOCR Python iniciam um processo e carregam models a cada página; a DLL carrega models uma vez por engine
- Parada: um processo filho pode ser terminado de uma vez, e o worker Python roda dentro de um Job Object kill-on-close para que a árvore de processos inteira dele vá junto; a DLL para em checkpoints de estágio e de linha
- Contenção de falhas: um crash no
tesseract.exefalha uma página; um access violation dentro da DLL derruba o seu processo - Deploy: adapters de processo precisam de um programa instalado ou um ambiente Python; a DLL precisa dela mesma, dos models dela e do dictionary dela, casados com o bitness da aplicação
- Memória: um adapter de processo libera tudo quando o filho sai; uma engine de DLL mantém os models residentes até a última referência de interface ir embora
Escolha a DLL para uma aplicação desktop interativa que faz OCR de uma página por vez e precisa de um botão Stop responsivo que retorna dentro de um estágio de inferência. Para um server ingerindo scans não confiáveis ininterruptamente, pague o custo de start-up por página e mantenha a fronteira de processo; uma imagem craftada que crasha um recognizer deve custar uma página, e com um processo filho custa
Buildando a HotPDFRapidOCR.dll e escolhendo models
A HotPDFRapidOCR.dll é buildada dos fontes C++ em Native/RapidOCR com MSVC, C++17, um Windows SDK, e CMake 3.20 ou mais novo. O helper tools/Build-HotPDFRapidOCR.ps1 recebe os diretórios de fonte nativa, ONNX Runtime e OpenCV mais -Platform Win32 ou Win64, e escreve o resultado em Lib/Native/RapidOCR/<Platform>/. Faça o build dos dois se você shipa os dois. Uma aplicação Delphi de 32 bits não consegue carregar uma DLL de 64 bits, e as static libraries que você provisiona precisam casar com a arquitetura alvo e também com o modo de CRT
Models têm regras de compatibilidade próprias. O detector é um DB text detector. O recognizer aceita models CTC em layout NCHW com altura de input fixa de 32 ou 48, e usa 48 quando o model declara altura dinâmica. O formato de model tem de ser um que o ONNX Runtime linkado estaticamente entenda; exports mais novos como PP-OCRv5 podem exigir uma runtime mais nova, e um model ilegível falha na inicialização com um diagnóstico. O tools/Install-RapidOCRModels.ps1 instala packs PP-OCRv3 e PP-OCRv4 verificados contra hashes SHA256 pregados, com detector e classifier compartilhados sob os filenames que o Default espera. Fique nesses packs a menos que você controle também o build da runtime
O dictionary precisa ser UTF-8 sem BOM, exatamente na ordem de caracteres do model, e a contagem de entradas dele precisa casar com as classes de output do model. Finais de linha CRLF estão OK. Quando um model embute a própria lista de caracteres em metadata, a inicialização do model compara cada entrada e a posição dela contra o arquivo de dictionary, então um dictionary que só tem o comprimento certo ainda assim falha. A DLL nunca baixa um model que falta
O HotPDF embute o adapter RapidOCR nativo com os adapters OCR baseados em processo, o page renderer que os alimenta, e o writer de camada de texto Unicode invisível, tudo dentro de um componente VCL nativo para Delphi e C++Builder. Para software de captura e arquivamento que precisa produzir PDF pesquisável em máquinas sem Python instalado, o HotPDF Delphi PDF component deixa só a DLL e os model files dela para deploy