Uma nota fiscal russa processada por um recognizer que carrega o model cirílico mas continua lendo o character dictionary chinês volta como fileiras de caracteres Han perfeitamente válidos. Toda linha é UTF-8 bem formado, toda linha entra na camada de texto pesquisável, e uma busca por qualquer palavra impressa na página não encontra nada. O model fez o trabalho dele. Um recognizer CTC nunca produz caracteres, só números de classe, e o arquivo de dictionary é a única coisa que mapeia a classe 1.204 para um glyph
Três falhas relacionadas moram perto dali, e uma demo em script latino não mostra nenhuma delas: toda linha perdendo o caractere final, texto em inglês chegando sem espaçamento de palavras, e text boxes em árabe voltando na ordem da esquerda para a direita. Cada uma remonta a uma regra de dictionary, a uma borda de loop ou a uma ordem de sort fácil de acertar quase por completo. As quatro começam no mesmo ponto: a etapa que transforma uma tag de idioma num model e num dictionary
Presets de idioma RapidOCR no HotPDF: uma tag, um par pregado
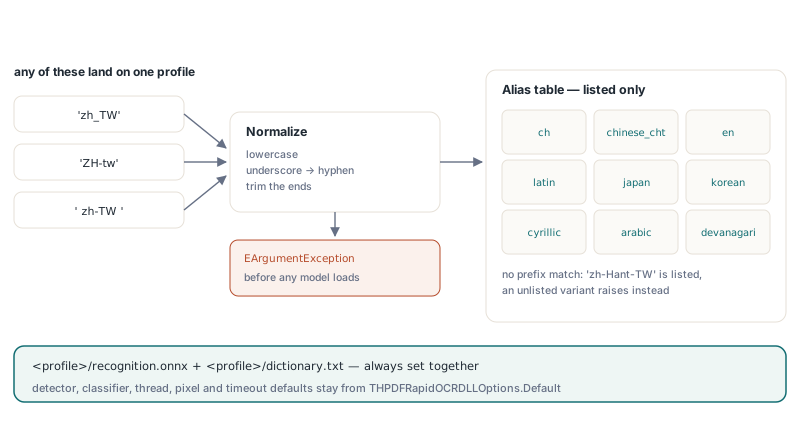
No HotPDF, o THPDFRapidOCRDLLOptions.ForLanguage transforma uma tag de idioma em options que apontam para <profile>/recognition.onnx e <profile>/dictionary.txt abaixo do seu model directory. Todo o resto vem do THPDFRapidOCRDLLOptions.Default: o detector compartilhado, o angle classifier opcional, uma thread, um budget de 16.777.216 pixels por request e um timeout de 60 segundos. A tag é convertida para minúsculas, underscores viram hífens e whitespace ao redor é aparado, então 'zh_TW', 'ZH-tw' e ' zh-tw ' resolvem para o mesmo perfil
O matching roda contra uma lista explícita de aliases, sem prefix matching. 'zh-Hant-TW' e 'zh-MO' são aceitas porque estão listadas; 'pt-AO' não está, e o ForLanguage levanta EArgumentException antes de qualquer arquivo ser aberto. Essa rigidez é proposital. Uma regra de prefixo entregaria silenciosamente 'zh-Hant-SG' ou alguma tag futura ao perfil que compartilha as duas primeiras letras, e com chinês as duas primeiras letras não dizem o script
| Perfil | Idiomas | Tags de exemplo | Ordem das boxes na linha |
|---|---|---|---|
ch | Chinês simplificado e inglês | zh, zh-CN, zh-Hans, chi_sim | Esquerda para a direita |
chinese_cht | Chinês tradicional | zh-TW, zh-HK, zh-Hant, chi_tra | Esquerda para a direita |
en | Inglês | en, en-US, en-GB, eng | Esquerda para a direita |
latin | Francês, alemão, espanhol, português, italiano, holandês, turco | fr, de, es-419, pt-BR, tr | Esquerda para a direita |
japan | Japonês | ja, ja-JP, jpn | Esquerda para a direita |
korean | Coreano | ko, ko-KR, kor | Esquerda para a direita |
cyrillic | Russo, ucraniano, búlgaro, bielorruso | ru, ru-RU, uk, bg | Esquerda para a direita |
arabic | Árabe, persa, urdu | ar, ar-SA, fa, ur | Direita para a esquerda |
devanagari | Hindi, marata, nepalês | hi, mr, ne | Esquerda para a direita |
O adapter nunca baixa nada. Os model files são provisionados uma vez com o helper que acompanha o pacote, por exemplo tools/Install-RapidOCRModels.ps1 -Destination C:/OCR/models -Language ch,chinese_cht,cyrillic, ou -Language All para todos os nove perfis. O helper coloca o detector e o classifier compartilhados nos filenames de raiz que o Default espera, e cada perfil na própria pasta dele. A criação da engine, a fronteira da DLL e o threading são cobertos em o artigo sobre a DLL RapidOCR in-process; com os arquivos no lugar, um scan de chinês simplificado fica pesquisável assim
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeChineseScanSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Models: THPDFRapidOCRDLLOptions;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // ch/recognition.onnx + ch/dictionary.txt, detector e classifier compartilhados
  Models := THPDFRapidOCRDLLOptions.ForLanguage('zh-CN');
  // os models carregam aqui; reutilize a engine entre documentos
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Layer := THPDFOCRTextLayerOptions.Default;  // 300 DPI, MinimumConfidence 0.5
    // lista de páginas vazia = todas as páginas; SkipPagesWithText deixa páginas com texto em paz
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Layer, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines, ', Info.UniqueScalarCount, ' distinct characters');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
Dois números desse output pedem leitura com atenção. O pipeline nativo reporta um resultado por linha de texto detectada, então o AcceptedWordCount conta linhas aqui, e o MinimumConfidence é comparado com a confidence média de caractere da linha inteira: uma linha com média 0.45 é descartada como uma unidade. O UniqueScalarCount é o número de Unicode scalars distintos que a camada de texto precisou mapear na fonte e na tabela ToUnicode dela. Uma página de corpo de texto em chinês deve empurrar esse número bem além das poucas dezenas de scalars que uma página latina precisa; uma contagem em território latino num scan em chinês normalmente significa que o perfil errado está carregado
Por que trocar só o recognition model produz lixo?
Porque o model e o dictionary são duas metades de uma mesma lookup table, e só o dictionary sabe o que os índices significam. Aponte o RecognitionModel para o cyrillic/recognition.onnx enquanto o CharacterDictionary continua nomeando o arquivo chinês, e o model emite índices cirílicos válidos que o dictionary velho traduz em caracteres Han aleatórios. O ForLanguage sempre define os dois campos juntos. Options montadas à mão devem seguir a mesma regra: nunca troque uma sem a outra
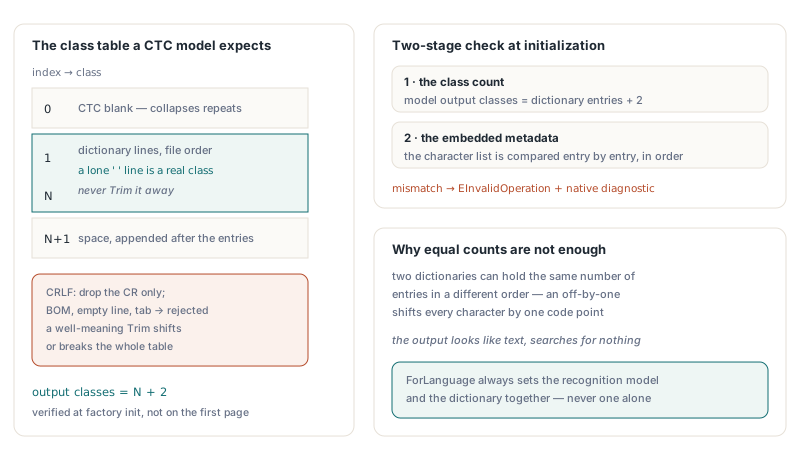
A proteção óbvia, comparar o tamanho do dictionary com a largura de output do model, é necessária e ainda assim não basta. Dois dictionaries podem ter o mesmo número de entradas em ordens diferentes, e um off-by-one desloca cada caractere em uma posição. Por isso a DLL RapidOCR do HotPDF confere duas vezes enquanto a factory inicializa o recognizer. A contagem de classes de output do model tem de ser igual às entradas do dictionary mais duas. Depois, se o arquivo ONNX embute uma lista de metadata character, cada linha do dictionary é comparada com ela em ordem. Qualquer divergência faz o HPDFCreateRapidOCRDLLOCREngine levantar EInvalidOperation com o diagnóstico nativo, e o erro aparece na inicialização, não na archive de um cliente
O "mais duas" vem do layout de classes. A classe 0 é o blank CTC, as classes 1 a N são as linhas do dictionary em ordem de arquivo, e a classe final é um espaço. Alguns dictionaries também trazem a própria entrada de espaço único deles, e essa linha precisa sobreviver exatamente como está. É aqui que um Trim bem-intencionado causa dano real: ele transforma a entrada de espaço numa string vazia e desloca ou quebra a tabela. A DLL remove um carriage return no fim da linha para que arquivos CRLF carreguem, e rejeita byte order mark UTF-8, linha vazia, ou entrada com tab ou um carriage return perdido
Se você mantém os próprios dictionaries, uma checagem pre-flight no script de build ou deploy pega esses problemas antes da engine. A função abaixo é código seu, escrito para espelhar as regras acima
// Helper seu, não é API do HotPDF: monta a tabela de classes que um CTC
// recognizer espera e rejeita os defeitos de dictionary que a DLL rejeita
uses
  SysUtils, IOUtils;

function BuildCTCClassTable(const FileName: string): TArray<string>;
var
  Text, Entry: string;
  Lines: TArray<string>;
  I, Last: Integer;
begin
  Text := TEncoding.UTF8.GetString(TFile.ReadAllBytes(FileName));
  if (Text <> '') and (Text[1] = #$FEFF) then
    raise EArgumentException.Create('Dictionary must be UTF-8 without a BOM');
  Lines := Text.Split([#10]);
  Last := High(Lines);
  if (Last >= 0) and (Lines[Last] = '') then
    Dec(Last);                                   // newline no fim do arquivo
  if Last < 0 then
    raise EArgumentException.Create('Dictionary is empty');
  SetLength(Result, Last + 3);
  Result[0] := '';                               // classe 0: blank CTC
  for I := 0 to Last do
  begin
    Entry := Lines[I];
    if (Entry <> '') and (Entry[Length(Entry)] = #13) then
      SetLength(Entry, Length(Entry) - 1);       // CRLF: descarta só o CR
    if (Entry = '') or (Pos(#9, Entry) > 0) or (Pos(#13, Entry) > 0) then
      raise EArgumentException.CreateFmt('Invalid dictionary line %d', [I + 1]);
    Result[I + 1] := Entry;                      // nunca Trim: ' ' é uma classe
  end;
  Result[Last + 2] := ' ';                       // classe final: espaço
  // Length(Result) tem de ser igual à contagem de classes de output do model
end;
Greedy CTC decoding e as três armadilhas de borda dele
O greedy CTC decoding escolhe a classe de maior score a cada time step, colapsa repetições consecutivas num caractere e descarta o blank. O blank é o que permite que uma letra genuinamente dobrada sobreviva. Um recognition model lê uma linha de texto como uma sequência de fatias verticais estreitas, e para cada fatia produz uma probabilidade para cada classe. Uma linha com AA中 pode gerar a sequência argmax A A blank A 中 space: os dois primeiros passos A colapsam num só, o blank separa esse caractere do próximo A, e o output é AA中 com o espaço final intacto. Sem a regra do blank, book e bok decodificariam igual
Um decoder tão curto convida a erros off-by-one, e cada erro produz o próprio sintoma reconhecível. Pare o loop argmax interno uma classe antes e a classe de espaço nunca vence, então toda linha em inglês ou latim volta como uma palavra única comprida e a phrase search para de funcionar. Pare o loop externo um time step antes e o último caractere de toda linha desaparece, o que num rótulo de dois caracteres é metade do texto. Esqueça de deixar um blank resetar o guard de repetição e caracteres dobrados colapsam: o ll de hello, ou o 谢谢 reduplicado. Se você escrever um decoder para um pipeline próprio, esses três casos formam um conjunto de testes compacto. O decoder do HotPDF cobre a última classe e o último passo, mantém repetições separadas por blank, e rejeita scores que não são finitos ou saem da faixa de 0 a 1, além de qualquer contagem de classes que discorde do dictionary
// Ilustração para um pipeline seu, não é API do HotPDF: greedy CTC
// decoding com bordas corretas. Scores guarda Steps * Classes
// probabilidades, uma linha por time step
function GreedyCTCDecode(const Scores: array of Single;
  Steps, Classes: Integer; const Characters: array of string): string;
var
  Step, C, Best, Previous: Integer;
  BestScore: Single;
begin
  if (Classes < 3) or (Length(Characters) <> Classes) or
    (Length(Scores) <> Steps * Classes) then
    raise EArgumentException.Create('Model output does not match the dictionary');
  Result := '';
  Previous := 0;                            // a classe 0 é o blank CTC
  for Step := 0 to Steps - 1 do             // inclua o último time step
  begin
    Best := 0;
    BestScore := Scores[Step * Classes];
    for C := 1 to Classes - 1 do            // inclua a última classe (espaço)
      if Scores[Step * Classes + C] > BestScore then
      begin
        Best := C;
        BestScore := Scores[Step * Classes + C];
      end;
    if (Best <> 0) and (Best <> Previous) then
      Result := Result + Characters[Best];
    Previous := Best;                       // um blank reseta o guard de repetição
  end;
end;
Beam search com um language model resolve algumas fatias ambíguas em que o greedy decoding erra, a um custo real de velocidade e de um segundo conjunto de arquivos para versionar. Para documentos impressos renderizados a 300 DPI, o greedy decoding é o default certo, e o decoder é o lugar errado para compensar o que o model não consegue ver. O mesmo vale para tabelas de substituição de caracteres. Se um model lê uma letra acentuada como a letra base dela, remendar o output com uma tabela de substituição conserta um idioma e quebra outro. Um caractere errado numa camada pesquisável é pior que um ausente, porque a busca encontra o documento errado em vez de não encontrar nada, então o texto reconhecido vai para o PDF exatamente como o model o produziu
Como as linhas de texto são ordenadas para árabe da direita para a esquerda?
A DLL ordena as text boxes detectadas de cima para baixo, agrupa boxes numa mesma linha quando elas se sobrepõem verticalmente em pelo menos metade da altura da box menor, e ordena cada linha da esquerda para a direita, ou da direita para a esquerda quando o RightToLeft está definido. Os caracteres dentro de uma linha reconhecida nunca são invertidos. O agrupamento em linhas importa porque detectors costumam dividir uma linha visual em várias boxes, um rótulo e um valor separados por um vão largo, por exemplo, e um sort simples pela coordenada superior intercalaria essas boxes com a linha seguinte sempre que os topos diferissem em um ou dois pixels
O perfil árabe é o único em que o ForLanguage define RightToLeft := True, o que faz a DLL ordenar cada linha pelas bordas direitas das boxes, começando pela margem direita. O efeito é só esse. O texto que o model devolve para uma linha já está em ordem lógica Unicode, a ordem em que um leitor de árabe lê e digita, e é também a ordem que a extração de texto e a busca em PDF esperam. Inverter a string para que ela "pareça certa" no debugger do Delphi quebraria busca, copiar e colar, e screen readers. Exibição bidirecional e glyph shaping são trabalho do visualizador de PDF
Uma engine serve um perfil de idioma, e não existe detecção automática de script. Um documento que mistura scripts precisa de uma engine por perfil, cada uma aplicada às próprias páginas dela. O ApplyLoadedOCRTextLayer recebe uma lista de páginas explícita e efetiva cada chamada como transação própria, então uma falha nas páginas em árabe faz rollback daquela chamada sem tocar na camada chinesa já escrita
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

function CreateRapidEngine(const Tag: string): IHPDFOCREngine;
var
  Models: THPDFRapidOCRDLLOptions;
begin
  // levanta EArgumentException para tag fora da lista, antes de qualquer model carregar
  Models := THPDFRapidOCRDLLOptions.ForLanguage(Tag);
  Models.MaxPixels := 33554432;          // espaço para páginas A3 a 300 DPI
  Result := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
end;

procedure OCRMixedArchive(Doc: THotPDF);
var
  Chinese, Arabic: IHPDFOCREngine;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Chinese := CreateRapidEngine('zh-TW');  // perfil chinese_cht
  Arabic := CreateRapidEngine('ar-SA');   // perfil arabic, RightToLeft = True
  Layer := THPDFOCRTextLayerOptions.Default;
  if not Doc.ApplyLoadedOCRTextLayer([0, 1, 2], Chinese, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
  if not Doc.ApplyLoadedOCRTextLayer([3], Arabic, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
end;
A linha do MaxPixels está ali por um motivo. O budget default de 16.777.216 pixels por request cobre A4 e US Letter a 300 DPI com folga. Uma folha A3 a 300 DPI dá cerca de 3508 por 4961 pixels, aproximadamente 17,4 milhões, então esse request é recusado e o Info.Diagnostic reporta um request inválido ou um pixel budget estourado. Suba o MaxPixels até o teto de 67.108.864, ou baixe o THPDFOCRTextLayerOptions.DPI para formatos grandes. A ordenação da direita para a esquerda passa pelo export de DLL HPDFRapidOCRSetReadingDirection, que o adapter procura só quando o RightToLeft está definido; um build da DLL sem esse export ainda serve os perfis da esquerda para a direita, e criar uma engine árabe com ele levanta EArgumentException nomeando o export que falta
Model packs pregados e o que um par próprio precisa passar
A DLL RapidOCR do HotPDF linka um ONNX Runtime buildado estaticamente, então ela lê as versões do formato de arquivo ONNX que essa runtime entende e nada mais novo. Exports de model recentes podem mirar um formato mais novo; tal arquivo é rejeitado na criação da engine com um diagnóstico nativo. Esse pareamento é o motivo de cada language pack apontar para um recognizer e um dictionary específicos que carregam e passam nas checagens de classe sob a runtime embarcada, e de os packs nunca serem a versão "latest"
O Install-RapidOCRModels.ps1 impõe o pareamento em disco. Todo arquivo no manifest dele carrega um hash SHA256. Um arquivo existente com hash diferente para o install e fica no lugar para você mover ou remover, e cada download é escrito sob um nome temporário e só se move para a posição depois de o hash dele bater. Isso bloqueia a versão silenciosa do problema de dictionary: alguém copia à mão um recognition.onnx mais novo para dentro de uma pasta de perfil, a contagem de classes por acaso bate, e o primeiro sinal de problema é um cliente dizendo que a busca não encontra palavras que dá para ver claramente. Se você instalar com -SkipClassifier, defina UseAngleClassifier := False nas options, porque o Default espera o arquivo do classifier e a criação da engine verifica que ele existe
O recognizer também confere o input shape do model na carga. Ele aceita input float NCHW com altura fixa de 32 ou 48 pixels, ou altura dinâmica, que roda a 48. Um model exportado com qualquer outra altura fixa falha a criação da engine com "Unsupported recognition model input or output shape"
Para um script que nenhum dos nove perfis cobre, o RecognitionModel e o CharacterDictionary podem apontar para os seus próprios arquivos, e todas as checagens acima continuam valendo. Um par desalinhado falha na criação da engine, ainda no seu teste. Para páginas em que nenhum perfil RapidOCR se encaixa, o adapter Tesseract para PDF pesquisável entra na mesma chamada ApplyLoadedOCRTextLayer, e para formulários ASCII impressos por máquina a engine OCR de template matching integrada não precisa de nenhum model file
Os presets de idioma, o adapter nativo RapidOCR e a camada de texto OCR estão todos incluídos no HotPDF Delphi PDF Component para projetos Delphi, C++Builder e FPC/Lazarus no Windows