Um pipe que nunca reporta end-of-file é um bug estranho de caçar numa feature de OCR. Uma thread na sua aplicação lê o standard output de um programa auxiliar e espera o ReadFile falhar com ERROR_BROKEN_PIPE. Outra thread inicia o tesseract.exe através de CreateProcess com bInheritHandles setado para True, porque é assim que se entrega a um processo filho um arquivo para o standard error dele. O write end do pipe do auxiliar era herdável, então o Tesseract agora possui uma cópia, e a thread de leitura pende até o Tesseract terminar a página dele — o que, num scan de 300 DPI com dois language models carregados, não é rápido
Um recognizer externo traz mais que o hang: o que o filho pode ver, o que fazer com output meio válido, como transformar boxes de pixels em texto PDF pesquisável. A engine OCR de template matching integrada cobre letras e dígitos ASCII impressos por máquina de propósito. Nomes acentuados, contratos em chinês e arquivos multilíngue precisam de language models treinados, e o Tesseract é o candidato usual porque é um programa de linha de comando que você pode instalar ao lado do executável
Encaixando o Tesseract na camada de texto OCR do HotPDF
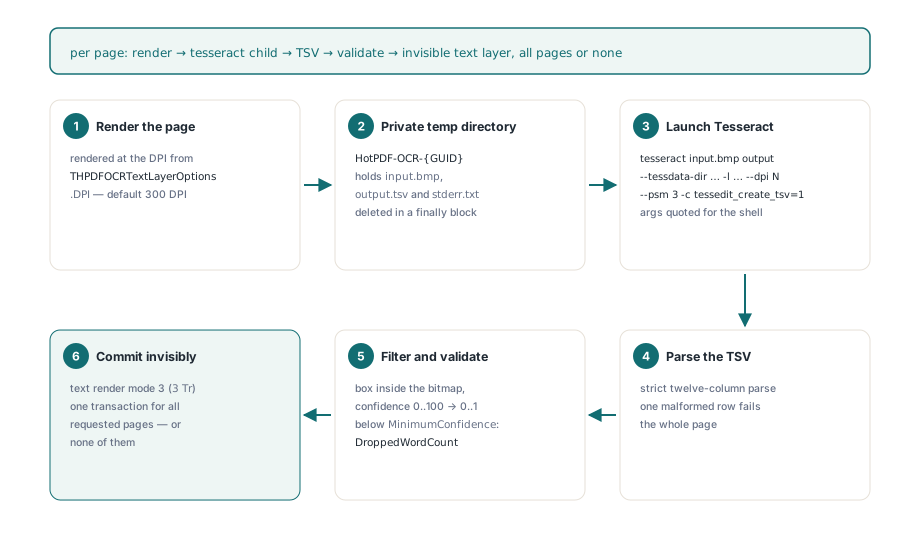
O HotPDF embrulha um executável Tesseract instalado localmente como uma IHPDFOCREngine através do HPDFCreateTesseractOCREngine na unit HPDFTesseractRecognition. Você passa essa engine ao THotPDF.ApplyLoadedOCRTextLayer, que renderiza cada página pedida, roda o Tesseract uma vez por página, filtra as palavras e escreve uma camada de texto Unicode invisível para todas as páginas pedidas numa única transação, ou para nenhuma delas. Mapeamento de coordenadas, rotação, filtragem de confidence e o commit são o pipeline que a engine integrada já usa; só o reconhecimento muda
A factory levanta EArgumentException antes de qualquer página ser tocada. O executável e o diretório tessdata precisam existir, o timeout precisa estar entre 1 e 3.600.000 milissegundos, e o idioma pode conter só letras ASCII, dígitos, _ e +, porque ele acaba numa linha de comando: eng+chi_sim é legítimo, um valor com aspas ou espaços é uma injeção esperando para acontecer. Um segundo overload recebe um record THPDFTesseractOptions. O Default dele dá --psm 3, --oem 3, 60 segundos por página e um cap de 16.777.216 pixels, e ele rejeita tpsOSDOnly e tpsAutoOnly, os dois modos que não retornam palavras
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFTesseractRecognition;

function MakeSearchable(const SourceFile, TargetFile: string;
  Token: THPDFCancellationToken): Boolean;
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default; // psm 3, oem 3, 60 s, 16.777.216 px
  TessOptions.TimeoutMilliseconds := 120000;    // vale para cada página
  // levanta EArgumentException para executável ou pasta tessdata ausente,
  // um identificador de idioma inválido, ou options fora das faixas delas
  Engine := HPDFCreateTesseractOCREngine(
    'C:\OCR\Tesseract\tesseract.exe',
    'C:\OCR\Tesseract\tessdata',
    'eng+chi_sim',                              // models unidos com '+'
    TessOptions);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default; // 300 DPI, MinimumConfidence 0.5
    Options.CancellationToken := Token;
    // lista de páginas vazia significa todas as páginas; páginas que já têm texto são puladas
    Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
    if Result then
    begin
      Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
        ' words kept, ', Info.DroppedWordCount, ' below the threshold');
      Doc.SaveLoadedDocument(TargetFile);
    end
    else
      case Info.Status of
        otlsCancelled:      Writeln('Cancelled, document unchanged');
        otlsEngineError:    Writeln('Engine: ', string(Info.Diagnostic));
        otlsBudgetExceeded: Writeln('Budget: ', string(Info.Diagnostic));
      else
        Writeln(string(Info.Diagnostic));
      end;
  finally
    Doc.Free;
  end;
end;
Faça a aritmética de pixels uma vez. Uma página A4 a 300 DPI dá cerca de 2.481 por 3.508 pixels, aproximadamente 8,7 milhões, e cabe. Uma página A3 na mesma resolução é cerca de 3.508 por 4.961, perto de 17,4 milhões, então ela falha com um diagnóstico de pixel budget e a run termina como otlsEngineError. O overload que recebe só um timeout não aplica cap de pixel nenhum. Para um serviço que aceita arquivos de fora, mantenha o overload de options e suba o MaxPixels (até 67.108.864) ou baixe o THPDFOCRTextLayerOptions.DPI deliberadamente quando formatos grandes são esperados
Por página, a engine cria um diretório privado HotPDF-OCR-{GUID} sob o temp path, salva o bitmap como input.bmp e roda tesseract input.bmp output --tessdata-dir … -l … --dpi N --psm 3 -c tessedit_create_tsv=1, adicionando --oem quando um engine mode está definido. Paths são postos entre aspas com as regras do Windows para barras invertidas e aspas embutidas, e o --dpi carrega a resolução de render para que o Tesseract nunca a chute. O Tesseract e os arquivos .traineddata dele não vêm no pacote; provisioná-los é trabalho da aplicação. Nas nossas próprias máquinas de teste Linux o recognizer roda de um bundle de nível de usuário do binário, do closure de shared libraries dele e da pasta tessdata, porque depender de /usr/bin/tesseract só funciona onde alguém instalou o pacote do sistema
Por que uma linha TSV quebrada esvazia a página inteira?
O adapter Tesseract falha a página inteira na primeira linha malformada, porque uma lista de palavras parcialmente parseada produz uma camada de texto que discorda da imagem, e nada no PDF salvo diz quais palavras sumiram. O output precisa decodificar como UTF-8 estrito sem NUL embutido. A primeira linha precisa igualar o header de doze colunas do Tesseract, de level a text, depois de um byte order mark opcional ser removido. Cada linha precisa se dividir em exatamente doze campos, e o split para depois do décimo primeiro tab, então um tab dentro do texto reconhecido cai no campo de texto em vez de criar uma décima terceira coluna, onde a checagem de caracteres de controle abaixo então o rejeitaria
Só linhas de level 5 são palavras; linhas de page, block, paragraph e line são puladas, assim como palavras vazias ou só de whitespace. Uma palavra contendo um caractere de controle (abaixo de U+0020, ou U+007F a U+009F) falha a página. O resto precisa de geometria inteira, uma confidence parseada com formatação invariante para que uma aplicação com locale alemão ainda leia 93.5, uma box totalmente dentro do bitmap, e uma confidence de 0 a 100. Uma palavra válida seguida de uma linha quebrada rende zero palavras
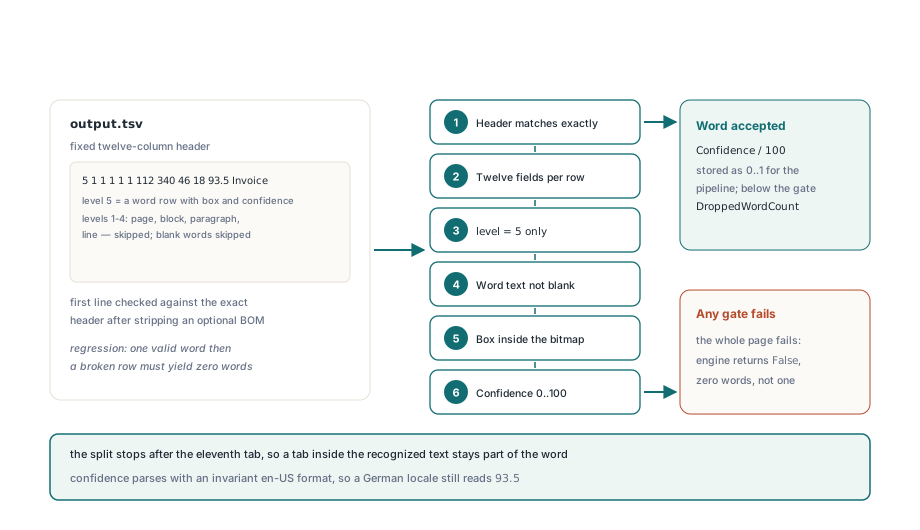
Uma linha esquisita portanto falha a run inteira e deixa todas as páginas intocadas. Esse é o trade certo. Uma rerun é barata; um PDF pesquisável em que uma busca por um número de nota fiscal erra a única página que importa costuma aparecer meses depois, nas mãos de outra pessoa
O último passo também encontra um default que você talvez não espere. O Tesseract reporta confidence de 0 a 100, o pipeline divide por 100, e o THPDFOCRTextLayerOptions.MinimumConfidence tem default 0.5, então qualquer palavra abaixo de 50 cai no Info.DroppedWordCount em vez de na página. Num scan limpo esse piso é sensato. Num fax ruidoso ele pode remover uma grande fatia do texto, então compare o Info.ReceivedWordCount com o Info.AcceptedWordCount antes de baixá-lo
Rodando OCR de novo num arquivo que já tem texto
O SkipPagesWithText é True por default, e isso pega as pessoas na segunda vez. Suponha que um lote foi processado com eng e agora precisa de eng+deu: toda página já carrega texto invisível, então o Info.SkippedPageCount iguala a contagem de páginas. O HotPDF marca o content stream que escreve como a própria camada OCR dele, e o ReplaceExistingOCRTextLayer usa essa marca para reconhecer essas páginas de novo, descartando a camada velha e mantendo o conteúdo original da página
Options := THPDFOCRTextLayerOptions.Default;
Options.ReplaceExistingOCRTextLayer := True;  // troca a nossa camada anterior
Options.UseOptionalContentGroup := True;      // camada nomeada 'OCR Text Layer'
Options.CancellationToken := Token;
if Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
  Writeln(Info.ReplacedPageCount, ' replaced, ',
    Info.SkippedPageCount, ' skipped, ',
    Info.RecognizedPageCount, ' recognized')
else
  Writeln(string(Info.Diagnostic));
Um arquivo com OCR feito por um driver de scanner não carrega tal marca, então as páginas dele ainda contam como páginas com texto. Desligar o SkipPagesWithText empilharia uma segunda camada invisível sobre a primeira, e todo hit de busca apareceria duas vezes. Deixe esses arquivos em paz
Quais handles o processo Tesseract herda?
O processo filho Tesseract herda exatamente dois handles do HotPDF: um aberto em NUL para standard input e output, e um para o stderr.txt no diretório privado. O hang de pipe acima vem do próprio CreateProcess: bInheritHandles = True é requerido para passar standard handles, e por si só ele passa todo handle herdável no host, incluindo pipes, arquivos e events abertos por código sem relação. O HotPDF usa STARTUPINFOEX com uma attribute list carregando PROC_THREAD_ATTRIBUTE_HANDLE_LIST e a flag EXTENDED_STARTUPINFO_PRESENT. O bInheritHandles continua True, mas só os handles listados cruzam
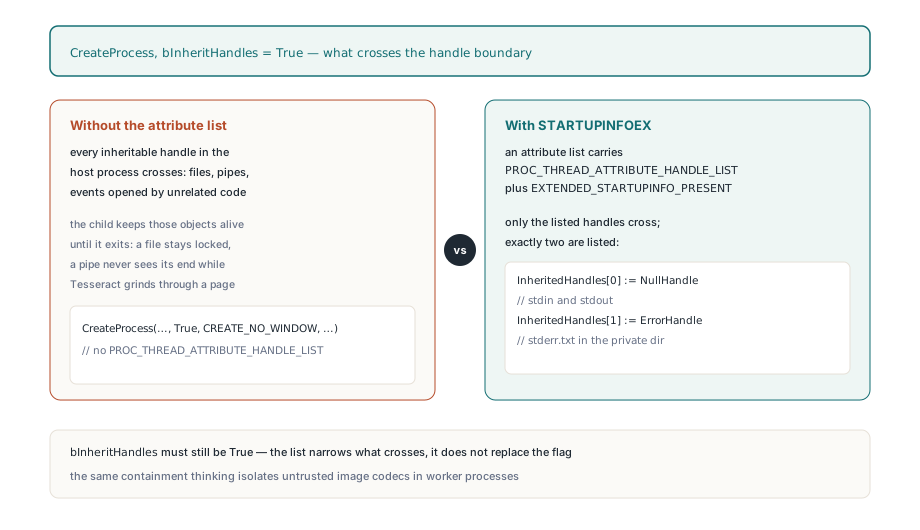
O mesmo padrão pertence a todo outro processo filho que a sua aplicação iniciar, já que um launcher que herda tudo basta para pendurar todo leitor de pipe no processo:
// Padrão para as suas próprias chamadas CreateProcess (fragmento: NullHandle, ErrorHandle,
// Exe, CommandLine, WorkDir e ProcessInfo são declarados em outro lugar).
// RTLs Delphi mais velhas não declaram as funções de attribute list; adicione as suas
// declarações external próprias do kernel32 se o compilador não as encontrar
// Confira cada resultado BOOL em código de produção
type
  TStartupInfoExRec = record
    StartupInfo: TStartupInfo;
    AttributeList: Pointer;
  end;
const
  HANDLE_LIST_ATTRIBUTE = $00020002;   // PROC_THREAD_ATTRIBUTE_HANDLE_LIST
  EXTENDED_STARTUP_FLAG = $00080000;   // EXTENDED_STARTUPINFO_PRESENT
var
  Startup: TStartupInfoExRec;
  HandleList: array[0..1] of THandle;
  Size: NativeUInt;
begin
  FillChar(Startup, SizeOf(Startup), 0);
  HandleList[0] := NullHandle;         // criado com bInheritHandle = True
  HandleList[1] := ErrorHandle;        // idem
  Size := 0;
  InitializeProcThreadAttributeList(nil, 1, 0, Size);
  GetMem(Startup.AttributeList, Size);
  InitializeProcThreadAttributeList(Startup.AttributeList, 1, 0, Size);
  UpdateProcThreadAttribute(Startup.AttributeList, 0, HANDLE_LIST_ATTRIBUTE,
    @HandleList[0], SizeOf(HandleList), nil, nil);
  Startup.StartupInfo.cb := SizeOf(Startup);
  // ... defina dwFlags e hStdInput / hStdOutput / hStdError como de costume ...
  CreateProcess(PChar(Exe), PChar(CommandLine), nil, nil,
    True,                              // ainda requerido com uma handle list
    CREATE_NO_WINDOW or EXTENDED_STARTUP_FLAG,
    nil, PChar(WorkDir), Startup.StartupInfo, ProcessInfo);
  // depois de o filho sair: DeleteProcThreadAttributeList, FreeMem, CloseHandle
end;
Bridge scripts adicionam mais um detalhe do Windows. Um launcher Python pode iniciar um segundo processo interpretador, e terminar o processo que você criou deixa aquele rodando. Quando a engine recebe um script path, como o adapter RapidOCR abaixo recebe, o HotPDF inicia o filho suspenso, o atribui a um job object com JOB_OBJECT_LIMIT_KILL_ON_JOB_CLOSE e então o retoma, então fechar o job encerra a árvore inteira. A mesma ideia de contenção dirige isolar codecs de imagem PDF em processos worker, em que o filho não é confiável; aqui o filho é confiável, mas o seu processo não é o único código segurando handles nele
Cancelamento, timeouts e o commit all-or-nothing
O IHPDFOCREngine.Recognize retorna um Boolean, e False cobre tanto "o Tesseract falhou" quanto "o usuário apertou Cancel". O adapter consulta o token e o timeout dele a cada 25 milissegundos enquanto o Tesseract roda, e no cancelamento ele limpa e retorna False. Tomado ao pé da letra isso leria como otlsEngineError, então o ApplyLoadedOCRTextLayer confere o token primeiro sempre que o Recognize retorna False. Reconhecimento e construção de conteúdo terminam para toda página pedida antes de a transação do documento abrir, então um cancelamento na página 40 de 50 reporta otlsCancelled e deixa as 50 páginas como carregadas. Os outros limites seguem o mesmo estilo:
- O timeout corre do início de cada chamada
Recognize, então o default de 60.000 ms é um limite por página - Um filho ainda rodando no timeout ou cancelamento é terminado e esperado por até 5 segundos; o diretório privado é removido num bloco
finally, com deleção retentada por até um segundo porque arquivos de output podem ficar travados brevemente depois de o processo terminar - O
output.tsvé limitado a 64 MiB e ostderr.txta 1 MiB, conferidos enquanto o filho roda e depois que ele sai - Palavras e code units UTF-16 por página são limitados pelo que resta de
MaxWordsPerPage,MaxTotalWordseMaxTextCodeUnits; passar disso falha a run em vez de truncar a lista - Um exit code não zero volta com até 4.096 caracteres do
stderr.txt, o caminho mais rápido para descobrir que um arquivo.traineddataestá faltando
Como a camada de texto invisível fica dentro da página
O HotPDF escreve as palavras com text rendering mode 3 (nem fill nem stroke, ISO 32000-1 §9.3.6), então o scan continua visível enquanto busca e cópia trabalham sobre as palavras. O content stream abre BT com 3 Tr; cada palavra recebe uma matriz Tm na baseline dela, um font size de altura da box em pixels vezes 72 sobre o DPI de render, e uma escala Tz que estica a run até a largura da box. Esse esticamento mantém um highlight de busca sobre a palavra na imagem
O TSV tem boxes mas nenhuma baseline, então cada baseline é posta a um quinto da altura da box acima da borda inferior. Entre palavras vizinhas numa linha da esquerda para a direita em scripts separados por espaço como latim ou cirílico, um espaço esticado preenche o vão, então texto copiado mantém as quebras de palavra dele; chinês não recebe nenhuma. Glyphs passam por uma fonte Type0 compartilhada não embutida com encoding Identity-H e um CMap ToUnicode gerado, um CID por Unicode scalar distinto, que é como chinês, latim acentuado e caracteres de plano suplementar sobrevivem a cópia e busca. Uma run segura até 65.535 scalars distintos, e como o ISO 19005 exige fontes embutidas, output PDF/A precisa de uma fonte conformante embutida separadamente. Para conferir um resultado, salve, recarregue e rode o caminho comum de extrair texto de um PDF carregado no Delphi; se as palavras esperadas voltarem nas páginas esperadas, a camada é real
RapidOCR e a DLL nativa no mesmo contrato
Para scans de chinês simplificado, HPDFCreateRapidOCREngine(PythonExecutable, BridgeScript, ModelDirectory, TimeoutMilliseconds) reutiliza o mesmo runner de processo e parser TSV. O path do bridge script segue o executável Python e o idioma é fixado em chi_sim. O HotPDF embarca a bridge como tools/OCR/rapidocr_tsv.py; ela precisa dos pacotes rapidocr e onnxruntime, de models ONNX locais e de um arquivo de fonte, recusa downloads automáticos, e escreve TSV em formato Tesseract; um overload THPDFRapidOCROptions define model files, contagens de threads e um pixel cap. A factory genérica por trás dos dois adapters, HPDFCreateLocalTSVOCREngine em HPDFLocalTSVRecognition, aceita qualquer programa que receba os argumentos estilo Tesseract e escreva o TSV de doze colunas, e ela herda a handle list, o timeout, o cancelamento e os budgets
O HPDFCreateTesseractDLLOCREngine(LibraryPath, TessDataDirectory, Language) carrega a C API do Tesseract in-process em vez disso, se reporta como Tesseract (native DLL), confere de cara que todo .traineddata pedido existe, e mapeia cancelamento e timeout para o progress monitor do próprio Tesseract. Ele economiza um start de processo e uma viagem de BMP por página; o executável mantém os crashes e o crescimento de memória do recognizer fora do seu address space. Para uma ferramenta desktop trabalhando nos scans do próprio usuário a DLL está ótima. Para um serviço que ingere documentos de estranhos, a engine de linha de comando é a escolha mais segura. De qualquer forma o reconhecimento roda no Windows, uma página por vez, sobre o bitmap renderizado, então faça deskew e limpeza de scans difíceis antes de eles chegarem à engine
Os adapters OCR, o writer de camada de texto, o renderer que os alimenta e a extração que confere o output vivem todos num único componente VCL nativo para Delphi e C++Builder. Se a sua aplicação de captura ou arquivamento precisa de output PDF pesquisável, o HotPDF Delphi PDF component cobre tudo exceto a engine OCR que você mesmo instala