Em uma fonte TrueType que mantém a ordem de glifos Macintosh padrão, a palavra "Total" pode estar em um content stream de PDF como <0037005200570044004F> Tj. Aqueles cinco valores de dois bytes são números de glifo dentro da fonte incorporada, e nada na string diz que eles desenham T, o, t, a e l. Leia aqueles bytes como UTF-16 e você recebe a string 7RWDO, enquanto a página em si mostra Total na tela, porque desenhar um glifo precisa apenas do mapeamento código-para-glifo, e recuperar texto precisa de um mapeamento código-para-Unicode que o arquivo pode nunca ter carregado
Por que o texto extraído sai como gibberish?
Um content stream registra códigos de caractere, e o significado deles mora inteiramente na fonte. Os operadores Tj e TJ (ISO 32000-1 §9.4.3) carregam strings de bytes que são interpretadas pela fonte que o Tf anterior selecionou: o byte 0x41 é a letra A sob WinAnsi, um glifo arbitrário em uma fonte subset, ou metade de um CID de dois bytes em uma fonte CJK composta. A ISO 32000-1 §9.10 trata extração de texto como exatamente esse problema de decodificação, mapeando cada código de volta para Unicode a partir do que o dicionário de fonte fornece, e diz explicitamente que um arquivo conforme não é obrigado a fornecer informação suficiente para fazer isso
Essa cláusula está por trás de todo relatório de "copiar e colar deste PDF produz lixo". Um produtor que incorpora uma fonte subset sem tabela /ToUnicode gravou um arquivo válido que renderiza corretamente. Os glifos estão todos lá. O que falta é o mapa reverso, que um extrator precisa reconstruir de evidência secundária: a codificação declarada da fonte, nomes de glifo, as coleções de caracteres publicadas pela Adobe, a tabela cmap dentro do programa de fonte incorporado. Quantos desses uma API tenta, e o que ela entrega quando todos falham, é o que separa bibliotecas de extração na prática
Texto em ordem de leitura com ExtractLoadedPageText
O HotPDF Delphi Component retorna o texto em ordem de leitura de uma página carregada por meio de function ExtractLoadedPageText(PageIndex: Integer; out AText: UnicodeString): boolean. Índices de página são zero-based, o resultado é um UnicodeString nativo do Delphi, e a função retorna False quando a página não tem content stream legível em vez de levantar exceção. Ela funciona em qualquer PDF que você carregar: a nota fiscal que um cliente mandou por e-mail, o relatório que uma casa de digitalização entregou, o contrato produzido por um software que ninguém consegue mais nomear
var
  Pdf: THotPDF;
  PageCount, I: Integer;
  PageText, AllText: UnicodeString;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('invoice.pdf');  // retorna a contagem de páginas
    AllText := '';
    for I := 0 to PageCount - 1 do
      if Pdf.ExtractLoadedPageText(I, PageText) then
        AllText := AllText + PageText + #13#10;
  finally
    Pdf.Free;
  end;
end;
Para o documento inteiro em uma string, o ExtractLoadedPagesText(PageRange, PageSeparator) recebe uma faixa one-based como '1,3-5,7-' (uma string vazia significa todas as páginas) e põe o PageSeparator, um form feed #12 por padrão, entre as páginas. Documentos grandes vão melhor pelo ExtractLoadedPagesTextToStream, que grava UTF-8 página por página em um TStream e retorna quantas páginas processou
O texto guarda o que a página mostra. Glifos cujo centro da caixa cai fora da área visível (o crop box dentro do media box) ficam de fora, então marcas de impressora em uma página aparada não vazam para o seu índice. Texto dentro de Form XObjects que a página pinta é incluído, recortado ao /BBox de cada form. Um caractere pintado duas vezes no mesmo lugar, o truque antigo para fingir uma face bold, é lido uma vez; fake bold e glifos duplicados na extração de texto percorre como esse caso é detectado
Quebras de linha seguem uma regra geométrica simples. Uma linha nova começa quando a origem do glifo se move através da direção de escrita por mais que metade da altura do texto, tomando a maior entre a altura de ascent-a-descent deste glifo e a do glifo anterior em unidades de página. Medir a caixa do glifo em vez do operando de tamanho do Tf é a parte que importa: muitos produtores dimensionam texto pela matriz de texto e passam 1 ao Tf, e um limiar construído sobre aquele operando quebraria em todo sobrescrito elevado e poria cada caractere de texto rotacionado em sua própria linha. Espaços entre palavras funcionam do mesmo jeito. Onde um produtor separa palavras movendo a posição do texto com um ajuste de TJ ou um Td em vez de mostrar um espaço, um espaço é adicionado quando o vão após a própria largura do glifo anterior excede 0.15 da altura do glifo, e nunca entre dois caracteres chineses, japoneses ou coreanos. Códigos que o decodificador não resolve viram espaços, então fronteiras de palavras sobrevivem mesmo quando glifos individuais não. Texto horizontal sai na ordem do content stream; corridas CJK verticais são reagrupadas em colunas lidas da direita para a esquerda, de cima para baixo. Espaços entre palavras e quebras de linha em texto de página cobre esses limiares
Grade, colunas ou ordem de estrutura
Quando a posição carrega significado (tabelas, formulários, listagens de código, qualquer coisa que você vai diffar, grep ou parsear por coluna), o ExtractLoadedPageTextLayout é a chamada melhor. Ele agrupa glifos em baselines, ordena cada baseline por X, e reproduz whitespace horizontal e vertical em uma grade de caracteres monoespaçada dimensionada pelo avanço mediano de glifo e pelo tamanho de fonte da página. Vãos largos em uma baseline viram sequências de espaços, vãos grandes entre baselines viram linhas em branco
uses System.IOUtils;
...
var
  Grid: UnicodeString;
begin
  if Pdf.ExtractLoadedPageTextLayout(0, Grid) then
    TFile.WriteAllText('page1.txt', Grid, TEncoding.UTF8);
  // Colunas, indentação e alinhamento de tabela sobrevivem como
  // espaços e linhas em branco em uma grade de caracteres
end;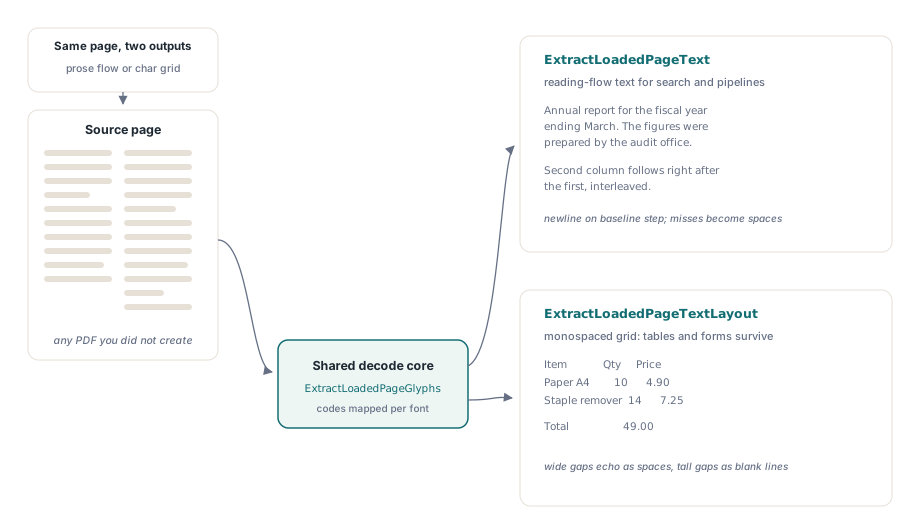
Ambas as chamadas decodificam pela mesma maquinaria, então escolher uma não custa nada em fidelidade. O que a grade não faz é refluir prosa: um artigo de duas colunas sai com as duas colunas lado a lado, fielmente, o que é certo para um diff e errado para um resumidor. Outras duas chamadas cobrem essa lacuna. O ExtractLoadedPageTextColumns(PageIndex, AText, ColumnGapMultiplier) divide cada linha onde quer que o vão entre glifos vizinhos exceda o multiplicador vezes o avanço mediano (3.0 por padrão) e separa as partes com uma tabulação. O ExtractLoadedPageStructureText(PageIndex, AText, UntaggedGlyphCount) caminha pela árvore de estrutura de um PDF taggeado (ISO 32000-1 §14.8.4) e retorna as corridas de marked-content em ordem de autoria; ele retorna False quando a página não tem árvore de estrutura utilizável, e o UntaggedGlyphCount diz quantos glifos ele não conseguiu posicionar
Para texto que uma pessoa ou um modelo de linguagem vai ler, tente a ordem de estrutura primeiro e volte para o ExtractLoadedPageText. A árvore de estrutura é a única ordenação que o autor declarou de propósito, e todo método geométrico é um chute em comparação. Mantenha a grade para os trabalhos em que colunas são dados. Extração de texto em ordem de estrutura tem os detalhes de como marked content é casado com a árvore
Como o HotPDF decodifica códigos de caractere para Unicode
O HotPDF Delphi Component resolve cada código de caractere por uma cadeia de fallback ordenada por prioridade, e uma estratégia que não consegue responder entrega o código à seguinte. A CMap /ToUnicode da fonte (ISO 32000-1 §9.10.3) vem primeiro, porque é o único mapeamento que o produtor escreveu especificamente para extração. Depois dela vêm nomes de glifo de um array /Differences de /Encoding, lidos pela Adobe Glyph List; então a própria CMap de /Encoding, incorporada como stream ou nomeada, em que um nome Uni…-UTF16 significa que o código já é UTF-16. Fontes compostas continuam pelas coleções de caracteres da Adobe (Adobe-GB1, Adobe-CNS1, Adobe-Japan1, Adobe-Korea1, Adobe-KR) de CID para Unicode, depois pelo /CIDToGIDMap até a tabela cmap do programa de fonte incorporado, lida em reverso de glifo para Unicode. Fontes simples voltam para as tabelas WinAnsi, MacRoman, Standard e MacExpert e por fim para aquela mesma cmap incorporada. Um código que esgota a cadeia resolve para 0
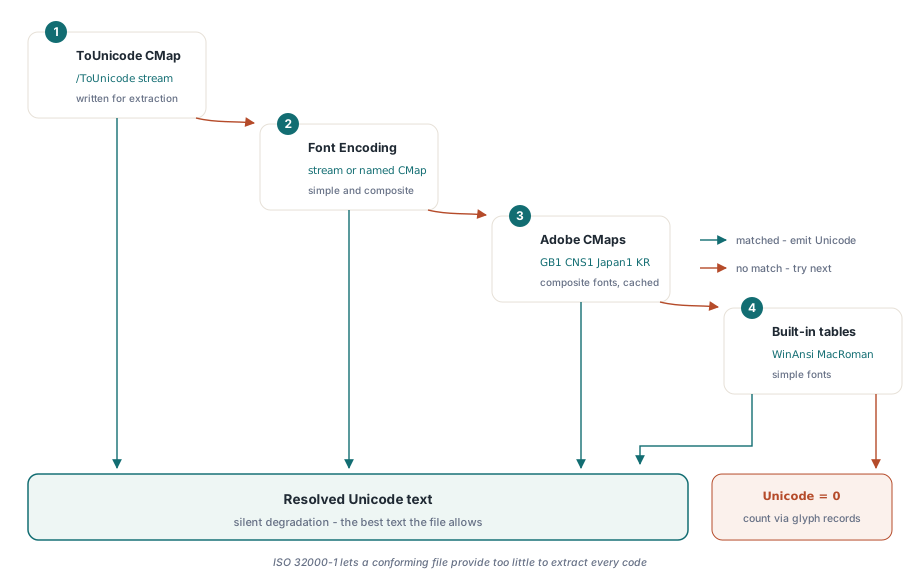
O passo da cmap incorporada é o que resgata muitas fontes subset que vêm sem /ToUnicode: o programa de fonte normalmente ainda contém a própria cmap Unicode dele, e invertê-la recupera a maior parte do texto. É uma reconstrução, porém. Dois caracteres Unicode que compartilham um glifo voltam ambos como o que a cmap listar, então trate o texto recuperado como bom para busca e indexação e o confira antes de usá-lo como registro legal
Os dados das coleções da Adobe vivem em disco. O HotPDF vem com os arquivos CMap e cid2code.txt sob a pasta resources\CMap dele, interpreta cada arquivo no máximo uma vez por processo e faz cache do resultado; só o mapa Adobe-GB1 é cerca de 2 MB de texto que você não quer interpretar por página. As CMaps predefinidas também existem como tabelas embutidas, então uma fonte codificada com uma CMap nomeada como UniGB-UTF16-H ainda decodifica sem a pasta. As tabelas CID-para-Unicode para fontes CJK Identity-H precisam dela. A propriedade CMapResourcePath nomeia a pasta que guarda os subdiretórios de coleção; deixada vazia, o HotPDF procura por resources\CMap ao lado do executável e um ou dois níveis acima dele
Pdf := THotPDF.Create(nil);
try
  // Pasta que contém Adobe-GB1-6, Adobe-CNS1-7, Adobe-Japan1-7 ...
  Pdf.CMapResourcePath := 'C:\MyService\resources\CMap';
  Pdf.LoadFromFile(FileName);
  ...
finally
  Pdf.Free;
end;
Defina o caminho explicitamente em qualquer serviço, módulo ISAPI ou DLL de plugin. Nesses hospedeiros o ParamStr(0) nomeia o processo hospedeiro, que raramente é a pasta para a qual você fez deploy, e uma pasta ausente não levanta exceção; páginas CJK simplesmente voltam com lacunas onde as tabelas de coleção teriam preenchido. Shaping de texto de scripts complexos com o HotPDF encontra a mesma divisão código-versus-glifo na hora de escrever
Duas armadilhas de sintaxe de CMap
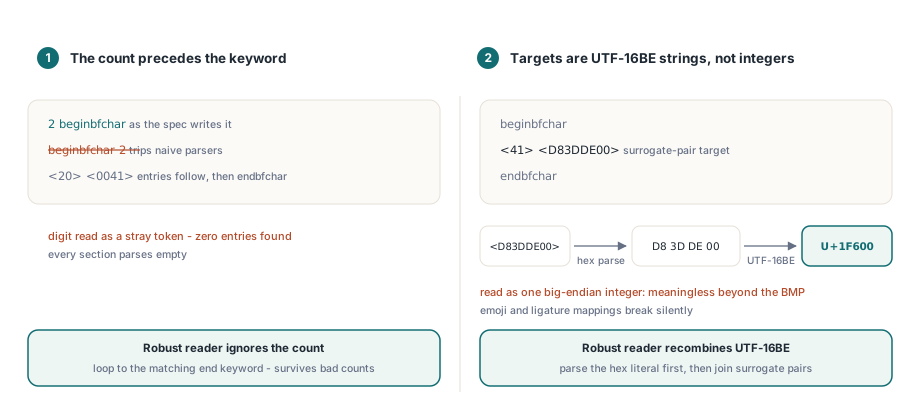
Arquivos CMap parecem trivialmente interpretáveis, e dois detalhes derrubam a maior parte das primeiras tentativas. A contagem de records vem antes da palavra-chave de seção: uma seção lê 2 beginbfchar, nunca beginbfchar 2. Um parser que espera a contagem depois da palavra-chave engole o número como um token perdido e então encontra zero entradas em cada seção. O leitor do HotPDF ignora a contagem por inteiro e faz loop até o endbfchar ou endbfrange correspondente, o que também lida com arquivos reais cujas contagens declaradas estão erradas
A segunda armadilha é que os alvos de bfchar e bfrange são strings UTF-16BE. O destino <D83DDE00> significa U+1F600, um par surrogate que precisa ser recombinado em um code point, e ler aqueles quatro bytes como um inteiro big-endian produz um valor sem sentido para todo caractere fora do Basic Multilingual Plane, emoji incluídos. O HotPDF interpreta o literal hexadecimal para bytes crus primeiro e então recombina unidades de código UTF-16BE, o que também trata os alvos de múltiplos caracteres que mapeamentos de ligadura produzem, como um glifo fi mapeando para duas letras
Contando glifos não resolvidos com ExtractLoadedPageGlyphs
O ExtractLoadedPageGlyphs(PageIndex, AGlyphs) expõe os records de glifo por baixo das chamadas de texto como um THPDFGlyphArray. Cada THPDFGlyphRecord carrega o Code bruto, o CodeByteWidth dele (1, 2 ou 4, decidido pelo codespacerange da CMap), o code point Unicode resolvido mais um UnicodeSequence para ligaduras, o FontKey e o FontSize ativos, a origem X e Y em espaço de usuário, o Advance, um quad de glifo de quatro cantos, e GlyphEndX / GlyphEndY, o fim da própria largura do glifo de onde a regra de espaço entre palavras mede. É o suficiente para highlighting posicionado ou um algoritmo de layout seu
var
  Glyphs: THPDFGlyphArray;
  I, Unresolved: Integer;
begin
  if Pdf.ExtractLoadedPageGlyphs(0, Glyphs) then
  begin
    Unresolved := 0;
    for I := 0 to High(Glyphs) do
      if Glyphs[I].Unicode = 0 then
        Inc(Unresolved);
    if Unresolved > 0 then
      ShowMessageFmt('%d of %d glyphs have no Unicode mapping',
        [Unresolved, Length(Glyphs)]);
  end;
end;
Contar records Unicode = 0 é o jeito honesto de julgar um documento antes de confiar no texto dele downstream. Espere a contagem diferir um pouco do que as chamadas de texto veem. Esta chamada retorna todo glifo no content stream da própria página, incluindo os fora do crop box e os duplicados pintados para fake bold, e não desce para Form XObjects. Cada record também guarda TokenIndex, ItemIndex e ByteOffset, que amarram o caractere de volta ao operando de origem dele; busca e substituição em um PDF existente é construído sobre esses três campos
Alguns arquivos não têm texto para dar. Uma página escaneada é uma imagem grande sem operadores de texto, então a extração corretamente retorna uma string vazia, e o caminho à frente é OCR, começando por extrair as imagens da página do PDF carregado. Documentos criptografados extraem normalmente uma vez abertos com LoadFromFile(FileName, Password), porque os streams são descriptografados antes de o interpretador lê-los. Streams de fonte e de conteúdo são decodificados pela mesma cadeia de filtros do resto do documento carregado, e um stream /ToUnicode que não pode ser decodificado cai para a estratégia seguinte enquanto o resto da página ainda extrai. O mesmo leitor de objetos sustenta editar metadata em documentos carregados, então uma passada de intake pode ler texto e corrigir metadata
Extração em ordem de leitura, grade, colunas e ordem de estrutura, mais acesso de nível de glifo, todos vêm no HotPDF Delphi Component para Delphi e C++Builder como Object Pascal puro sem DLLs externas ou serviços de texto do sistema operacional, então quando um arquivo estranho cai na sua fila você pode entrar no decodificador e ver qual estratégia respondeu por cada código