A caixa de buscar de um visualizador destaca "Acme Corp" na página 2 de uma fatura, mas uma busca por bytes no stream de página descomprimido pelos mesmos nove caracteres volta vazia. Só para a primeira palavra, o stream pode guardar algo como <0024004600500048> Tj: códigos de glifo de dois bytes numa fonte subset embutida, com o vão entre as duas palavras produzido por um offset de posicionamento em vez de um caractere de espaço. Substituir esse nome significa decodificar esses códigos para Unicode, casar ali, voltar até os bytes exatos que produziram o acerto e escrever códigos novos que a mesma fonte entenda. Quando o subset nunca conteve um glifo de que o texto novo precisa, não há códigos a escrever
Os pedidos por trás disso são manutenção comum de documentos. Uma empresa muda de nome e três mil faturas arquivadas ainda carregam o nome antigo. Um template de contrato saiu com a data de validade do ano passado. Um número de peça aposentado precisa virar o sucessor dele em todo datasheet. Num processador de texto cada um disso leva trinta segundos; num PDF cada um esbarra no modo como as páginas são de fato guardadas
O que uma página de PDF guarda em vez de texto
Uma página de PDF guarda glifos posicionados, não texto editável. Sob a ISO 32000-1 §9.4, o content stream comanda operadores de exibição de texto como Tj e TJ, que pintam sequências de códigos de caractere nas posições definidas pela matriz de texto. Esses códigos são índices para a codificação que a fonte corrente declarar. O caminho de volta a caracteres legíveis pode passar por um CMap /ToUnicode (§9.10.3), um /Encoding com array /Differences, ou uma cadeia de mapeamento CID para fontes Type0. Não existe objeto de parágrafo nem fluxo de texto, e nada obriga um produtor a guardar uma palavra visível como uma string: [(Ac) -12 (me)] TJ é um jeito perfeitamente comum de aplicar kerning a uma palavra
A substituição acrescenta um segundo requisito sobre a decodificação. Um extrator de texto pode jogar fora as posições de bytes depois de tirar o Unicode. Um substituidor precisa delas, porque precisa saber quais bytes de qual operando de string produziram cada glifo, para poder reescrever exatamente aquele intervalo e deixar todo o resto em paz. É por isso que um StringReplace comum sobre os bytes do stream é a ferramenta errada mesmo em arquivos que por acaso usam codificação WinAnsi. Ele não faz ideia de qual ( pertence a uma string e qual Tf seleciona a fonte que dá àqueles bytes o significado deles
Buscando na sequência de glifos decodificada
O HotPDF Delphi Component busca num documento carregado com SearchLoadedPageText e SearchLoadedDocumentText, que casam a agulha contra a sequência de glifos Unicode decodificada de cada página, nunca contra bytes brutos do stream. Um acerto, portanto, é um acerto seja como for que a fonte o tenha codificado. Durante a decodificação, todo glifo guarda um registro do operando de string, do item do array TJ e do offset de bytes de onde veio, que é no que o passo de substituição se apoia depois. O mesmo interpretador de glifos comanda a API coberta em extrair texto de um PDF carregado no Delphi; a busca simplesmente guarda as posições de origem que a extração descarta
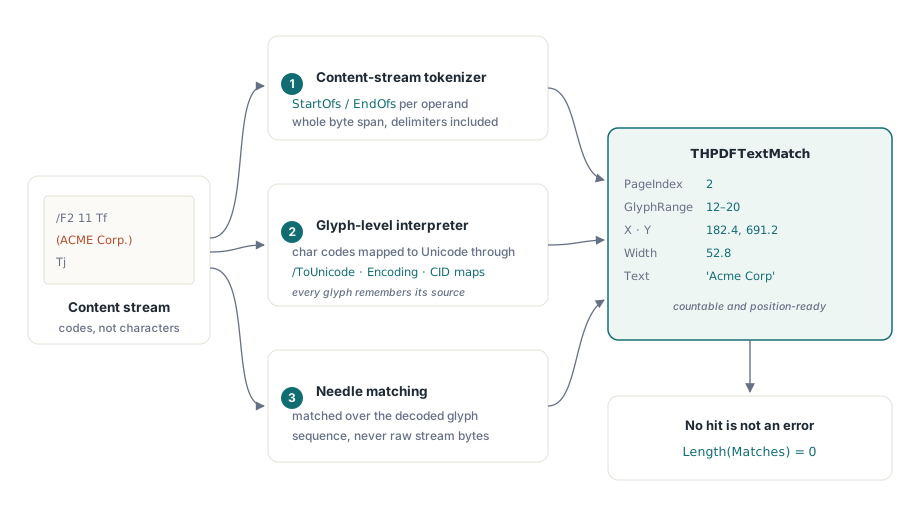
Cada acerto volta como um registro THPDFTextMatch: PageIndex, o intervalo de glifos inclusivo em GlyphStart e GlyphEnd, a origem em user space em X e Y, o Width do acerto, o TokenIndex e o ItemIndex de origem, e o Text casado. PageIndex é zero-based. Uma agulha que não ocorre devolve um array vazio e um resultado True, então o código chamador não precisa de caso especial para "nada encontrado"
var
  Pdf: THotPDF;
  Matches: THPDFTextMatchArray;
  I: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoices-2025.pdf') > 0 then
      if Pdf.SearchLoadedDocumentText('Acme Corp', False, Matches) then
        for I := 0 to High(Matches) do
          WriteLn(Format('page %d at (%.1f, %.1f), width %.1f: "%s"',
            [Matches[I].PageIndex + 1, Matches[I].X, Matches[I].Y,
             Matches[I].Width, Matches[I].Text]));
  finally
    Pdf.Free;
  end;
end;
Se aquele loop imprime alguma coisa depende, antes de qualquer outra coisa, de espaços. O texto de busca é construído a partir dos glifos que a página realmente pinta, um caractere por glifo, e um offset de TJ que separa visualmente duas palavras é um número num array em vez de um glifo. Um produtor que define vãos de palavra com offsets em vez de um caractere de espaço rende "AcmeCorp" na sequência de glifos, e a agulha "Acme Corp" não vai casar com isso. Quando uma frase visível se recusa a casar, busque primeiro a palavra única mais longa dela e olhe o Text do que voltar
Maiúsculas e minúsculas são a outra coisa a conferir. Com CaseSensitive em False, builds do Delphi XE2 em diante comparam caracteres pelo mapeamento Unicode simple lowercase, que é independente de locale, então É casa com é e maiúsculas gregas ou cirílicas casam com as formas minúsculas delas. Builds com compiladores mais velhos dobram apenas A–Z. O mapeamento é de um caractere para um caractere, o que mantém cada posição da agulha alinhada com exatamente um glifo; a consequência é que ß não casa com SS. Para fluxos de UI de palavra inteira, SearchLoadedPageTextWholeWord derruba acertos que sentam dentro de uma palavra mais longa, e GetLoadedSearchHitRect transforma um acerto num único retângulo para desenhar um realce
Busca e substituição trabalham nos streams /Contents da própria página. Texto pintado dentro de um Form XObject, que é onde muitas ferramentas põem cabeçalhos e rodapés carimbados, mora num stream separado que a página invoca com Do, e fica fora das duas operações
Reescrevendo bytes casados com ReplaceLoadedDocumentText
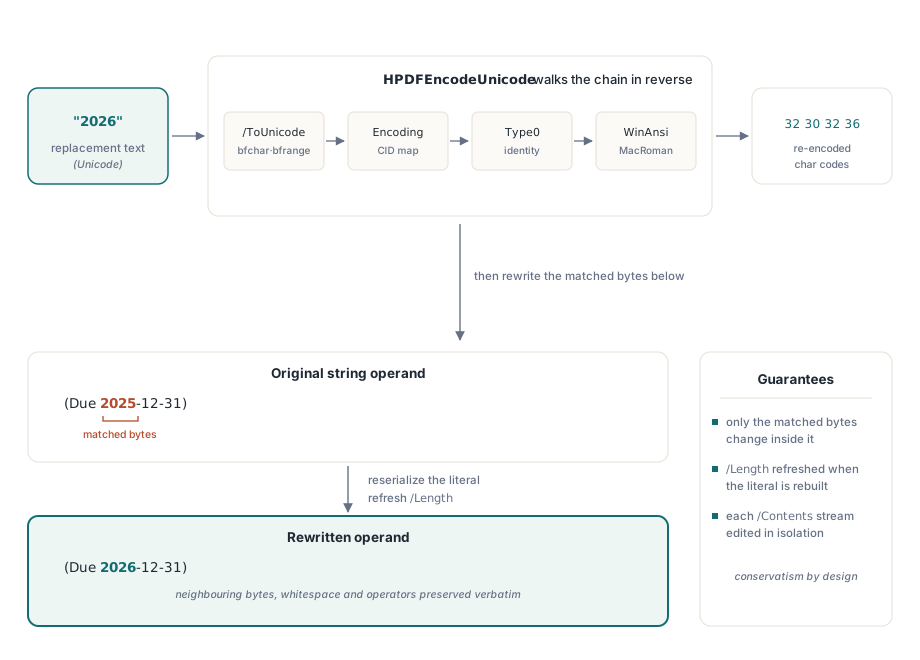
ReplaceLoadedPageText e ReplaceLoadedDocumentText reescrevem toda ocorrência de uma agulha rodando a decodificação de fonte ao contrário. Cada caractere de substituição é consultado pela mesma cadeia que o decodificador usa, em sentido reverso: entradas bfchar e bfrange do /ToUnicode, mapeamentos CID para fontes Type0, mapeamentos de identidade e as tabelas predefinidas WinAnsi e MacRoman. Os códigos de caractere resultantes são escritos de volta como string literal, ou como string hex quando algum byte cai fora do ASCII imprimível, seguindo as mesmas regras de escape que o parser de content stream lê
Só os bytes cobertos pelo acerto mudam. Bytes não casados no mesmo operando, o espaço em branco entre tokens, comentários e todo operador em volta passam intocados. Substituir bca dentro de abcabc rende a + substituição + bc. A substituição pode ser mais curta ou mais longa que a agulha, e cada stream do array /Contents de uma página é processado por conta própria para que a página continue bem-formada. Quando um acerto cavalga vários operandos de string, como Hello guardado como [(He) -20 (llo)] TJ, a substituição é escrita no operando em que o acerto começa e os bytes casados são removidos dos operandos seguintes
var
  Pdf: THotPDF;
  Rewrites: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('contract-draft.pdf') > 0 then
    begin
      if Pdf.ReplaceLoadedDocumentText('2025-12-31', '2026-12-31',
        True, Rewrites) then
        WriteLn(Format('%d operand rewrites', [Rewrites]));
      Pdf.SaveLoadedDocument('contract-final.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
A página não é repaginada. O PDF não tem reflow, então uma substituição mais larga que o original simplesmente toma mais espaço horizontal e pode esbarrar no que quer que tenha sido pintado à direita dela; a posição do próximo glifo foi fixada pelo produtor e não se move. Datas, strings de versão, números de peça e correções ortográficas de comprimento parecido são o trabalho para o qual este método foi feito. Redigir um parágrafo exigiria repaginar tudo a jusante, então essa mudança pertence ao documento de origem
Por que um subset de fonte não pode receber caracteres que nunca conteve?
Um caractere de substituição que o subset embutido nunca incluiu não tem código de caractere para o qual reverter. Quando um produtor cria um subset de uma fonte, o CMap /ToUnicode e a codificação dele cobrem apenas os glifos que o documento original usou, e os contornos de glifo de todo o resto simplesmente não estão no arquivo. Se o documento nunca imprimiu um E maiúsculo naquela fonte, nenhuma sequência de bytes seleciona um. Essa limitação senta no arquivo, não na ferramenta que faz a substituição
ReplaceLoadedDocumentText trata uma substituição não codificável de forma conservadora: se qualquer caractere único não puder ser recodificado, aquela ocorrência é pulada por inteiro. Não há exceção nem string meio substituída, e o texto original continua legível. No exemplo da data acima, o dígito 6 precisa existir em algum lugar daquela mesma fonte para a reescrita ter sucesso. Suponha que a fonte só imprimiu "2025" e alguns totais de pedido sem nenhum 6: as datas ficam como estão
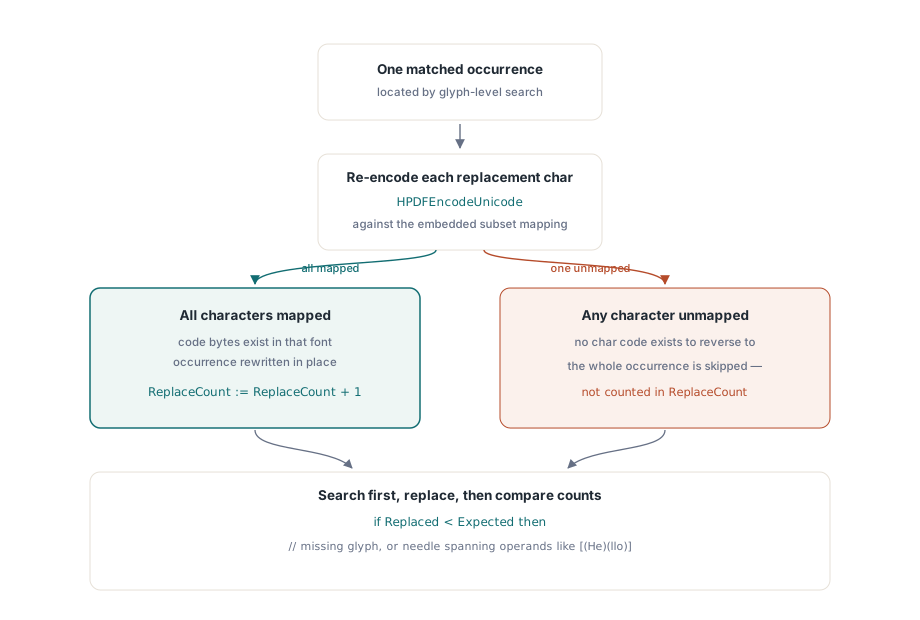
ReplaceCount reporta reescritas de operandos, e um acerto espalhado por vários operandos pode responder por mais de uma reescrita. Uma contagem menor que o número de acertos ainda significa que algo foi pulado, mas a resposta exata vem de buscar de novo depois da substituição. O que a segunda busca achar é o que ficou para trás, com página e posição anexadas
procedure ReplaceAndAudit(Pdf: THotPDF; const OldText, NewText: UnicodeString);
var
  Before, After: THPDFTextMatchArray;
  Rewrites, I: Integer;
begin
  // Pesquisar de novo só funciona quando o NewText não contém o próprio OldText
  Pdf.SearchLoadedDocumentText(OldText, True, Before);
  Pdf.ReplaceLoadedDocumentText(OldText, NewText, True, Rewrites);
  Pdf.SearchLoadedDocumentText(OldText, True, After);
  WriteLn(Format('%d found, %d operand rewrites, %d left',
    [Length(Before), Rewrites, Length(After)]));
  for I := 0 to High(After) do
    WriteLn(Format('  left on page %d at (%.1f, %.1f)',
      [After[I].PageIndex + 1, After[I].X, After[I].Y]));
end;
Quando o subset é curto: pré-visualizar e aplicar com uma fonte nova
Para ocorrências que o método a nível de bytes não consegue codificar, PreviewLoadedPageTextReplacement e ApplyLoadedPageTextReplacement tomam outra rota: removem os glifos casados e desenham a substituição no lugar com uma fonte que você escolher, no tamanho original e sobre a baseline original. O THPDFLoadedTextReplacementOptions padrão usa Arial no tamanho de fonte do texto casado, dimensiona a caixa pela largura do texto casado e mantém Atomic ligado. Um único acerto rejeitado na página então desfaz os outros. A pré-visualização devolve um plano com um resultado por acerto, cada um carregando um Status e, quando rejeitado, um Reason
var
  Opts: THPDFLoadedTextReplacementOptions;
  Plan, Applied: THPDFLoadedTextReplacementPlan;
  I: Integer;
begin
  // Pdf é um THotPDF carregado; PageIndex é uma página zero-based que a auditoria marcou
  Opts := THPDFLoadedTextReplacementOptions.Default;
  Opts.Appearance.FontName := 'Arial';
  Opts.Appearance.OverflowPolicy := ltopShrinkToFit;
  Opts.Appearance.MinFontSize := 6;
  if not Pdf.PreviewLoadedPageTextReplacement(PageIndex, 'Acme Corp',
    'Apex Corporation', True, Opts, Plan) then
    for I := 0 to High(Plan.Results) do
      if Plan.Results[I].Status = ltrsRejected then
        WriteLn(Format('match %d at (%.1f, %.1f): %s',
          [I, Plan.Results[I].X, Plan.Results[I].Y, Plan.Results[I].Reason]));
  if (Plan.RejectedCount = 0) and (Plan.ReadyCount > 0) then
  begin
    Pdf.ApplyLoadedPageTextReplacement(Plan, Applied);
    WriteLn(Format('%d of %d matches applied',
      [Applied.AppliedCount, Applied.MatchedCount]));
  end;
end;
Os motivos de rejeição valem ser impressos porque eles mapeiam direto para a geometria da página. Um acerto que atravessa de uma linha de texto para a próxima é rejeitado, e texto vertical também. Com a política de overflow padrão ltopReject, uma substituição que não caiba na largura casada também é rejeitada. ltopShrinkToFit reduz o tamanho em direção a MinFontSize em vez disso, que é por que o exemplo o define para uma substituição cinco caracteres mais longa que a agulha. Uma substituição contendo caracteres que a fonte escolhida não consegue mostrar também é rejeitada
O plano carrega uma impressão digital do conteúdo e das fontes da página. Se qualquer coisa mudar a página entre a pré-visualização e a aplicação, ApplyLoadedPageTextReplacement lança EInvalidOpException em vez de escrever numa página que a pré-visualização nunca viu. Páginas com pares q/Q ou BT/ET desbalanceados, e documentos que contêm campos de assinatura, lançam EArgumentException; documentos assinados pedem atualizações incrementais para que a revisão assinada permaneça intacta
A substituição a nível de bytes vai primeiro, e o caminho de troca de fonte roda só nas páginas em que a auditoria ainda acha o texto antigo. A reescrita a nível de bytes mantém a fonte original, as métricas e o kerning dela, então o texto editado casa com os vizinhos na linha. O caminho de pré-visualização desenha num tipo de letra diferente, e numa linha composta numa fonte condensada ou serifada um leitor atento verá a mudança. Quando o objetivo é fazer texto desaparecer em vez de reescrevê-lo, remoção de conteúdo de verdade é a ferramenta melhor; redigir e reestruturar PDFs carregados no Delphi cobre esse caminho
O que muda no arquivo salvo
Um content stream editado por ReplaceLoadedPageText é salvo descomprimido. O stream é decodificado para edição, e quando os bytes reconstruídos são escritos de volta as entradas /Filter e /DecodeParms dele são descartadas e o /Length é atualizado. O PDF é válido e renderiza normalmente; o custo é um arquivo maior para todo stream editado. Um job em lote sobre milhares de faturas deve orçar esse crescimento ou rodar uma passada de compressão depois
O caminho de pré-visualizar e aplicar muda um pouco mais. Uma página aplicada recebe um único content stream novo descomprimido no lugar do /Contents original, mais a própria cópia dela do dicionário de recursos com a fonte de substituição acrescentada. Todo o resto do documento fica em paz: streams intocados mantêm a compressão deles, fontes e imagens existentes não são reescritas, e páginas sem acertos nunca são abertas para escrita. Como objetos reescritos aterrissam na estrutura de referência cruzada no save está coberto em object streams e atualizações incrementais no HotPDF
Busca, substituição a nível de bytes, substituição com pré-visualização e aplicação, extração e redação correm todos no mesmo interpretador de content stream, do Delphi 5 até o RAD Studio atual, sem dependências externas. Referências de métodos, as opções de substituição e uma build de avaliação estão na página de produto do HotPDF Delphi Component