O fragmento de content stream [(Reference)-333(Manual)] TJ pinta duas palavras com um vão claro entre elas, mas não contém caractere de espaço nenhum. O vão é movimento da caneta: a ISO 32000-1 §9.4.3 manda o leitor deslocar o próximo glyph para a direita em 333 milésimos do tamanho da fonte antes de desenhar Manual. Um extrator que copia caracteres e ignora geometria retorna ReferenceManual, e um índice de busca alimentado por ele nunca vai casar com a frase “Reference Manual”. Saída de TeX, muitos arquivos do Distiller e a maior parte dos layouts justificados separa palavras assim
Quebras de linha dão errado pelo outro lado. Um sobrescrito elevado parte a linha em dois, uma marca d’água DRAFT diagonal chega um caractere por linha, e uma prova aparada começa com a linha de slug da impressora que nenhum visualizador exibe. Nenhum desses arquivos está quebrado. Cada um usa uma forma legal de posicionar texto que um extrator copiador de caracteres lê errado
Espaços de palavra reconstruídos da geometria dos glyphs
O THotPDF.ExtractLoadedPageText no HotPDF Delphi Component decide quebras de palavra a partir das posições dos glyphs, e um caractere de espaço no stream é apenas um dos sinais que ele lê. Na direção de escrita do glyph anterior ele mede a distância do fim da própria largura desse glyph à origem do glyph atual, e insere um espaço quando a distância excede 0.15 da altura do box do glyph atual, medida do ascent ao descent no user space. Para o fragmento TJ acima, um terço de um em fica confortavelmente além dessa linha para qualquer face de texto comum, então o texto da página lê Reference Manual
Duas condições seguram o espaço. Nada é adicionado quando o texto até então já termina em branco ou o próximo glyph é um (espaço, tab, espaço sem quebra, espaço ideográfico), então produtores que exibem espaços nunca recebem espaços dobrados. Nada é adicionado entre dois caracteres CJK também. Ideogramas, kana, hangul e formas full-width contam todos, porque a justificação estica uma linha chinesa ou japonesa sem esse esticamento significar uma quebra de palavra. Separadamente de ambos, um box de glyph com altura zero cai para o tamanho do Tf como sua altura. Todo número que a regra usa fica armazenado nos records de glyph, então um arquivo cujo espaçamento parece errado pode ser reproduzido glyph por glyph
uses
  SysUtils, HPDFDoc, HPDFContentStream;

// Imprime os vãos que o ExtractLoadedPageText transformaria em espaços.
// Apenas texto horizontal; o ExtractLoadedPageGlyphs retorna o
// content stream sem texto de Form XObject e sem o filtro de crop
procedure DumpWordGaps(Pdf: THotPDF; PageIndex: Integer);
var
  Glyphs: THPDFGlyphArray;
  I: Integer;
  Height, Gap: Double;
begin
  if not Pdf.ExtractLoadedPageGlyphs(PageIndex, Glyphs) then
    Exit;
  for I := 1 to High(Glyphs) do
  begin
    if Glyphs[I].Vertical or Glyphs[I - 1].Vertical then
      Continue;
    // altura de ascent a descent do box do glyph, no user space
    Height := Sqrt(Sqr(Glyphs[I].QuadX[3] - Glyphs[I].QuadX[0]) +
      Sqr(Glyphs[I].QuadY[3] - Glyphs[I].QuadY[0]));
    if Height <= 0 then
      Height := Abs(Glyphs[I].FontSize);
    // vão do fim da própria largura do glyph anterior
    Gap := Glyphs[I].BaselineStartX - Glyphs[I - 1].GlyphEndX;
    if (Height > 0) and (Gap > 0.15 * Height) then
      Writeln(Format('U+%.4x gap %.2f height %.2f: space',
        [Glyphs[I].Unicode, Gap, Height]));
  end;
end;
Por que medir da própria largura do glyph em vez da posição da caneta?
Porque a posição da caneta depois de um glyph já contém espaçamento que não tem nada a ver com quebras de palavra. A ISO 32000-1 §9.4.4 define o deslocamento horizontal como a largura do glyph vezes o tamanho da fonte, mais character spacing Tc, mais word spacing Tw, tudo escalado pelo horizontal scaling Tz. Cada record de glyph carrega as duas pontas: BaselineEndX / BaselineEndY guardam esse deslocamento completo, enquanto GlyphEndX / GlyphEndY guardam apenas o avanço da fonte no tamanho atual e o Tz. Os dois divergem em arquivos que apertam o tracking com um Tc negativo e devolvem o espaço por um ajuste TJ depois de cada glyph. Medido pela caneta, cada devolução parece um vão, e um termo chinês como “95后” sai como “9 5 后”. Medido da própria largura do glyph, o ajuste só devolve o que o Tc levou, e o termo permanece intacto
O limiar está amarrado à altura do box do glyph em vez do tamanho do Tf por uma razão parecida. Exportações do Word frequentemente gravam 1 Tf e carregam o tamanho real em um Tm escalado, então o operando de tamanho da fonte lê 1 enquanto o texto tem 10 pontos de altura. Uma regra presa a esse operador colocaria o limiar em 0.15 ponto nessa página, e pares de kerning comuns começariam a ler como quebras de palavra. A altura do box é medida depois de cada matriz aplicada, então 1 Tf com matriz escalada e um 10 Tf simples produzem o mesmo texto
Dois casos de borda saem direto da geometria. Um título composto com espaçamento de letras bem largo, em que o Tc sozinho abre mais de 0.15 da altura do texto entre letras, é extraído como S P A C E D. É o que a página mostra, e preferimos devolvê-lo a adicionar uma heurística que adivinha quais vãos largos são tracking e quais são palavras; um chute desse tipo começa a engolir quebras de palavra reais em colunas justificadas apertadas, o que é uma falha pior para busca. Peças desenhadas fora de ordem em uma mesma baseline produzem um vão negativo e se juntam sem espaço. Em texto corrido esse caso é raro
Quando uma nova linha começa no texto extraído?
O ExtractLoadedPageText começa uma nova linha quando o movimento da origem do glyph anterior à do atual, projetado na normal da direção de escrita anterior, excede metade da maior altura de box dos dois glyphs. Movimento ao longo da baseline nunca conta para quebra de linha, por mais que a caneta salte
Uma regra que compara o movimento Y cru com metade do tamanho do Tf falha em duas direções. Com 1 Tf e um Tm escalado o limiar encolhe para meia unidade, então um sobrescrito elevado por um text rise de 0.4 quebra a linha. Também quebra o pequeno jitter de baseline que alguns motores de layout deixam entre runs. A mesma regra ignora o X por completo. Texto sob um Tm rotacionado, como aquela marca d’água diagonal, desce a página a cada glyph e sai um caractere por linha, enquanto a projeção trata um trecho a 45 graus exatamente como um horizontal
Tomar a maior das duas alturas importa quando tamanhos se misturam em uma linha. Uma palavra de display de 36 pontos seguida por uma legenda de 8 pontos alguns pontos abaixo é julgada contra metade da altura do glyph grande, então o par fica junto; julgada contra o glyph pequeno sozinho, a legenda cairia em uma linha própria. O text rise faz parte da origem do glyph, que é por que a baseline elevada de um sobrescrito é medida contra essa mesma metade de altura
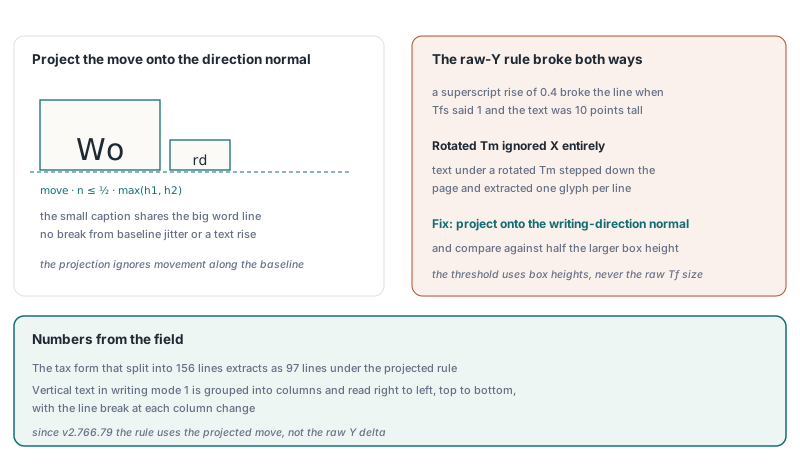
Texto vertical em writing mode 1 (§9.7.4.3) segue um caminho separado. Esses glyphs são agrupados em colunas pelo X da origem, com metade do tamanho da fonte como tolerância de coluna, então lidos da direita para a esquerda e de cima para baixo, com uma quebra de linha a cada troca de coluna. Uma página que mistura um corpo japonês vertical com um cabeçalho corrido horizontal também recebe uma quebra de linha a cada troca entre as duas direções
Quais glyphs entram no texto da página
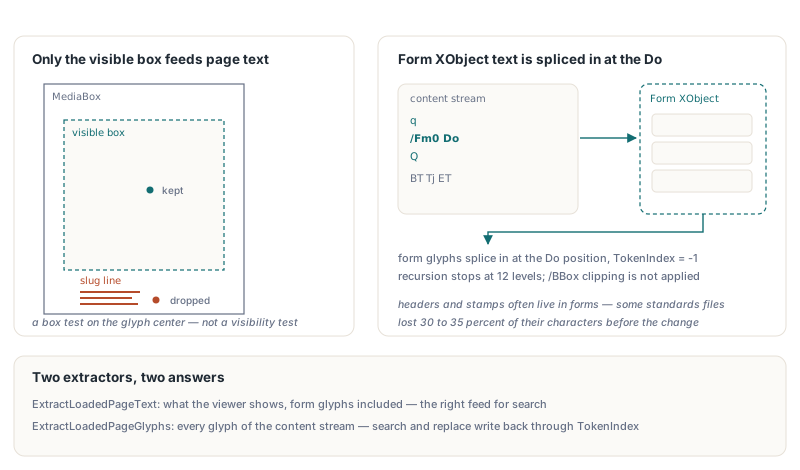
O ExtractLoadedPageText retorna o texto que um visualizador mostra. Ele mantém apenas os glyphs cujo centro do box cai dentro do GetLoadedPageVisibleBox, que é a CropBox recortada pela MediaBox (§14.11.2), então linhas de slug e outras marcas de impressora postas como texto fora da área de corte saem fora. O ExtractLoadedPageGlyphs continua retornando todo glyph do content stream da página, linha de slug incluída, para os jobs que precisam dela. O filtro é um teste geométrico em um ponto por glyph. Texto escondido por um clipping path, pintado de branco ou coberto por uma imagem ainda sai, porque decidir visibilidade real significaria renderizar a página
uses
  SysUtils, HPDFDoc, HPDFContentStream;

var
  Pdf: THotPDF;
  Raw, Merged: THPDFGlyphArray;
  PageText: UnicodeString;
  L, B, R, T: Single;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('trimmed-proof.pdf');
    if Pdf.GetLoadedPageVisibleBox(0, L, B, R, T) then
      Writeln(Format('Visible box: %.1f %.1f %.1f %.1f', [L, B, R, T]));
    // todo glyph do content stream da página, linha de slug incluída
    if Pdf.ExtractLoadedPageGlyphs(0, Raw) then
      Writeln(Length(Raw), ' glyphs in the page content stream');
    // stream da página mais texto de Form XObject, em ordem de pintura, antes do crop
    if Pdf.ExtractLoadedPageGlyphsWithForms(0, Merged) then
      Writeln(Length(Merged), ' glyphs including forms');
    // o que a página mostra: formas emendadas, glyphs fora do crop descartados
    if Pdf.ExtractLoadedPageText(0, PageText) then
      Writeln(PageText);
    // as mesmas regras de espaçamento aplicadas ao stream sem filtro, para um diff
    Writeln(HPDFAssemblePageText(Raw));
  finally
    Pdf.Free;
  end;
end.
Texto pintado por meio de Form XObjects faz parte do texto da página. Cabeçalhos, carimbos e marcas d’água muito frequentemente vivem em formas, e um extrator que lê apenas o content stream da página nunca os vê. O HotPDF registra cada Do junto com o CTM em vigor, interpreta a forma no /Matrix dela vezes esse CTM (§8.10.1), e emenda os glyphs da forma na posição do Do, recursando em formas aninhadas. Uma forma sem /Resources próprio pega emprestado os do stream que a pinta, o arranjo mais antigo que a §7.8.3 descreve. Glyphs cujo centro cai fora do /BBox da forma ficam de fora, já que esse box recorta a forma quando ela é pintada. Uma forma que pinta a si mesma, direta ou por meio de outra forma, não é entrada uma segunda vez, e o aninhamento para em 12 níveis
Glyphs de forma carregam TokenIndex = -1 e ItemIndex = -1. A mesma razão mantém o ExtractLoadedPageGlyphs limitado a glyphs do stream da página: busca, substituição e redação gravam suas mudanças de volta pelo TokenIndex, e um glyph de forma nesse array apontaria para bytes em um stream diferente. Quando você precisa da lista mesclada em nível de glyph, o ExtractLoadedPageGlyphsWithForms a retorna em ordem de pintura, antes de o filtro de visible box rodar
Mais uma passada roda antes das regras de espaçamento. Logos sobreimpressos e negrito falso feitos pintando o mesmo texto duas vezes com um pequeno offset, de outra forma, seriam extraídos com toda letra dobrada. Quando um glyph pinta o mesmo caractere no mesmo tamanho dentro de um décimo desse tamanho ao longo da baseline, e um quinto através dela, de um glyph anterior, apenas uma cópia é mantida; espaços nunca são removidos assim. O artigo sobre negrito falso e glyphs duplicados na extração de texto percorre esse caso
Estado de texto através de q e Q
Texto depois de um Q decodifica errado em qualquer extrator que salva apenas o CTM no q. Os parâmetros de estado de texto, ou seja, fonte, tamanho, Tc, Tw, Tz, TL, modo de renderização e rise, pertencem ao estado gráfico (§9.3.1), então o Q precisa restaurá-los junto com todo o resto da pilha (§8.4.2). Um padrão expõe o erro rápido: uma fonte de dois bytes Identity-H é selecionada dentro de q … Q para uma única célula de tabela, e o texto depois do Q mostra strings WinAnsi de um byte sem um Tf próprio. Um interpretador que mantém a fonte interna lê esses bytes em pares, e os pontilhados de um sumário viram uma sequência de caracteres CJK sem relação. O interpretador do HotPDF empilha os oito valores de estado de texto junto com o CTM em cada q e os desempilha em cada Q
Tudo acima se aplica a cada página, então um documento inteiro pode ir para um arquivo UTF-8 em uma chamada. O ExtractLoadedPagesTextToStream recebe um intervalo de páginas com base 1 (uma string vazia significa todas as páginas), um separador gravado entre páginas, e um flag para o byte order mark, e retorna o número de páginas extraídas. A saída é anexada na posição atual do stream, então nada maior que o texto de uma página fica na memória
uses
  SysUtils, Classes, HPDFDoc;

var
  Pdf: THotPDF;
  Output: TFileStream;
  Pages: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('report.pdf');
    Output := TFileStream.Create('report.txt', fmCreate);
    try
      // intervalo vazio = todas as páginas; form feed entre páginas; BOM UTF-8
      Pages := Pdf.ExtractLoadedPagesTextToStream(Output, '', #12, True);
      Writeln(Pages, ' pages extracted');
    finally
      Output.Free;
    end;
  finally
    Pdf.Free;
  end;
end.
Escolhendo a API de texto para o trabalho
Para busca e indexação, o ExtractLoadedPageText é o feed certo: ele segue a ordem do content stream e reflete o que a página mostra. A cadeia de decodificação por baixo dele, dos mapas /ToUnicode a fontes CID, é coberta em extrair texto de PDFs carregados com HotPDF. A ordem do content stream é mais fraca em documentos tagueados cujo produtor gravou o cabeçalho corrido por último ou intercalou duas colunas; para esses, extração de texto em ordem de estrutura percorre a árvore de estrutura em ordem de autoria em vez de inferi-la da geometria. Dados presos em tabelas são melhor servidos por extração de tabelas tipada através de quebras de página, que retorna células com seus valores. Código que edita a página pertence ao ExtractLoadedPageGlyphs, cujos índices de token apontam para os bytes que ele vai reescrever
Os campos do record de glyph usados nesses exemplos, junto com o resto da API de extração de texto e um build de teste, estão documentados na página do produto HotPDF Delphi PDF Component