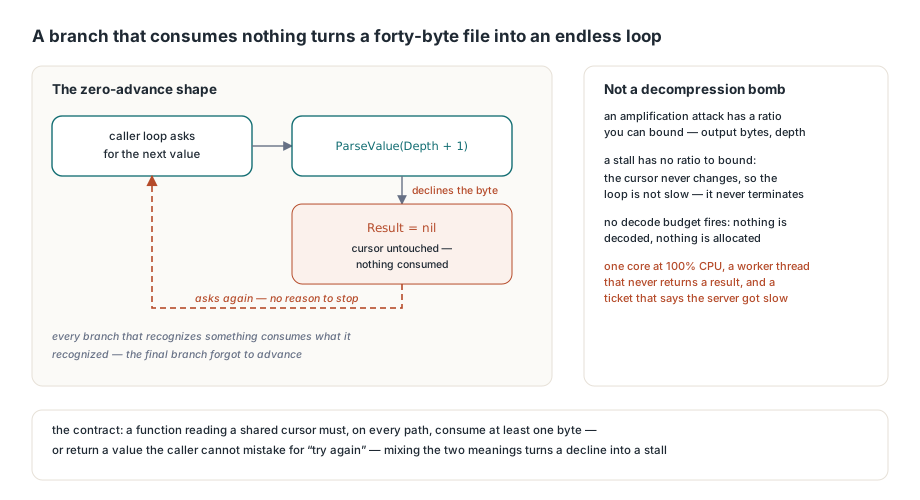
Um parser trava num PDF malformado quando algum ramo lê um byte, se recusa a tratá-lo e retorna sem mover o cursor. O loop do chamador não vê progresso nem motivo para parar, então gira para sempre. A HotPDF embarcou exatamente esse defeito em três parsers independentes, todos alcançáveis por entradas com menos de cinquenta bytes
É uma classe de negação de serviço que merece nome próprio, porque não se parece com aquela que todo mundo já aprendeu a bloquear. Não há descompressão, não há crescimento de alocação, não há pressão de memória que dispare um watchdog. O processo só fica a cem por cento de CPU num único core com um punhado de bytes num buffer. Se você adicionou um orçamento de decode depois de ler sobre amplificação de filtros aninhados e PDF bombs, esse orçamento não vai disparar aqui: nada está sendo decodificado, e nada está sendo alocado. Falha diferente, correção diferente
Por que um arquivo de quarenta bytes custa mais que uma bomba de descompressão?
Porque o custo não tem relação nenhuma com o tamanho da entrada. Um ataque de amplificação tem uma razão que você consegue limitar: cap nos bytes de saída, cap na profundidade de recursão, e o pior caso vira finito. Um loop de avanço zero não tem razão nenhuma para limitar. A condição do loop é função de um cursor que nunca muda, então não é lento, é não-terminante, e nenhum limite baseado em tamanho a montante vai pegá-lo. Isso também o torna operacionalmente desagradável num jeito particular. Uma queda te dá um stack, um out-of-memory te dá uma linha de log, e um parser travado te dá uma thread de trabalho que nunca devolve resultado, uma requisição que nunca estoura porque ninguém a jusante sabe que ela começou, e um ticket dizendo que o servidor ficou lento numa terça-feira. A causa estrutural tem sempre a mesma forma. Um tokenizer ou parser de valores tem uma cadeia de ramos atrelados ao byte atual. Todo ramo que reconhece algo consome o que reconheceu. Aí existe um ramo final, ou uma guarda antes da cadeia, que retorna para os bytes que ninguém reivindicou, e o autor raciocina sobre ele como caminho de erro em vez de passo de varredura. Caminhos de erro retornam. Passos de varredura avançam. Quando uma função precisa ser as duas coisas, é o avanço que fica esquecido
O parser de objetos: dois delimitadores que ninguém consumiu
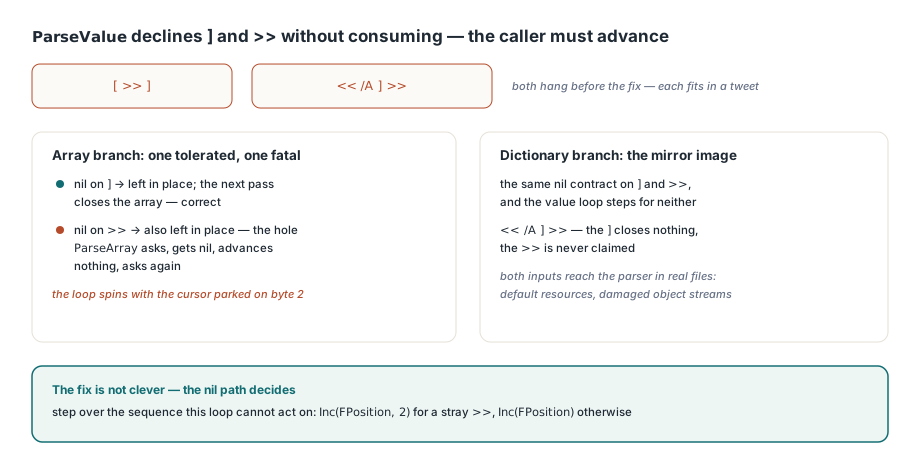
Em HPDFParser, o método THPDFSpanObjectParser.ParseValue começa recusando duas sequências de bytes de cara. Pela seção 7.3 da ISO 32000-1, um valor não pode começar com ] nem com >>, porque isso fecha um contêiner em vez de abrir um valor, então ParseValue retorna nil para ambos sem consumi-los. Esse é o contrato correto, e ele coloca o peso inteiro do avanço nas costas do chamador. O ramo de array honrou metade dele: num resultado nil ele checava ], deixava no lugar para a próxima passagem fechar o array, e pulava todo o resto — exceto que a checagem foi escrita de um jeito que um >> perdido também ficava no lugar. Então [ >> ] trava, porque ParseArray pede um valor, recebe nil, não avança nada, e pede de novo. O ramo de dicionário tinha o buraco espelhado, e << /A ] >> trava do mesmo jeito. As duas entradas são válidas o suficiente para chegar ao parser e curtas o suficiente para caber num tweet
uses
  HPDFObjs, HPDFParser;

procedure ProbeParserStalls;
var
  Stats: THPDFParserViewStatistics;
  Arr: THPDFArrayObject;
  Dict: THPDFDictionaryObject;
begin
  // Antes da correção, nenhuma das duas chamadas abaixo retornava
  Arr := HPDFParserParseSimpleArrayWithStatistics('[ >> ]', Stats);
  Arr.Free;
  WriteLn('array errors=', Stats.ErrorCount, ' valid=', Stats.Valid);

  Dict := HPDFParserParseSimpleDictionaryWithStatistics('<< /A ] >>', Stats);
  Dict.Free;
  WriteLn('dict errors=', Stats.ErrorCount, ' valid=', Stats.Valid);
end;
A correção não é inteligente, e é exatamente esse o ponto: o caminho do nil tem que decidir, explicitamente, qual das duas sequências não consumidas o loop atual consegue tratar, e pular a outra
Value := ParseValue(Depth + 1);
if Value = nil then
begin
  RecordError;
  // ParseValue retorna nil tanto para ']' quanto para '>>' sem consumi-los.
  // O ']' fecha o array na próxima passagem, mas um '>>' perdido
  // dentro de um array precisa ser pulado ou o parse nunca avança
  if (FPosition < FLength) and StartsWithPair('>', '>') then
    Inc(FPosition, 2)
  else if (FPosition < FLength) and (CharAt(FPosition) <> ']') then
    Inc(FPosition);
  Continue;
end;
Mais uma coisa merece atenção aqui. THPDFSpanObjectParser.RecordError só incrementa ErrorCount em THPDFParserViewStatistics; ele não limita nada. O parser define HPDFParserMaximumDepth em 64 para limitar o aninhamento, mas não tem teto equivalente na contagem de erros, e um contador que ninguém lê é um circuit breaker perdido. Mesmo com o avanço restaurado, uma entrada que produz um erro por byte vai mastigar um objeto grande numa velocidade que merece uma saída antecipada em vez de uma varredura completa. Cheque Valid no registro de estatísticas depois de cada parse e trate um ErrorCount grande como motivo para parar de confiar no objeto, não apenas como diagnóstico
A mesma forma no tokenizer de CMap e no leitor de XFDF
HPDFCMapReader.NextToken carregava o defeito idêntico no ramo de fallback. A função retorna um TCMapTok e trata <, ( e / com ramos dedicados; todo o resto cai em "ler até espaço em branco ou delimitador". Quando o byte inicial é ele próprio um delimitador do conjunto da seção 7.2.2 da ISO 32000-1, esse loop roda zero vezes, o token volta vazio, e o chamador pede o mesmo token de novo. Dos seis caracteres que podem cair ali, só o [ era interceptado antes pelo tratamento de bfrange, então um ), >, ], { ou } perdido em qualquer lugar de um CMap ToUnicode bastava para travar a extração de texto
// palavra-chave ou número: ler até espaço em branco ou delimitador
StartP := P;
while (P <= Len) and (not IsCMapWhiteSpace(Text[P]))
  and (not IsCMapDelimiter(Text[P])) do
  Inc(P);
// Um delimitador que nenhum dos ramos acima reivindica (um ')', '>',
// '[', ']', '{' ou '}') deixaria P onde estava e retornaria uma
// palavra-chave vazia, então o chamador pediria o mesmo token para sempre
if P = StartP then
  Inc(P);
AKeyword := Copy(Text, StartP, P - StartP);
Result := ctKeyword;
O lado XFDF tinha uma variante com origem diferente e o mesmo efeito. HPDFXFDFXml.ParseElement define Result := P no topo, enquanto P ainda aponta para o < de abertura, e só então incrementa o cursor local, então toda saída antecipada que vem depois retorna a posição de entrada a menos que sobrescreva Result antes. Uma declaração de doctype pela seção 2.8 do XML 1.0, ou qualquer outra coisa sem nome de tag analisável, como <1a>, tomava uma saída que nunca atualizava Result, e o loop de elementos filhos recebia a posição que tinha passado. O loop de atributos tinha mais três desses, porque ReadName, o salto de espaço em branco e o tratamento de = todos recusam um byte que não é caractere de nome, nem espaço, nem um dos =, >, /, e nenhum deles o consumia. O reparo vizinho de CDATA movia uma responsabilidade em vez de adicionar uma guarda: uma seção de CDATA pela seção 2.7 do XML 1.0 começa com <, então o loop de filhos costumava entregá-la a ParseElement, que lia um nome de tag do conteúdo da seção. Reconhecê-la no loop de filhos com IsCDATAStart e copiar bytes para o buffer de texto até IsCDATAEnd é a divisão correta, e o salto antigo também era um byte curto, porque o marcador tem oito bytes contados a partir do !
Contagens declaradas que sobrevivem aos dados
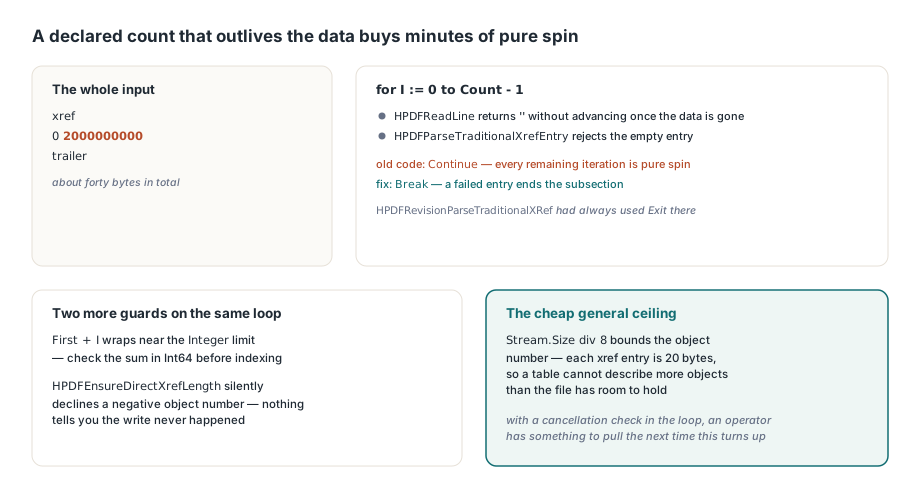
Uma versão posterior expôs o mesmo padrão pela direção oposta, e é a variante com mais chance de existir no seu próprio código. O cabeçalho de uma subseção de cross-reference pela seção 7.5.4 da ISO 32000-1 é um par first count, e os dois parsers de xref tradicional da HotPDF faziam loop for I := 0 to Count - 1 sobre ele, usando Continue em vez de Break quando uma entrada falhava ao ser analisada. Isso parece tolerância por uma linha ruim. Não é: HPDFReadLine retorna uma string vazia sem avançar quando os dados acabam, e HPDFParseTraditionalXrefEntry rejeita uma entrada vazia imediatamente, então toda iteração restante da contagem declarada é puro giro. A aritmética é cruel — o cabeçalho xref\n0 2000000000\ntrailer com um wrapper mínimo tem uns quarenta bytes, e compra dezenas de segundos de um core ocupado sem nenhuma checagem de cancelamento no loop. O indício estava na mesma unit, porque HPDFRevisionParseTraditionalXRef sempre usou Exit naquela posição. Quando duas funções analisam a mesma gramática e discordam sobre se uma entrada que falha encerra a subseção, uma delas é um fork que parou de receber correções — a mesma assinatura que aparece no tratamento de cross-reference híbrida, onde uma tabela tradicional e um stream descrevem os mesmos objetos
if not HPDFParseIntegerPair(Line, First, Count) then
  Exit;
for I := 0 to Count - 1 do
begin
  Entry := HPDFReadLine(XrefData, P);
  // Uma contagem declarada maior que a tabela, do contrário, giraria
  // aqui sem sobrar dado para ler
  if not HPDFParseTraditionalXrefEntry(Entry, EntryOffset, GenNum, InUse) then
    Break;
  // First vem do cabeçalho da subseção, então a soma estoura para um
  // início declarado perto do limite de Integer, e o helper de crescimento
  // recusa um índice negativo em silêncio
  if (First < 0) or (Int64(First) + I > MaxInt) then
    Break;
  ObjNumber := First + I;
  if (ObjNumber < 0) or (Int64(ObjNumber) > Stream.Size div 8) then
    Break;
  HPDFEnsureDirectXrefLength(State, ObjNumber);
  // ... registra a entrada ...
end;
Os dois limites depois do Break pertencem ao mesmo reparo. HPDFEnsureDirectXrefLength se recusa a crescer o array para um número de objeto negativo e não diz nada sobre isso, e First + I estoura para um início declarado perto do limite de Integer, então um índice negativo chega aos writes abaixo. O teto de número de objeto de Stream.Size div 8 é a resposta geral barata, porque nenhuma tabela de cross-reference tradicional pode descrever mais objetos do que o arquivo tem espaço para guardar, e qualquer cabeçalho que afirme o contrário está descrevendo um arquivo que não existe. Se você está consertando uma tabela danificada na mão, o mesmo raciocínio vale do outro lado, que é o território coberto nas notas sobre diagnóstico e reparo de PDFs editados à mão
Como provar que a correção de um travamento funciona de verdade?
Rodando o código antigo, não relendo ele. Um travamento é uma das poucas classes de defeito em que uma correção pode ser verificada com um sinal binário e sem instrumentação, porque o processo ou retorna ou não retorna, e raciocinar sobre fluxo de controle é exatamente a habilidade que produziu o bug em primeiro lugar. A mecânica vale a pena copiar. Extraia a revisão pré-correção das units alteradas para um diretório scratch, e compile uma probe pequena com o caminho de busca de units colocando esse diretório à frente da biblioteca real: dcc32 -U<scratchdir>;<Lib> probe.dpr. O compilador pega as fontes antigas para o que encontrar primeiro e as fontes atuais para todo o resto, então um único binário de probe exercita o parser antigo contra o resto da biblioteca. Rode sob um timeout — quarenta segundos é generoso — e trate o exit code 124 como a asserção. Depois retire as units do diretório scratch uma a uma e recompile. Os três travamentos se reproduziram desse jeito, cada um atribuível a uma unit específica, e os três sumiram quando a fonte corrigida voltou ao caminho, ao custo de uma compilação por unit
Duas armadilhas valem conhecimento antes de tentar. O caminho de busca de units é silenciosamente permissivo: passe um caminho estilo Unix para -U vindo de um shell, como $PWD, e o compilador ignora aquele diretório sem dizer uma palavra, o que significa que sua probe compilou contra as fontes atuais e passou pelo motivo errado. Converta o caminho para a forma nativa do Windows primeiro. A segunda é que o diretório scratch não carrega os arquivos include, então você também precisa de -I<Lib> para o HotPDF.inc, senão o build falha de um jeito que parece problema de fonte em vez de problema de caminho. E seja honesto sobre o que o método não te dá: ele confirma que uma entrada específica parou de travar num build específico, e não diz nada sobre as entradas que você não pensou. Defeitos de avanço zero são encontrados por fuzzing ou lendo todos os ramos de todo tokenizer, não por testes de regressão escritos depois do fato
O que auditar nos seus próprios parsers
A regra reutilizável é um contrato, não um item de checklist. Toda função que lê de um cursor compartilhado precisa, em todos os caminhos incluindo os de falha, ou consumir ao menos um byte, ou retornar um valor que o chamador não consiga confundir com "tente de novo". Misturar esses dois significados num único nil ou num único token vazio é o que transforma uma recusa em travamento. Então audite pela forma, não pelo sintoma. Encontre todo loop cuja terminação depende de um cursor que outra função possui, e pergunte o que acontece quando essa função recusa o byte atual. Encontre todo ramo de fallback escrito como "ler até X" e pergunte o que ele faz quando o cursor já está em X. Encontre todo loop limitado por uma contagem que saiu do arquivo em vez dos dados, e faça um elemento com falha encerrar o loop em vez de pular uma iteração. Onde a mesma gramática é analisada em dois lugares, faça o diff, porque um dos dois vai ter recebido uma correção que o outro não. E coloque uma checagem de cancelamento dentro de todo loop que possa rodar por um número de iterações fornecido pelo chamador, para que um operador tenha algo para puxar quando o próximo desses aparecer em produção
Os parsers descritos aqui estão no HotPDF Delphi Component atual para Delphi e C++Builder, com os registros de estatísticas e limites de profundidade expostos para que seu próprio hardening possa construir em cima deles