Abra um PDF produzido pelo Microsoft Word ou Excel, percorra as páginas e nada parece incomum. Carregue-o num programa Delphi, leia de volta a contagem de páginas e o número está correto. Então salve-o novamente com criptografia ligada e o passo de save lança exceção, ou o output abre com um aviso de cross-reference danificada. O arquivo nunca esteve corrompido. É um arquivo de referência híbrida, e a própria estrutura que permite a um viewer de quinze anos abri-lo é a estrutura que derrota um loader que para de ler cedo demais
Esta é uma das maneiras mais comuns de um pipeline de PDF que passou em todos os testes internos encontrar um arquivo que não consegue salvar de volta (round-trip). As entradas foram todas geradas internamente, então elas nunca foram híbridas. O primeiro arquivo híbrido chega no dia em que um cliente encaminha uma fatura exportada de uma planilha
O que o Word e o Excel realmente escrevem
O ISO 32000-1 descreve o layout de referência híbrida na §7.5.8.4. Um aplicativo que deseja os recursos do PDF 1.5, como fluxos de objetos, e ao mesmo tempo permitir que um leitor de PDF 1.4 abra o arquivo, grava as informações de referência cruzada duas vezes. Existe uma tabela de referência cruzada clássica, as linhas ASCII de largura fixa que terminavam todos os PDFs até a versão 1.4, e existe um fluxo de referência cruzada que indexa o restante. O trailer da seção clássica contém uma entrada /XRefStm cujo valor é o deslocamento em bytes daquele fluxo
A divisão de trabalho é deliberada. Objetos que um leitor antigo tem que alcançar, o catálogo e a árvore de páginas entre eles, são endereçáveis a partir da tabela clássica. Objetos que foram dobrados em object streams comprimidos são marcados livres na tabela clássica, com uma entrada do tipo f, para que um leitor 1.4 passe direto por eles e nunca tropece numa estrutura que não consegue parsear. As localizações reais deles vivem só no cross-reference stream. A assinatura de tal arquivo é a cauda dele: uma seção clássica curta que cobre só os objetos de que um leitor legado precisa, cujo trailer aponta para o /XRefStm onde os dados reais de recuperação estão
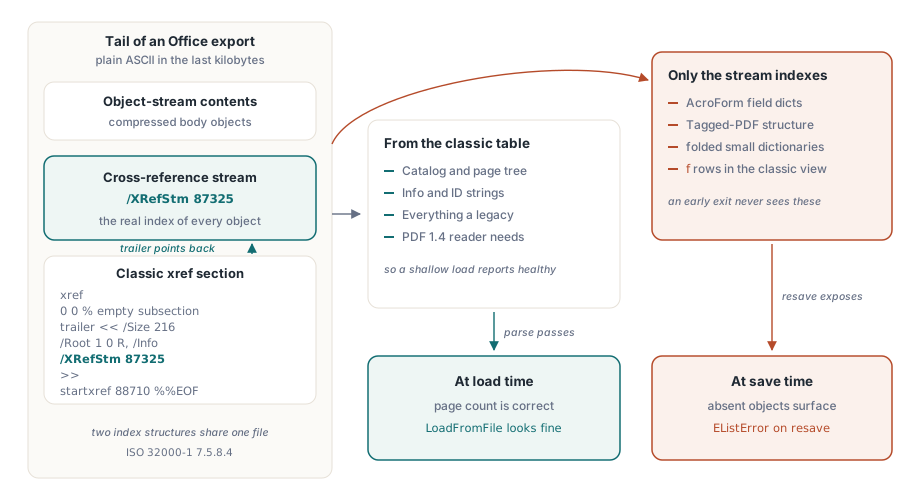
/XRefStm no trailer dela leva ao stream que guarda o resto do índice de objetosPor que uma contagem de páginas correta não prova nada
Como o catálogo e a árvore de páginas podem ser acessados da tabela clássica de propósito, um carregador que lê apenas essa tabela encontra o /Root, percorre a árvore de páginas e relata o número correto de páginas. Tudo que um leitor antigo precisa está presente, então o arquivo parece saudável. Os objetos que desapareceram são os agrupados em fluxos de objetos: dicionários de campos AcroForm, elementos de estrutura de PDF com tags, a longa cauda de pequenos dicionários que nunca precisaram ficar visíveis para um visualizador legado
Você não percebe a lacuna até que algo toque nesses objetos, e um resave completo toca em todos eles. Percorrer o documento para re-criptografá-lo ou reescrevê-lo é precisamente a operação que pede cada número de objeto, um por um, e é por isso que o sintoma aparece na hora do save e não na hora do load, longe da causa dele
A armadilha é um detector que vê o xref e para
A maneira mais barata de decidir como um arquivo é indexado é seguir o startxref e inspecionar os primeiros bytes para os quais ele aponta. A palavra-chave xref significa uma tabela clássica; um objeto de fluxo significa um fluxo de referência cruzada. Esse teste é correto para qualquer arquivo que se comprometa com um único esquema. É errado para um arquivo híbrido, cujo startxref aponta para uma seção clássica com o único propósito de satisfazer leitores antigos, enquanto o /XRefStm no trailer dessa seção é onde a maior parte do documento é realmente indexada. Um detector que retorna "clássico" no primeiro xref que encontra nunca lê /XRefStm, e cada objeto que reside apenas no fluxo torna-se invisível
var
  Pdf: THotPDF;
  PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('Invoice_XLS.pdf');  // as páginas são alcançáveis pela tabela clássica
    // inspecione ou edite o documento carregado aqui
    Pdf.SaveLoadedDocument('Invoice_secured.pdf');     // precisa de todo objeto, inclusive os que só vivem em streams
  finally
    Pdf.Free;
  end;
end;
Rode essa sequência num loader construído em torno do detector de saída antecipada e o load parece bem; o resave é onde os objetos ausentes se anunciam. O conserto não é ler mais bytes no início; é reconhecer o trailer híbrido e seguir o /XRefStm antes de decidir que o arquivo acabou
A ordem de mesclagem não é negociável
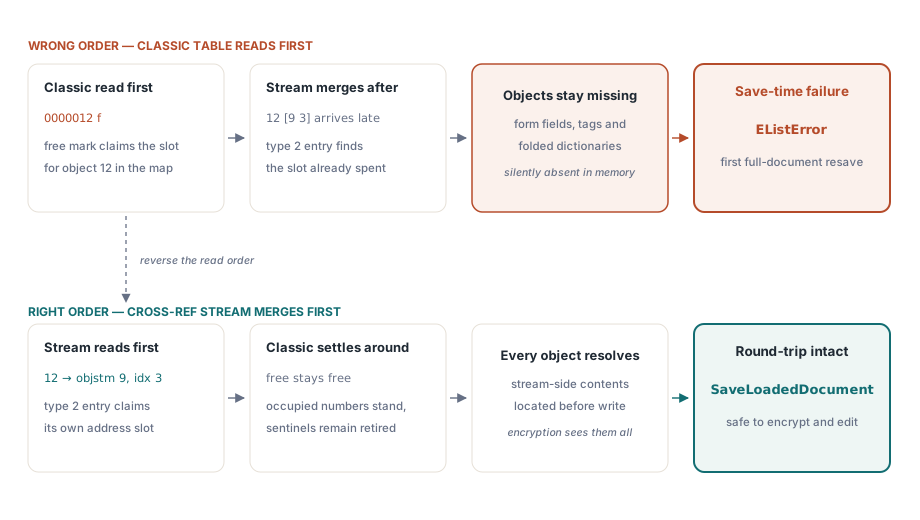
Uma vez que ambos os índices tenham sido lidos, eles só podem ser combinados em uma direção. O fluxo de referência cruzada tem que ser mesclado primeiro, com as entradas clássicas preenchidas em torno dele. O motivo é a pequena decepção no coração do formato. Um arquivo híbrido marca seus objetos compactados como livres na tabela clássica para que leitores antigos os ignorem. Um carregador que honra uma política de 'o primeiro visto vence' e lê a tabela clássica primeiro registrará esses números de objeto como livres e descartará as entradas de fluxo que realmente os localizam, porque os slots já estão ocupados. Inverta a ordem e as entradas do tipo 2 do fluxo, cada uma sendo um número de fluxo de objeto mais um índice, ganham os slots que deveriam possuir, e as entradas clássicas se acomodam ao redor delas
A mesma disciplina protege contra a ressurreição de um objeto excluído por uma revisão mais antiga. Atualizações incrementais encadeiam-se de volta através de /Prev, e uma entrada livre do tipo 0 é uma sentinela de que uma seção mais recente aposentou um número de objeto. Não se deve permitir que uma seção posterior e mais antiga da cadeia sobrescreva aquela sentinela com um local desatualizado. Trate o 'primeiro a ser visto' como definitivo para os marcadores livres e o objeto excluído continuará excluído; trate-o sem cuidado e a própria história de um arquivo reanimará o conteúdo que a última revisão removeu
Como as duas visões se dessincronizam
Tudo isso assume que os dois índices concordam. Direto do Word, eles concordam: cada visão descreve o mesmo documento dentro do escopo que declara. O problema começa quando o arquivo passa por uma ferramenta que entende só uma delas. Utilitários de stamping são os suspeitos de sempre. Um deles anexa um update incremental em estilo clássico com alguns objetos novos, uma nova seção xref, um link /Prev de volta à seção anterior, e um trailer novo. Se esse trailer derruba o /XRefStm, a visão de stream fica órfã. Se ele copia o valor antigo para frente, a visão de stream ainda descreve o documento como estava antes do stamp entrar. De qualquer jeito, os índices agora discordam
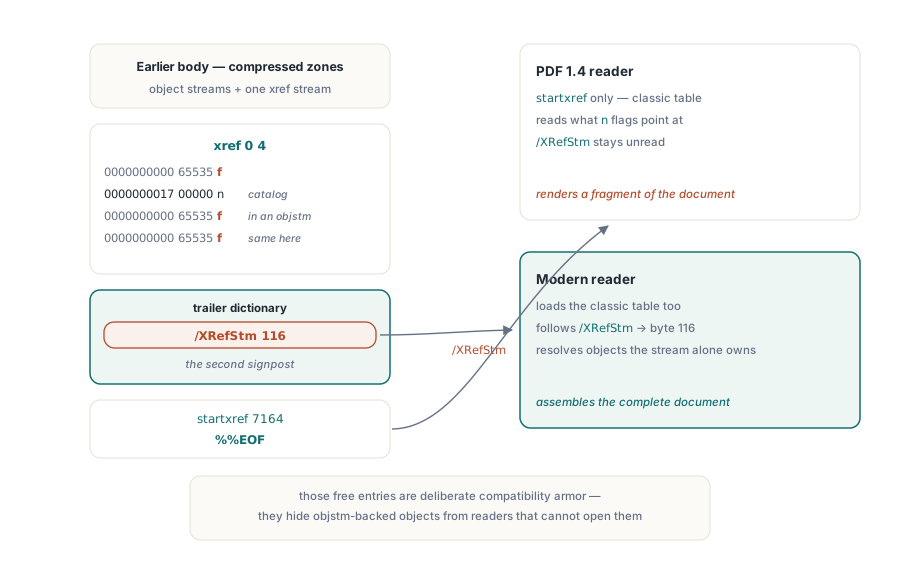
A assinatura é fácil de reconhecer quando você a conhece. Objetos visíveis por uma visão estão ausentes ou obsoletos na outra. Um leitor que resolve pelo stream encontra a versão pré-edição de um objeto atualizado, ou entrada nenhuma para um objeto anexado. Um leitor que confia só na tabela vê a edição mas perde todo objeto comprimido que só o stream podia localizar. Usuários descrevem isso como form fields que aparecem num viewer e desaparecem noutro, anotações que a passada de stamping parece ter apagado, ou lookups que pousam no objeto errado por completo
O Adobe Acrobat é o que torna esses arquivos tão caros de caçar. Quando o índice declarado discorda dos bytes, o Acrobat normalmente reconstrói os dados de cross-reference em silêncio varrendo por headers de objeto, então quem produziu o arquivo quebrado o abre, não vê nada de errado, e o manda adiante. A falha aparece depois e em outro lugar — um validador de preflight, um serviço de assinatura, um job de ingestão de arquivamento — qualquer consumidor que confia na estrutura declarada e reporta objetos ausentes ou um desencontro de cross-reference. "Abre normal no Acrobat" é como praticamente todo ticket de dessincronização híbrida começa
O que isso significa no HotPDF
O motor resolve arquivos de referência híbrida para você, e faz isso em todo caminho que precisa parsear os dados de cross-reference. Carregue um documento com LoadFromFile ou LoadFromStream, faça as suas mudanças, e chame SaveLoadedDocument; ou rode uma operação de uso único como o EncryptFile, que lê um input e escreve um output. De qualquer jeito a recuperação lê o /XRefStm, mescla a seção de stream à frente das entradas clássicas, e resolve os objetos que vivem em streams antes de a escrita enumerá-los. O caminho de criptografia AES-256 é onde isso aparece de forma mais visível, porque criptografar um documento reescreve todo objeto e portanto exige que todo objeto já tenha sido localizado
// Uso único: lê a entrada híbrida e grava uma cópia criptografada com AES-256
Pdf.EncryptFile('Letter_DOC.pdf', 'Letter_secured.pdf',
  'owner-secret', '', aes256, [prPrint, prFillAnnotations]);
O detalhe que vale a pena levar reside a montante da API. Arquivos que chegam do Word, Excel, PowerPoint e de uma longa lista de pipelines do tipo "Salvar como PDF" são rotineiramente híbridos, de modo que um carregador que você exercita apenas com a saída do seu próprio gerador pode nunca encontrar um durante os testes. Preencha seus ambientes de teste com documentos exportados de aplicativos Office reais, não apenas com arquivos que seu próprio código produziu
Verificando um arquivo suspeito
Duas inspeções resolvem a questão rapidamente. Abra o arquivo numa visão hexadecimal e leia os bytes depois do startxref final; um arquivo híbrido mostra uma seção clássica curta cujo dicionário de trailer contém /XRefStm. Ou compare a contagem de objetos que um parse completo reporta contra o maior número de objeto que o /Size declara no trailer. Uma lacuna grande significa que objetos estão escondidos em streams que o loader não abriu, que é a mesma falta que vira uma falha de save mais tarde
A cauda de uma exportação típica do Excel torna a primeira checagem concreta. Tudo depois do xref final é ASCII puro, então a assinatura é legível direto de uma visão hexadecimal (offsets ilustrativos, anotações adicionadas)
xref
0 16                         % objetos 0-15: o que um leitor legado precisa
0000000000 65535 f
0000000017 00000 n
...                          % mais 14 linhas; o resto vive em object streams
trailer
<< /Size 216                 % um a mais que o maior número de objeto em uso
   /Root 1 0 R
   /Info 15 0 R
   /ID [<5C9A...> <5C9A...>]
   /XRefStm 87325            % offset em bytes do cross-reference stream
>>
startxref
88710                        % aponta para a seção clássica acima
%%EOF
A chave /XRefStm no trailer é o indício. A seção clássica acima dela lista 16 dos 216 números de objeto que o arquivo usa; tudo empacotado em object streams ou está ausente dela ou está marcado livre. Um detector que para no xref viu, neste ponto, só esse índice parcial. Quando você prefere fazer script da checagem em vez de analisar a olho nu, o marcador fica nos últimos dois kilobytes do arquivo, então uma leitura retroativa limitada basta. Se o arquivo foi depois atualizado incrementalmente, a cauda guarda mais de um trailer, e o que conta é o último
// Devolve o offset de /XRefStm a partir do trailer mais novo na cauda do arquivo,
// ou -1 se o marcador estiver ausente (o arquivo não é híbrido, ou nem é um PDF)
function FindXRefStm(const FileName: string): Int64;
var
  FS: TFileStream;
  Tail: AnsiString;
  Len, P, Q: Integer;
begin
  Result := -1;
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    Len := 2048;                        // o trailer fica na cauda do arquivo
    if FS.Size < Len then
      Len := Integer(FS.Size);
    FS.Position := FS.Size - Len;       // leitura retroativa limitada: 2 KB no máximo
    SetLength(Tail, Len);
    FS.ReadBuffer(Tail[1], Len);
  finally
    FS.Free;
  end;
  P := 0;                               // guarda o último marcador: incremental
  Q := Pos(AnsiString('/XRefStm'), Tail); // updates anexam trailers mais novos
  while Q > 0 do
  begin
    P := Q;
    Q := Pos(AnsiString('/XRefStm'), Tail, P + 1);
  end;
  if P = 0 then
    Exit;                               // nenhum marcador híbrido na cauda
  Inc(P, Length('/XRefStm'));
  while (P <= Len) and (Tail[P] in [' ', #9, #13, #10]) do
    Inc(P);                             // pula espaços em branco após a chave
  Result := 0;
  while (P <= Len) and (Tail[P] in ['0'..'9']) do
  begin
    Result := Result * 10 + Ord(Tail[P]) - Ord('0');
    Inc(P);
  end;
end;

// Uso: um resultado não negativo indica o byte onde o stream começa
if FindXRefStm('Invoice_XLS.pdf') >= 0 then
  Writeln('hybrid-reference file: resave will need the /XRefStm section');
Trate a sonda como triagem, não como parser: ela diz quais arquivos num lote merecem atenção antes de um job de resave rodar, e nada mais
Aponte-a para uma pasta de inputs reais e os arquivos se separam em três grupos. Um arquivo só-clássico tem a palavra-chave trailer na cauda mas nenhum /XRefStm, então a sonda devolve -1. Um arquivo que se compromete por completo com cross-reference streams também devolve -1, corretamente. Ele não tem palavra-chave trailer nenhuma, porque as chaves de trailer dele vivem no dicionário do stream. Só o layout de índice duplo devolve um offset. Se o seu relatório de triagem precisa distinguir os dois primeiros grupos, procure trailer na mesma cauda antes de descartá-la; uma chamada a mais de Pos resolve
Antes de a sonda rodar sem supervisão, endureça-a em dois lugares. Um offset é só uma afirmação. Vá até ele e confirme que um objeto cujo dicionário diz /Type /XRef realmente está ali, porque um arquivo danificado ou truncado ainda pode carregar a chave enquanto o stream que ela nomeia se foi. Esse arquivo pertence a um balde diferente de um híbrido saudável. A checagem é umas poucas linhas por cima do mesmo manejo de arquivo
// Offset é o valor que FindXRefStm devolveu; FS é um TFileStream aberto
// do mesmo jeito, Head um AnsiString (Min vem de System.Math)
if Offset >= FS.Size then
  Exit(False);                          // a chave sobreviveu, o stream não
FS.Position := Offset;
SetLength(Head, Integer(Min(Int64(512), FS.Size - Offset)));
FS.ReadBuffer(Head[1], Length(Head));
Result := (Pos(AnsiString('/Type /XRef'), Head) > 0) or
  (Pos(AnsiString('/Type/XRef'), Head) > 0);  // a sintaxe PDF permite as duas grafias
Depois torne a janela de 2 KB um parâmetro. Dois kilobytes cobrem output comum de Office, mas um dicionário de trailer incomumente grande pode empurrar o marcador para fora da faixa, e alargar a janela é melhor que declarar o arquivo clássico por acidente
Roteando arquivos híbridos por um pipeline
A detecção vale a pena quando muda para onde um arquivo vai em seguida. Onde isso é depende do que o pipeline está prestes a fazer com ele
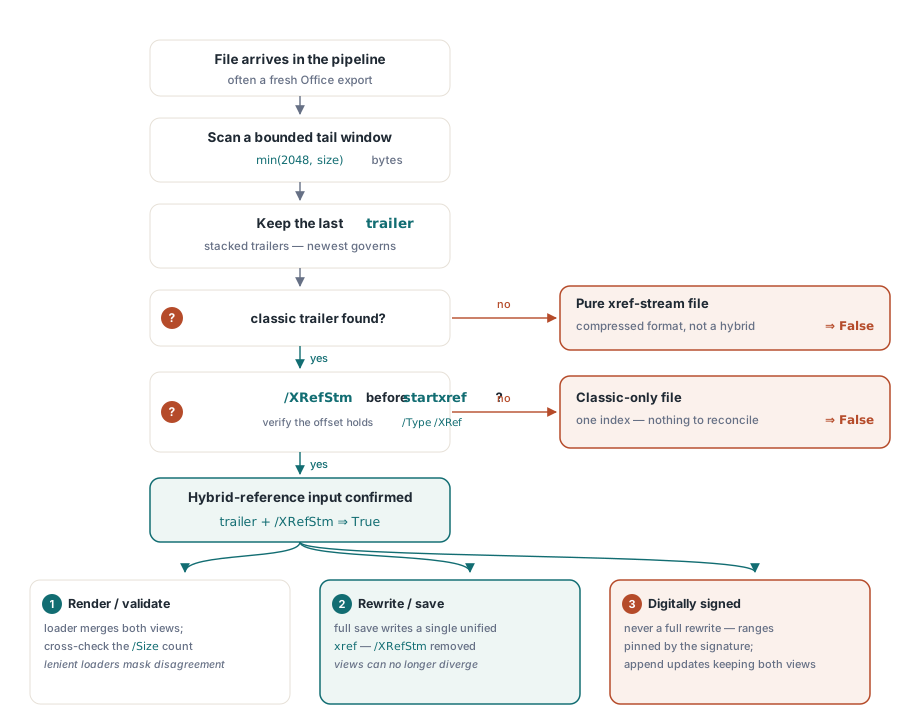
Arquivos que só são lidos, renderizados ou validados devem ir para um loader que resolve as duas visões. O PDFium Component parseia a cadeia /XRefStm durante o load, então a tabela de objetos que o seu código vê já é a mesclada, e as checagens de nosso artigo sobre validação de object e cross-reference streams se aplicam sem mudança. Quando um híbrido dessincronizado está danificado a ponto de recusar o load, o motor o reporta pelo código de erro de load dele, e o FPDF_ERR_FORMAT é o que dano estrutural produz. Um load limpo é evidência mais fraca. O PDFium é tolerante por desenho e reconstrói a maior parte dos arquivos inconsistentes sem comentário, então o sucesso prova que o arquivo era recuperável e não diz nada sobre se as duas visões dele concordam. Para essa pergunta, volte a comparar o que um passeio completo por objetos encontra contra o /Size do trailer
Arquivos que o pipeline modifica são outra história. Nossa preferência aqui é direta: deixá-los de ser híbridos de uma vez. Carregue o documento com o HotPDF e salve-o por completo, e o output carrega um cross-reference único e autoconsistente numa forma só. Nenhum /XRefStm, nenhuma segunda visão para dessincronizar, todo objeto pertencente a exatamente uma entrada de índice. Essa normalização é o que você quer antes de uma ingestão de arquivamento, antes de um RIP ou serviço de assinatura estrito a jusante, e depois de qualquer edição aplicada a um input híbrido. Ela se apoia por inteiro na mesclagem stream-primeiro descrita antes, já que um save completo só pode escrever os objetos que o load conseguiu localizar
Documentos assinados são a exceção. Uma regravação completa move todo byte, o que invalida qualquer assinatura computada sobre os intervalos de bytes originais. Uma mudança num híbrido assinado tem que entrar como um update incremental de verdade que mantém as duas visões em passo, e um arquivo assinado que só precisa ser lido deve passar pelo pipeline intocado
O lado de gravação desta história, ou seja, como fluxos de objetos e referências cruzadas compactadas são produzidos em primeiro lugar, é abordado em nosso artigo sobre fluxos de objetos e atualizações incrementais. Quando o arquivo híbrido em questão também é muito grande, as técnicas de carregamento explicadas no passo a passo da Direct File API para fluxos de trabalho de PDFs grandes permitem que você o inspecione sem ter que ler o arquivo inteiro na memória. Ambos combinam naturalmente com a recuperação descrita aqui, que é fornecida como parte do Componente HotPDF para Delphi e C++Builder junto com as APIs de carregamento, edição, criptografia e assinatura abordadas em outras partes deste blog