O HotPDF pode salvar um documento carregado em uma forma de diagnóstico projetada para ser lida e editada por um humano, e depois reparar o arquivo após você tê-lo editado. SaveLoadedDocumentDiagnostic grava o documento com ordenação determinística de dicionários, cada objeto como um objeto indireto normal, sem object streams, sem cross-reference stream e sem linearização. RepairDiagnosticDocument então reconstrói os deslocamentos de bytes, os comprimentos de stream, a tabela de referência cruzada e o trailer que sua edição invalidou
Essa dupla existe para um único fluxo de trabalho: entender ou corrigir o que realmente há dentro de um PDF. Todo desenvolvedor que já depurou um problema de renderização já quis abrir o arquivo, mudar um número em um dicionário e ver o resultado. Em um PDF normal isso é impossível, porque o conteúdo é comprimido em object streams, e cada byte que você insere desloca os offsets que uma tabela de referência cruzada registra com exatidão
O que torna um salvamento de diagnóstico diferente?
Seis configurações mudam juntas. As chaves de dicionário são gravadas em ordem determinística, de modo que dois salvamentos do mesmo documento produzem arquivos comparáveis. O modo de saída de diagnóstico anota a estrutura. A reescrita completa é forçada, de modo que nada é transportado como uma revisão incremental intocada. A linearização fica desativada, já que um arquivo linearizado é organizado para um visualizador web, e não para um leitor. As cross-reference streams ficam desativadas, de modo que a tabela é texto simples. E os object streams ficam desativados, de modo que nenhum objeto fica escondido dentro de um contêiner comprimido
O resultado é um arquivo cujo cabeçalho carrega um marcador de diagnóstico ao lado da assinatura %PDF- usual, e cujo corpo você pode percorrer em qualquer editor. Os objetos aparecem um após o outro, os dicionários são legíveis, e os fluxos de conteúdo ficam onde você consegue encontrá-los. A ferramenta de reparo verifica esse marcador e recusa arquivos que não o têm, porque a estrutura compacta de um PDF normal não é algo que um reparador por faixas de bytes deveria tentar interpretar

uses
  HPDFDoc;

var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoice.pdf') <= 0 then
      Exit;
    // Legível, um objeto por bloco, nada escondido em object streams
    Pdf.SaveLoadedDocumentDiagnostic('invoice-diagnostic.pdf');
  finally
    Pdf.Free;
  end;
end;
Por que a edição quebra o arquivo, e o que precisa ser reconstruído?
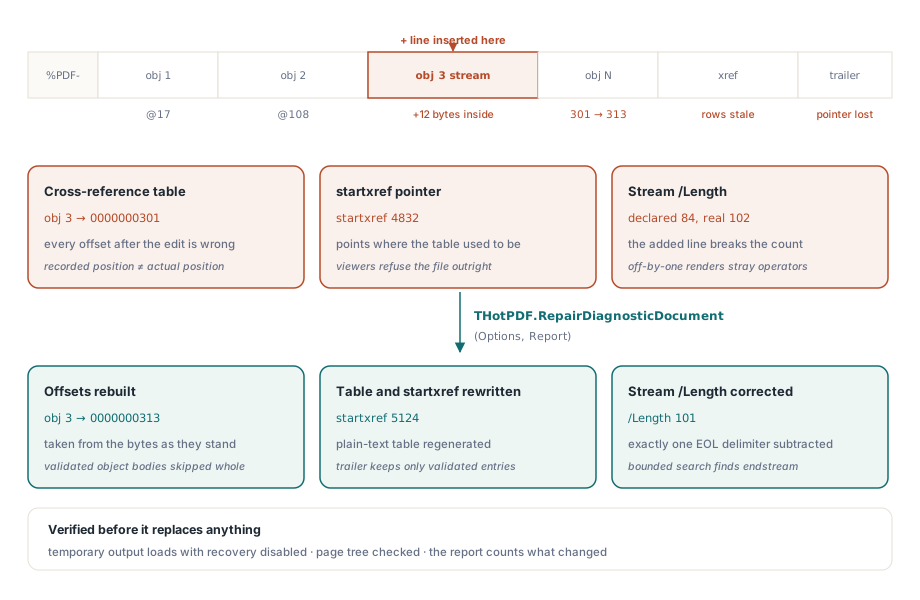
Três coisas em um PDF codificam posições de bytes ou contagens de bytes. A tabela de referência cruzada mapeia cada número de objeto para um offset de byte. O valor startxref no final do arquivo aponta para a tabela. E todo dicionário de stream carrega um /Length dizendo quantos bytes o corpo do stream ocupa
Mude um caractere em qualquer ponto antes do final do arquivo e os offsets depois dele ficam errados. Adicione uma linha a um fluxo de conteúdo e o seu /Length também fica errado. A maioria dos visualizadores vai recusar o arquivo, e os que o recuperam fazem isso por varredura, o que esconde o erro em vez de corrigi-lo. O reparo reconstrói os três a partir do que os bytes realmente dizem agora
var
  Options: THPDFDiagnosticRepairOptions;
  Report: THPDFDiagnosticRepairReport;
begin
  Options := THPDFDiagnosticRepairOptions.Default;
  Options.VerifyOutput := True;         // carrega o resultado antes de substituir

  if THotPDF.RepairDiagnosticDocument('invoice-diagnostic.pdf',
       'invoice-fixed.pdf', Options, Report) then
    Writeln(Format('%d objects, %d streams, %d lengths corrected, ' +
      '%d xref rows rebuilt, %d pages verified',
      [Report.ObjectCount, Report.StreamCount,
       Report.RepairedStreamLengthCount, Report.RebuiltXRefEntryCount,
       Report.VerifiedPageCount]))
  else
    Writeln(Format('repair failed (%d): %s',
      [Ord(Report.Status), string(Report.Diagnostic)]));
end;
Copie bytes, não reserialize
A decisão de design que torna essa ferramenta confiável é que ela nunca carrega o documento e o grava de volta. Ela copia as faixas de bytes dos objetos que validou, muda apenas os valores de /Length que estão errados, e reconstrói a tabela, o trailer e o startxref ao redor deles
Carregar e reserializar seria muito mais fácil de implementar e mudaria as coisas silenciosamente. Sintaxe de objeto desconhecida seria normalizada, escapes de string seriam reescritos na forma preferida do escritor, e cargas úteis de stream já codificadas poderiam ser recodificadas. Para uma ferramenta de depuração, isso é inaceitável: você editou um número, e o diff deveria mostrar um número, não mil mudanças de formatação incidentais. Se você quer saber exatamente o que mudou entre dois arquivos, esse é um problema de comparação, abordado em comparando dois arquivos PDF por estrutura e por pixels

As duas regras de análise que evitam objetos falsos
Um escaneador por faixas de bytes enfrenta uma armadilha óbvia: texto que se parece com um cabeçalho de objeto pode aparecer dentro de uma carga útil de stream ou dentro de uma string. Uma varredura ingênua emitiria uma linha de referência cruzada apontando para o meio de um fluxo de conteúdo, e o arquivo resultante ficaria quebrado de uma forma nova e mais confusa
O HotPDF evita isso pulando toda a faixa de bytes de cada objeto validado, usando seu offset de fim registrado, de modo que nada dentro do corpo de um objeto é jamais considerado candidato. Entre objetos, apenas espaços em branco e comentários de PDF são permitidos; qualquer outra coisa significa que a região não foi compreendida e seus bytes não devem ser trazidos para a saída
Os comprimentos de stream exigem cuidado igual. O comprimento real da carga útil exclui o delimitador de fim de linha que um gravador insere antes de endstream. Quando o comprimento declarado cai exatamente no marcador, essa declaração é aceita. Quando não cai, o reparador realiza uma busca limitada pelo par endstream e endobj e subtrai exatamente um delimitador, um CR, um LF ou um CRLF. Errar isso por um byte produz um arquivo que abre e renderiza uma página com um operador solto no final do seu fluxo de conteúdo
O que o trailer tem permissão para manter
O trailer reconstruído não é uma cópia do antigo. /Size, /Prev e /XRefStm descrevem todos o layout anterior do arquivo e são recalculados ou descartados. Apenas as entradas cujos alvos foram validados sobrevivem: /Info, /ID e /Encrypt. E /Root precisa resolver para exatamente um objeto Catalog — nem zero, nem vários, que é o que um arquivo montado por copiar e colar blocos de objetos tende a produzir
A segurança da saída é tratada da forma como deveria ser para uma ferramenta que roda sobre arquivos com os quais as pessoas se importam. O resultado é gravado em um arquivo temporário no diretório de destino, depois verificado carregando-o pelo caminho normal com a recuperação de referência cruzada desativada, de modo que um arquivo que só abre graças à recuperação conta como uma falha. Somente depois que a árvore de páginas é verificada, o arquivo temporário substitui o destino de forma atômica. Um reparo malsucedido nunca sobrescreve uma saída existente
Orçamentos e códigos de falha honestos
Três limites delimitam o trabalho: bytes de entrada, contagem de objetos candidatos e número máximo de objeto, com padrão de 8 GiB, dois milhões e dois milhões. O teto de número de objeto importa mais do que parece, porque uma tabela esparsa com poucos objetos numerados na casa dos bilhões, do contrário, infla enormemente a tabela de referência cruzada reconstruída. Tabelas de referência cruzada clássicas também rejeitam offsets que precisariam de mais de dez dígitos decimais, o que é um limite de formato, não uma escolha de implementação
As falhas relatam um status específico, e não um booleano: argumentos inválidos, origem grande demais, não é um arquivo de diagnóstico, limite de objetos excedido, objeto inválido, objeto duplicado, catálogo ausente, trailer inválido, erro de saída ou validação falhou. Cada um corresponde a uma correção diferente. Um objeto duplicado significa que você colou um bloco de objeto duas vezes. Um catálogo ausente geralmente significa que o objeto que contém /Type /Catalog foi danificado. Validação falhou significa que a estrutura agora é consistente, mas a árvore de páginas não carrega, o que costuma ser um array /Kids editado de forma dessincronizada com seu /Count
Duas notas práticas fecham o ciclo. Guarde o arquivo de diagnóstico, não apenas o reparado, para que a próxima edição comece de uma base legível. E não envie saída de diagnóstico para usuários finais: ela é maior do que um salvamento normal porque nada é comprimido em object streams, e a rota de produção para um arquivo compacto é o caminho de salvamento comum descrito em object streams e atualizações incrementais. Quando o objetivo é encontrar o que está errado em vez de mudá-lo, a rota automatizada em automação de relatório de preflight responde mais rápido do que ler bytes
O salvamento de diagnóstico, o reparo, o preflight e a comparação operam sobre o mesmo modelo de documento carregado no Delphi e no C++Builder; a lista completa de recursos está na página do componente PDF Delphi HotPDF