Kontrakt wyeksportowany z edytora tekstu z niezaznaczonym kwadratem „tagged PDF" nadal wygląda strukturalnie na ekranie: 24-punktowy pogrubiony tytuł, numerowane paragrafy, liniami rysowany cennik. Skonwertuj go do przepływowego HTML, a cennik wraca jako porządny <table>, podczas gdy tytuł to <p> z dokładnie taką samą rangą jak przypis. To wyjście jest poprawne. ISO 32000-1 §14.8 daje PDF dokładnie jedno miejsce, by powiedzieć „ten bieg tekstu to nagłówek" — drzewo struktury — a nieoznakowany plik nie ma żadnego. Rozmiar czcionki i pogrubienie to decyzja zecerska, i konwerter, który zamienia każdą wielką pogrubioną linijkę w <h1>, awansuje też cytaty wyróżnione, sumy w tabelach i nazwę firmy na papeterii
Pytanie warte zadania każdemu potokowi PDF-do-HTML brzmi więc: skąd wzięły się w jego wyjściu każdy nagłówek, element listy i tabela, i jak daleko każde z nich może ufać układ telefonu, czytnik ekranu albo indeksator wyszukiwania. Nagłówki i tabele dają różne odpowiedzi. Krok eksportu dokłada własne wybory o łamaniach linii, kodowaniu znaków i pamięci
Skąd biorą się nagłówki i listy
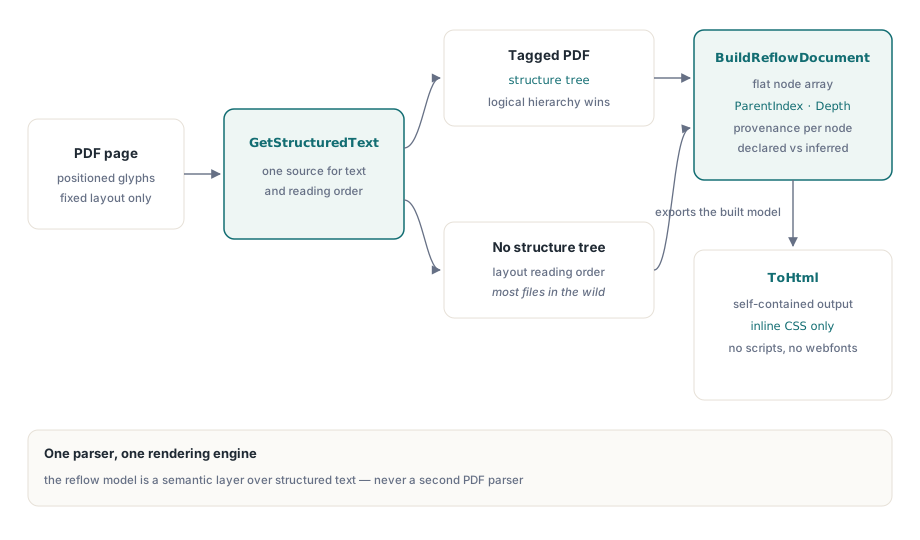
PDFium Component buduje model przepływowy przez TPdf.BuildReflowDocument, a ta metoda bierze każde słowo, blok i wskazówkę semantyczną z GetStructuredText — tej samej warstwy tekstu strukturalnego opisanej w artykule o blokach tekstu strukturalnego i kolejności czytania. Nie ma za tym drugiego parsera ani drugiego ekstraktora tekstu. Dla każdej strony w żądanym zakresie zbiera bloki w fizycznej kolejności układu. GetStructuredText już dopasował każdy blok do oznakowanej treści strony po nakładającym się obszarze, a BuildReflowDocument kopiuje znalezioną rolę na blok: H przez H6 stają się nagłówkami ze swoim poziomem, LI, Lbl i LBody stają się elementami list, Figure staje się figurą, której tekstem jest opis alternatywny, a Caption staje się podpisem
Płyną z tego dwie konsekwencje i obie łatwo zaobserwować. Kolejność bloków zawsze podąża za układem strony, nawet w pliku oznakowanym — tagi rozstrzygają, czym blok jest, a geometria rozstrzyga, gdzie idzie. I na stronie bez tagów każdy blok jest akapitem. Nagłówki i listy nie są nigdy zgadywane z rozmiaru czcionki
Każdy węzeł niesie pole Source typu TPdfReadingOrderSource: rosStructure, gdy rola przyszła z drzewa struktury, rosHeuristic, gdy przyszła z samego układu. Eksportowany HTML powtarza to jako data-source="structure" albo data-source="inferred" na każdym elemencie, a dokumentowy TPdfReflowDocument.Source jest rosStructure tylko, gdy każda strona w zakresie była oznakowana. Tabele są zawsze rosHeuristic, bo pochodzą z detekcji geometrycznej, nie z tagów Table. Jeśli downstreamowy krok traktuje nagłówki jako punkty orientacyjne nawigacji, sprawdź to pole najpierw; oznakowany dokument daje ci punkty orientacyjne wybrane przez autora
Płaska tablica węzłów zamiast drzewa obiektów
TPdfReflowDocument.Nodes to spłaszczone drzewo w porządku prefiksowym: jedna dynamiczna tablica rekordów TPdfReflowNode, każdy z ParentIndex i Depth. Węzły stron siedzą na głębokości 0 z indeksem rodzica -1. Akapity, nagłówki, figury, podpisy, listy i tabele wiszą na stronie na głębokości 1, elementy list siedzą na głębokości 2 pod swoją listą, a komórki tabel sięgają głębokości 3 pod wierszem. Kolejne elementy listy dzielą jeden węzeł listy; jakikolwiek inny blok albo tabela pomiędzy nimi zaczyna nową listę
Płaski układ to decyzja o przenośności. Rekurencyjny rekord zawierający dynamiczną tablicę samych siebie kompiluje się pod Delphi, C++Builderem i Free Pascalem, ale te trzy obchodzi się z rekurencyjnymi typami zarządzanymi różnie przez granicę pakietu albo DLL. Płaska tablica zwykłych rekordów zachowuje się tak samo w wszystkich trzech i da się ją streamować jedną pętlą for bez rekurencji
uses
  SysUtils, PDFium;

var
  Pdf: TPdf;
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Node: TPdfReflowNode;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'contract.pdf';
    Pdf.LoadDocument;

    Options := TPdfReflowOptions.Default;   // wszystkie strony, tabele włączone, CSS włączony
    Doc := Pdf.BuildReflowDocument(Options);

    for I := 0 to High(Doc.Nodes) do
    begin
      Node := Doc.Nodes[I];
      case Node.Kind of
        prnkHeading:
          Writeln(Format('%sH%d [%s] %s', [StringOfChar(' ', Node.Depth * 2),
            Node.HeadingLevel,
            BoolToStr(Node.Source = rosStructure, True), Node.Text]));
        prnkTable:
          // na węźle tabeli RowSpan/ColumnSpan trzymają liczbę wierszy i kolumn tabeli
          Writeln(Format('%stable %dx%d, page %d, confidence %.2f',
            [StringOfChar(' ', Node.Depth * 2), Node.RowSpan, Node.ColumnSpan,
             Node.PageNumber, Node.Confidence]));
      end;
    end;

    Writeln(Format('%d node(s), %d table(s), %d character(s), pages %d-%d',
      [Length(Doc.Nodes), Doc.TableCount, Doc.CharacterCount,
       Doc.FirstPage, Doc.LastPage]));
  finally
    Pdf.Free;
  end;
end;
Na nieoznakowanym kontrakcie z otwarcia ta pętla nie wypisuje żadnych linii H i jedną linię tabeli na każdą wykrytą tabelę stawek. Puść ją na oznakowanej kopii tego samego dokumentu, a nagłówki pojawią się z True obok. FirstPage i LastPage w opcjach domyślają się 0, czyli pierwszej i ostatniej strony dokumentu; zakres poza liczbą stron podnosi EPdfError, zanim jakakolwiek strona zostanie przeczytana
Dlaczego tekst tabeli nie pojawia się dwa razy?
Detekcja tabel chodzi na każdej stronie po zebraniu tekstu strukturalnego, co znaczy, że słowa wewnątrz tabeli istnieją dwa razy: raz jako bloki tekstu, raz jako komórki. Wyemituj oba, a każda tabela w HTML ma za sobą ponownie własną zawartość jako luźne akapity — dokładnie to produkuje naiwne scalanie „doklej tabele do tekstu"
Model rozwiązuje to geometrycznie. Blok tekstu, którego ramka otaczająca leży co najmniej w połowie wewnątrz granic wykrytej tabeli, jest wyrzucany, a węzeł tabeli zajmuje jego miejsce. Tabele są potem przeplatane z pozostałymi blokami według pozycji pionowej (wyżej na stronie najpierw, z lewa-na-prawo jako rozstrzygnięciem remisu, gdy górne krawędzie są w granicach pół punktu), więc tabela ląduje między akapitem nad nią a akapitem pod nią, zamiast być doklejana na końcu strony
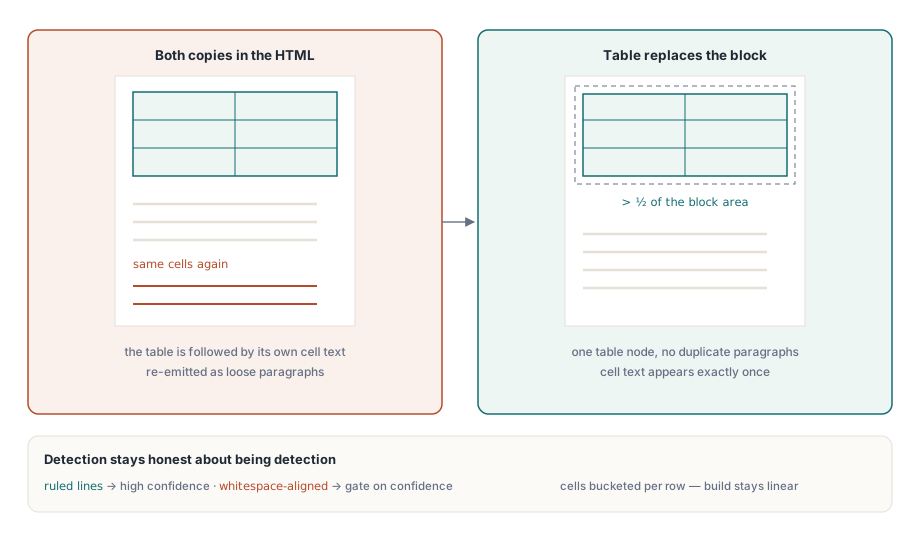
Próg połowy obszaru ma widoczny brzeg. Blok, który siada okrakiem na granicy tabeli i mieszka w większości poza nią, przeżywa w całości, więc linijka tekstu potrafi od czasu do czasu pojawić się i w ostatnim wierszu, i w akapicie, który następuje. To właściwa strona, na którą warto się mylić. Próg na tyle niski, by usunąć każdy nachodzący blok, skasowałby też tekst treści, który jedynie dotyka ramki otaczającej tabeli, a zduplikowana linijka jest dużo łatwiejsza do zauważenia i wybaczenia niż brakujące zdanie
Wykryte tabele wozi też pewność, i dwie strategie detekcji lądują w różnych pasmach. Tabela znaleziona z linii siatki punktuję między 0.88 a 1.0, zależnie od tego, ile jej komórek trzyma tekst. Tabela wywnioskowana czysto z wyrównania białych znaków punktuję między 0.58 a 0.88. Confidence węzła tabeli trzyma ten wynik, każdy węzeł komórki go powtarza, a HTML zapisuje go jako data-confidence na elemencie <table>. Tabele poniżej TableOptions.MinConfidence (domyślnie 0.5) nie są nigdy tworzone, a gdy tabela zostaje odrzucona, jej słowa po prostu zostają w modelu jako zwykłe akapity
Dla indeksu wyszukiwania albo mobilnego widoku czytania zła tabela kosztuje mało, a poprawnie wykryta to duży zysk, więc zostaw domyślne. Dla konwersji archiwalnej, gdzie wymyślona siatka wokół dwukolumnowego bloku adresowego jest gorsza niż żadna siatka, zawęź detekcję do tabel z liniami:
Options := TPdfReflowOptions.Default;
Options.DetectTables := True;
Options.TableOptions.DetectWhitespaceTables := False; // tylko tabele z liniami
Options.TableOptions.MinConfidence := 0.9;            // zrzucaj też rzadkie siatki z liniami
Options.TableOptions.MaxTables := 200;                // sufit na cały dokument
Options.TableOptions.MaxCells := 50000;               // sufit na cały dokument

Doc := Pdf.BuildReflowDocument(Options);
if Doc.TableCount = 0 then
  Writeln('No ruled tables; all page text is emitted as paragraphs');
Wewnątrz budowy reflow MaxTables i MaxCells liczą się przez cały zakres stron, nie per strona, więc wyciąg na 300 stron z tabelą z liniami na każdej stronie potrzebuje MaxTables co najmniej 300, albo budowa staje z EPdfError przy pierwszej tabeli ponad limit. Domyślne to 1000 tabel i 100000 komórek
Samą stronę detekcji — łącznie z cienkimi wypełnionymi prostokątami rysowanymi jako linie i kontynuacją między stronami — omawia artykuł o wykrywaniu i ekstrakcji tabel
Eksportowanie HTML-a, który nie potrzebuje niczego więcej
TPdfReflowDocument.ToHtml przechodzi model, który został już zbudowany, i nigdy więcej nie dotyka PDFium, więc dwukrotny eksport tego samego modela daje ten sam łańcuch. Z ustawionym FullDocument (domyślnym) wynik to kompletna strona: doctype, <meta charset="utf-8">, meta tag viewport, <title> wzięty z wpisu Title dokumentu (albo „PDF document", gdy jest pusty) i atrybut lang z języka dokumentu. Z wyłączonym FullDocument dostajesz pojedynczy fragment <div class="pdf-reflow"> do wklejenia we własny szablon
Opcjonalny arkusz z IncludeCss to jeden inline'owy blok <style>: kolumna czytania 72rem, każda strona PDF jako biała karta przy włączonym IncludePageSections, zapadnięte granice tabel i media query poniżej 40rem, który zdejmuje padding karty i zmniejsza tekst tabel. Nie ma skryptu, fontu internetowego ani zewnętrznego URL-a — to pozwala plikowi siedzieć w wiadomości e-mail, przeglądarce pomocy w stylu CHM albo piaskownicowej kontrolce przeglądarki. Poziomy nagłówków poza 1 do 6 zapisywane są jako h2, komórki nagłówkowe stają się th, a komórki z RowSpan albo ColumnSpan powyżej 1 dostają rowspan i colspan. Włączenie IncludeGeometry dokłada data-left, data-top, data-right i data-bottom w punktach PDF, co przydaje się do podświetlenia trafienia wyszukiwania z powrotem na wyrenderowanej stronie
PreserveLineBreaks zasługuje na świadomy wybór. Łamanie linii wewnątrz akapitu PDF powstało pod jedną stałą szerokość kolumny; utrzymaj je na ekranie 360 pikseli, a każda linia łamie się dwa razy — postrzępiony wzór, do usunięcia którego reflow istnieje. Zostaw wyłączone (domyślne) dla prozy. Włącz dla dokumentów, gdzie łamanie niesie znaczenie — adresy, wiersze, listingi kodu — a zapisuje <br> zamiast spacji
Dla długiego dokumentu zbudowanie całej strony jako jednego WString i dopiero potem zakodowanie jej podwaja szczyt pamięciowy. WriteHtml streamuje ten sam znacznik do TPdfReportWriter zamiast tego, pisząc ASCII z każdym znakiem nie-ASCII jako numerycznym odniesieniem znakowym, więc bajty są poprawne niezależnie od tego, jak strona odbierająca zgaduje kodowanie:
uses
  Classes, SysUtils, PDFium, FPdfAsync, FPdfReport;

procedure ExportReflowHtml(Pdf: TPdf; const FileName: string;
  const Token: IPdfCancellationToken);
var
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Limits: TPdfReportLimits;
  Stream: TFileStream;
  Writer: TPdfReportWriter;
begin
  Options := TPdfReflowOptions.Default;
  Options.MaxNodes := 500000;
  Options.MaxCharacters := 20000000;
  Doc := Pdf.BuildReflowDocument(Options, Token);   // stan strony jest przywracany potem

  Limits := TPdfReportLimits.Default;
  Limits.MaxCharacters := 64 * 1024 * 1024;  // sufit bajtów wyjścia, maksimum 64 MiB
  Limits.MaxItems := Options.MaxNodes;       // jeden element na węzeł, maksimum 1048576

  Stream := TFileStream.Create(FileName, fmCreate);
  try
    Writer := TPdfReportWriter.Create(Limits, Stream);  // strumień pozostaje własnością wołającego
    try
      Doc.WriteHtml(Writer);
    finally
      Writer.Free;
    end;
  finally
    Stream.Free;
  end;
end;
WriteHtml sprawdza więcej niż ToHtml. Odmawia modelu z większą liczbą węzłów niż Options.MaxNodes, egzekwuje Options.MaxCharacters na zapisywanym tekście, ogranicza zagnieżdżenie do argumentu MaxDepth (domyślnie 64) i weryfikuje, że każdy ParentIndex wskazuje na wcześniejszy węzeł. Ten ostatni sprawdzian ma znaczenie, gdy twój kod filtruje albo przepisuje Nodes przed eksportem: zedytowana tablica z rodzicem wskazującym w przód podnosi EPdfReportLimit zamiast produkować znacznik z niedopasowanymi tagami
Budżety, anulowanie i bieżąca strona
PDF to niezaufane wejście, i zniekształcony albo wrogi plik może zadeklarować tysiące stron malutkiego tekstu. BuildReflowDocument sprawdza budżety znaków, węzłów, tabel i komórek przed dodaniem każdego węzła, więc plik, który je przekracza, staje z EPdfError i komunikatem nazywającym budżet („Reflow node budget exceeded", na przykład), podczas gdy zużycie pamięci pozostaje ograniczone. Zarówno MaxCharacters, jak i MaxNodes muszą być dodatnie; domyślne to 10 000 000 znaków i 1 000 000 węzłów
Opcjonalny IPdfCancellationToken jest sprawdzany przed każdą stroną, między blokami, przed każdą tabelą i przed każdym wierszem tabeli. Podaj Token z TPdfCancellationTokenSource należącego do twojego formularza, zawołaj Cancel z handlera przycisku, a budowa podniesie EPdfOperationCancelled przy następnym z tych punktów kontrolnych. Łap go osobno od EPdfError, żeby cancel użytkownika nie został zalogowany jako zepsuty plik. Z jakimkolwiek wyjątkiem budowa by się skończyła, nic częściowego nie jest zwracane; jeśli porażka wydarzy się później wewnątrz WriteHtml, plik docelowy trzyma uciętą stronę, więc usuń go we własnym handlerze wyjątków
Stan strony to detal, od którego zależy kod GUI. Budowa odwiedza każdą stronę w zakresie przez przesuwanie PageNumber, a try/finally odkłada stronę wołającego z powrotem — przy sukcesie, przy porażce budżetu i przy anulowaniu jednakowo. Przeglądarka, która zacznie eksport, póki użytkownik czyta stronę 340, jest nadal na stronie 340, gdy eksport wróci
Gdzie pasuje reflow
Wyjście reflow dobrze pracuje jako wejście dla indeksowania wyszukiwania, dostępnych widoków czytania, wyświetlania na telefonie i migracji treści do CMS-a. Celowo zrzuca pozycjonowanie absolutne, dokładne fonty, grafikę wektorową i geometrię strony — poza opcjonalnymi współrzędnymi data-*. Gdy zadanie potrzebuje, by strona wyglądała identycznie, renderuj ją; gdy potrzebuje, by słowa dały się czytać gdzie indziej, przepuszczaj reflow
Bo nagłówki i listy przychodzą wyłącznie z tagów, jakość HTML-a podąża za jakością oznakowania upstream. Dokumenty przechodzące kontrole z artykułu o walidacji drzewa struktury PDF/UA produkują model z prawdziwą hierarchią nagłówków, a ta sama oznakowana treść napędza funkcje czytania w budowaniu dostępnego czytnika
Reflow, tekst strukturalny, ekstrakcja tabel i renderowanie chodzą wszystkie na tym samym obiekcie TPdf w Delphi, C++Builderze i Lazarusie; rekordy opcji, wyjątki i report writer są udokumentowane na stronie produktu PDFium Component for Delphi