Dwukolumnowy artykuł konferencyjny poukładany według pozycji pionowej wraca z pierwszą linią typu Abstract We measure the 2 Related work Earlier studies: początkowe słowa lewej kolumny i początkowe słowa kolumny prawej, sklejone, bo obie siedzą na tej samej linii bazowej. W parserze nic nie poszło nie tak. Strona PDF oferuje dwa obronione kolejności dla swojego tekstu, sekwencję, w jakiej maluje go strumień treści, i pozycję każdego glifu na stronie, i dla wielu układów te dwie kolejności się różnią. Ekstraktor zwracający bloki z pozycjami zamiast jednego łańcucha pozwala ci zobaczyć, którą kolejność dostałeś, i przełączyć, gdy jest zła dla strony, którą masz przed sobą
Co zwraca GetStructuredText
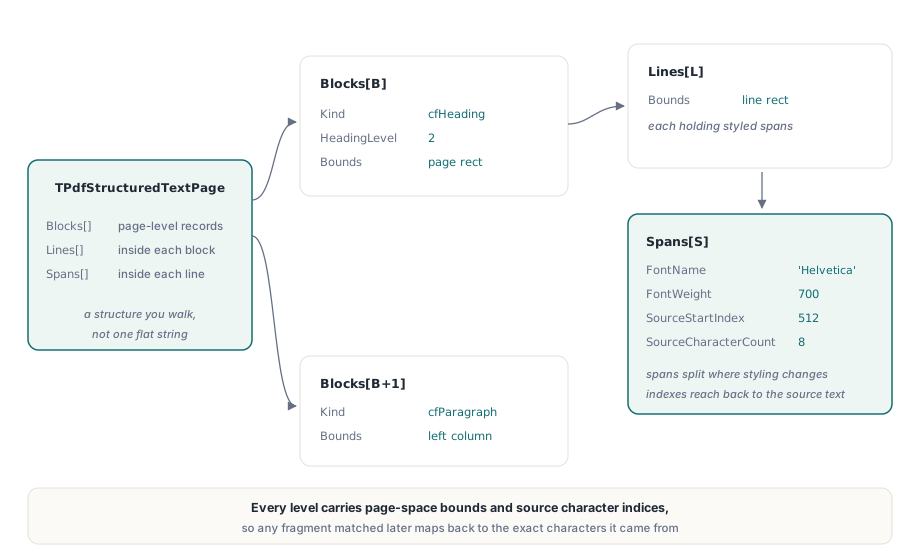
TPdf.GetStructuredText w PDFium Component zwraca TPdfStructuredTextPage dla bieżącej strony: tablicę bloków, każdy blok tablicą wierszy, każdy wiersz tablicą stylizowanych fragmentów. Każdy poziom niesie własne Text i prostokąt Bounds w przestrzeni strony w punktach PDF, więc nagłówek, pojedynczy wiersz albo pogrubiona fraza da się zlokalizować na stronie bez drugiego wyszukiwania. Rekord strony dokłada Width, Height, CharacterCount i dwa liczniki jakości opisane niżej
Spłaszczony Page.Text jest budowany z bloków, a nie ze surowego strumienia znaków. Wiersze wewnątrz bloku są sklejane pojedynczym CRLF, a bloki rozdziela pusta linia, co znaczy, że zrzut Page.Text jako zwykłego tekstu już pokazuje, gdzie ekstraktor poprowadził granice bloków. To czyni go najszybszą rzeczą do wydrukowania, gdy strona czyta się dziwnie
Całe to napędza mały rekord opcji. TPdfStructuredTextOptions.Default ustawia ReadingOrder na roPhysicalLayout, włącza IncludeFontInfo i IncludeSemantics oraz ustawia MaxCharacters na 1 000 000. Pole kolejności czytania to to, które zmienia kształt wyjścia najbardziej
Jak dwie kolejności czytania budują wiersze i bloki
roContentOrder trzyma sekwencję rysowania producenta, podczas gdy roPhysicalLayout przebudowuje kolejność z pozycji glifów, i różnica wychodzi najpierw w tym, jak powstają wiersze. W kolejności treści znaki są brane w kolejności, w jakiej strona je rysuje. Nowa linia zaczyna się przy jawnym złamaniu linii albo gdy następny znak przestaje pokrywać się z bieżącą linią w pionie. Linia dołącza wtedy do bloku bezpośrednio przed nią tylko, jeśli obie pokrywają się w poziomie co najmniej na piątą część węższej szerokości, a przerwa pionowa nie przekracza około dwóch i ćwiartki wysokości linii; w przeciwnym razie otwiera nowy blok. Bloki zostają w kolejności rysowania
Fizyczny układ wyrzuca sekwencję rysowania. Każdy znak z znanym pudełkiem jest sortowany po pionowym środku tego pudełka, góra strony pierwsza, potem po swojej lewej krawędzi. Znaki, których pionowe rozmiary pokrywają się dostatecznie, dzielą linię, a ten test patrzy tylko na wysokość. Odległość pozioma nie gra w nim żadnej roli. Każda linia dołącza potem do tego istniejącego bloku gdziekolwiek na stronie, który pasuje jej najlepiej tą samą regułą pokrycia i przerwy, a skończone bloki są sortowane po górnej krawędzi, z lewą krawędzią rozstrzygającą remisy w granicach pół punktu
Ta druga reguła to źródło przykładu z otwarcia. Gdy dwie kolumny artykułu dzielą siatkę linii bazowych, pierwszy wiersz lewej kolumny i pierwszy wiersz kolumny prawej pokrywają się w pionie, więc fizyczny układ kładzie je w jednej linii. Przerwa na marginesie wewnętrznym jest szersza niż ćwiartka rozmiaru fontu, więc ekstraktor wstawia jedną spację i jedzie dalej. Każdy wiersz treści robi to samo, scalone wiersze wszystkie pokrywają się nawzajem w poziomie, i cała dwukolumnowa treść staje się jednym szerokim blokiem czytanym wprost przez margines
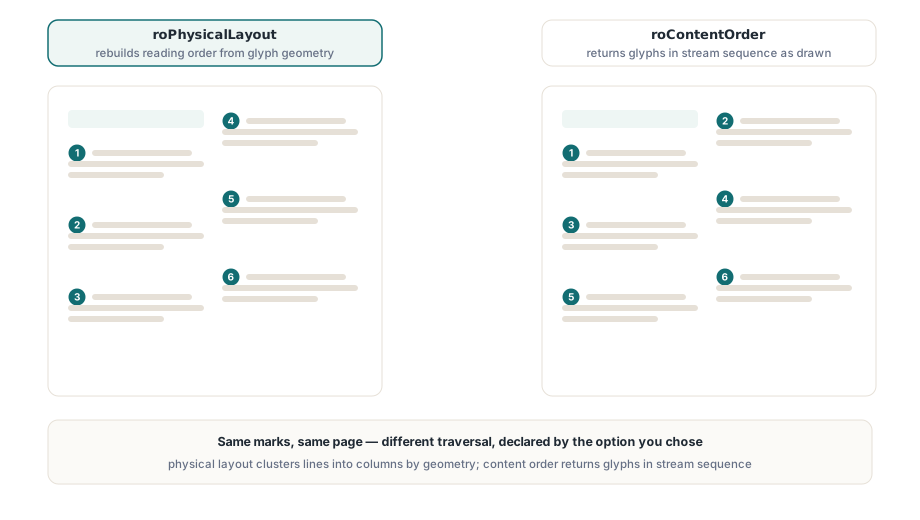
Kolejność treści ogarnia taką stronę dobrze zawsze, gdy producent napisał kolumnę pierwszą przed kolumną drugą, czyli to, co edytory i systemy składu robią normalnie. Wiersze lewej kolumny układają się w bloki, pierwszy wiersz kolumny prawej nie ma z nimi poziomego pokrycia i otwiera świeży blok, a bloki wychodzą w kolejności, w jakiej napisał je autor. Fizyczny układ zarabia swoją pozycję na innym gatunku strony: fakturach, wyciągach, formularzach i slajdach, gdzie etykieta i jej wartość siedzą na tej samej linii bazowej, a czytanie wiersza od lewej do prawej to dokładnie to, czego chcesz. To też tryb na wypadek, gdy sekwencja rysowania nie znaczy nic, na przykład tekst malowany font po foncie albo strona złożona z wielu małych nakładek
Dla mieszanej kolekcji rozdziel wybór po typie dokumentu. Artykuły, raporty i instrukcje z znanego narzędzia autorskiego idą przez roContentOrder; formularze i dokumenty transakcyjne zostają na domyślnym roPhysicalLayout. Poniższa procedura drukuje bloki jednej strony w kolejności treści, z nagłówkami oznaczonymi, gdy plik jest otagowany
uses
  SysUtils, PDFium;

procedure DumpBlocks(Pdf: TPdf; PageNumber: Integer);
var
  Options: TPdfStructuredTextOptions;
  Page: TPdfStructuredTextPage;
  B, L: Integer;
begin
  Pdf.PageNumber := PageNumber;                 // liczony od 1
  Options := TPdfStructuredTextOptions.Default;
  Options.ReadingOrder := roContentOrder;      // producenci kolumna po kolumnie

  Page := Pdf.GetStructuredText(Options);
  if Page.Source = rosStructure then
    Writeln('block kinds come from the structure tree')
  else
    Writeln('block kinds are inferred from layout');

  for B := 0 to High(Page.Blocks) do
  begin
    if Page.Blocks[B].Kind = cfHeading then
      Writeln(Format('[%d] H%d  %s',
        [B, Page.Blocks[B].HeadingLevel, Page.Blocks[B].Text]))
    else
    begin
      Writeln(Format('[%d] x=%.0f..%.0f, %d line(s)',
        [B, Page.Blocks[B].Bounds.Left, Page.Blocks[B].Bounds.Right,
         Length(Page.Blocks[B].Lines)]));
      for L := 0 to High(Page.Blocks[B].Lines) do
        Writeln('      ', Page.Blocks[B].Lines[L].Text);
    end;
  end;
end;
Jak wykryć linię biegnącą przez margines wewnętrzny?
Scalona linia zdradza się przez swoje fragmenty. GetStructuredText zaczyna nowy fragment zawsze, gdy następny znak nie jest bezpośrednim następcą poprzedniego w pierwotnej sekwencji znaków strony, obok zmian stylu opisanych niżej. Wewnątrz jednej kolumny kolejne wyrazy są zwykle kolejne w źródle. Na marginesie scalonej linii indeks źródłowy skacze o setki znaków, a pozioma przerwa między dwoma fragmentami jest daleko szersza niż jakakolwiek spacja wyrazowa
Te dwa sygnały razem robią wiarygodny test, i możesz go odpalić na domyślnym wyjściu, zanim zdecydujesz, czy strona potrzebuje zamiast tego kolejności treści. Migawka danych znakowych, którą czyta GetStructuredText, jest cache'owana per strona, domyślnie osiem stron, więc prośba o tę samą stronę drugi raz z innym ReadingOrder przegrupowuje dane już w pamięci, zamiast ekstrahować stronę ponownie
// LineCrossesGutter to funkcja pomocnicza, którą dodajesz sam: flaguje linię
// trzymającą dwa sąsiednie fragmenty daleko rozdzielone na stronie i nieprzyległe
// w źródłowej sekwencji znaków
function LineCrossesGutter(const Line: TPdfStructuredTextLine;
  MinGap: Double): Boolean;
var
  S: Integer;
  Prev, Cur: TPdfStructuredTextSpan;
begin
  Result := False;
  for S := 1 to High(Line.Spans) do
  begin
    Prev := Line.Spans[S - 1];
    Cur := Line.Spans[S];
    if (Prev.SourceStartIndex < 0) or (Cur.SourceStartIndex < 0) then
      Continue;                                 // bloki tekstu alternatywnego
    if (Cur.Bounds.Left - Prev.Bounds.Right > MinGap) and
       (Cur.SourceStartIndex <>
        Prev.SourceStartIndex + Prev.SourceCharacterCount) then
      Exit(True);
  end;
end;

function ExtractWithFallback(Pdf: TPdf): TPdfStructuredTextPage;
var
  Options: TPdfStructuredTextOptions;
  B, L, Lines, Crossing: Integer;
begin
  Options := TPdfStructuredTextOptions.Default;   // roPhysicalLayout
  Result := Pdf.GetStructuredText(Options);

  Lines := 0;
  Crossing := 0;
  for B := 0 to High(Result.Blocks) do
    for L := 0 to High(Result.Blocks[B].Lines) do
    begin
      Inc(Lines);
      if LineCrossesGutter(Result.Blocks[B].Lines[L], 18) then
        Inc(Crossing);
    end;

  // ćwiartka linii przecinających przerwę wygląda jak kolumny, nie jak wiersz formularza
  if (Lines > 0) and (Crossing * 4 >= Lines) then
  begin
    Options.ReadingOrder := roContentOrder;
    Result := Pdf.GetStructuredText(Options);
  end;
end;
Osiemnaście punktów to ćwiartka cala, wygodnie szersza niż spacja wyrazowa w tekście głównym i węższa niż większość marginesów wewnętrznych. Próg jeden na cztery trzyma fakturę z kilkoma wierszami etykieta-kwota na fizycznym układzie, podczas gdy prawdziwa dwukolumnowa treść, gdzie przecina prawie każda linia, się przełącza. Jeśli producent napisał stronę wiersz po wierszu przez obie kolumny, indeksy źródłowe pozostają ciągłe, test nigdy nie odpala i żadna kolejność nie rozdzieli dla ciebie kolumn; ta strona potrzebuje trybu kolumnowego API treści czytelnej, opisanego w artykule o czytaniu dwóch kolumn z nagłówkiem przerastającym
Co zmienia IncludeSemantics, a czego nie rusza?
IncludeSemantics etykietuje bloki; nie przestawia ich kolejności. Z opcją włączoną GetStructuredText czyta treść czytelną strony i daje każdemu blokowi rodzaj fragmentu, z którym pokrywa się największym obszarem. Dostępne rodzaje to cfParagraph, cfHeading z HeadingLevel, cfListItem, cfTableCell, cfCaption, cfFigure, cfLink, cfOther dla dowolnego innego znacznika i cfPlain, gdy nic nie pasowało. Każdy blok podnosi też Language i StructElementIndex wiążący go z elementem drzewa struktury
Pole Source mówi, skąd przyszła etykieta: rosStructure, gdy strona ma użyteczne drzewo struktury w sensie ISO 32000-1 §14.7, rosHeuristic, gdy rodzaje były wnioskowane. Page.Source daje tę samą odpowiedź dla strony jako całości. Nagłówek raportowany z rosStructure jest nagłówkiem, bo otagował go autor; raportowany z rosHeuristic to wyedukowane zgadywanie, i potok indeksujący ważący tytuły powinien traktować oba inaczej. Kolejność bloków w obu przypadkach nadal pochodzi z ReadingOrder. Przebieg semantyczny używa domyślnych treści czytelnej, więc ustawienie kolumn naniesione przez ReadableContentOptions nie sięga GetStructuredText
Figury dostają jedną dodatkową regułę. Na stronie otagowanej element Figure albo tekst alternatywny niedopasowany do żadnego bloku tekstu jest doklejany jako blok własny, trzymający opis alternatywny jako swój tekst. Taki blok ma pojedynczy wiersz i pojedynczy fragment z SourceStartIndex ustawionym na -1, bo żaden glif na stronie go nie wyprodukował. Kod mapujący fragmenty z powrotem na znaki musi tę wartość pomijać, dlatego test marginesu wyżej ją sprawdza. Same kontrole drzewa struktury omawia artykuł o walidacji drzewa struktury PDF/UA
Fragmenty, granice i droga z powrotem do znaków
Każdy TPdfStructuredTextSpan niesie swój tekst, swoje granice, FontName, FontSize, FontWeight i Angle, plus SourceStartIndex i SourceCharacterCount. Przy włączonym IncludeFontInfo fragment kończy się tam, gdzie zmienia się dowolna z czterech wartości stylu, więc zdanie z trzema pogrubionymi słowami w środku przychodzi jako trzy fragmenty, a wyróżnienie da się przebudować z FontWeight zamiast zgadywać z nazw fontów. Przy wyłączonym IncludeFontInfo pola stylu zostają puste, a fragmenty łamią się tylko tam, gdzie sekwencja źródłowa jest przerwana
Kąt ma znaczenie na stronach z pieczątkami. Ukośny znak wodny DRAFT mieszka w tej samej przestrzeni współrzędnych co tekst główny, a w fizycznym układzie jego litery mogą wylądować na liniach treści, które krzyżują w pionie. Fragmenty z niezerowym Angle łatwo wyrzucić, zanim skleisz tekst do indeksowania
Te dwa pola źródłowe to to, co zamienia trafienie wyszukiwania w coś, co da się narysować. Indeksują sekwencję znaków strony, więc fraza znaleziona w bloku konwertuje się bezpośrednio w pudełka znaków dla podświetlenia, podejściem z artykułu o wizualnym zaznaczaniu linii tekstu ramkami znaków. Gdy celem jest postać strony po reflow albo w HTML, te same bloki zasilają model reflow i jego eksport HTML
Budżet znaków i dwa liczniki jakości
MaxCharacters odrzuca stronę w całości, gdy trzyma więcej znaków niż dozwolone. GetStructuredText sprawdza liczbę, zanim przydzieli jakiekolwiek tablice robocze, i przerośnięta strona rzuca EPdfError z komunikatem Structured text character budget exceeded; strona częściowa nigdy nie jest zwracana. Wartość musi być dodatnia. Migawka znaków per strona, którą czyta metoda, ma własny domyślny sufit 1 000 000 znaków i 100 000 obiektów tekstowych, raportowany jako Text snapshot budget exceeded, więc ustawienie MaxCharacters powyżej miliona nie przepuści większej strony
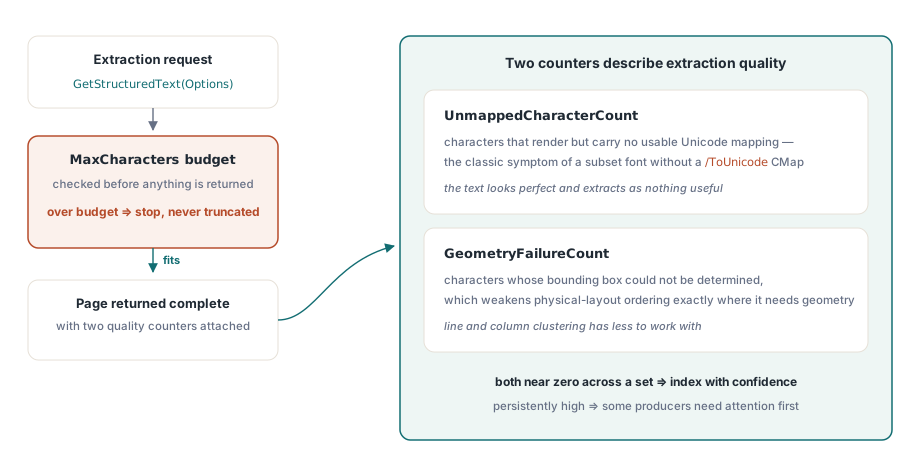
UnmappedCharacterCount liczy znaki, dla których PDFium nie potrafił wyprodukować żadnej wartości Unicode. Te znaki pojawiają się jako U+FFFD w każdym polu Text. Zwykłą przyczyną jest czcionka podzbioru z własnym kodowaniem i bez mapy CMap /ToUnicode, przypadek opisany w ISO 32000-1 §9.10.2, gdzie tekst renderuje się poprawnie i nie da się go wyodrębnić wiarygodnie. Licznik mierzy wyłącznie brakujące mapowania: glif, którego wpis /ToUnicode nazywa zły punkt kodowy, liczy się jako zmapowany, więc strona wiarygodnie wyglądającego śmiecia może nadal raportować zero
GeometryFailureCount liczy znaki bez użytecznego pudełka, złamania linii wyłączone. W kolejności treści takie znaki po prostu idą za sąsiadami. W fizycznym układzie nie mają pozycji, po której sortować, więc są kładzione po każdym pozycjonowanym znaku i kończą przyklejone do ostatniej linii strony. Strona z niezerowym licznikiem geometrii i dziwnymi fragmentami na swojej ostatniej linii pokazuje dokładnie to
// LogRejected i LogQuality to twoje własne procedury logowania
function ExtractForIndex(Pdf: TPdf; PageNumber: Integer;
  out Page: TPdfStructuredTextPage): Boolean;
var
  Options: TPdfStructuredTextOptions;
begin
  Result := False;
  Pdf.PageNumber := PageNumber;
  Options := TPdfStructuredTextOptions.Default;
  Options.MaxCharacters := 200000;              // limit przyjmowania dla tego potoku
  try
    Page := Pdf.GetStructuredText(Options);
  except
    on E: EPdfError do
    begin
      LogRejected(PageNumber, E.Message);       // budżet znaków albo migawki
      Exit;
    end;
  end;

  if Page.UnmappedCharacterCount * 20 > Page.CharacterCount then
    LogQuality(PageNumber, Format('%d of %d characters have no Unicode value',
      [Page.UnmappedCharacterCount, Page.CharacterCount]));
  if (Options.ReadingOrder = roPhysicalLayout) and
     (Page.GeometryFailureCount > 0) then
    LogQuality(PageNumber, Format('%d characters without a box; check the last line',
      [Page.GeometryFailureCount]));
  Result := True;
end;
Dla strony, której potrzebujesz tylko jako łańcucha, artykuł o wyodrębnianiu tekstu z dokumentów PDF obejmuje prostsze wywołania, a artykuł o odczycie i zapisie treści oznaczonej BDC i MCID schodzi warstwę pod drzewo struktury. Model strony strukturyzowanej, czytnik treści czytelnej i eksport reflow wchodzą wszystkie w skład komponentu Delphi i Lazarus opisanego na stronie produktu PDFium Component