Ten sam PDF może zgłaszać dwóch różnych autorów. Okno właściwości desktopowego czytnika pokazuje jedną nazwę, system zarządzania zasobami indeksujący XMP inną — i oba programy czytają plik poprawnie. PDF przechowuje metadane dokumentu dwa razy, a zakładki, łącza i notatki trzyma w strukturach, które nigdy nie dotykają treści stron, więc każda z tych rzeczy może być zepsuta, podczas gdy każda strona renderuje się idealnie
Model obiektowy leżący pod spodem — obiekty pośrednie, tabela odwołań krzyżowych, trailer — jest omówiony w przewodniku po strukturze dokumentu PDF. Tutaj skupiamy się wyłącznie na tym, co podpięte pod katalog dokumentu
Cztery wpisy w katalogu, cztery niezależne podsystemy
Wszystko omawiane poniżej jest osiągalne z katalogu dokumentu — słownika, na który wskazuje wpis /Root trailera (ISO 32000-1 §7.7.2). Katalog spięty ze wszystkim wygląda tak:
1 0 obj
<< /Type /Catalog
   /Pages 2 0 R
   /Outlines 3 0 R
   /Names << /EmbeddedFiles 4 0 R /Dests 6 0 R >>
   /Metadata 5 0 R
>>
endobj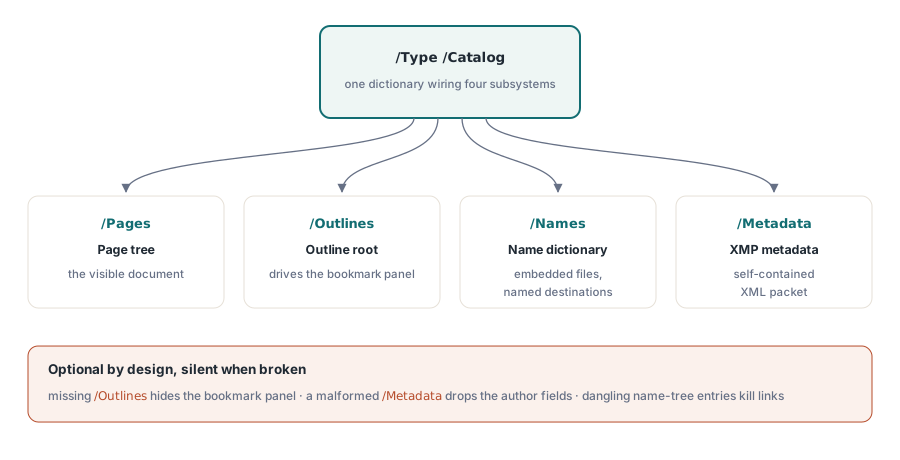
/Pages to widoczny dokument i jedyny z czwórki wymagany przez katalog. /Outlines prowadzi do drzewa zakładek, /Metadata do strumienia XMP, a /Names do słownika nazw, który trzyma osadzone pliki pod /EmbeddedFiles i nazwane miejsca docelowe pod /Dests. Czytnik, który nie znajdzie żadnej z trzech opcjonalnych, i tak pokaże każdą stronę — dlatego ta warstwa degraduje się pierwsza, gdy plik przechodzi przez narzędzia rozumiejące wyłącznie strony. Nic wewnątrz obiektu strony nie wskazuje z powrotem na konspekt, drzewo /Dests ani strumień XMP. Skopiuj same strony do nowego pliku, a wszystkie trzy zostaną w tyle
Czemu PDF niesie dwa magazyny metadanych?
PDF niesie dwa magazyny metadanych, bo format dorobił sobie drugi, nie wycofując pierwszego. Pierwotny mechanizm to słownik informacji o dokumencie (ISO 32000-1 §14.3.3, tabela 317), wskazywany przez /Info w trailerze: płaskie wpisy tekstowe /Title, /Author, /Subject, /Keywords, /Creator, /Producer, plus /CreationDate, /ModDate i /Trapped. ISO 32000-2 uznaje cały słownik za przestarzały poza dwoma wpisami dat i kieruje pisarzy do strumienia metadanych XMP
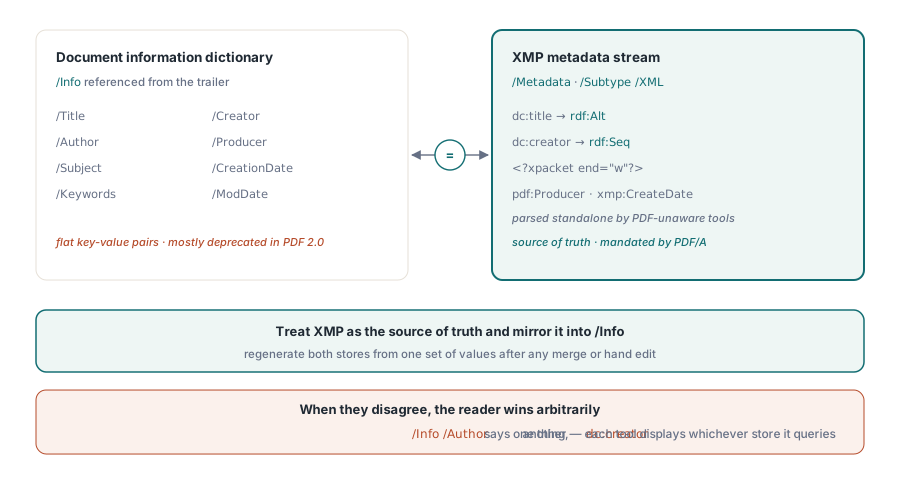
XMP (ISO 32000-1 §14.3.2) to dokument XML napisany w RDF, przechowywany w strumieniu, którego słownik niesie /Type /Metadata /Subtype /XML. W przeciwieństwie do słownika Info pakiet XMP jest zaprojektowany tak, żeby odnajdywały go i parsowały narzędzia, które o składni PDF nic nie wiedzą:
5 0 obj
<< /Type /Metadata /Subtype /XML /Length 1235 >>
stream
<?xpacket begin="" id="W5M0MpCehiHzreSzNTczkc9d"?>
<x:xmpmeta xmlns:x="adobe:ns:meta/">
  <rdf:RDF xmlns:rdf="http://www.w3.org/1999/02/22-rdf-syntax-ns#">
    <rdf:Description rdf:about=""
        xmlns:dc="http://purl.org/dc/elements/1.1/"
        xmlns:xmp="http://ns.adobe.com/xap/1.0/"
        xmlns:pdf="http://ns.adobe.com/pdf/1.3/">
      <dc:title><rdf:Alt><rdf:li xml:lang="x-default">Quarterly Report</rdf:li></rdf:Alt></dc:title>
      <dc:creator><rdf:Seq><rdf:li>A. Author</rdf:li></rdf:Seq></dc:creator>
      <xmp:CreateDate>2026-06-16T10:46:27+08:00</xmp:CreateDate>
      <xmp:CreatorTool>Reporting Service 4.2</xmp:CreatorTool>
      <pdf:Producer>losLab PDF Library</pdf:Producer>
    </rdf:Description>
  </rdf:RDF>
</x:xmpmeta>
<?xpacket end="w"?>
endstream
endobj
Trzy szczegóły w tym bloku rozstrzygają, czy pakiet przeżyje kontakt z prawdziwymi narzędziami. Instrukcje przetwarzania xpacket tworzą ramy pakietu, dzięki którym skaner odnajduje go w dowolnym strumieniu bajtów; wyrzuć zamykający <?xpacket end="w"?>, a plik dalej się otworzy, ale skanery tracą znacznik końca. Typy wartości też mają znaczenie: dc:title to wariant językowy i potrzebuje rdf:Alt, podczas gdy dc:creator to uporządkowana lista i potrzebuje rdf:Seq. Wypisanie któregokolwiek jako nagiego węzła tekstowego to łatwy błąd. Prefiksy są za to wyłącznie konwencją; parser kluczuje po URI przestrzeni nazw, więc dc: związany z niewłaściwym URI to zupełnie inna właściwość
Klucze Info i ich odpowiedniki XMP parują się tak, jak poniżej. PDF/A-1 (ISO 19005-1 §6.7.3) zapisuje to parowanie jako regułę zgodności: gdy obecne są oba magazyny, wartości muszą być równoważne
| Słownik Info | Właściwość XMP |
|---|---|
/Title | dc:title (rdf:Alt) |
/Author | dc:creator (rdf:Seq) |
/Subject | dc:description (rdf:Alt) |
/Keywords | pdf:Keywords |
/Creator | xmp:CreatorTool |
/Producer | pdf:Producer |
/CreationDate, /ModDate | xmp:CreateDate, xmp:ModifyDate |
Ręczne edycje i scalanie to miejsca, w których oba magazyny się rozjeżdżają. Scalanie potrafi odziedziczyć /Info z jednego wejścia, a pakiet XMP z drugiego. Bezpieczniejsza reguła: traktuj XMP jako źródło prawdy, trzymaj /Info dla starszych konsumentów i odtwarzaj oba z jednego zestawu wartości, ilekroć cokolwiek się zmieni
Zapis obu magazynów z jednego zestawu właściwości
HotPDF buduje oba magazyny z tych samych właściwości dokumentu. Title, Author, Subject i Keywords idą do /Info; gdy EnableXMPMetadata jest True, EndDoc pisze także pakiet XMP z tych samych wartości — z dc:title jako rdf:Alt i dc:creator jako rdf:Seq — i podpina go z katalogowego /Metadata. EnableXMPMetadata domyślnie jest False i warto je włączać dla wszystkiego, co opuszcza twoje ręce: plik wyłącznie z /Info jest niewidoczny dla każdego narzędzia czytającego samo XMP. CustomXMP zastępuje generowany pakiet własnym tekstem, gdy potrzebujesz dodatkowych schematów
uses
  System.SysUtils, Vcl.Graphics, HPDFDoc;

procedure BuildReport(const FileName: string);
var
  PDF: THotPDF;
  Chapter: THPDFDocOutlineObject;
begin
  PDF := THotPDF.Create(nil);
  try
    PDF.AutoLaunch := False;
    PDF.FileName := FileName;
    // Jeden zestaw wartości zasila i /Info, i pakiet XMP
    PDF.Title := 'Quarterly Report';
    PDF.Author := 'A. Author';
    PDF.Subject := 'Results for the third quarter';
    PDF.Keywords := 'quarterly, results';
    PDF.EnableXMPMetadata := True;
    PDF.BeginDoc;

    PDF.CurrentPage.SetFont('Arial', [fsBold], 20);
    PDF.CurrentPage.TextOut(50, 50, 0, 'Chapter 1: Results');
    Chapter := PDF.OutlineRoot.AddChild('Chapter 1: Results', 0, 50);
    Chapter.Opened := True;   // zapisywane jako dodatnie /Count

    PDF.AddPage;
    PDF.CurrentPage.SetFont('Arial', [fsBold], 16);
    PDF.CurrentPage.TextOut(50, 50, 0, 'Introduction');
    Chapter.AddChild('Introduction', 0, 50);

    PDF.AddPage;
    PDF.CurrentPage.SetFont('Arial', [fsBold], 16);
    PDF.CurrentPage.TextOut(50, 50, 0, 'Methodology');
    Chapter.AddChild('Methodology', 0, 50);

    PDF.EndDoc;
  finally
    PDF.Free;
  end;
end;
Edycja istniejącego pliku wygląda inaczej. Na wczytanym dokumencie SetLoadedTitle, SetLoadedAuthor, SetLoadedCreator i rodzeństwo piszą wpis słownika Info, a strumień XMP to osobny obiekt, który wymieniasz przez SetLoadedXMPMetadata. Zmień autora jednym wywołaniem i nie drugim, a SaveLoadedDocument wyprodukuje dokładnie plik z dwoma autorami z akapitu otwierającego
Drzewo zarysów stojące za panelem zakładek
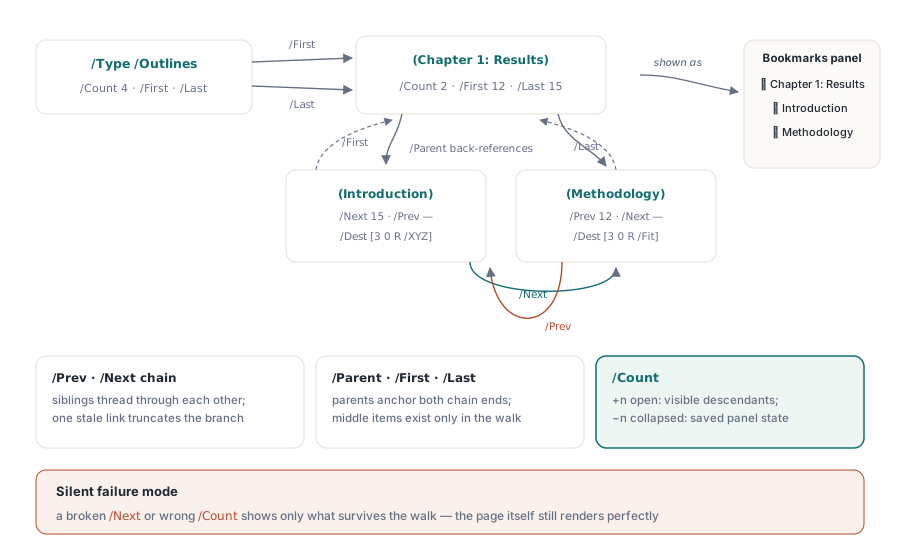
Panel zakładek jest odbudowywany z podwójnie powiązanego drzewa słowników — zarysu dokumentu (ISO 32000-1 §12.3.3, tabele 152 i 153). W pliku nie istnieje nigdzie żadna tablica zakładek; czytnik rekonstruuje panel, podążając za referencjami od katalogowego /Outlines
8 0 obj                                    % korzeń konspektu
<< /Type /Outlines /Count 3 /First 9 0 R /Last 9 0 R >>
endobj
9 0 obj                                    % najwyższy poziom: rozdział
<< /Title (Chapter 1: Results)
   /Parent 8 0 R /Count 2
   /First 12 0 R /Last 15 0 R
   /Dest [3 0 R /XYZ 0 792 0] >>
endobj
12 0 obj                                   % pierwsze dziecko
<< /Title (Introduction)
   /Parent 9 0 R /Next 15 0 R
   /Dest [4 0 R /XYZ 72 720 0] >>
endobj
15 0 obj                                   % drugie dziecko, ostatni brat
<< /Title (Methodology)
   /Parent 9 0 R /Prev 12 0 R
   /Dest [5 0 R /Fit] >>
endobj
Niezmienniki czyta się prosto z łączy. Każdy element wskazuje z powrotem na swojego /Parent-a. Rodzeństwo tworzy łańcuch przez /Prev i /Next; pierwsze dziecko nie ma /Prev, ostatnie nie ma /Next. Rodzic nazywa swoje dwa końce przez /First i /Last, a wszystko pomiędzy istnieje wyłącznie jako przystanek w przejściu po rodzeństwie. Zerwij jedno łącze, a czytniki pokażą, do czego jeszcze dotrą: nieświeże /Next urywa rozdział, a /Last niezgodne z końcem łańcucha zostawia różne czytniki rysujące różne drzewa
/Count zaskakuje, bo przechowuje stan panelu. Na korzeniu to liczba elementów widocznych na wszystkich poziomach. Na elemencie wartość dodatnia znaczy, że element jest otwarty, i podaje liczbę widocznych potomków; wartość ujemna znaczy, że jest zamknięty, a jej wartość bezwzględna mówi, ilu potomków pojawiłoby się po rozwinięciu. W przykładzie korzeń trzyma 3: jeden rozdział plus jego dwoje otwartych dzieci. Generator wpisujący każde /Count jako dodatnią sumę po cichu otwiera na nowo każdą gałąź, którą autor zwinął
W HotPDF OutlineRoot to THPDFDocOutlineObject, a AddChild(Title, X, Y) dokleja element, sprząta jego łącza /Parent, /Prev, /Next, /First i /Last i wskazuje bieżącą stronę jako [page /XYZ left top 0]. Właściwość Opened rozstrzyga znak, a pisarz przelicza każde /Count z gotowego drzewa przy EndDoc, więc ustawienie Opened po dodaniu dzieci jest w porządku. InsertBefore, InsertAfter i MoveTo przebudowują drzewo z tą samą księgowością
Miejsca docelowe: gdzie tak naprawdę ląduje kliknięcie
Zakładki i adnotacje łączy rozwiązują się do miejsca docelowego (ISO 32000-1 §12.3.2, tabela 151), a miejsce docelowe to więcej niż numer strony. To tablica nazywająca obiekt strony, po czym typ dopasowania, który mówi czytnikowi, jak ją wykadrować. Koń roboczy to [page /XYZ left top zoom]. Każdy z trzech operandów może być null — „zostaw, co czytnik miał” — a zoom 0 znaczy to samo co null. Więc [page /XYZ null null null] zmienia stronę i nic więcej, co zwykle jest dokładnie tym, czego chce łącze „przejdź do strony”
Rodzina /Fit wymienia dokładne pozycjonowanie na odporność. [page /Fit] skaluje całą stronę do okna, [page /FitH top] dopasowuje szerokość strony z podaną górną krawędzią, a [page /FitR left bottom right top] powiększa prostokąt, żeby wypełnił widok. Te liczą skalę z geometrii strony w chwili kliknięcia; /XYZ z wbudowanym zoomem trzyma go nawet po zmianie rozmiaru strony. Dla spisu treści lepszym domyślnym jest /FitH na górnej krawędzi sekcji
Na współrzędnych ludzie się palą. Liczby miejsc docelowych są w domyślnej przestrzeni użytkownika, z początkiem w lewym dolnym rogu i y rosnącym w górę (§8.3.2.3), podczas gdy nawyki layoutu ekranowego mierzą od góry. Wywołania HotPDF w stylu kanwy (TextOut, prostokąty łączy, X i Y AddChild) przyjmują współrzędne odgórne i przeliczają je za ciebie. RegisterNamedDestination wpisuje swoje Left i Top do tablicy miejsca docelowego takimi, jakie są, więc muszą już być w przestrzeni użytkownika PDF:
// Wołaj między BeginDoc a EndDoc, gdy strony 0..2 już istnieją
procedure AddContentsLinks(PDF: THotPDF);
var
  R: TRect;
begin
  // Nazwane miejsce docelowe 50 pt pod górą strony 1.
  // Top to przestrzeń użytkownika PDF, mierzona w górę od dolnej krawędzi
  PDF.CurrentPageNumber := 1;
  PDF.RegisterNamedDestination('chapter-1', 1, dfmFitH,
    0, PDF.CurrentPage.Height - 50, 0, 0, 0);

  // Wpisy spisu treści na stronie 0; prostokąty używają współrzędnych odgórnych
  PDF.CurrentPageNumber := 0;
  R := Rect(50, 175, 545, 209);
  PDF.CurrentPage.AddNamedDestinationLink(R, 'chapter-1', 'Chapter 1: Results');

  // YPos = -1 pisze [page /XYZ null null null]: zmień stronę, zachowaj widok
  R := Rect(50, 225, 545, 259);
  PDF.CurrentPage.AddGoToLink(R, 2, -1, 'Methodology');

  R := Rect(50, 275, 545, 309);
  PDF.CurrentPage.AddURILink(R, 'https://www.example.com', 'Project website');
end;
Podanie ekranowej wartości 50 jako Top wyśle łącze 50 punktów nad dolną krawędź — zamiast nagłówka pokaże stopkę. Nazwane miejsce docelowe mieszka w drzewie nazw /Dests katalogu i każde łącze rozwiązuje się przez nazwę, więc przy dziesiątkach łączy w te same rozdziały to właściwy wybór. Przesuniesz sekcję — poprawiasz jeden wpis w /Dests, a każde łącze go nazywające idzie za nim. O porządku stron, od którego te miejsca docelowe zależą, pisze artykuł o tym, czemu kolejność drzewa stron ma znaczenie
Adnotacje: interaktywne obiekty poza strumieniem treści
Adnotacja siedzi na stronie, nie będąc częścią jej strumienia treści (ISO 32000-1 §12.5). Łącza, karteczki, zakreślenia, widgety formularzy, ikony załączników i pieczątki żyją wszystkie w tablicy /Annots swojej strony. Usuń wpis — adnotacja znika, a strumień treści zostaje bajt w bajt ten sam
Każda adnotacja dzieli mały wspólny rdzeń (tabela 164): /Subtype nazywa rodzaj, /Rect podaje pudełko obejmujące w domyślnej przestrzeni użytkownika, a /Contents trzyma tekst, który zarazem służy jako alternatywny opis czytany przez technologie wspomagające. Adnotacje łączy (§12.5.6.5, tabela 173) przychodzą w dwóch postaciach:
20 0 obj                                    % łącze do miejsca docelowego
<< /Type /Annot /Subtype /Link
   /Rect [100 200 300 250]
   /Border [0 0 0]
   /Dest [5 0 R /XYZ null null null] >>
endobj
21 0 obj                                    % łącze uruchamiające akcję
<< /Type /Annot /Subtype /Link
   /Rect [50 50 200 100]
   /Border [0 0 0]
   /Contents (Project website)
   /A << /Type /Action /S /URI /URI (https://www.example.com) >> >>
endobj
/Border [0 0 0] jest tam nie bez powodu: domyślna ramka to [0 0 1], jednopunktowa obwódka, którą wiele czytników rysuje wokół każdego łącza. /Dest i /A się wykluczają, a /S akcji wybiera zachowanie: /GoTo w obrębie tego pliku (§12.6.4.2), /GoToR dla strony w innym PDF (§12.6.4.3), /URI dla adresu w sieci (§12.6.4.7), /Launch by otworzyć zewnętrzną aplikację albo plik (§12.6.4.5). Zostaw /Launch poza dokumentami, które dystrybuujesz: czytniki zwykle go blokują albo stawiają przed nim monit bezpieczeństwa, a PDF/A zabrania go wprost (ISO 19005-1 §6.6.1). Argument Description wywołań łączy z góry wypełnia /Contents, a przy włączonym PDFUACompliance HotPDF puste opisy rzucają wyjątkiem, bo PDF/UA-1 wymaga tego wpisu na każdym łączu
Adnotacje oznaczeń, jak zakreślenia i notatki, oraz kształty, jak /Square, mają haczyk: ich typ nie przesądza wyglądu. Bez strumienia wyglądu (wpis /AP, §12.5.5) każdy czytnik rysuje własną wersję. ISO 32000-2 czyni /AP obowiązkowym dla większości typów adnotacji, z Popup i Link wśród wyjątków. Załączniki plików reużywają tego samego mechanizmu: osadzony strumień pliku owinięty w specyfikację pliku (§7.11), wyprowadzony albo jako adnotacja /FileAttachment na stronie, albo przez drzewo nazw /EmbeddedFiles pod katalogowym /Names
Jak sprawdzić tę warstwę, zanim plik wypłynie?
Dwa sprawdzenia łapią większość: przeklikaj panel zakładek i próbkę łączy w prawdziwym czytniku, a potem odczytaj metadane programem, bo żadna ilość klikania nie ujawni /Info niezgodnego z XMP. Wywołania HotPDF dla wczytanych dokumentów pokrywają obie połowy. GetLoadedOutlineTitlesDeep przechodzi łańcuch /First i /Next w głąb — tym samym przebiegiem co czytnik — więc gałąź odcięta nieświeżym łączem jest nieobecna także w jego wyniku. FindLoadedOutlineByTitle rozwiązuje stronę docelową zakładki i zgłasza -1, gdy celem jest nazwane miejsce docelowe albo nie rozwiązują się do strony
// StripXmlTags to helper, który dopisujesz sam; to nie wywołanie biblioteki.
// GetLoadedXMPValue zwraca wewnętrzny markup elementu, więc dc:creator
// wraca owinięty w tagi rdf:Seq i rdf:li
function StripXmlTags(const S: AnsiString): AnsiString;
var
  I: Integer;
  InTag: Boolean;
begin
  Result := '';
  InTag := False;
  for I := 1 to Length(S) do
    if S[I] = '<' then InTag := True
    else if S[I] = '>' then InTag := False
    else if not InTag then Result := Result + S[I];
  Result := AnsiString(Trim(string(Result)));
end;

procedure CheckNavigationLayer(const FileName: string);
var
  PDF: THotPDF;
  Title, Author, Subject, Keywords, Creator, Producer, XmpAuthor: AnsiString;
  Titles: THPDFAnsiStringArray;
  I, PageIndex: Integer;
begin
  PDF := THotPDF.Create(nil);
  try
    PDF.AutoLaunch := False;
    if PDF.LoadFromFile(FileName) <= 0 then
      raise Exception.Create('No readable pages');

    if PDF.GetLoadedDocumentInfo(Title, Author, Subject, Keywords,
      Creator, Producer) then
    begin
      XmpAuthor := StripXmlTags(PDF.GetLoadedXMPValue('dc', 'creator'));
      if (XmpAuthor <> '') and (XmpAuthor <> Author) then
        Writeln('Author mismatch: /Info="', Author, '" XMP="', XmpAuthor, '"');
    end;

    Titles := PDF.GetLoadedOutlineTitlesDeep;
    Writeln(Length(Titles), ' bookmarks reachable');
    for I := 0 to High(Titles) do
      if PDF.FindLoadedOutlineByTitle(Titles[I], PageIndex, False, True)
        and (PageIndex < 0) then
        Writeln('No direct page target: ', Titles[I]);
  finally
    PDF.Free;
  end;
end;
Liczba zakładek niższa od wpisanej wskazuje zepsuty łańcuch rodzeństwa. -1 na zakładce używającej nazwanego miejsca docelowego jest oczekiwany, a FindLoadedOutlineByTitle staje na pierwszym trafieniu, więc zduplikowane tytuły zgłaszają cel pierwszego. GetLoadedXMPValue to zwykłe przeszukanie tekstu pakietu, a porównanie jest bajt w bajt, więc przy nazwach spoza ASCII obejrzyj, jak obie wartości wracają, zanim uwierzysz w niezgodność
Cała ta warstwa to księgowość referencji, a księgowość to ta część, którą warto oddać bibliotece. HotPDF Delphi Component dla Delphi i C++Buildera zapisuje oba magazyny metadanych z jednego zestawu właściwości, sprząta łącza konspektu w miarę dodawania elementów i dokleja adnotacje łączy wraz z akcjami i opisami; jego API wczytanego dokumentu czyta te same struktury z powrotem do sprawdzenia