PDF ucięty w połowie pobierania potrafi odmówić otwarcia, choć prawie każda strona dotarła, a zarazem podręcznik na 2000 stron wskakuje na stronę 1500 od razu. Oba przypadki wynikają ze struktury pliku PDF, takiej jaką ją zapisuje HotPDF Delphi Component: nagłówek, ciało numerowanych obiektów, tabela odsyłaczy (xref) z przesunięciami bajtowymi oraz trailer, te dwa ostatnie zapisane na końcu
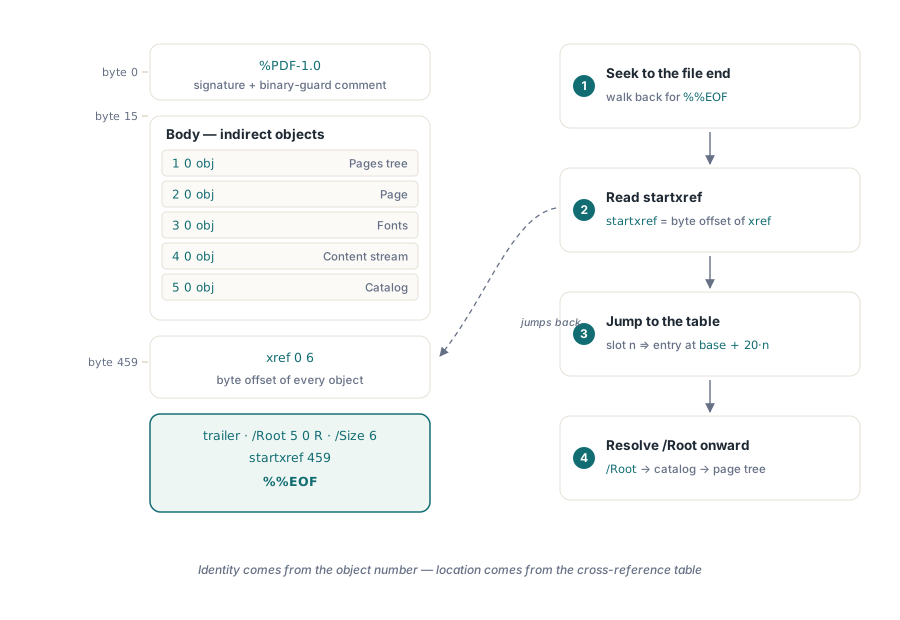
ISO 32000-2 §7.5.1 rozkłada tę samą czteroczęściową anatomię na każdy PDF, od jednostronicowego paragonu po zeskanowane archiwum. Części zawsze leżą w tej samej kolejności w dół pliku i łączą się w stały łańcuch: trailer nazywa katalog i mówi, gdzie zaczyna się tabela xref, tabela xref mówi, gdzie zaczyna się każdy obiekt, a obiekty wskazują na siebie numerami. Fragmenty poniżej pochodzą z 610-bajtowego pliku Hello World, którego przesunięcia sprawdziliśmy bajt po bajcie; kompletny plik, opatrzony adnotacjami przy każdym słowie kluczowym, jest w tym, jak PDF wygląda w środku, a to, co przeglądarka robi z tymi częściami w drodze do pikseli, opisuje jak PDF działa, gdy czytnik go otwiera
Nagłówek PDF to dwie linie, i druga ma znaczenie
Pierwsza linia, typu %PDF-1.7, to z punktu widzenia składni komentarz, ale czytniki traktują ją jako sygnaturę pliku i biorą z niej wersję; obsługa wersji w praktyce jest luźna, więc traktuj ten numer jako wskazówkę, jakich funkcji się spodziewać. Druga linia to ta, którą ludzie usuwają przez przypadek, a potem spędzają popołudnie na debugowaniu. Jej ładunek to co najmniej cztery bajty powyżej ASCII 127 (ISO 32000-1 §7.5.2), po to, żeby cokolwiek przenoszącego plik w trybie tekstowym rozpoznało go jako binarny i przestało przepisywać zakończenia linii. Skompresowane strumienie zawierają bajty, które przez przypadek odpowiadają carriage return albo line feed; przepisz je, a długość strumienia zapisana w słowniku przestaje zgadzać się z bajtami na dysku. Każde poważne narzędzie i tak emituje ten komentarz, bo porażka, której zapobiega, jest cicha i całkowita
Ciało: numerowane obiekty i osiem typów obiektów PDF
Ciało to płaska sekwencja obiektów pośrednich, każdy opakowany w N G obj ... endobj z numerem obiektu i numerem generacji. Tym, co zamienia tę płaską listę w wewnętrzną strukturę PDF, jest token referencji N G R: 2 0 R znaczy "obiekt 2, generacja 0, gdziekolwiek akurat mieszka w pliku". Każda wartość może też być zapisana na miejscu jako obiekt bezpośredni. We fragmencie słownik /Resources strony jest bezpośredni, a font, którego on nazywa, pośredni, więc sto stron może współdzielić obiekt 4 zamiast nieść sto kopii:
1 0 obj
<< /Type /Catalog /Pages 2 0 R >>          % katalog wskazuje drzewo stron
endobj
...
3 0 obj
<< /Type /Page
   /Parent 2 0 R
   /MediaBox [0 0 612 792]
   /Resources << /Font << /F1 4 0 R >> >>   % słownik bezpośredni, font pośredni
   /Contents 5 0 R
>>
endobj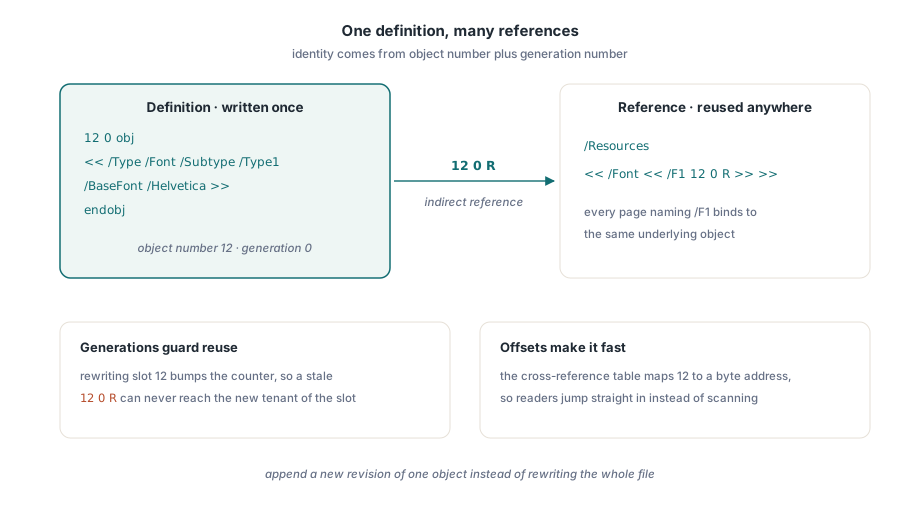
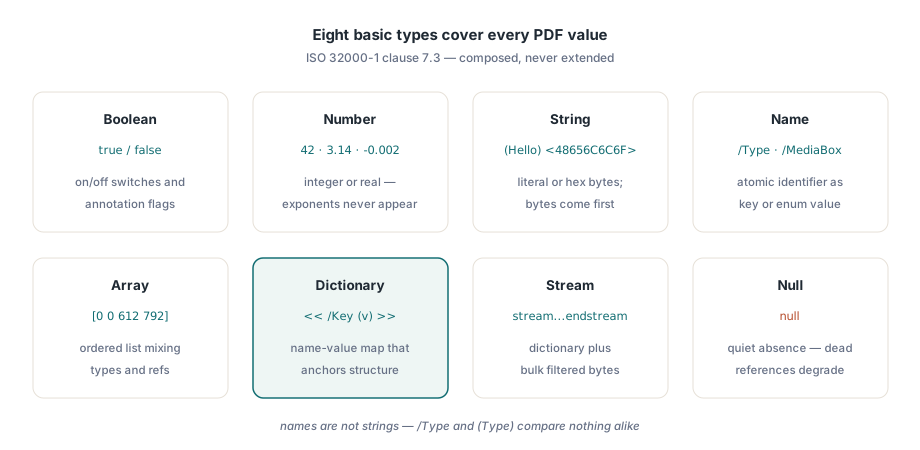
ISO 32000-1 §7.3 trzyma słownictwo krótko: każda wartość w PDF to jeden z ośmiu typów podstawowych. Booleany i liczby to skalary, a PDF nie ma notacji wykładniczej, więc 1e6 nigdy nie pojawia się w zgodnym pliku. Stringi trzymają bajty, zapisywane jako (Hello, World!) albo szesnastkowo jako <48656C6C6F>. Nazwy typu /Type albo /Helvetica są porównywane bajt po bajcie, więc (Helvetica) tam, gdzie /BaseFont oczekuje nazwy, to błąd typu, choć znaki się zgadzają. Tablice trzymają cokolwiek w kolejności, jak MediaBox. Słowniki mapują nazwy na wartości i niosą większość struktury. Strumień to słownik plus surowe bajty, dom dla zawartości stron, fontów i obrazów. Ósmy typ to null, i referencja do nieistniejącego obiektu rozwiązuje się do niego zamiast rzucać błąd, dzięki czemu uszkodzony plik degraduje się zamiast wykładać się od razu
Numer generacji istnieje na potrzeby ponownego użycia. Gdy edycja usuwa obiekt, jego numer trafia na listę wolnych, a jeśli późniejsza edycja użyje numeru ponownie, generacja rośnie o jeden, więc przestarzałe 12 0 R nie rozwiąże się po cichu do nowego 12 1 obj. Prawie każdy obiekt, jaki spotkasz, ma generację 0. Rozwiązywanie zaczyna się od katalogu, obiektu 1 we fragmencie, którego wpis /Pages prowadzi do drzewa stron; węzły wewnętrzne zbierają strony w /Kids, pilnują /Count i mogą przekazywać atrybuty typu /MediaBox w dół, swoim potomkom. Czemu to drzewo, a nie fizyczna kolejność obiektów, rozstrzyga kolejność stron, opisuje drzewa stron PDF a kolejność stron
Jak tabela xref lokalizuje obiekt?
Tabela xref zamienia numer obiektu w przesunięcie bajtowe arytmetyką, i dlatego podręcznik na 2000 stron otwiera się na stronie 1500 bez parsowania stron przed nią. ISO 32000-1 §7.5.4 ustala każdy wpis na dokładnie dwadzieścia bajtów: dziesięciocyfrowe przesunięcie liczone od początku pliku, spacja, pięciocyfrowa generacja, spacja, jednoliterowy typ i dwubajtowy koniec linii, który przy LF to spacja plus znak nowej linii. Ponieważ wiersze są jednolite, czytnik indeksuje prosto do wiersza obiektu n. Linia 0 6 to nagłówek podsekcji, a wpis 0 jest zawsze wolny z generacją 65535 i przewodzi połączonej liście wolnych numerów obiektów. Każde inne przesunięcie musi wylądować na pierwszej cyfrze pasującego nagłówka N G obj, jak w 610-bajtowym pliku:
xref
0 6                  % 6 wpisów, zaczynając od obiektu 0
0000000000 65535 f   % wpis 0: początek listy wolnych
0000000019 00000 n   % obiekt 1 (katalog) zaczyna się przy bajcie 19
0000000068 00000 n   % obiekt 2 (drzewo stron) zaczyna się przy bajcie 68
0000000125 00000 n   % obiekt 3 (strona) zaczyna się przy bajcie 125
0000000263 00000 n   % obiekt 4 (font) zaczyna się przy bajcie 263
0000000333 00000 n   % obiekt 5 (strumień zawartości) zaczyna się przy bajcie 333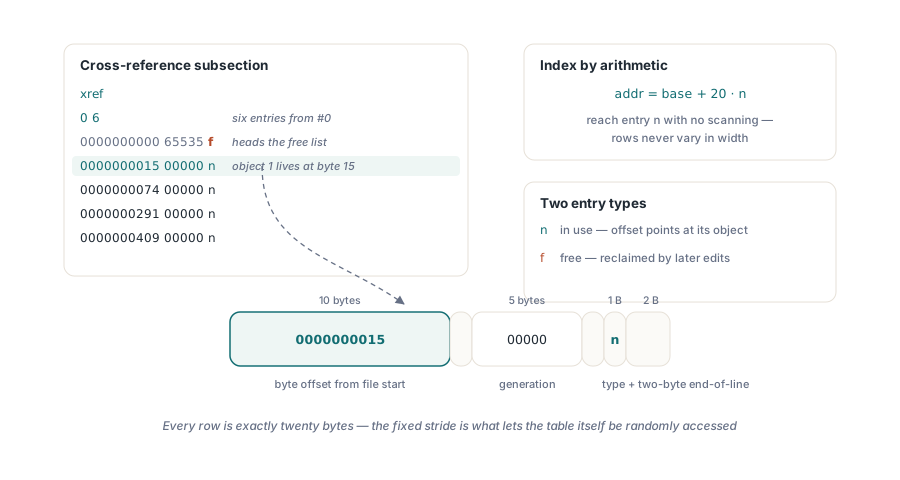
Dlaczego ucięty PDF odmawia otwarcia?
Ucięty PDF pada, bo dwie części spinające całość, tabela xref i trailer, są ostatnimi zapisanymi bajtami. Słownik trailera niesie /Root, katalog, i /Size, liczbę wpisów xref, o jeden więcej niż najwyższy numer obiektu, bo na pozycji zero siedzi wolny wpis. Pod nim startxref podaje przesunięcie bajtowe słowa kluczowego xref, a %%EOF zamyka plik:
trailer
<< /Size 6 /Root 1 0 R >>   % liczba wpisów, katalog dokumentu
startxref
427                          % przesunięcie bajtowe słowa kluczowego xref
%%EOF
Utracisz ostatnie kilkaset bajtów, a plik ma obiekty, ale bez mapy do nich. Surowe czytniki stają tam; tolerancyjne skanują cały plik w poszukiwaniu nagłówków N G obj i przebudowują tabelę, wolną ścieżkę, której xref istnieje po to, by unikać, a przebudowana mapa nadal może pominąć obiekty albo wybrać złą kopię obiektu edytowanego. Transfer w trybie tekstowym robi cichsze szkody, bo przepisywanie zakończeń linii przesuwa każdy obiekt. Skonwertowaliśmy 610-bajtowy plik do zakończeń CRLF i pusciliśmy qpdf --check (qpdf 12.3.2): raportował "file is damaged" i "xref not found" przy przesunięciu 427 i przebudował tabelę skanowaniem, zanim cokolwiek sprawdził
Klasyczna tabela xref czy strumień odsyłaczy?
Od PDF 1.5 xref może być też strumieniem odsyłaczy (ISO 32000-1 §7.5.8): obiektem pośrednim /Type /XRef, którego binarne wiersze zastępują tabelę tekstową, a którego słownik strumienia wchłania wpisy trailera, więc słowo kluczowe trailer znika, a startxref wskazuje ten obiekt. Typy wierszy stają się liczbami (0 wolny, 1 na przesunięciu bajtowym, 2 wewnątrz strumienia obiektów), /W podaje szerokość bajtową każdej kolumny, a HotPDF kompresuje wiersze Flate z predyktorem PNG Up. HotPDF pisze formę strumieniową, gdy Version wynosi pdf15 albo nowszy, więc przykład ustawia to jawnie, a UseObjectStreams buduje na tym samym przełączniku. Zostawiamy UseXRefStream wyłączone dla plików, które muszą otwierać się w narzędziach ery PDF 1.4, nieumiejących sparsować strumienia xref w ogóle, i włączamy dla dużych dokumentów, gdzie zwarty indeks się opłaca. Zmienia się tylko ogon pliku:
uses
  System.SysUtils, HPDFDoc;

procedure SaveWithXRef(const FileName: string; AsStream: Boolean);
var
  PDF: THotPDF;
begin
  PDF := THotPDF.Create(nil);
  try
    PDF.AutoLaunch := False;
    PDF.FileName := FileName;
    PDF.Version := pdf17;            // strumienie xref potrzebują PDF 1.5 albo nowszego
    PDF.UseXRefStream := AsStream;   // domyślnie False: tabela tekstowa plus trailer
    PDF.BeginDoc;
    PDF.CurrentPage.TextOut(72, 72, 0, 'Same page, different index');
    PDF.EndDoc;
  finally
    PDF.Free;
  end;
end;

// SaveWithXRef('table.pdf', False);
//   Oczekiwany ogon: xref, 0 N, wiersze po dwadzieścia bajtów,
//   trailer << /Size /Root /Info /ID >>, startxref, %%EOF
// SaveWithXRef('stream.pdf', True);
//   Oczekiwany ogon: N 0 obj << /Type /XRef /Size /Root /Info /ID /W ...
//   /Filter /FlateDecode >> stream ... endstream endobj, startxref, %%EOF
Aktualizacje przyrostowe dopisują drugi xref zamiast przepisywać
PDF można edytować bez dotykania jakiegokolwiek bajtu już leżącego na dysku. Zmienione i nowe obiekty są dopisywane, po nich idzie sekcja xref wyliczająca tylko je i trailer, którego wpis /Prev trzyma przesunięcie poprzedniej tabeli. Czytnik idzie za startxref do najnowszej sekcji, przechodzi łańcuch /Prev wstecz i pozwala wygrać najnowszemu wpisowi dla każdego numeru obiektu. Edycja poniżej dokłada adnotację notatki do 610-bajtowego pliku: obiekt strony 3 jest przepisany z tablicą /Annots pod tym samym numerem, a obiekt 6 jest nowy. Bez komentarzy i z zakończeniami LF przesunięcia są dokładne, a qpdf --check przeszedł na wyniku bez błędów:
% ... oryginalne 610 bajtów, bez zmian ...
3 0 obj                          % zastępuje stronę 3, ten sam numer obiektu
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792] /Resources << /Font << /F1 4 0 R >> >> /Contents 5 0 R /Annots [6 0 R] >>
endobj
6 0 obj                          % nowa adnotacja
<< /Type /Annot /Subtype /Text /Rect [72 650 92 670] /Contents (Checked) >>
endobj
xref                             % dwie jedno-wpisowe podsekcje
3 1
0000000610 00000 n
6 1
0000000752 00000 n
trailer
<< /Size 7 /Root 1 0 R /Prev 427 >>
startxref
843
%%EOF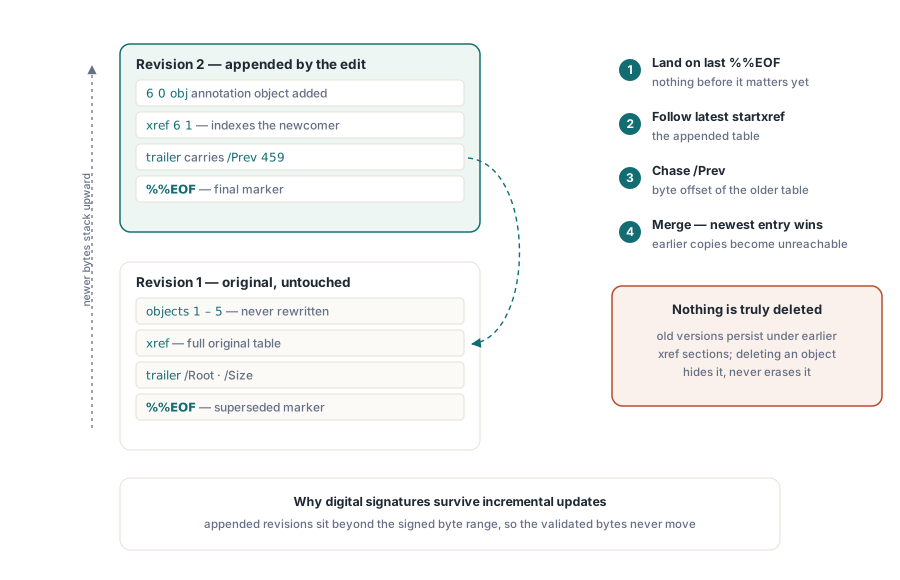
Dopisywanie utrzymuje podpisane PDF-y weryfikowalnymi: podpis obejmuje zakres bajtów, a aktualizacja przyrostowa nigdy nie rusza tych bajtów. To też powód, dla którego PDF niesie odzyskiwalną historię, bo stara strona 3 nadal siedzi przy bajcie 125, nieosiągalna, ale obecna. Pliki rewizowane wielokrotnie rosną w długi łańcuch /Prev; qpdf revised.pdf flat.pdf reserializuje osiągalne obiekty pod jednym xref i wyrzuca stare rewizje, co na pliku wyżej zostawiło jedną tabelę xref i żadnego /Prev, w cenie każdego podpisu nad oryginalnymi bajtami. W HotPDF przyrostowa rewizja wygląda tak:
procedure ReviseInPlace(const Original, Revised: string);
var
  PDF: THotPDF;
begin
  PDF := THotPDF.Create(nil);
  try
    PDF.AutoLaunch := False;
    PDF.BeginIncrementalUpdate(Original);   // trzyma oryginalne bajty słowo w słowo
    PDF.SetLoadedTitle('Quarterly report, revised');
    PDF.SetLoadedAuthor('Finance');
    PDF.SaveIncrementalUpdate(Revised);      // zmienione obiekty, nowy xref, trailer z /Prev
  finally
    PDF.Free;
  end;
end;
Czteroczęściowy układ daje też szybką kolejność triażu dla PDF-a, który źle się zachowuje: sprawdź, że plik kończy się %%EOF z sensownym startxref, potwierdź, że jedno albo dwa przesunięcia xref lądują na nagłówku N G obj, potem idź za /Root do katalogu i drzewa stron. HotPDF Delphi Component dla Delphi i C++Buildera pisze na życzenie klasyczne tabele xref albo strumienie odsyłaczy i dopisuje przyrostowe rewizje, które zostawiają wcześniejsze bajty, i podpisy nad nimi, nietknięte