Plik PDF jest w gruncie rzeczy zbiorem obiektów wskazujących nawzajem na siebie. Odrzuć kompresję, księgowość tablicy odwołań krzyżowych i przesunięcia bajtowe, a to, co zostaje, to graf: niewielki zbiór typowanych wartości, połączonych odwołaniami, zakorzeniony w jednym obiekcie, który czytnik potrafi znaleźć. Wszystko, co PDF może wyrazić, od akapitu tekstu, przez osadzoną czcionkę, po podpis cyfrowy, zbudowane jest z ośmiu prymitywnych typów obiektów oraz reguły pozwalającej jednemu obiektowi odwoływać się do drugiego. Poznaj je, a reszta formatu czyta się jako kompozycja, a nie tajemnica
To jest warstwa logiczna PDF, zdefiniowana w klauzuli 7.3 normy ISO 32000-1, i leży ona jeden poziom nad fizycznym układem pliku (nagłówek, treść, tablica odwołań krzyżowych i trailer, co jest osobnym tematem w technicznym przeglądzie struktury pliku PDF). Model logiczny to znaczenie tych bajtów po sparsowaniu. Przeglądarka czyta plik od końca, aby znaleźć trailer, podąża stamtąd do korzenia, i od tego miejsca dokument rozwija się jako obiekty odwołujące się do obiektów. To jest ta część, o której rozumuje się, debugując źle sformułowaną stronę, pisząc parser, albo ufając bibliotece, że złoży dokument
Osiem typów obiektów i nic więcej
PDF definiuje dokładnie osiem podstawowych typów obiektów. Każda wartość w dokumencie jest jednym z nich, co utrzymuje format w ryzach mimo jego zasięgu
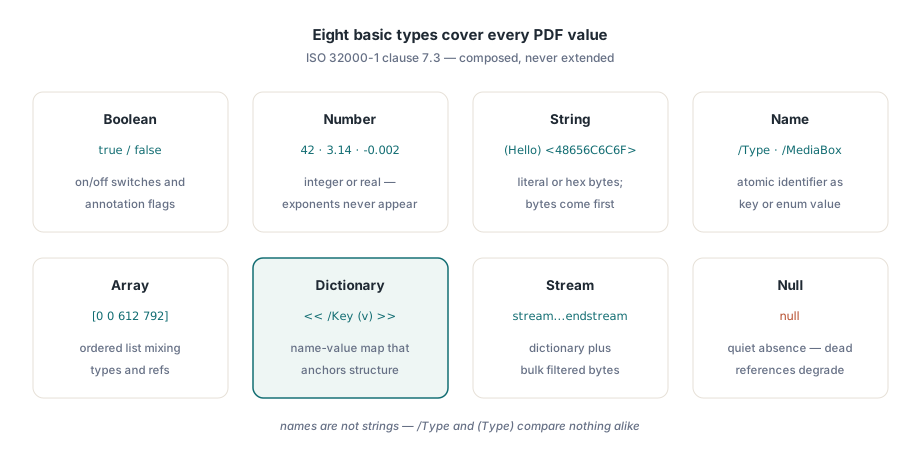
Wartości logiczne (Booleans) to słowa kluczowe true i false. Włączają i wyłączają flagi, na przykład to, czy adnotacja się drukuje
Liczby występują w dwóch odmianach, które specyfikacja traktuje jako jeden typ: całkowite, jak 42, i rzeczywiste, jak 3.14 czy -0.002. PDF nie ma notacji wykładniczej, więc w zgodnym pliku nigdy nie zobaczy się 1e6. Współrzędne, rozmiary czcionek i kąty obrotu to wszystko liczby
Ciągi znaków (Strings) przechowują sekwencje bajtów, zapisane albo w nawiasach okrągłych, (Hello), albo w nawiasach kątowych jako liczby szesnastkowe, <48656C6C6F>. Obie notacje kodują identyczną treść; zapis szesnastkowy to furtka dla bajtów niewygodnych wewnątrz nawiasów okrągłych. Ciągi znaków niosą tekst, ale są przede wszystkim bajtami, co ma znaczenie w chwili, gdy trzeba obsłużyć cokolwiek poza ASCII
Nazwy (Names) to atomowe tokeny wprowadzane ukośnikiem: /Type, /Pages, /MediaBox. Nazwa nie jest ciągiem znaków; jest identyfikatorem, używanym jako klucz słownika albo wartość wyliczeniowa, i dwie nazwy są sobie równe tylko wtedy, gdy zgadzają się bajt po bajcie. Ukośnik jest składnią, nie częścią nazwy. Nowicjuszy myli to, że traktują /Times-Roman i ciąg znaków (Times-Roman) jako wymienne; format tak tego nie traktuje
Tablice (Arrays) to uporządkowane, niejednorodne listy w nawiasach kwadratowych: [0 0 612 792] to prostokąt strony, a tablica może swobodnie mieszać typy, w tym odwołania do innych obiektów. Słowniki (Dictionaries) to koń pociągowy formatu. Zapisany między << a >>, słownik mapuje klucze-nazwy na wartości dowolnego typu, i niemal każda znacząca struktura w PDF, strona, katalog, czcionka, adnotacja, jest słownikiem z kluczem /Type deklarującym, czym jest
Strumienie (Streams) to słowniki z ogonem surowych bajtów między słowami kluczowymi stream i endstream. Słownik opisuje bajty (ich długość i wszelkie filtry, takie jak FlateDecode, które je kompresują), a bajty niosą tę obszerną treść: instrukcje treści strony, programy osadzonych czcionek, obrazy. Strumień to miejsce, w którym PDF umieszcza wszystko, co za duże albo za bardzo binarne, żeby siedzieć w linii
Ósmym typem jest obiekt null, słowo kluczowe null. To realna wartość, odrębna od braku klucza. Wpis słownika ustawiony na null jest traktowany tak, jakby go nie było, a odwołanie, które rozwiązuje się do nieistniejącego obiektu, też daje null, a nie błąd. To wyrozumiałe zachowanie jest celowe: pozwala uszkodzonemu plikowi zdegradować się zamiast odmówić otwarcia. Nie ma dziewiątego typu; wszystko, co wyraża PDF, powstaje z tego, jak łączy się tych osiem
Wartości bezpośrednie, obiekty pośrednie i odwołania
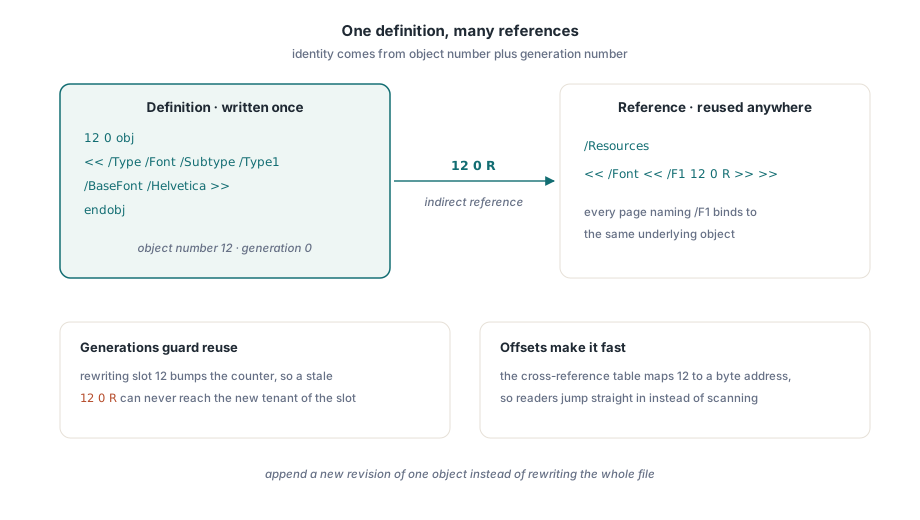
Każdy z tych ośmiu typów może wystąpić na dwa sposoby. Obiekt bezpośredni jest zapisany na miejscu, jak 612 wewnątrz tablicy MediaBox. Obiekt pośredni otrzymuje tożsamość, dzięki czemu inne obiekty mogą na niego wskazywać: dwie liczby całkowite, numer obiektu i numer generacji, opakowujące definicję w obj i endobj:
12 0 obj
<< /Type /Font /Subtype /Type1 /BaseFont /Helvetica >>
endobj
To jest obiekt 12, generacja 0, słownik czcionki. Gdziekolwiek indziej w pliku inny obiekt odwołuje się do niego za pomocą odwołania pośredniego: te same dwie liczby, po których następuje słowo kluczowe R, 12 0 R. Odwołanie to wskaźnik. Kiedy słownik zasobów strony mówi /Font << /F1 12 0 R >>, nazywa obiekt 12 czcionką stojącą za nazwą zasobu /F1, bez kopiowania definicji czcionki do strony
Numer generacji istnieje ze względu na usunięcia i ponowne użycie. Kiedy obiekt zostaje zwolniony, a jego slot ponownie użyty, generacja się zwiększa, tak aby nieaktualne 12 0 R nie rozwiązywało się do nowego lokatora slotu 12. Świeżo zapisane pliki mają niemal zawsze generację 0, ale mocno edytowany plik może nosić wyższe numery, a parser ignorujący generację prędzej czy później odczyta zły obiekt
Pośredniość jest tym, co czyni PDF wydajnym i edytowalnym. Jedna czcionka, obraz czy przestrzeń kolorów może zostać zdefiniowana raz i przywoływana ze stu stron. Drobna zmiana może zostać dopisana jako nowa rewizja zastępująca pojedynczy obiekt, zamiast przepisywać cały plik. Tablica odwołań krzyżowych to indeks zamieniający numer obiektu na przesunięcie bajtowe, dzięki czemu czytnik skacze prosto do 12 0 obj bez skanowania, ale to jest optymalizacja fizyczna. Logicznie wystarczy wiedzieć, że 12 0 R oznacza „obiekt zidentyfikowany jako 12 0”
Katalog: miejsce, w którym zaczyna się każdy dokument
Rozwiązywanie odwołań musi od czegoś zacząć, i tym czymś jest wpis /Root w trailerze, który wskazuje na katalog dokumentu: korzeń grafu obiektów, słownik z /Type /Catalog. Czytnik dociera do niego jako pierwszego, ponieważ trailer jest znajdowany jako pierwszy, a stamtąd każda inna część dokumentu jest osiągalna przez podążanie za odwołaniami
Katalog niesie tylko dwa ściśle wymagane wpisy: swój /Type oraz /Pages, odwołanie pośrednie do korzenia drzewa stron. Reszta jest opcjonalna i opisuje zachowanie całego dokumentu, a nie treść: /Outlines wskazuje na drzewo zakładek, /Names przechowuje drzewa nazw indeksowane ciągiem znaków, /Metadata odwołuje się do strumienia metadanych XMP, a /PageMode i /PageLayout sugerują, jak przeglądarka powinna otworzyć dokument. Żaden z nich nie jest potrzebny do wyrenderowania strony; konfigurują one otoczenie wokół stron. Struktury zakładek, metadanych i adnotacji zwisające z katalogu są omówione w artykule o metadanych, zakładkach i adnotacjach PDF
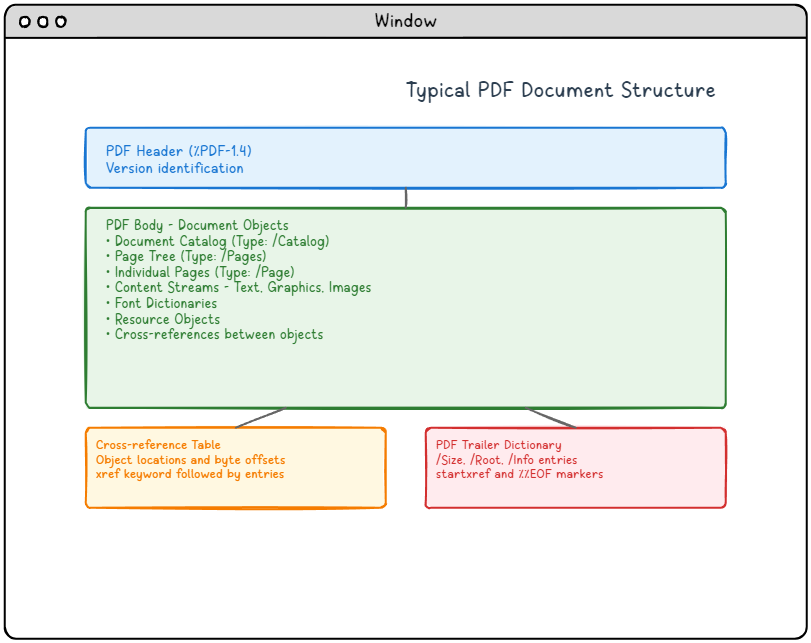
Poniższy diagram pokazuje, gdzie treść obiektów siedzi w otaczającym ją pliku. Katalog i drzewo stron żyją wewnątrz tej treści jako zwykłe obiekty pośrednie; nagłówek, tablica odwołań krzyżowych i trailer wokół nich to fizyczne rusztowanie, które pozwala czytnikowi je zlokalizować
Drzewo stron: zrównoważona hierarchia stron
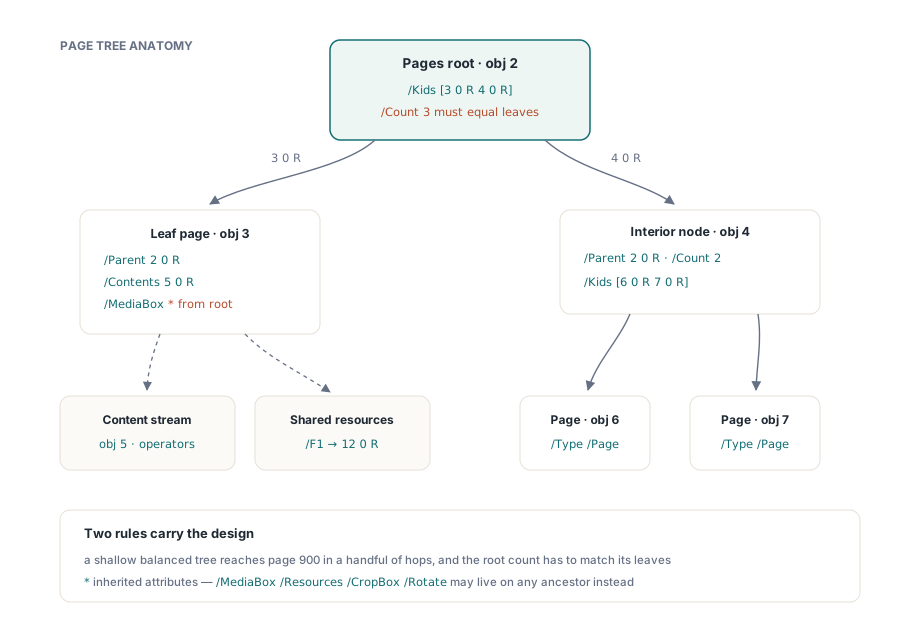
Od /Pages dokument rozgałęzia się w drzewo stron, gdzie wybór grafu zamiast płaskiej listy przez PDF się opłaca. Strony nie są przechowywane jako prosta sekwencja; zwisają z drzewa, którego węzły wewnętrzne to węzły drzewa stron (/Type /Pages), a liście to obiekty stron (/Type /Page). Węzeł wewnętrzny wymienia swoje dzieci w tablicy /Kids i zapisuje w /Count, ile liściastych stron żyje pod nim. Każdy węzeł oprócz korzenia niesie odwołanie /Parent z powrotem w górę, więc drzewo przechodzi się w obu kierunkach
2 0 obj                                  % korzeń drzewa stron
<< /Type /Pages /Kids [3 0 R 4 0 R] /Count 3 >>
endobj

3 0 obj                                  % strona liścia
<< /Type /Page /Parent 2 0 R
   /MediaBox [0 0 612 792]
   /Resources << /Font << /F1 12 0 R >> >>
   /Contents 5 0 R >>
endobj

4 0 obj                                  % węzeł wewnętrzny grupujący dwie kolejne strony
<< /Type /Pages /Parent 2 0 R /Kids [6 0 R 7 0 R] /Count 2 >>
endobj
Tu obiekt 2 jest korzeniem, z trzema stronami pod sobą: liściastą stroną 3, plus dwoma kolejnymi osiągalnymi przez węzeł wewnętrzny 4. /Count korzenia, wynoszący 3, musi być równy całkowitej liczbie liści pod nim, a liczba niezgodna z rzeczywistą strukturą to częsty sposób, w jaki ręcznie edytowany plik się psuje. Sensem drzewa jest lokalność dostępu. Czytnik otwierający stronę 900 z tysiącstronicowego dokumentu nie przechodzi przez 900 obiektów; schodzi przez garstkę węzłów, ponieważ dobrze sformułowane drzewo pozostaje płytkie i zrównoważone. Budowanie takiego drzewa ręcznie jest wystarczająco kłopotliwe, żeby zobaczyć to od początku do końca, co robi przewodnik po budowaniu dokumentu PDF od zera
Drzewo zarabia na swoje utrzymanie po raz drugi dzięki dziedziczeniu. Garstka atrybutów strony, /Resources, /MediaBox, /CropBox i /Rotate, może zostać ustawiona na węźle wewnętrznym i pominięta na poszczególnych stronach, które wtedy dziedziczą wartość najbliższego przodka. Ustaw /MediaBox raz na korzeniu, a każdy liść otrzyma ten sam rozmiar strony bez powtarzania go; strona, która musi się różnić, deklaruje własny. To jedyne miejsce w modelu obiektowym, gdzie znaczenie wartości zależy od pozycji obiektu w drzewie, a nie tylko od jego własnej zawartości
Co faktycznie zawiera strona-liść
Obiekt strony to punkt złączenia modelu strukturalnego z widoczną treścią. Jego wpis /Contents odwołuje się do jednego lub więcej strumieni treści, operatorów rysujących, które malują tekst i grafikę na stronie. Jego słownik /Resources nazywa czcionki, obrazy i przestrzenie kolorów, na których te operatory polegają, każdy wpis to odwołanie pośrednie do obiektu współdzielonego między stronami. /MediaBox podaje prostokąt strony w punktach (1/72 cala), a wpisy takie jak /Rotate i /CropBox dostosowują sposób jej prezentacji
Ten podział pracy to cały model w miniaturze. Słownik strony to struktura: typowane wpisy i odwołania mówiące, czym jest strona i czym rysuje. Strumień treści to instrukcje: osobny, kompresowalny blob mówiący, jak rysować. Czcionka stojąca za /F1 jest zasobem współdzielonym, zdefiniowanym raz i wskazywanym wszędzie, gdzie jest używana. Słownik, strumień i odwołanie współpracują, aby wyrenderować jedną stronę, a te same wzorce skalują się na cały dokument. Operatory strumienia treści wewnątrz tego bloba są omówione osobno dla tekstu i czcionek oraz dla grafiki i elementów wizualnych
/Count i może przekazywać w dół atrybuty jak /MediaBox każdemu potomkowiDlaczego warto znać ten model
Większość programistów spotyka model obiektowy dopiero wtedy, gdy coś się psuje: strona renderuje się pusta, bo jej odwołanie /Contents wisi w próżni, tekst wychodzi jako prostokąty, bo zasób czcionki nigdy nie został osadzony, narzędzie zgłasza /Count, który nie zgadza się z liczbą znalezionych stron. Każdy z tych przypadków to stwierdzenie o grafie, a czytanie grafu bezpośrednio bije zgadywanie. Osiem typów i reguła odwołań to słownictwo wystarczająco małe, by zmieścić się w głowie, a gdy raz zobaczy się PDF jako obiekty wskazujące na obiekty, źle sformułowane pliki przestają być nieprzejrzyste
To powiedziawszy, pisanie modelu ręcznie rzadko jest właściwym wyborem poza nauką. Utrzymywanie spójności przesunięć w tablicy odwołań krzyżowych, numerów generacji, liczników drzewa stron i długości strumieni między edycjami to rodzaj księgowości, do której istnieje biblioteka. W produkcji dojrzała biblioteka do tworzenia PDF zarządza grafem obiektów, pozostawiając myślenie o stronach i treści programiście. Znajomość modelu wciąż się opłaca: rozumie się, co biblioteka buduje pod spodem i dlaczego