Dwa wątki dzielą jeden TFileStream nad pakietem .xlsx. Wątek A ustawia Position na pierwszym skompresowanym bajcie sheet1.xml, wątek B chwilę później ustawia go na pierwszym bajcie sheet2.xml, a Read wątku A zwraca bufor należący do drugiego członka. Inflater wątku A dekoduje teraz środek cudzego strumienia deflate; zlib zwykle staje z Z_DATA_ERROR po kilku blokach, a jeśli akurat wyprodukuje wyjście, CRC32 członka się nie zgodzi. Deflate nie jest tu problemem. Wyścig mieszka całkowicie w kursorze pozycji strumienia, i jedna blokada wokół pary seek-odczyt wystarcza, by wiele workerów inflatowało członków tego samego pakietu naraz
Powód, dla którego ktokolwiek tego chce, to pamięć. Załóżmy skoroszyt 80 MB na dysku, którego XML arkuszy rozszerza się po rozprężeniu pięciokrotnie do dziesięciokrotnie. Ścieżka otwarcia, która wyciąga każdy arkusz do bufora przed sparsowaniem go, płaci za te rozprężone bajty na wierzchu skoroszytu, który właśnie buduje, a szczyt przychodzi, zanim istnieje jakakolwiek komórka. Ten artykuł omawia współbieżność na poziomie pakietu, która usuwa krok ekstrakcji. Sufit alokatora nad nim omawia artykuł o równoległym parsowaniu XLSX i menedżerze pamięci, a API czytaj-jednorazowo, które w ogóle nie buduje skoroszytu, to przewodnik po strumieniowym czytniku bezpośrednim
Projekt odstawiający i to, co trzyma w pamięci
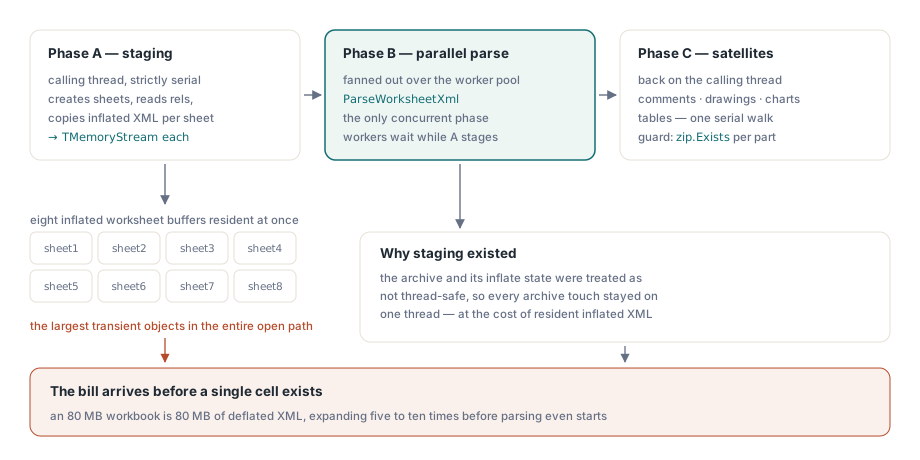
Ostrożny sposób na zrównoleglenie otwarcia XLSX to trójfazowy potok, w którym tylko środkowa faza biegnie na workerach. Faza A przechodzi listę arkuszy na wątku wywołującym, tworzy każdy arkusz, czyta jego część relacji i kopiuje cały rozprężony XML arkusza do prywatnego TMemoryStream. Faza B rozprasza parsowanie XML na pulę wątków. Faza C wraca do archiwum, wciąż na wątku wywołującym, po małe satelickie części: komentarze, komentarze wątkowane, rysunki, wykresy i tabele
Argument za tym kształtem brzmi nie do obalenia. Archiwum ZIP i jego stan inflate nie są thread-safe, więc trzymaj każdy kontakt z archiwum na jednym wątku i odpuść blokady całkiem. Rachunek to skoroszyt z ośmioma zajętymi arkuszami trzymający w tym samym momencie osiem w pełni rozprężonych buforów arkuszy, a te bufory to największe przejściowe obiekty w całej ścieżce otwarcia. Przy zakładanym wyżej pakiecie 80 MB to kilkaset megabajtów tekstu XML, który istnieje tylko po to, żeby parser mógł go przeczytać raz
HotXLS zostawia fazy A i C, ale wyrzuca kopię. Każdy worker w fazie B otwiera własny strumień wpisu na współdzielonym pakiecie i podaje go prosto czytnikowi XML, więc rozprężony arkusz nigdy nie istnieje jako jeden kawałek. To działa tylko dlatego, że argument "nie thread-safe" okazuje się o dwóch różnych rzeczach
Czy dwa wątki mogą inflatować z jednego strumienia ZIP?
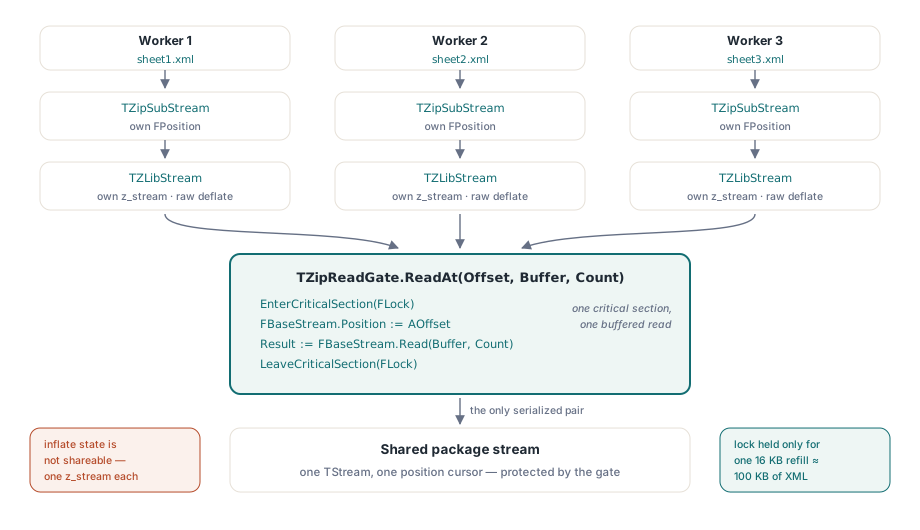
Tak, pod warunkiem, że każdy wątek posiada swój inflater, a współdzielone źródło bajtów jest serializowane przy odczycie. Ostrożny argument składa dwa rodzaje stanu w jedno zdanie. Stanu inflate naprawdę nie da się dzielić: zlibowy z_stream niesie 32 KB przesuwne okno, które definiuje RFC 1951, bieżące tabele Huffmana i pozycję bitową wewnątrz jednego skompresowanego członka, a dwa wątki pchające bajty przez ten sam produkują śmieci. Źródło bajtów to inna sprawa. Strumień pliku ma dokładnie jeden kawałek mutowalnego stanu wartego ochrony: swoją pozycję
Kontener ZIP czyni ten rozdział legalnym. APPNOTE firmy PKWARE (sekcja 4.3) układa pakiet jako niezależne członki, każdy z własnym lokalnym nagłówkiem pliku, własnymi skompresowanymi danymi na własnym offsetcie i własnym CRC32 oraz rozmiarami zapisanymi w katalogu centralnym. Żaden słownik nie rozciąga się na członki tak jak blok solid w 7z, więc wpis N da się rozprężyć bez czytania bajta wpisu M. Daj każdemu workerowi prywatny inflater nad własnym zakresem bajtów, a jedyną pozostałą kolizją jest seek. W HotXLS tę kolizję obsługuje TZipReadGate w lxZipArchive.pas, a cała klasa mieści się na jednym ekranie
type
  TZipReadGate = class
  private
    FBaseStream: TStream;
    FLock: TXLSCriticalSection;   // opakowanie lxPlatform nad sekcją krytyczną
  public
    constructor Create(ABaseStream: TStream);
    destructor Destroy; override;
    function ReadAt(AOffset: Int64; var Buffer; Count: Longint): Longint;
  end;

function TZipReadGate.ReadAt(AOffset: Int64; var Buffer;
  Count: Longint): Longint;
begin
  if Count <= 0 then
  begin
    Result := 0;
    Exit;
  end;
  XLSEnterCriticalSection(FLock);
  try
    FBaseStream.Position := AOffset;
    Result := FBaseStream.Read(Buffer, Count);
  finally
    XLSLeaveCriticalSection(FLock);
  end;
end;
Co blokuje bramka odczytu, a co zostaje poza nią
TZipReadGate.ReadAt strzeże jednej niepodzielnej operacji: pozycjonowania współdzielonego strumienia i czytania z niego. TZipArchive.OpenArchive buduje bramkę raz, po sparsowaniu katalogu centralnego, zarówno dla wariantu z nazwą pliku, jak i dla przeciążenia z TStream, a zwolnienie archiwum ją uwalnia. Archiwa stworzone do zapisu nigdy jej nie dostają, bo nikt z nich nie czyta współbieżnie
Wszystko inne zostaje poza blokadą, bo jest już prywatne albo już zamrożone. Każdy strumień wpisu, który zwraca TZipArchive.OpenFile, trzyma własną pozycję wewnątrz własnego członka i przelicza ją na absolutny offset pakietu dopiero w chwili wołania ReadAt. Inflater owinięty wokół niego jest tworzony per wpis z rozmiarem okna -15, co zlib czyta jako goły deflate bez nagłówka zlib, i nigdy nie trafia do innego wątku. Katalog centralny, z lokalnymi nagłówkami włącznie, jest w pełni sparsowany, zanim jakikolwiek worker ruszy, więc wyszukiwanie wpisu po nazwie jest w chwili startu współbieżności wyłącznie odczytem hasha. a nazwy zawierające segmenty .. są przy wyszukiwaniu odrzucane
Jedna konsekwencja ma znaczenie, gdy wołasz TXLSXWorkbook.Open(Stream) ze swoim własnym strumieniem. Bramka jest owinięta wokół tego strumienia, a jej blokada koordynuje workerów biblioteki między sobą. O twoim kodzie nie wie nic. Jeśli inny wątek twojej aplikacji czyta albo przestawia ten sam TStream, póki Open biegnie, wyścig kursora z pierwszego akapitu wraca, więc oddaj strumień i zostaw go w spokoju, aż Open wróci
Ile jedna blokada kosztuje pod rywalizacją?
Mniej niż sugeruje "globalna blokada na archiwum", biorąc pod uwagę, ile pracy pokrywa każde jej przejęcie. Inflater uzupełnia wejście w kawałkach 64 KB skompresowanych bajtów, więc jeden przebieg przez bramkę karmi workera 64 KB danych deflate, które potem dekoduje i parsuje, niczego nie trzymając. Przy zakładanym wcześniej rozszerzeniu pięcio- do dziesięciokrotnego to uzupełnienie staje się z grubsza 320 do 640 KB znaczników arkusza. Sama blokada obejmuje pozycjonowany odczyt, który zwykle obsługuje plikowy cache systemu operacyjnego
Proporcja odwraca się w trzech miejscach, a wszystkie dotyczą wejścia albo maszyny. Członki składowane bez kompresji przechodzą przez bramkę raz na wywołanie odczytu, bez roboty inflate między przejęciami; większość zapisywaczy deflatuje części arkuszy, ale pakiet wyprodukowany przez narzędzie wszystko składowujące serializuje się mocniej. Zimny plik na wolnym albo sieciowym magazynie poszerza sekcję krytyczną, bo odczyt wewnątrz niej staje się prawdziwym transferem. A ponad garstkę workerów bramka i tak nie jest pierwszym murem: parsowanie arkuszy alokuje ciężko, a delphiowski menedżer pamięci serializuje alokacje między wątkami na długo zanim bramka odczytu się nasyci
Ten ostatni punkt rozstrzyga liczbę wątków. TXLSXWorkbook.ParallelParseThreads ma domyślnie 0, co startuje jednego workera na logiczny procesor, nigdy więcej niż liczba arkuszy. Na laptopie z czterema do ośmiu logicznymi procesorami ten domyślny jest w porządku. Na serwerze budowania z 32 wątkami otwierającym skoroszyty z dziesiątkami arkuszy ustaw jawnie mały krawat, na przykład 4: nadmiarowi workerowie w większości stoją w kolejce do alokatora, a każdy trzyma własny inflater i bufory. Żeby znaleźć właściwą liczbę dla swoich plików, otwieraj jeden reprezentatywny skoroszyt w pętli z właściwością ustawioną na 1, 2, 4 i 8 i porównuj czas ścienny z szczytowym working setem w Task Managerze albo Process Explorerze
Przeczytanie wpisu do końca odpala kontrolę CRC
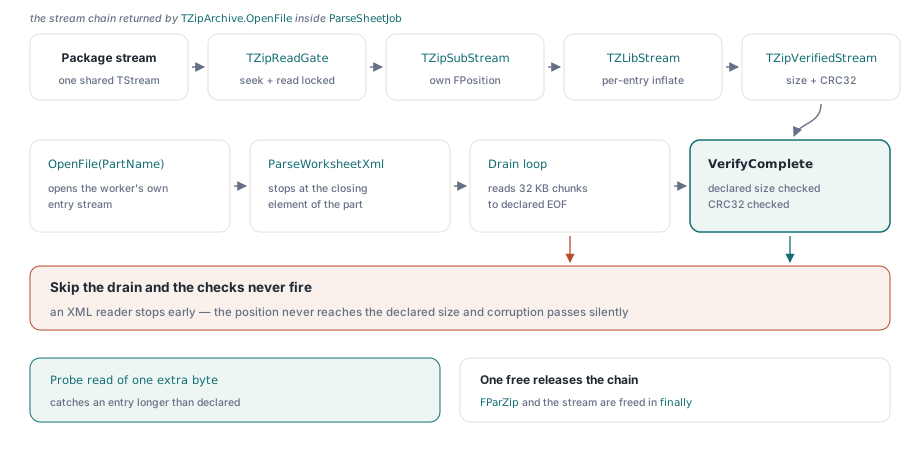
Każdy strumień wpisu, który zwraca archiwum, sprawdza sam siebie, ale dopiero na końcu. Akumuluje biegnący CRC32, kiedy bajty przez niego przechodzą, a gdy jego pozycja sięga rozmiaru nierozprężonego zapisanego w katalogu centralnym, porównuje obie wartości i sonduje jeden dodatkowy bajt. Porażki wychodzą jako wyjątki z dosłownymi komunikatami: 'ZIP entry uncompressed size mismatch', 'ZIP entry CRC32 mismatch', 'ZIP entry exceeds its declared size' i 'ZIP entry ended before its declared size' dla członka, który urywa się za wcześnie
Czytnik XML staje na tagu zamykającym </worksheet>. Wszystko po nim, często tylko kończący znak nowej linii, zostaje nieprzeczytane, pozycja nigdy nie sięga zadeklarowanego rozmiaru, a porównanie nigdy nie biegnie. Projekt odstawiający dostawał tę kontrolę gratis, bo kopiowanie wpisu do bufora czyta każdy bajt. Parser czytający strumień wpisu bezpośrednio nie, więc każdy worker HotXLS odprowadza to, co parser zostawił, buforem roboczym 32 KB, zanim zwolni strumień, a zwolnienie najbardziej zewnętrznego strumienia uwalnia inflatera i podstrumień pod nim
Ta sama reguła obowiązuje, gdy twój własny kod używa TZipArchive z lxZipArchive, na przykład do sanitarnej kontroli przychodzącego pakietu przed podaniem go loaderowi skoroszytów. Funkcja czytająca tylko pierwsze kilka kilobajtów każdej części, by węszyć jej element korzeniowy, nie dowodzi niczego o integralności. Czytaj do końca:
uses
  Classes, SysUtils, lxZipArchive;

// Czyta jedną część pakietu do jej zadeklarowanego końca, żeby odpaliły się kontrole rozmiaru i CRC32.
// PartIsIntact to funkcja pomocnicza, którą piszesz sam; nie jest częścią biblioteki
function PartIsIntact(Zip: TZipArchive; const PartName: WideString;
  out Problem: string): Boolean;
var
  Stream: TStream;
  Buffer: array [0..32767] of Byte;
begin
  Result := False;
  Problem := '';
  Stream := Zip.OpenFile(PartName);   // nil, gdy część nie istnieje
  if Stream = nil then
  begin
    Problem := 'part not found';
    Exit;
  end;
  try
    try
      while Stream.Read(Buffer, SizeOf(Buffer)) > 0 do
        ;
      Result := True;
    except
      on E: Exception do
        Problem := E.Message;          // np. 'ZIP entry CRC32 mismatch'
    end;
  finally
    Stream.Free;
  end;
end;

var
  Zip: TZipArchive;
  Problem: string;
begin
  Zip := TZipArchive.Create;
  try
    Zip.OpenArchive('quarterly-consolidation.xlsx');
    if not PartIsIntact(Zip, 'xl/worksheets/sheet1.xml', Problem) then
      Writeln('sheet1.xml: ', Problem);
  finally
    Zip.Free;
  end;
end;
Drugą pułapką w tym kodzie jest przewijanie z powrotem. Strumienie wpisów są tylko do przodu: przeczytanie Size działa, bo zadeklarowany rozmiar jest znany z góry, ale ustawienie Position := 0 po podglądzie podnosi 'ZIP entry stream is forward-only'. Jeśli komponent upiera się na seekowaniu, otwórz wpis drugi raz przez OpenFile, co jest tanie i daje świeży strumień na offsetcie zero. Kilka wątków może naraz wołać OpenFile na jednym archiwum otwartym do odczytu, bo dokładnie to robi loader skoroszytów, pod warunkiem, że nic nie zwalnia archiwum, póki ich strumienie żyją
Co wciąż biegnie sekwencyjnie i przełącznik, który to wyłącza
Faza A wciąż biegnie, minus ekstrakcja. Tworzy każdy arkusz i czyta jego relacje na wątku wywołującym, co sprawia, że każda współdzielona mapa jest niemutowalna, gdy tylko workery ruszą. Tablica ciągów współdzielonych i tabele formatów komórek są kompletne, zanim faza B się zacznie, i nigdy nie są w niej zapisywane. Faza C wciąż przechodzi arkusze po kolei później, dla komentarzy, rysunków, wykresów i tabel, pomijając każdy arkusz, którego części brak w pakiecie
uses
  SysUtils, lxHandleX;

var
  Wb: TXLSXWorkbook;
begin
  Wb := TXLSXWorkbook.Create;
  try
    Wb.ParallelParse := True;        // domyślnie; False parsuje arkusz po arkuszu
    Wb.ParallelParseThreads := 4;    // 0 = jeden worker na logiczny procesor
    Wb.SelectedSheets.Add('Q3 Detail');  // opcjonalnie: parsuj komórki tylko tego arkusza
    if Wb.Open('quarterly-consolidation.xlsx') <> 1 then
      raise Exception.Create('Workbook open failed');
    // Wczytany skoroszyt jest identyczny, niezależnie od parsującej ścieżki
  finally
    Wb.Free;
  end;
end;
Ustawienie ParallelParse na False przed Open puszcza tę samą robotę per arkusz z liczbą wątków jeden, a pula degeneruje się do zwykłej pętli na wątku wywołującym. Skoroszyt z pojedynczym arkuszem bierze tę ścieżkę niezależnie od wszystkiego. Miej ten przełącznik na oku przy diagnozowaniu problemu z otwarciem: usuwa wielowątkowość z obrazu jedną linijką, a obie ścieżki puszczają ten sam kod parsowania, więc skoroszyt, który dostaniesz z powrotem, nie zależy od tego ustawienia
Błędy też trzymają serialny kształt. Gdy worker podniesie wyjątek, żadne dalsze arkusze nie są wysyłane, wszyscy workerowie się złączają, a wyjątek z najniższego indeksu arkusza jest podnoszony ponownie na wątku wywołującym, więc zepsuty sheet3.xml nadal wychodzi jako jeden wyjątek z Open. Przy RecoveryMode ustawionym na True arkusz, który nie chce się sparsować, jest pomijany i zapisywany jako ostrzeżenie w diagnostyce skoroszytu. Arkusze wypuszczone z SelectedSheets nigdy w ogóle nie otwierają swojego strumienia wpisu, a MetadataOnly pomija fazę równoległą całkiem. Szersze dostrajanie ścieżki otwarcia omawia przewodnik po wydajności dużych skoroszytów w Delphi
Bramka odczytu, równoległa faza otwarcia i wpisowy dostęp ZIP pokazane tutaj są częścią HotXLS Delphi Excel component dla Delphi i C++Buildera, który płynie z pełnym źródłem, więc możesz czytać lxZipArchive.pas obok właściwości otwarcia TXLSXWorkbook opisanych na stronie produktu