Loader Delphi, który parsuje ośmioarkuszowy pakiet XLSX na ośmiu wątkach roboczych, potrafi pokazać wykres CPU ledwo wzbijający się ponad jeden rdzeń, a przemiatanie liczbą wątków od dwóch do ośmiu zostawia stoper praktycznie w tym samym miejscu. Przy dwóch wątkach wczytanie potrafi wyjść nawet wolniej niż zwykła pętla szeregowa. Kod parsowania nie zakłada żadnych własnych blokad, a arkusze nie współdzielą danych, więc czekanie dzieje się gdzieś, o czym źródła nie wspominają: w menedżerze pamięci, do którego każdy z tych workerów dzwoni przy każdej nazwie elementu, wartości atrybutu i komórce
Liczba wątków to pokrętło, po które sięga się jako pierwsze. Dla kodu ograniczonego alokacjami prawie nic nie zmienia. Krzywą rusza inna rzecz: ile alokacji na stercie kosztuje każda komórka
Jak HotXLS dzieli Open na trzy fazy
HotXLS domyślnie parsuje arkusze wieloarkuszowego pakietu XLSX na wątkach roboczych. TXLSXWorkbook.ParallelParse startuje jako True, a ParallelParseThreads startuje jako 0, co znaczy jeden worker na każdy logiczny procesor zgłoszony przez system operacyjny i nigdy więcej workerów niż arkuszy do sparsowania. Tylko jedna z trzech faz Open biegnie na tych workerach. Faza A jest szeregowa: czyta część workbook, shared strings i style, tworzy każdy arkusz wraz z jego nazwą i widocznością oraz parsuje plik relacji każdego arkusza, tak by cele hiperłączy i tabel były już rozwiązane. Zanim worker zacznie pracę, każda tabela, po której zagląda, jest kompletna i jest wyłącznie czytana
Faza B oddaje każdy arkusz workerowi. Workery pobierają indeksy arkuszy ze współdzielonego licznika operacją interlocked, więc skoroszyt z jednym wielkim arkuszem i siedmioma małymi wyważa się bez harmonogramu: kto skończył mały arkusz, bierze po prostu kolejny indeks. Kontenerem, którego nie da się naiwnie współdzielić, jest ZIP, bo strumień deflate niesie stan z bloku na blok i dwa wątki nie pchną tego samego dekompresora do przodu. Dlatego każdy worker otwiera własny dekompresor na swoim wpisie arkusza i ciurkiem prowadzi XML prosto do własnego czytnika. Jedynym współdzielonym zasobem jest uchwyt pliku, a blokada wokół niego obejmuje pojedynczy seek-and-read skompresowanych bajtów. Dekompresja i parsowanie biegną równolegle, a XML żadnego arkusza nigdy nie jest trzymany w pamięci w pełni rozpakowany. Gdy parsowanie się kończy, worker czyta swój wpis do końca, by kontrole rozmiaru i CRC z ZIP-a wciąż przeszły
Faza C wraca na jeden wątek dla części doklejonych do każdego arkusza: komentarzy i wątków komentarzy, rysunków i wykresów, tabel oraz ustawień drukarki. W większości skoroszytów to drobiazg obok XML-a komórek
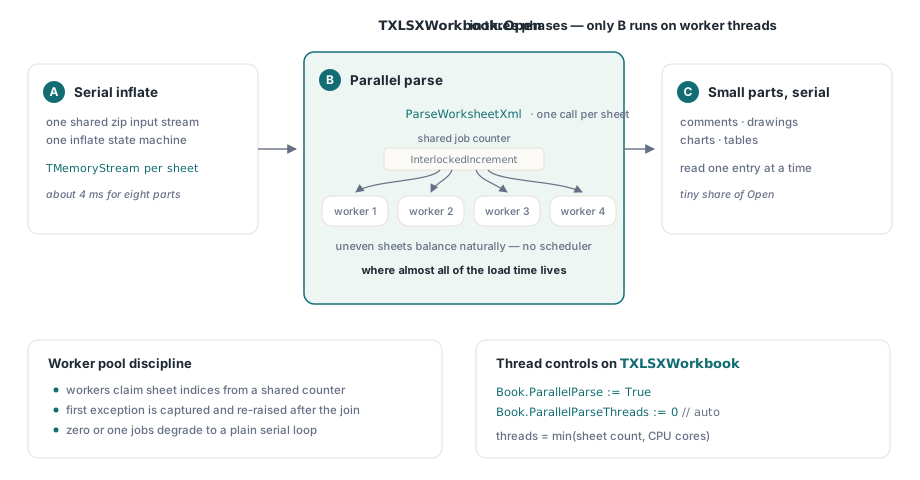
Błędy wracają na wątek wywołujący. Gdy arkusz rzuca podczas parsowania, pula przestaje rozdawać nowe indeksy, czeka na workery, które jeszcze biegną, a potem wznawia z Open wyjątek arkusza o najniższym numerze, który padł, więc raport idzie w kolejności arkuszy, a wołający nigdy nie musi się zmagać z wyjątkiem uciekającym z wątku roboczego. Przy RecoveryMode ustawionym na True arkusz, którego nie udało się sparsować, jest zamiast tego pomijany, ostrzeżenie ląduje w Diagnostics, a pozostałe arkusze wczytują się normalnie. Ustawienie ParallelParse na False puszcza ten sam parser po arkuszach pojedynczo i daje identyczne wyniki
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    // Obie wartości są domyślne; wypisanie ich wprost robi wybór
    // widocznym podczas przeglądu kodu
    Book.ParallelParse := True;
    Book.ParallelParseThreads := 0;  // 0 = jeden worker na logiczny CPU, ograniczony liczbą arkuszy
    Book.RecoveryMode := False;      // arkusz, którego nie da się sparsować, rzuca wyjątek z Open
    if Book.Open('quarterly-ledger.xlsx') <> 1 then
      raise Exception.Create('open failed');
    // tutaj każdy arkusz jest w pełni wczytany; czytaj komórki jak zwykle
  finally
    Book.Free;
  end;
end;
Dlaczego dodatkowe wątki spowalniają parser mocno alokujący pamięć?
Parsowanie arkusza to w przeważającej mierze małe alokacje, a domyślny menedżer pamięci Delphi ustawia do nich wątki w kolejce. Naiwny czytnik XML produkuje string na każdą nazwę elementu, drugi na każdą nazwę i wartość atrybutu, Variant dla komórki i string na jej tekst. Domyślny menedżer pamięci trzyma małe bloki w pulach pogrupowanych według rozmiaru i strzeże każdej puli blokadą. Wątek, który zastaje blokadę zajętą, cofa się i zasypia przed ponowną próbą. Gdy ośmiu workerów prosi o te same garście malutkich rozmiarów, ciągle zderzają się na tych samych pulach, a wątki wyglądające w źródłach na niezależne kończą w efekcie bieg jeden po drugim
To tłumaczy oba objawy z otwarcia artykułu. Czas CPU trzyma się blisko czasu zegarowego, bo śpiący wątek nie pali procesora, a przemiatanie wątkami zostaje płaskie, bo tempo wyznaczają blokady pul, nie rdzenie. Dwa wątki mogą przegrać z jednym z marszu: każda alokacja płaci teraz za podawanie blokady między rdzeniami, podczas gdy pętla szeregowa nigdzie się nie ściga
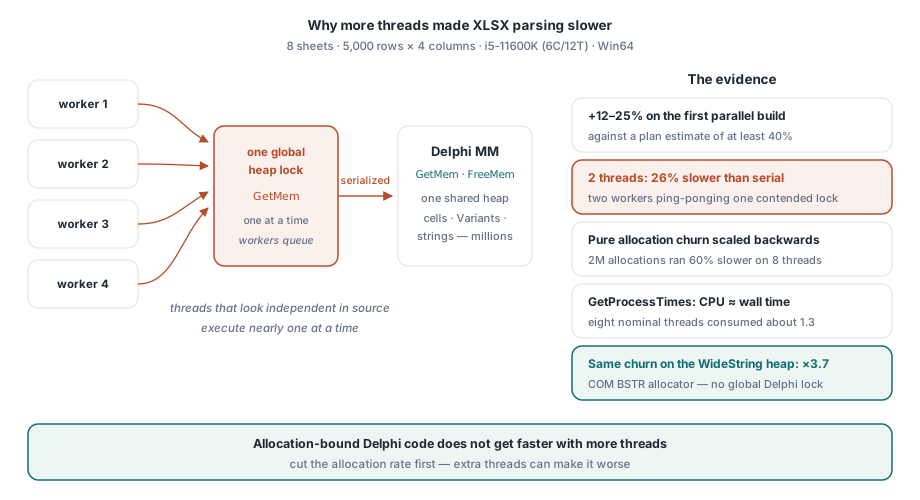
Jeden typ stringów stoi na Windows poza tym systemem. WideString to COM-owy BSTR, alokowany przez systemowy alokator stringów OLE, a nie przez menedżer pamięci Delphi, więc ruch WideString nigdy nie ustawia się w kolejce do pul Delphi. HotXLS trzyma tekst komórki jako WideString, co dla równoległego wczytywania znaczy więcej, niż kiedykolwiek znaczyło dla ścieżki szeregowej
Zmierz rywalizację na własnych skoroszytach
Dwie liczby mówią ci, czy wczytanie jest ograniczone alokacjami: jak zmienia się czas zegarowy wraz ze wzrostem liczby workerów i ile CPU proces zużył w tym samym interwale. Jeśli czas CPU podzielony przez czas zegarowy trzyma się w okolicy 1.0, gdy ośmiu workerów nominalnie pracuje, ustawiają kolejkę zamiast parsować. Pętla pomiarowa poniżej otwiera ten sam plik z liczbą workerów od jednego do ośmiu i wypisuje obie liczby. To harness pomiarowy dla twojego własnego projektu testowego; od HotXLS pochodzą tylko składowe TXLSXWorkbook
uses
  Winapi.Windows, System.SysUtils, System.Math, System.Diagnostics;

// Twój własny pomocnik: czas CPU user + kernel tego procesu, w milisekundach
function ProcessCpuMs: Int64;
var
  Created, Exited, Kernel, User: TFileTime;
begin
  GetProcessTimes(GetCurrentProcess, Created, Exited, Kernel, User);
  Result := (Int64(Kernel) + Int64(User)) div 10000;  // tiknięcia po 100 ns przeliczone na milisekundy
end;

procedure SweepThreads(const FileName: string);
var
  N: Integer;
  Book: TXLSXWorkbook;
  SW: TStopwatch;
  Cpu0, Cpu: Int64;
begin
  for N := 1 to 8 do
  begin
    Book := TXLSXWorkbook.Create;
    try
      Book.ParallelParseThreads := N;  // 1 puszcza zwykłą pętlę szeregową
      Cpu0 := ProcessCpuMs;
      SW := TStopwatch.StartNew;
      if Book.Open(FileName) <> 1 then
        raise Exception.CreateFmt('open failed: %s', [FileName]);
      SW.Stop;
      Cpu := ProcessCpuMs - Cpu0;
      Writeln(Format('%d workers: %d ms wall, CPU/wall %.2f',
        [N, SW.ElapsedMilliseconds, Cpu / Max(Int64(1), SW.ElapsedMilliseconds)]));
    finally
      Book.Free;
    end;
  end;
end;
Przemiataj kilka razy i zostaw najlepszy wynik dla każdej liczby workerów, bo otwierający przebieg płaci jeszcze za zimny dyskowy cache. Płaska krzywa czasu zegarowego z CPU/wall bliskim 1 znaczy, że sufitem jest menedżer pamięci. Jeśli czas zegarowy wciąż spada, a CPU/wall pnie się w stronę liczby workerów, plik ogranicza parsowanie i dodatkowi workerzy zarabiają swoje miejsce
Płaska krzywa prowokuje następne pytanie: które alokacje za to odpowiadają? Opakowanie menedżera pamięci zliczające wywołania według rozmiaru odpowiada na nie w kilka minut, bez żadnego profilera. Poniższa wersja zlicza tylko GetMem i zostawia FreeMem oraz ReallocMem wskazujące na oryginalny menedżer, a to wystarcza, by zobaczyć, skąd płynie ruch
// Diagnostyka dokładana do własnego harnessu testowego; nie jest częścią HotXLS
var
  OldMM, NewMM: TMemoryManagerEx;
  AllocCount, TinyCount: Int64;

function CountingGetMem(Size: NativeInt): Pointer;
begin
  AtomicIncrement(AllocCount);
  if Size <= 32 then
    AtomicIncrement(TinyCount);  // ruch małych bloków, który warto obserwować
  Result := OldMM.GetMem(Size);
end;

procedure InstallCounter;
begin
  GetMemoryManager(OldMM);
  NewMM := OldMM;
  NewMM.GetMem := CountingGetMem;
  SetMemoryManager(NewMM);
end;

procedure RemoveCounter;
begin
  SetMemoryManager(OldMM);
end;
Zainstaluj licznik tuż przed Open, zdejmij go tuż po, i podziel AllocCount przez liczbę komórek w pliku. Ta per-komórkowa liczba jest tą, którą śledzisz z builda na build, a udział bloków o rozmiarze do 32 bajtów pokazuje, czy dominują krótkie stringi. Sprawdź to, zanim napiszesz pulę obiektów komórek: każdy obiekt komórki to jedna alokacja, a krótko żyjące stringi powstające podczas parsowania tej komórki potrafią przewyższyć ją liczebnie kilka razy
Gdzie w XML arkusza kryją się alokacje
Komórka taka jak <c r="B7" s="3" t="s"><v>42</v></c> wygląda na dysku niepozornie. Prostolinijny czytnik i tak zamienia ją w serię świeżych stringów: nazwy elementów c i v, trzy nazwy atrybutów, trzy wartości atrybutów i zawartość tekstową. Konwersja każdego tokenu UTF-8 przez RTL dodaje pośredni UnicodeString, zanim powstanie finalny WideString. Żaden z tych stringów nie przeżyje komórki, a każdy z nich to podróż przez menedżer pamięci
Czytnik XML w HotXLS uderza w dwa największe źródła. Nazwy elementów w XML arkusza pochodzą z bardzo małego słownika (row, c, v, f, is), więc czytnik trzyma krótką pamięć podręczną już widzianych nazw, porównuje surowe bajty każdej nowej nazwy z tą pamięcią i przy trafieniu zwraca string z pamięci podręcznej. Buforowane kopie są świadomie AnsiString. AnsiString ma zliczanie referencji, więc wydanie buforowanej instancji kosztuje jedno zwiększenie licznika i zero alokacji. Pamięć podręczna nazw WideString nie kupiłaby nic: WideString nie ma licznika referencji, a każde przypisanie to nowa systemowa alokacja
Nazwy atrybutów, wartości atrybutów i tekst komórki idą drugą drogą. Czytnik dekoduje UTF-8 prosto z bufora skanowania w dwóch przebiegach: pierwszy liczy jednostki kodowe UTF-16, drugi wypełnia WideString alokowany raz, dokładnie na tę długość. To jedna alokacja na token i ląduje ona u systemowego alokatora stringów, a nie w pulach Delphi. Referencje znaków takie jak A i encje predefiniowane rozwiązuje skaner, zanim dekodowanie się zacznie, więc dekoder widzi wyłącznie czyste UTF-8. Dla sekwencji bajtów, które nie są poprawnym UTF-8, dekoder przepuszcza winne bajty pojedynczo, tam gdzie konwersja RTL wyrzuciłaby je lub zastąpiła, dzięki czemu uszkodzony plik wciąż daje czytelny ASCII wokół złego miejsca. Poprawne wejście dekoduje się tak samo w obu wypadkach
Oba chwyty przenoszą się do twojego własnego kodu parsującego w Delphi. Buforowanie stringów oszczędza alokacje tylko wtedy, gdy typ stringa ma zliczanie referencji, a dekodowanie prosto do typu docelowego usuwa tymczasowy obiekt, który wygodne funkcje konwersji RTL tworzą przy każdym wywołaniu
Które skoroszyty zyskują i jakie ustawienia wybrać
Parsowanie równoległe pracuje z ziarnistością arkusza, więc kształt skoroszytu rozstrzyga większość wyniku. Kilka arkuszy porównywalnego rozmiaru to przypadek idealny, w tym pliki, które dostajesz przez duplikowanie arkusza szablonu raz na region albo na miesiąc. Skoroszyt będący jednym gigantycznym arkuszem parsuje się na jednym workerze, cokolwiek mówi ParallelParseThreads; dla tego kształtu lepiej pasuje strumieniowy czytnik bezpośredni, bo nigdy nie buduje całego skoroszytu w pamięci. Czas spędzony na komentarzach, wykresach i rysunkach zostaje w szeregowej fazie C. Plik z zerem albo jednym arkuszem do sparsowania omija pulę i puszcza zwykłą pętlę szeregową
Gdy ważne są tylko niektóre arkusze, wypisz ich nazwy w SelectedSheets przed wywołaniem Open. Pozostałe arkusze wciąż powstają z nazwami i widocznością, ale bez komórek, workery je przelatują, a LoadSheet uzupełni któryś później, jeśli użytkownik go otworzy
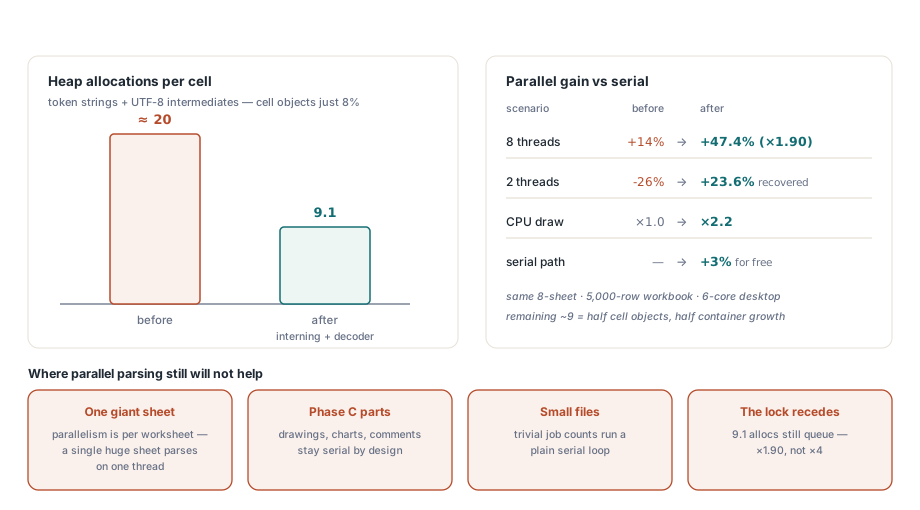
Zostaw ParallelParse włączone dla narzędzi desktopowych i zadań wsadowych otwierających jeden skoroszyt naraz. Ta wartość domyślna jest bezpieczniejsza: wyniki zgadzają się ze ścieżką szeregową, a jedna właściwość wyłącza ją, gdyby pytanie o wątki kiedyś się pojawiło. Serwer, który już otwiera kilka skoroszytów współbieżnie, to inna bajka. Każdy wątek żądań też alokuje, więc każdy dodatkowy worker parsowania dokłada kolejnego konkurenta do tych samych pul menedżera pamięci; ustaw tam ParallelParseThreads na 2 i podnoś tę wartość dopiero po tym, jak przemiatanie z góry, uruchomione na tym serwerze pod jego normalnym obciążeniem, pokaże, że dodatkowi workerzy się bronią. Mniej alokacji na komórkę podnosi sufit, ale go nie usuwa. Obiekty komórek i wzrost kontenerów wciąż przechodzą przez pule Delphi, dlatego zysk z ośmiu workerów zostaje daleko poniżej ośmiokrotności. O reszcie zestawu do wczytywania i zapisu, od ponownego użycia stylów po zbiorcze callbacki wierszy, opowiada przewodnik po wydajności dużych skoroszytów w Delphi
Równoległe analizowanie XLSX, właściwości ParallelParse i ParallelParseThreads oraz oszczędzający alokacje czytnik XML opisany w tym artykule są dostarczane jako standardowe elementy komponentu HotXLS Delphi Excel Component, który odczytuje i zapisuje formaty XLS, XLSX oraz ODS natywnie w Delphi i C++Builder bez użycia automatyzacji programu Excel