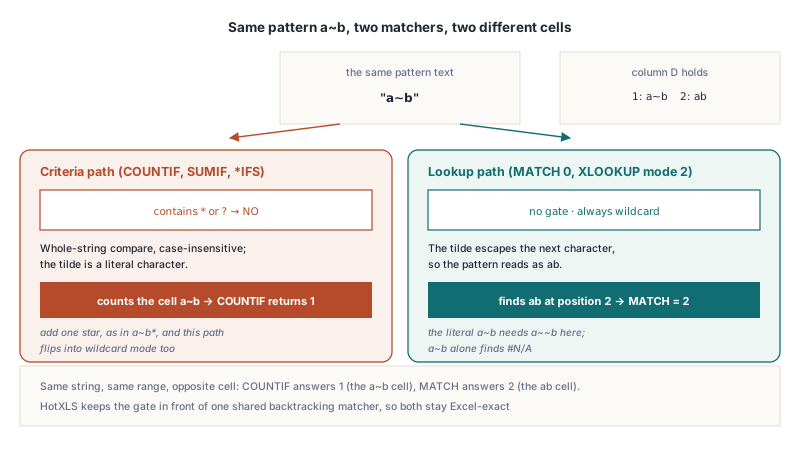
Przy a~b w D1 i ab w D2 formuła =COUNTIF(D1:D2,"a~b") zwraca 1, a liczy komórkę D1. =MATCH("a~b",D1:D2,0) zwraca 2, co wskazuje na D2. Ten sam wzorzec, te same dwie komórki, a Excel wybiera inną komórkę w zależności od tego, która funkcja czyta wzorzec. Silnik arkusza, który chce, by jego zapamiętane wyniki zgadzały się z Excelem, musi odtworzyć ten podział plus jeszcze dwie reguły: funkcje bazodanowe typu DSUM traktują goły tekst jako „zaczyna się od", a Find przy opcji całej komórki musi cofać się do ostatniej *
Raporty, które na to trafiają, rzadko wspominają o wildcardach. Mówią, że wygenerowany na serwerze skoroszyt liczy o dwa wiersze mniej niż ten sam plik przeliczony na desktopie, albo że numer części zawierający tyldę znajduje jedna formuła, a następna go ignoruje. Przepuszczanie każdego wzorca przez maskę plikową w stylu DOS daje trafienie w codziennych przypadkach, więc dryf ujawnia się dopiero, gdy w prawdziwych kodach produktów zaczną się pojawiać ~ albo [
Jeden wzorzec, cztery zestawy reguł Excela
Excel nigdy nie ujednolicił swoich reguł dopasowywania; każda funkcja przyniosła własne. Funkcje kryteriów (COUNTIF, SUMIF, AVERAGEIF i rodzina *IFS) decydują osobno dla każdego kryterium, czy wildcardy w ogóle obowiązują. Funkcje wyszukujące (MATCH z typem dopasowania 0, XLOOKUP z match_mode 2) stosują je zawsze. Funkcje bazodanowe (DSUM, DCOUNTA i reszta) dziedziczą regułę Advanced Filter, gdzie gołe słowo to prefiks. Okno Find ma własne tryby całej komórki i częściowy. HotXLS Delphi Component ewaluuje każdą rodzinę według jej własnych reguł, w klasycznym silniku i silniku XLSX. Tabela pokazuje, które komórki pasują do każdego wzorca w kolumnie trzymającej a~b, ab, AB, abc, abcb, a*b i axb, przy każdej funkcji w domyślnym trybie nieuwzględniania wielkości liter
| Wzorzec | COUNTIF / SUMIF | MATCH(…,0) / XLOOKUP tryb 2 | Kryterium DSUM | Find, cała komórka, wildcardy włączone |
|---|---|---|---|---|
ab | ab, AB | ab, AB | ab, AB, abc, abcb | ab, AB |
a*b | a~b, ab, AB, abcb, a*b, axb | jak w COUNTIF | każdy wpis, w tym abc | jak w COUNTIF |
a~b | tylko a~b | ab, AB | ab, AB, abc, abcb | ab, AB |
a~*b | tylko a*b | tylko a*b | tylko a*b | tylko a*b |
=ab | ab, AB | nie dotyczy | ab, AB | nie dotyczy |
Dwa wiersze zasługują na drugie spojrzenie. W wierszu a~b COUNTIF i MATCH lądują na różnych komórkach, a tyld w ręcznie wpisywanych kodach jest więcej, niż ktokolwiek planuje. W wierszu a*b abc pasuje dla DSUM i nie pasuje dla COUNTIF, bo funkcja bazodanowa po cichu dokleja * do kryterium. Wpis DSUM dla a~b wynika z tej samej doklejonej gwiazdki: skoro tam jest, kryterium jest wzorcem z wildcardami, a ~b jest po prostu escapowanym b
Kiedy COUNTIF włącza tryb wildcardów?
COUNTIF włącza tryb wildcardów tylko wtedy, gdy tekst kryterium zawiera * lub ?, escapowane czy nie. Bez żadnego z tych znaków kryterium jest porównywane z każdą komórką jako cały łańcuch, bez rozróżniania wielkości liter, a tylda jest zwykłym znakiem, więc COUNTIF(A1:A7,"a~b") liczy komórkę, która dosłownie trzyma a~b. Jedna gwiazdka odwraca znaczenie. W "a~b*" tylda escapuje teraz b, wzorzec czyta się jako „ab i potem cokolwiek", a komórka a~b wypada z licznika. HotXLS stosuje tę bramkę w COUNTIF, SUMIF, AVERAGEIF, COUNTIFS, SUMIFS, AVERAGEIFS, a także w funkcjach bazodanowych
Wewnątrz trybu wildcardów reguła escape jest krótka. ~ czyni dosłownym następny znak, cokolwiek to jest, więc ~b znaczy b, a ~~ znaczy jedną tyldę; tylda na samym końcu wzorca jest porzucana, więc "a*~" zachowuje się jak "a*". Nawiasy kwadratowe nigdy nie są specjalne. Kryterium "[x]" liczy komórki trzymające trzy znaki [x], a "[a-z]" nie liczy nic na zwykłych danych. Najszybszy sposób sprawdzenia tego na własnych danych to TXLSXWorkbook.Calculate, które ewaluuje łańcuch formuły na aktywnym arkuszu i zwraca Variant; świeży skoroszyt czyni pierwszy dodany arkusz aktywnym
uses
  System.Variants, lxHandleX;

const
  Names: array [1..7] of string = ('a~b', 'ab', 'AB', 'abc', 'abcb', 'a*b', 'axb');
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  i: Integer;

  procedure Show(const Formula: string);
  begin
    Writeln(Formula, ' = ', VarToStr(Book.Calculate(Formula)));
  end;

begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Data');            // pierwszy arkusz, więc jest aktywny
    for i := 1 to High(Names) do
    begin
      Sheet.Cells[i, 1].Value := Names[i];
      Sheet.Cells[i, 2].Value := 1 shl (i - 1);  // 1, 2, 4 ... więc suma SUMIF wskaże swoje wiersze
    end;
    Sheet.Cells[8, 1].Value := 5;                // liczba; A9 zostaje pusta

    Show('=COUNTIF(A1:A7,"a~b")');      // 1    brak * i ?: zwykły tekst, komórka a~b
    Show('=COUNTIF(A1:A7,"a~b*")');     // 4    tryb wildcardów: ab, AB, abc, abcb
    Show('=COUNTIF(A1:A7,"a*b")');      // 6    wildcard po całym łańcuchu, abc wykluczone
    Show('=SUMIF(A1:A7,"a*b",B1:B7)');  // 119  każdy wiersz poza abc (8)
    Show('=COUNTIF(A1:A7,"a~*b")');     // 1    dosłowne a*b
    Show('=COUNTIF(A1:A9,"<>ab")');     // 7    liczba 5 i pusta A9 się liczą
    Show('=COUNTIF(A1:A9,"<>")');       // 8    komórki niepuste
  finally
    Book.Free;
  end;
end.
Co tak naprawdę liczy „<>text"
Kryterium "<>text" liczy każdą komórkę, która nie jest tym tekstem, a w Excelu wchodzi w to liczby, wartości logiczne, wartości błędów i puste komórki. Gołe "<>" pyta o coś zupełnie innego: „niepusta komórka". Pomija puste komórki, ale liczy każdą wartość, łącznie z pustym tekstem, który zwraca formuła typu ="". Pułapka Delphi siedzi w porównaniu Variant. Porównanie 'ab' z numeryczną komórką sprawia, że Delphi próbuje skonwertować 'ab' na liczbę, konwersja się wykrusza, a handler połykający wyjątek jako „brak dopasowania" wyciąga komórki numeryczne z licznika. HotXLS je liczy, więc dwie ostatnie linie przykładu zwracają 7 i 8. Strona pustych komórek tego zagadnienia, łącznie z tym, do czego pusty operand jest równy w zwykłym porównaniu, jest opisana w artykule o łańcuchach porównań, pustych komórkach i SUMIF w HotXLS
Dlaczego MATCH znajduje ab, gdy szukasz a~b?
MATCH z typem dopasowania 0 i XLOOKUP z match_mode 2 są zawsze w trybie wildcardów, więc tylda jest escape'em nawet wtedy, gdy wzorzec nie zawiera ani *, ani ?. Na dwukomórkowym zakresie z otwarcia MATCH("a~b",D1:D2,0) zwraca 2. Na zakresie trzymającym tylko a~b to samo wywołanie zwraca #N/A. Wyszukanie dosłownego tekstu a~b wymaga "a~~b". Gdy klucze wyszukiwania pochodzą z wejścia użytkownika albo z zewnętrznego systemu i mogą zawierać tyldę, podwój każdą tyldę przed zbudowaniem formuły; ten jeden StringReplace jest tańszy niż późniejsze tłumaczenie brakującego wiersza
HotXLS trzyma te dwie decyzje osobno. MATCH, XLOOKUP i funkcje kryteriów dzielą jeden matcher z cofaniem, z tą samą obsługą escape i tą samą regułą końcowej tyldy; różni się bramka przed nim. Ścieżka kryteriów najpierw pyta, czy tekst zawiera * albo ?. Ścieżka wyszukująca nigdy nie pyta. Jeden wspólny punkt wejścia „dopasuj wzorzec" dla obu rodzin trafiałby jedną rodzinę dobrze, drugą źle — niezależnie od ustawienia bramki. Wyszukiwania z wildcardami niosą jeden warunek więcej: XLOOKUP zwraca #VALUE!, gdy match_mode 2 łączy się z trybem wyszukiwania binarnego, co jest opisane w przewodniku HotXLS po trybach wyszukiwania XLOOKUP i XMATCH
Kryteria DSUM: goły tekst znaczy „zaczyna się od"
DSUM i pozostałe funkcje bazodanowe czytają tekstowe kryterium bez wiodącego =, < albo > jako prefiks, przy nadal aktywnych wildcardach. To reguła Advanced Filter i celowo różni się od COUNTIF. Nad kolumną Name z abc, ab, xab i AB kryterium ab pasuje do abc, ab i AB, podczas gdy =ab pasuje tylko do ab i AB. <>ab to nierówność całego wpisu, a*b i a? też są wzorcami prefiksowymi, a >ab to zwykłe porównanie tekstowe. xab nigdy nie pasuje do ab; reguła brzmi „zaczyna się od", nie „zawiera"
Niewygodna strona dla implementacji: parser kryteriów, który zdejmuje operator, widzi ab i =ab jako ten sam test równości. Rozróżnia je tylko surowy tekst kryterium. HotXLS dlatego patrzy na surowy tekst, zanim zaufa sparsowanemu warunkowi: tekstowe kryterium, którego pierwszy znak nie jest =, < ani >, dostaje doklejoną * i przechodzi przez matcher wildcardów, a wszystko inne zachowuje porównanie całego wpisu
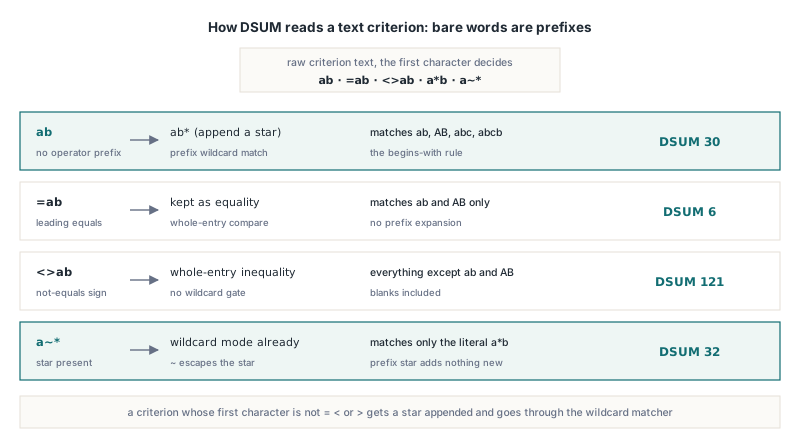
Zbudowanie zakresu kryteriów w kodzie ma jedną pułapkę specyficzną dla silnika. W silniku XLSX przypisanie łańcucha '=ab' do TXLSXCell.Value zapisuje tekst, czyli dokładnie to, czego potrzebuje komórka kryterium. Klasyczny silnik TXLSWorkbook kompiluje wartość łańcuchową zaczynającą się od = jako formułę, chyba że poprzedzisz ją apostrofem. Dla zakresów kryteriów budowanych w runtime silnik XLSX jest wyborem mniej podatnym na błędy. Pętla poniżej podmienia pięć kryteriów w D2 i za każdym razem przelicza to samo DSUM
const
  Names: array [1..7] of string = ('a~b', 'ab', 'AB', 'abc', 'abcb', 'a*b', 'axb');
  Criteria: array [0..4] of string = ('ab', '=ab', '<>ab', 'a*b', 'a~*');
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  i: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Db');
    Sheet.Cells[1, 1].Value := 'Name';
    Sheet.Cells[1, 2].Value := 'Val';
    for i := 1 to High(Names) do
    begin
      Sheet.Cells[i + 1, 1].Value := Names[i];
      Sheet.Cells[i + 1, 2].Value := 1 shl (i - 1);
    end;
    Sheet.Cells[1, 4].Value := 'Name';            // nagłówek kryteriów w D1
    for i := 0 to High(Criteria) do
    begin
      Sheet.Cells[2, 4].Value := Criteria[i];     // zostaje tekstem w silniku XLSX
      Writeln(Criteria[i], ' -> ',
        VarToStr(Book.Calculate('=DSUM(A1:B8,"Val",D1:D2)')));
    end;
    // ab   -> 30   ab, AB, abc, abcb (zaczyna się od)
    // =ab  -> 6    ab, AB (cały wpis)
    // <>ab -> 121  wszystko poza ab i AB
    // a*b  -> 127  a*b* pasuje do wszystkich siedmiu, w tym abc
    // a~*  -> 32   tylko dosłowne a*b
  finally
    Book.Free;
  end;
end;
Kryteria porządkujące typu >ab podlegają jeszcze innej regule. Zwykłe porównanie po punktach kodu daje dla "a~b">"ab" wynik TRUE, bo ~ siedzi nad wszystkimi literami w Unicode. Excel stawia interpunkcję przed literami i zwraca FALSE. Na Windows HotXLS ewaluuje tekstowe kryteria > i <, zwykłe porównanie tekstowe i sortowanie przy użyciu systemowego collation sortowania słów dla bieżących ustawień regionalnych użytkownika, więc wszystkie trzy zgadzają się między sobą i z Excelem
Find na całe komórki w Delphi: cofanie do ostatniej gwiazdki
Kuszący skrót dla Find na całych komórkach to użycie matchera częściowego stojącego za Replace z żądaniem, by dopasowanie pokryło całą komórkę. Na zwykłych danych to zawodzi. Matcher częściowy wraca, jak tylko wzorzec się wyczerpie, więc a*b przeciw abcb zatrzymuje się po ab — skonsumowane 2 z 4 znaków — i komórka jest odrzucana. HotXLS przepuszcza Find na całych komórkach przez osobny matcher, który traktuje „wzorzec się skończył, tekst nie" jako kolejne niedopasowanie i ponawia od ostatniej gwiazdki. Dzięki temu a*b pasuje do abcb, a a?b*b pasuje do axbyb, jak Find Excela z zaznaczonym „Match entire cell contents"
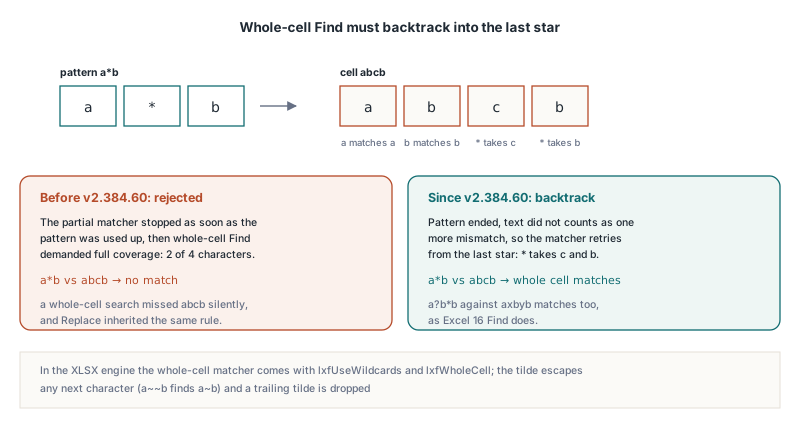
Find Excela, w trybie całej komórki i częściowym, traktuje ~ jako escape przed dowolnym następnym znakiem: a~b znajduje ab, a~~b znajduje a~b, a końcowa tylda jest ignorowana, więc q~ zachowuje się jak q. Matcher znający tylko ~*, ~? i ~~ sprawiłby, że a~b znajdzie tekst a~b — komórkę po przeciwnej stronie. HotXLS escapuje dowolny znak po tyldzie, w Find i Replace tak samo jak w formułach
W silniku XLSX to wywołanie TXLSXWorksheet.FindText z zestawem TXLSXFindOptions. lxfUseWildcards włącza *, ? i ~; lxfWholeCell wymaga dopasowania całej komórki; lxfMatchCase czyni porównanie czułym na wielkość liter. Bez lxfUseWildcards każdy znak, gwiazdka włącznie, jest dosłowny. Find patrzy wyłącznie na wartości tekstowe. Komórki numeryczne są pomijane, a komórki formuł są pomijane, dopóki nie ustawi się lxfSearchFormulas — wtedy przeszukiwany jest tekst formuły. lxfBackward i lxfByColumns zmieniają kolejność skanu. Kotwica wyznaczona przez StartRow i StartCol jest wliczana, więc pętla Find All musi skakać o jedną kolumnę za każdym trafieniem
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  Row, Col, NextRow, NextCol, Changed: Integer;
  Opts: TXLSXFindOptions;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Parts');
    Sheet.Cells[1, 1].Value := WideString('abc');
    Sheet.Cells[2, 1].Value := WideString('abcb');
    Sheet.Cells[3, 1].Value := WideString('a~b');
    Sheet.Cells[4, 1].Value := WideString('ab');

    Opts := [lxfUseWildcards, lxfWholeCell];
    if Sheet.FindText('a*b', Row, Col, Opts, 1, 1) then
      Writeln('a*b  whole cell -> row ', Row);   // 2: abc odrzucone, abcb przez backtracking
    if Sheet.FindText('a~b', Row, Col, Opts, 1, 1) then
      Writeln('a~b  whole cell -> row ', Row);   // 4: ~b to ubezpieczone b
    if Sheet.FindText('a~~b', Row, Col, Opts, 1, 1) then
      Writeln('a~~b whole cell -> row ', Row);   // 3: ~~ to jedna dosłowna tylda

    // Dopasowanie częściowe, Find All: komórka kotwicy jest wliczana, więc stawiaj krok za każdym trafieniem
    NextRow := 1;
    NextCol := 1;
    while Sheet.FindText('a*b', Row, Col, [lxfUseWildcards], NextRow, NextCol) do
    begin
      Writeln('a*b  contained in row ', Row);     // wiersze 1, 2, 3 i 4
      NextRow := Row;
      NextCol := Col + 1;
    end;

    // Zamiana z wildcardami na całą komórkę przepisuje tylko dosłowne a~b
    Changed := Sheet.ReplaceText('a~~b', 'a-b', Opts);
    Writeln(Changed, ' cell(s) replaced');         // 1
  finally
    Book.Free;
  end;
end;
Pętla częściowa zgłasza wszystkie cztery wiersze, w tym abc, bo w trybie częściowym a*b musi tylko wystąpić gdzieś w komórce. FindTextIn i ReplaceTextIn przyjmują te same opcje plus okno FirstRow, FirstCol, LastRow, LastCol — programową wersję szukania w ramach zaznaczenia; podaj 0 dla dowolnej granicy, by zostawić ją otwartą. Klasyczny silnik wystawia te same reguły dopasowania przez przeciążenie z trzema wartościami logicznymi, TXLSWorksheet.FindText(SearchText, Row, Col, MatchCase, UseWildcards, WholeCell), plus pasujące przeciążenie ReplaceText. Jego wyniki wiersza i kolumny są liczone od 1 i, jak wersja XLSX, pomijają komórki formuł oraz wartości nietekstowe
var
  Classic: IXLSWorkbook;
  Sheet: TXLSWorksheet;
  Row, Col: Integer;
begin
  Classic := TXLSWorkbook.Create;
  Sheet := Classic.Sheets.Add;
  Sheet.Range['A1', 'A1'].Value := 'abcb';
  // MatchCase = False, UseWildcards = True, WholeCell = True
  if Sheet.FindText('a*b', Row, Col, False, True, True) then
    Writeln('found at ', Row, ',', Col);           // 1,1
  if not Sheet.FindText('a*c', Row, Col, False, True, True) then
    Writeln('a*c does not cover abcb');
end;
Dlaczego maska plikowa DOS to zły matcher dla kryteriów Excela
Matcher masek plikowych, taki jak MatchesMask, mówi innym językiem niż wildcardy Excela, choć oba pokrywają się na * i ?. To pokrycie jest dokładnie powodem, dla którego bywa wybierany, i dlaczego jego błędy pozostają ukryte, dopóki dane nie staną się ciekawe:
[x]jest czytane jako zestaw znaków, więcCOUNTIF(A1:A10,"[x]")liczyłby komórki zxzamiast tekstu w nawiasach, a"[a-z]"pasowałby do każdej jednoznakowej komórki- Nie ma escape tyldą, więc
"a~*b"nie zdoła dopasować dosłownej gwiazdki - Zniekształcona maska, jak niedomknięty nawias, podnosi wyjątek, który wywołujący łatwo połknie jako „brak dopasowania", zamieniając literówkę w kryterium na złą sumę
- Po stronie wyszukiwania zestaw escape ograniczony do
~*,~?i~~też zawodzi:MATCH("a~b",…,0)ma znaleźćab, nie dosłownea~b
Jeśli twoje skoroszyty używają wyłącznie * i ? na zwykłych danych alfanumerycznych, wszystkie te matchery się zgadzają i nic z tego nie ma znaczenia. Nawiasy, tyldy, kolumny mieszanych typów pod "<>text" i kryteria DSUM zapisane jako gołe słowa to miejsca, gdzie sumy prostszego matchera dryfują od Excela — i to przypadki, które ćwiczy kod powyżej. Zapisane filtry podnoszą pokrewne pytanie o to, jak Excel przechowuje kryterium versus jak je porównuje — omawia je artykuł HotXLS o kryteriach DOPER AutoFiltra w BIFF8
HotXLS ewaluuje COUNTIF, MATCH, XLOOKUP, DSUM i resztę swojej biblioteki funkcji natywnie w Delphi i C++Builder, w klasycznym silniku i silniku XLSX, bez instalacji Excela na maszynie. Edycje, dokumentacja i build próbny są wypisane na stronie komponentu arkusza HotXLS dla Delphi