HotXLS Delphi Component wylicza =1<2<3 jako FALSE, tę samą odpowiedź, którą daje Excel 16, bo od v2.384.3 jego parser formuł zwija operatory porównań od lewej do prawej: 1<2 staje się TRUE, a TRUE<3 jest FALSE, bo boolean plasuje się nad każdą liczbą. To samo wydanie czyni pusty operand równym i 0, i "", oraz pozwala SUMIF rozciągnąć jedno-komórkowy zakres sumy do kształtu zakresu kryteriów. Każde z tych wygląda jak ciekawostka, dopóki skoroszyt wyliczony w Delphi nie zacznie się różnić od tego samego skoroszytu otwartego w Excelu
Rozjazd zaczyna się zwykle od formuły napisanej z intuicji. Ktoś wpisuje =0<B2<100, żeby sprawdzić, czy ilość mieści się w zakresie, Excel po cichu odpowiada FALSE w każdym wierszu, a arkusz wychodzi na produkcję z tym błędem w środku. Silnik obliczeń nie ma prawa poprawiać intencji użytkownika; jego robotą jest wyprodukowanie wartości, którą wyprodukowałby Excel, tak żeby wynik z pamięci podręcznej, który HotXLS zapisuje do pliku, zgadzał się z tym, co Excel pokazuje po przeliczeniu. Przed v2.384.3 HotXLS odpowiadał TRUE na tę kontrolę zakresu w każdym wierszu, źle w drugą stronę, i raport wygenerowany na serwerze przeczył temu samemu raportowi otwartemu na biurku
Dlaczego =1<2<3 zwraca FALSE w Excelu?
Excel zwraca FALSE, bo czyta łańcuch porównań jako (1<2)<3, a wewnętrzne TRUE przegrywa potem pojedynek rankingowy typów z liczbą 3. Stary parser HotXLS czytał ten sam tekst jako 1<(2<3): TXLSSyntax.Parse_expr w lxFormula.pas parsował jeden operand, widział token porównania i wchodził w rekurencję do Parse_expr po prawą stronę, co czyni operator prawostronnie łącznym. To daje 1<TRUE, a liczba jest poniżej booleana, więc wynikiem było TRUE. Pomyłka jest symetryczna: =3>2>1 to TRUE w Excelu i było FALSE w HotXLS, a =1=1=TRUE to TRUE w Excelu i było FALSE przed poprawką. Test regresji CalculateFormula_ComparisonChainsFoldLeftToRight przypina siedem takich formuł do wartości zwracanych przez Excel 16 i przepuszcza każdą przez obie architektury silnika, klasyczny TXLSWorkbook i natywny dla XLSX TXLSXWorkbook, używając metody Calculate opisanej w przeglądzie silnika formuł HotXLS
const
  Formulas: array [0..6] of string = ('=1<2<3', '=3>2>1', '=(1<2)<3',
    '=1<(2<3)', '=1=1=TRUE', '=3>2>1=TRUE', '=1<2<3=FALSE');
  // Co zwraca Excel 16:  FALSE, TRUE, FALSE, TRUE, TRUE, TRUE, TRUE
var
  Classic: IXLSWorkbook;
  Xlsx: TXLSXWorkbook;
  i: Integer;
begin
  Classic := TXLSWorkbook.Create;
  Xlsx := TXLSXWorkbook.Create;
  try
    // TXLSXWorkbook.Calculate wylicza względem aktywnego arkusza i
    // zwraca Null, gdy skoroszyt w ogóle nie ma arkusza
    Xlsx.Sheets.Add('Data');
    for i := 0 to High(Formulas) do
      Writeln(Formulas[i], '  classic=', VarToStr(Classic.Calculate(Formulas[i])),
        '  xlsx=', VarToStr(Xlsx.Calculate(Formulas[i])));
  finally
    Xlsx.Free;
  end;
end;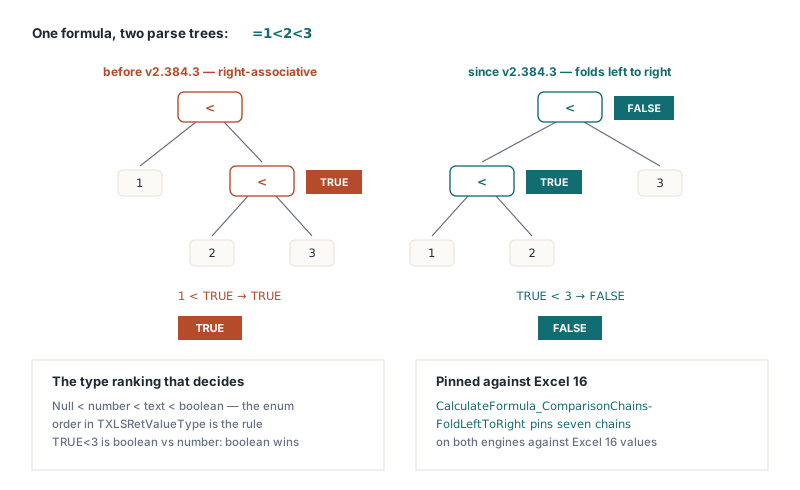
Poprawka zamienia Parse_expr w pętlę o tym samym kształcie, jakiego Parse_expr1 już używa dla +, - i &. Parsuje pierwszy operand przez Parse_expr1, a póki następny token to =, <>, <, >, <= albo >=, tworzy węzeł porównania, przyczepia zakumulowany lewy wynik jako pierwsze dziecko, parsuje następny operand przez Parse_expr1 zamiast Parse_expr i czyni nowy węzeł lewym wynikiem kolejnej rundy. Dwa detale łatwo było zepsuć przy zamianie rekurencji na iterację i oba są w notatkach opiekunów: zakumulowany węzeł trzeba przekazać (lChild := Item; Item := nil) właśnie w tej kolejności, a ścieżka błędu musi Exit po zwolnieniu półzbudowanego węzła, zamiast wypaść z pętli i zwrócić wiszące drzewo
Jak HotXLS uszeregowuje liczby, tekst i booleany w porównaniu?
HotXLS porządkuje typy mieszane tak jak Excel: każda liczba jest mniejsza od każdej wartości tekstowej, a każda wartość tekstowa jest mniejsza od każdego booleana. TXLSCalculator.CompareVariants w lxCalc.pas klasyfikuje oba operandy przez GetRetValueType do wyliczenia TXLSRetValueType = (xlVariantValue, xlNumberValue, xlStringValue, xlBooleanValue), a gdy klasy się różnią, po prostu porównuje ich ordynały, więc kolejność deklaracji tego enuma jest regułą międzytypową. W obrębie jednej klasy porównanie jest naturalne, z jednym excelowym akcentem dla tekstu: oba łańcuchy są przepuszczane najpierw przez lxUpperCase, więc ="abc"="ABC" to TRUE. Tego rankingu nie da się obejść przy rozumowaniu wyniku łańcucha. TRUE<3 nie jest koercją TRUE do 1, to boolean porównany z liczbą i boolean wygrywa. Daty są dla silnika liczbami seryjnymi (varDate klasyfikuje się jako xlNumberValue), więc data jest zawsze poniżej jakiegokolwiek tekstu, łącznie z tekstem, który akurat wygląda jak data
Czemu równa się pusta komórka w porównaniu?
Pusta komórka użyta jako operand porównania równa się 0, gdy druga strona to liczba, równa się "", gdy druga strona to tekst, a od v2.384.53 równa się FALSE, gdy druga strona to wartość logiczna, więc przy pustym A1 i =A1=0, i =A1="", i =A1=FALSE to TRUE. TXLSCalculator.CompareVarValues, która obsługuje wszystkie sześć operatorów porównania, podstawia pustkę przed wywołaniem CompareVariants: jeśli dokładnie jeden operand to Null, staje się WideString(''), gdy jego partner to łańcuch, False, gdy partner to boolean, i 0 w pozostałych przypadkach. Dwie pustki nadal porównują się jako równe bez podstawiania. Ścieżka arytmetyczna od zawsze zamieniała pustkę na 0, dlatego =A1+1 dawało 1, ale CompareVariants trzyma Null jako własny najniższy szczebel, poniżej każdej liczby, i operatory porównania używały tego szczebla wprost
var
  Wb: IXLSWorkbook;
  Sh: TXLSWorksheet;
begin
  Wb := TXLSWorkbook.Create;
  Sh := Wb.Sheets.Add;
  Sh.Range['B1', 'B1'].Value := 5;      // A1 zostaje puste celowo

  Writeln(VarToStr(Wb.Calculate('=A1=0')));    // True
  Writeln(VarToStr(Wb.Calculate('=A1=""')));   // True
  Writeln(VarToStr(Wb.Calculate('=A1<B1')));   // True: pustka porównuje się jak 0
  Writeln(VarToStr(Wb.Calculate('=A1<0')));    // False; True przed v2.384.3
end;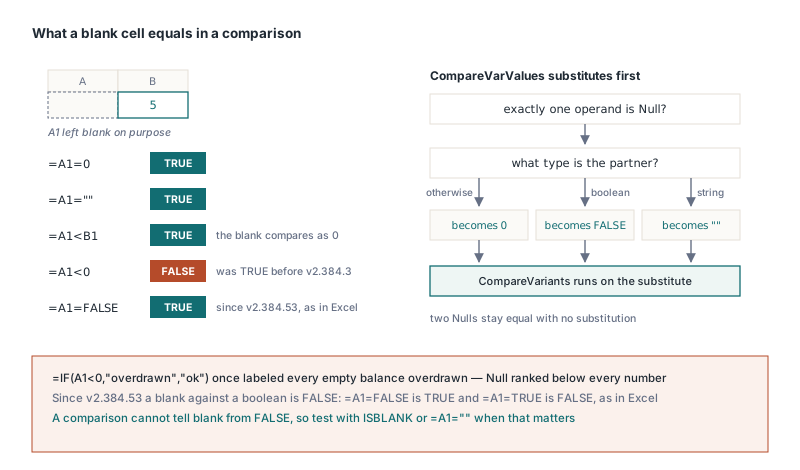
Ostatni wiersz to ten, który bolał w praktyce. Pod starym rankingiem pustka była mniejsza od każdej liczby, także ujemnej, więc =IF(A1<0,"overdrawn","ok") oznaczało każdą pustą komórkę salda jako przekroczony debet, a =A1=0 było FALSE dla komórki, którą każdy użytkownik opisałby jako zero. Jedna granica została po v2.384.3: podstawienie wybierało tylko między 0 a pustym łańcuchem, więc pustka porównana z booleanem stawała się 0, co plasuje się pod TRUE i pod FALSE, i =A1=FALSE na pustym A1 wyliczało się jako FALSE. Od HotXLS 2.384.53 pustka porównana z wartością logiczną jest traktowana jako FALSE w obu silnikach, XLS i XLSX, tak jak w Excelu: przy pustym A1 =A1=FALSE i =A1<TRUE zwracają TRUE, a =A1=TRUE zwraca FALSE. To znaczy też, że porównanie nie odróżni pustki od FALSE, ani w Excelu, ani w HotXLS; gdy arkusz potrzebuje tego rozróżnienia, testuj przez ISBLANK albo =A1=""
Dlaczego SUMIF z jedno-komórkowym zakresem sumy zwracał 0?
SUMIF zwracał 0, bo HotXLS docinał iterację do mniejszego z dwóch zakresów, podczas gdy Excel zachowuje kształt zakresu kryteriów i używa zakresu sumy tylko dla jego lewego górnego rogu. =SUMIF(A1:A10,">5",B1) znaczy więc w Excelu B1:B10, wygoda, na której polega wiele ręcznie budowanych szablonów. Wspólny worker TXLSCalculator.GetValueItemRange2 zmniejszał dotąd liczbę wierszy i kolumn do tych zakresu wartości, co redukowało przykład do pojedynczego testu A1 wobec B1. v2.384.3 zdejmuje docinkę: pętla chodzi teraz po zakresie kryteriów i czyta każdą wartość w tym samym przesunięciu od lewego górnego rogu zakresu sumy. Ponieważ CalcSumIF i CalcAverageIF wołają oba tego workera, AVERAGEIF dostaje to samo rozciąganie, a zakres sumy większy niż zakres kryteriów jest z tego samego powodu przycinany do kształtu kryteriów. Argument kryteriów w środku to argument klasy wartości, a dwa zewnętrzne to klasy referencji — rozróżnienie opisuje artykuł o implicit intersection i klasach argumentów
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  Row: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Sales');
    for Row := 1 to 10 do
    begin
      Sheet.Cells[Row, 1].Value := Row;          // kolumna kryteriów: 1..10
      Sheet.Cells[Row, 2].Value := Row * 100;    // kwoty: 100..1000
    end;
    Sheet.Cells[1, 4].Formula := '=SUMIF(A1:A10,">5",B1)';     // jedno-komórkowy zakres sumy
    Sheet.Cells[2, 4].Formula := '=SUMIF(A1:A10,">5",B1:B10)'; // jawny zakres sumy
    if Book.Recalculate = lxOk then
      // D1 i D2 to 4000 (600+700+800+900+1000); D1 było 0 przed v2.384.3
      Writeln(VarToStr(Sheet.Cells[1, 4].Value), ' ', VarToStr(Sheet.Cells[2, 4].Value));
  finally
    Book.Free;
  end;
end;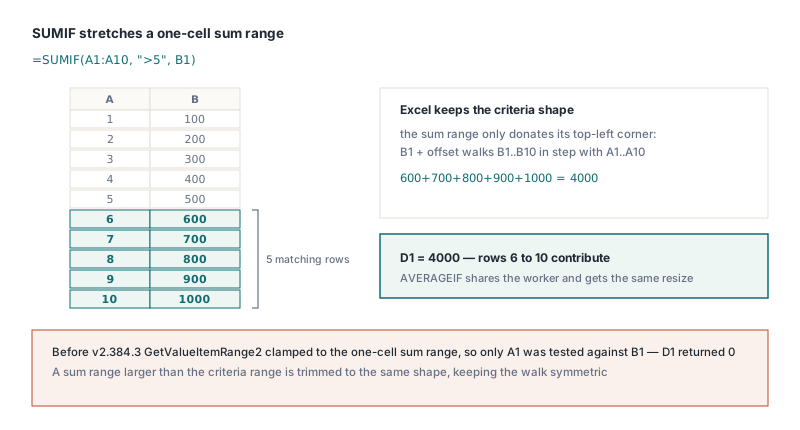
INDIRECT i YEARFRAC: dwie cichsze korekty
INDIRECT respektuje teraz swój drugi argument, a tekst po poprawnej referencji jest błędem zamiast być ignorowanym. Przy a1 FALSE tekst jest parsowany jako absolutne R1C1, więc =INDIRECT("R2C3",FALSE) czyta C2; stary kod ignorował flagę, czytał "R2" jako kolumnę R, wiersz 2, i po cichu zwracał złą komórkę. Flaga jest rozdzielana po typie wariantu (boolean, liczba albo tekst), bo konwersja wariantu łańcuchowego wprost na Double podnosi wyjątek. Względny tekst R1C1, jak R[1]C[1], zwraca #REF!, bo INDIRECT nie ma początku komórki formuły, względem którego mógłby go rozwiązać, a tekst A1 ze znakami na ogonie, "B2 junk", też zwraca #REF!. YEARFRAC z podstawą 0 stosuje teraz reguły NASD ostatniego dnia lutego, które DAYS360 już implementowało: gdy obie daty to ostatni dzień lutego, dzień końca staje się 30, a potem początek w ostatnim dniu lutego staje się 30. Od 2024-02-29 do 2025-02-28 liczba to teraz 360 dni, ułamek dokładnie 1, gdzie poprzednie Days360US liczyło 359
Co gwarantują te poprawki i jaka była lekcja?
Zachowanie łańcuchów porównań jest gwarantowane testem, który porównuje oba silniki z wartościami zmierzonymi w Excelu 16, a ten test istnieje, bo pierwszy opis poprawki był zły. Nota wydania v2.384.3 mówiła pierwotnie, że zwijanie od lewej do prawej czyni =1<2<3 TRUE, co jest dokładnie tym, co produkował stary prawostronnie łączny parser, i przeciwieństwem tego, co zwracają i Excel, i nowy kod. Nikt nie wyliczył przykładu; został napisany z intuicji, że "1 jest mniejsze od 2, a 2 od 3". Notę poprawiono, a test z siedmioma formułami dodano w commitcie następczym, i wypływająca z tego reguła obowiązuje każdego, kto dokumentuje semantykę arkuszy: odpal przykład w Excelu, zanim zapiszesz oczekiwaną wartość. Podstawianie pustego operandu i rozciąganie SUMIF idą za tym samym zachowaniem Excela, łącznie z przypadkiem pustka-versus-boolean od v2.384.53, a agregaty warunkowe, które muszą też pomijać wiersze przefiltrowane albo ukryte, idą za osobnymi regułami z artykułu o ukrytych wierszach SUBTOTAL i AGGREGATE
HotXLS to natywny komponent arkuszowy dla Delphi i C++Buildera, który czyta, przelicza i zapisuje XLS, XLSX, ODS oraz CSV bez zainstalowanego Excela, a reguły porównań, pustki i SUMIF opisane tutaj mieszkają w silniku obliczeń wspólnym dla obu architektur skoroszytów. Pełna lista funkcji i opcje licencjonowania są na stronie produktu HotXLS Delphi spreadsheet component