Nazwa zdefiniowana wskazująca całą kolumnę jest czytana przez Excela jako pojedyncza komórka, gdy występuje w pozycji skalarnej: =Vertical+1 w wierszu 7 oznacza „komórkę wiersza 7 nazwy Vertical”, a nie cały obszar. HotXLS Delphi Component stosuje to niejawe przecięcie w v2.382.4 na dwóch poziomach — przy obliczaniu wartości i przy wyciąganiu zależności — bo szablon kredytu z 4805 formułami pokazał, że samo poprawne wyliczenie wartości nie wystarcza. Gdy walker zależności rozwinie nazwę do całego jej obszaru, formuła położona dalej w grafie, która zasila dowolną komórkę tego obszaru, zamyka cykl, którego naprawdę nie ma, a TXLSXWorkbook.Recalculate odrzuca cały skoroszyt
Chodzi o typowy skoroszyt harmonogramu spłaty kredytu. Gdy każdą wartość w cache zatruto na 777 i uruchomiono pełne Recalculate, obie architektury silnika zwróciły 23, czyli lxErrorRef — kod odwołania cyklicznego. 3842 z 4805 formuł nie zgadzały się z niezależnym oczekiwaniem, B18 trzymało #VALUE!, E18 wciąż było 777, a licznik rat w J7 odczytał placeholdery z niedokończonej kolumny salda. Za jednym kodem zwrotnym kryły się trzy osobne defekty i każdy z nich omawiamy razem z kodem, który go naprawił
Dlaczego odwołanie skalarne do nazwy kolumny tworzy fałszywy cykl?
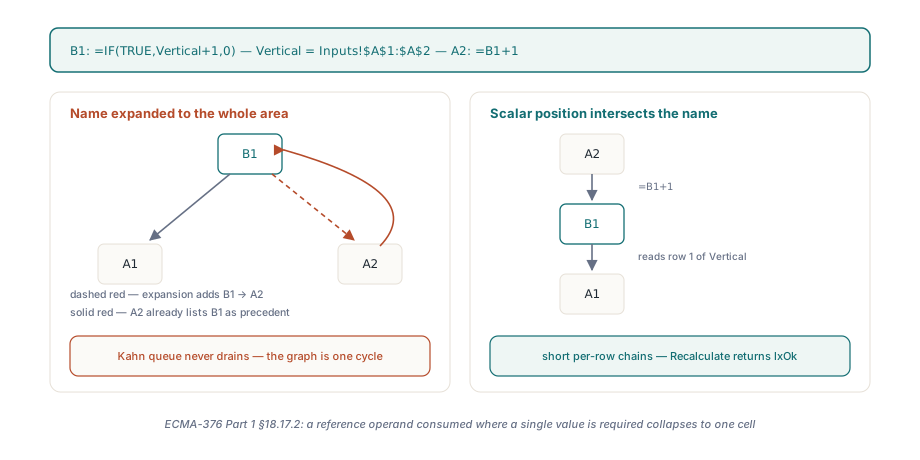
Bo graf zależności zna tylko krawędzie, a jedna krawędź od formuły do obszaru o 480 wierszach to 480 krawędzi, z których jedna prowadzi z powrotem przez komórkę zależną od tej formuły. Weźmy =IF(TRUE,Vertical+1,0) w B1 z Vertical zdefiniowaną jako Inputs!$A$1:$A$2 oraz =B1+1 w A2. Excel liczy B1 jako A1+1, a A2 jako B1+1 — prosty łańcuch. Walker, który zapisze B1 jako zależne od A1:A2, czyni A2 poprzednikiem B1, A2 już wymienia B1 jako poprzednika, a kolejka Kahna napędzająca przeliczanie przyrostowe w HotXLS nigdy nie doczeka się, by którykolwiek z tych węzłów osiągnął zerowy stopień wejściowy. Z tego wzoru uszyte są szablony kredytów: każdy wiersz okresu odwołuje się do nazwanych kolumn salda, stopy i liczby rat, każda nazwa obejmuje cały harmonogram, a każdy wiersz dodatkowo zapisuje do tych kolumn. Rozwiń nazwy, a graf staje się jednym wielkim silnie spójnym komponentem. Policz je z niejawnym przecięciem, a graf staje się zbiorem krótkich łańcuchów, po jednym na wiersz, co opisuje ECMA-376 Part 1 §18.17.2 dla operandu referencyjnego użytego tam, gdzie wymagana jest pojedyncza wartość
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Inputs');
    Book.DefinedNames.Add('Vertical', 'Inputs!$A$1:$A$2');
    Book.DefinedNames.Add('Alias', '=Vertical');
    Sheet.Cells[1, 1].Value := 1;
    // Pozycja skalarna: Vertical zwija się do A1, bo formuła jest w wierszu 1
    Sheet.Cells[1, 2].Formula := '=IF(TRUE,Vertical+1,0)';
    Sheet.Cells[2, 1].Formula := '=B1+1';
    // Nazwa, której definicją jest inna nazwa, też się przecina, więc to A2
    Sheet.Cells[2, 2].Formula := '=Alias';
    // Argument klasy referencyjnej: sumowany jest cały obszar, bez przecięcia
    Sheet.Cells[3, 2].Formula := '=SUM(Vertical)';
    // Wiersz 6 leży poza A1:A2, przecięcie jest puste i IFERROR je łapie
    Sheet.Cells[6, 2].Formula := '=IFERROR(Vertical,42)';

    if Book.Recalculate = lxOk then
    begin
      // B1 = 2, A2 = 3, B2 = 3, B3 = 4, B6 = 42
      // Przed v2.382.4 ta gałąź była nieosiągalna: B1 -> A2 -> B1 było cyklem
    end;
  finally
    Book.Free;
  end;
end;
Jak HotXLS rozstrzyga, że argument jest skalarny?
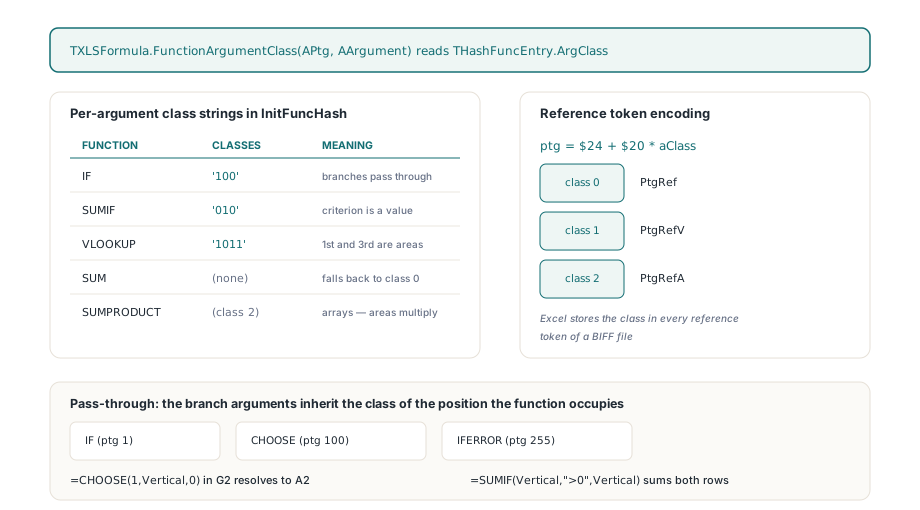
HotXLS czyta odpowiedź z tabeli funkcji, a nie z kształtu argumentu. Każdy wpis w TXLSFormula.InitFuncHash jest rejestrowany przez THashFunc.SetValue z opcjonalnym łańcuchem klas poszczególnych argumentów: 'IF' niesie '100', 'SUMIF' niesie '010', 'VLOOKUP' niesie '1011', a 'SUM' nie niesie żadnego, więc wszystkie jego argumenty spadają do klasy 0 na poziomie funkcji. Nowe TXLSFormula.FunctionArgumentClass(APtg, AArgument) wystawia ten bajt przez THashFuncEntry.ArgClass, a wynik 1 oznacza klasę wartości. To te same trzy klasy, które [MS-XLS] §2.2.2 przypisuje tokenom operandów, i koder już na nich polegał: pisząc odwołanie, liczy ptg jako $24 + $20 * aClass, co daje PtgRef dla klasy 0, PtgRefV dla klasy 1 i PtgRefA dla klasy 2. Plik BIFF zapisany przez Excela trzyma tę klasę w każdym tokenie odwołania, więc silnik, którego tabela zgadza się ze specyfikacją, potrafi odpowiedzieć „czy ten argument jest skalarny” bez patrzenia na dane. Środkowy argument SUMIF to kryterium, czyli wartość; pierwszy i trzeci to obszary, czyli referencje. SUMPRODUCT jest zarejestrowany z klasą 2 na poziomie funkcji, tablicową, dlatego =SUMPRODUCT(Vertical,Vertical) wciąż mnoży cały obszar
Trzy funkcje nie zaglądają do własnego wpisu w tabeli w niczym poza pierwszym argumentem. IF (ptg 1), CHOOSE (ptg 100) i IFERROR (ptg 255) przepuszczają to, co wybierają, więc ich argumenty gałęzi dziedziczą klasę pozycji, którą zajmuje sama funkcja. Ta jedna reguła sprawia, że =CHOOSE(1,Vertical,0) w G2 rozwiązuje się do A2, a stojące obok =SUMIF(Vertical,">0",Vertical) wciąż sumuje oba wiersze — i to właśnie tę regułę harmonogram spłat wykorzystuje najczęściej, bo jego komórki okresów opierają się na IF przy sprawdzaniu, czy kredyt jest jeszcze otwarty
Przenoszenie klasy przez przejście po zależnościach
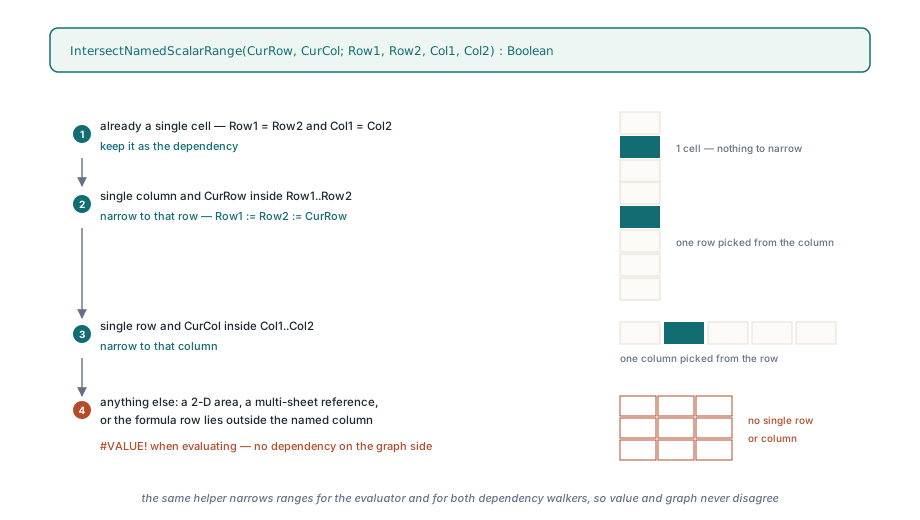
Ekstraktor zależności w lxCalc.pas to rekurencyjne Walk po skompilowanym drzewie składni i istnieje on dwa razy — w TXLSCalculator.ExtractDependencies dla grafu w obrębie skoroszytu i w ExtractWorkspaceDependencies dla grafu między skoroszytami. v2.382.4 daje obu walkerom dwa dodatkowe parametry. AScalar startuje jako True w korzeniu formuły, jest przeliczany dla każdego dziecka funkcji z FunctionArgumentClass i przechodzi bez zmian dla argumentów gałęzi ptg 1, 100 i 255. ANameRoot staje się True tylko wtedy, gdy walker schodzi do skompilowanej definicji nazwy, i przeżywa wyłącznie przez węzły SA_GROUP, czyli nawiasy, więc nazwa zdefiniowana jako =A1:A2+1 nie jest brana za zwykły obszar. Gdy w węźle SA_RANGE obie flagi są True, AddResolvedRange zawęża obszar tym samym pomocnikiem, którego używa ewaluator, zanim zapisze zależność. Pomocnik jest dość krótki, by przytoczyć go w całości
function IntersectNamedScalarRange(CurRow, CurCol: Integer;
  var Row1, Row2, Col1, Col2: Integer): Boolean;
begin
  Result := False;
  if (Row1 = Row2) and (Col1 = Col2) then Exit(True);   // już jedna komórka
  if (Col1 = Col2) and (CurRow >= Row1) and (CurRow <= Row2) then
  begin
    Row1 := CurRow; Row2 := CurRow;                     // pojedyncza kolumna: weź ten wiersz
    Exit(True);
  end;
  if (Row1 = Row2) and (CurCol >= Col1) and (CurCol <= Col2) then
  begin
    Col1 := CurCol; Col2 := CurCol;                     // pojedynczy wiersz: weź tę kolumnę
    Result := True;
  end;
end;
Wszystko, co pomocnik odrzuci — obszar dwuwymiarowy, odwołanie wieloarkuszowe albo formuła, której wiersz leży poza nazwaną kolumną — daje #VALUE! po stronie obliczeń i żadnej zależności po stronie grafu, czyli dokładnie to, co Excel robi przy pustym przecięciu. Strona obliczeń mieszka w TXLSCalculator.GetValueItemName: zdejmuje opakowania SA_GROUP ze skompilowanej definicji, a jeśli korzeniem jest SA_RANGE, woła GetRangeInfo, przecina i pobiera jedną komórkę przez FGetValue zamiast liczyć całą definicję. Odwołania zewnętrzne zostają na starej ścieżce, bo nie ma lokalnego wiersza, względem którego można by przecinać. Skąd w ogóle bierze się przechowywanie i zakres nazwy, omawia artykuł o nazwach zdefiniowanych i formułach między arkuszami; tutaj chodzi tylko o to, co silnik robi, gdy nazwa się już rozwiąże
Dlaczego MATCH po na wpół policzonej kolumnie odczytał 777?
Bo argument tablicy przeszukiwania w MATCH to referencja skanująca, a referencje skanujące były celowo wyłączone z kolejności obliczeń. Artykuł o skanowaniu w wyszukiwaniu wprowadził TXLSDepRange.LookupScan i kończył się sekcją „Co tracisz, wyłączając krawędzie skanowania z uporządkowania”: formuła wyszukiwania może wykonać się, zanim każda komórka jej zakresu zostanie przeliczona, i odczytać nieświeże wartości. W sesji interaktywnej zbiega się to przy następnym przebiegu. Przy wsadowym przeliczaniu zatrutego szablonu nie zbiega się, a PaymentCount, zdefiniowany jako =MATCH(0.01,Balances,-1)+1, odczytał placeholdery 777 wciąż siedzące w kolumnie salda i zwrócił liczbę okresów, która nie mogła być poprawna
TXLSDepGraph.TopoOrder traktuje teraz krawędzie skanowania jako miękkie krawędzie uporządkowania. Obok twardego stopnia wejściowego trzyma tablicę ScanInDeg, licząc brudne poprzedniki skanowania na węzeł i zmniejszając licznik w miarę emisji tych poprzedników, korzystając z list ScanPrecedents, ScanDependents i ScanPrecedentCount, które wcześniejsza zmiana już przechowywała. W każdej iteracji kolejka Kahna przeszukuje swoje okno gotowych węzłów w poszukiwaniu pierwszego o zerowym ScanInDeg i przestawia go na czoło; jeśli każdy gotowy węzeł wciąż czeka na poprzednik skanowania, czoło jest zdejmowane w swojej stabilnej kolejności. Krawędzie skanowania nigdy nie wchodzą do twardego stopnia wejściowego, więc samoodwołujący się VLOOKUP po własnej kolumnie wciąż jest legalny, ale wyszukiwanie, które mogłoby poczekać na możliwy do ukończenia poprzednik, teraz czeka. Regresja, która to przypina — LookupScan_WaitsForDirtyFormulaValues — zatruwa trzy komórki salda na 777 i oczekuje, że PaymentCount wróci jako 3, a potem przełącza wejście na zero i oczekuje, że =IFERROR(PaymentCount,99) zobaczy #N/A i zwróci 99
Skąd wzięło się obcięcie do czterech miejsc po przecinku?
Z arytmetyki na Variantach w Delphi i tylko w pozycjach zagnieżdżonych. Operatory binarne w TXLSCalculator.GetValueItem już kopiowały najwyższego poziomu + albo - do dwóch lokalnych zmiennych Double, więc =B1-A1 było w porządku. W środku =IF(TRUE,B1-A1,0) to samo odejmowanie szło jako Value := Value - SubValue na dwóch Variantach, a gdy jeden operand był wartością komórki typu Int64, a drugi Double, obserwowany wynik był typu Currency — stałoprzecinkowego z czterema miejscami po przecinku — więc 1066.1854641400994 minus 120 wracało obcięte do czterech miejsc. W harmonogramie, w którym każda rata jest naliczana od poprzedniego wiersza, ten błąd przechodzi przez setki okresów, zanim dotrze do sum
// TXLSCalculator.GetValueItem, gałąź arytmetyki binarnej (lxCalc.pas)
if VarIsNull(Value) then Value := 0;
if VarIsNull(SubValue) then SubValue := 0;
// Mieszana arytmetyka na Variantach Int64/Double może promować do Currency.
// Arytmetyka arkusza musi zachować precyzję zmiennoprzecinkową.
if VarIsNumeric(Value) then Value := Double(Value);
if VarIsNumeric(SubValue) then SubValue := Double(SubValue);
Strażnik działa przed SA_ADD, SA_SUB, SA_MUL i SA_DIV jednakowo, a regresja Arithmetic_MixedInt64AndDoubleKeepsPrecision zapisuje Int64(120) w A1 i 1066.1854641400994 w B1, po czym sprawdza zagnieżdżoną różnicę i sumę z dokładnością 1E-10, a iloczyn i iloraz z dokładnością 1E-8 i 1E-12. HotXLS nie twierdzi, że zna każdą regułę promocji, którą RTL stosuje do mieszanych typów Variant w różnych wersjach kompilatora; twierdzi, że arytmetyka arkusza to IEEE double, i sprawia teraz, że oba operandy są double, zanim zobaczy je operator — co usuwa pytanie
Co gwarantuje poprawka, a czego nie
Po v2.382.4 obie architektury silnika zwracają lxOk dla zatrutego szablonu, wszystkie 4805 wartości z cache zgadzają się z niezależnym oczekiwaniem wiersz po wierszu z dokładnością 1E-7, a asercje, że cache faktycznie było zatrute, że hash źródła się nie zmienił i że każda formuła wciąż jest na miejscu, wszystkie przechodzą. Nic nie zostało osiągnięte przez włączenie iteracji ani przez wyciszenie kodu błędu. Prawdziwy cykl przez nazwę — =B1 w A1, gdy B1 wciąż czyta Vertical — nadal zwraca błąd, i test NamedScalarRanges_IntersectWithoutFalseCycles kończy się dokładnie taką asercją
Granice warto powiedzieć wprost. Niejawe przecięcie dotyczy tylko nazwy, której skompilowana definicja po zdjęciu nawiasów jest obszarem jednokolumnowym albo jednowierszowym na jednym arkuszu; nazwa dwuwymiarowa w pozycji skalarnej to #VALUE!, tak jak w Excelu, a funkcja nieznana tabeli dostaje od FunctionArgumentClass klasę 0, więc jej argumenty nazwowe wciąż są rozwijane w całości. Miękkie uporządkowanie to preferencja, nie gwarancja: cykl złożony wyłącznie ze skanów nadal liczy się w stabilnej kolejności i czyta to, co jest w cache — na co artykuł o skanowaniu w wyszukiwaniu zgodził się świadomie. A wynik dla całego szablonu jest weryfikowany względem niezależnego skryptu oczekiwań, nie względem innego silnika arkusza, bo referencyjny pakiet biurowy nie dokończył przeliczania oryginalnego szablonu w budżecie 60 sekund. HotXLS to natywny komponent arkusza dla Delphi i C++Buildera, który czyta, przelicza i zapisuje XLS, XLSX, ODS i CSV bez zainstalowanego Excela; przecięcie nazw, tabela klas argumentów i miękkie uporządkowanie skanów działają dla każdego formatu, bo silnik obliczeń jest współdzielony, a aktualne pokrycie funkcji jest wypisane na stronie produktu HotXLS Delphi spreadsheet component