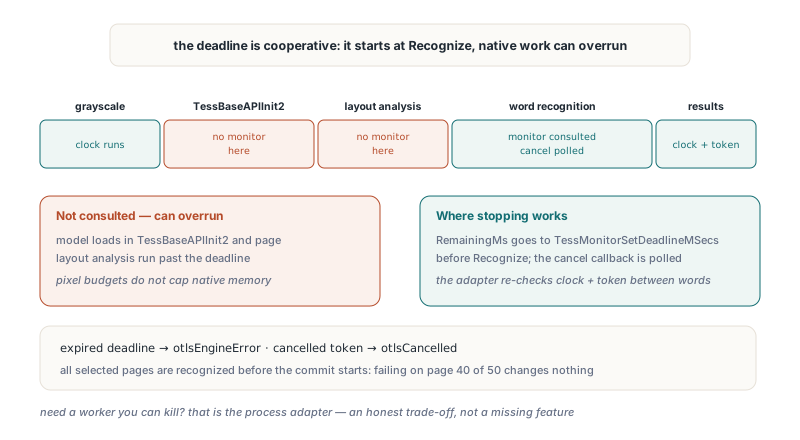
Timeout rozpoznawania 5000 ms na wywołanie Tesseracta w procesie nie znaczy, że wywołanie wraca po pięciu sekundach. Z dużym zestawem modeli wielojęzycznych wątek wołający może siedzieć wewnątrz biblioteki natywnej długo po tej granicy, bo monitor postępu, który egzekwuje deadline, jest odpytywany w czasie rozpoznawania słów, a ładowanie modeli i analiza układu strony dzieją się obie przed pierwszym odpytaniem. Ta dziura, callback anulowania, którego zwracany typ C to jeden bajt, i iterator wręczający pamięć, której nigdy nie wolno Ci zwolnić, to prawdziwa robota przy wiązaniu C API Tesseracta z Delphi. Reszta to hydraulika
Wpięcie DLL Tesseracta w warstwę tekstu HotPDF
HotPDF wystawia ścieżkę w procesie jako HPDFCreateTesseractDLLOCREngine w jednostce HPDFTesseractRecognition. Fabryka ładuje DLL Tesseracta eksportującą C API, prowadzi TessBaseAPIInit2, TessBaseAPIRecognize i iterator wyników, po czym zwraca IHPDFOCREngine. THotPDF.ApplyLoadedOCRTextLayer bierze ten silnik i dodaje niewidoczną, przeszukiwalną warstwę tekstu Unicode do zeskanowanych stron — to samo wywołanie, przez które przechodzi każdy silnik OCR HotPDF
Fabryka waliduje z góry. Plik DLL i katalog tessdata muszą istnieć. Identyfikator języka może zawierać tylko litery ASCII, cyfry, _ i +, a każdy model w kombinacji takiej jak chi_sim+eng potrzebuje pasującego pliku .traineddata. Wszystkie 21 wymaganych eksportów musi się rozwiązać, zanim dostaniesz silnik z powrotem. Błędy konfiguracji podnoszą EArgumentException z brakującym eksportem albo modelem zgłoszonym z nazwy; DLL, która nie chce się załadować, podnosi EOSError z kodem błędu Windows i sugestią sprawdzenia architektury oraz zależności
uses
  SysUtils, HPDFDoc, HPDFTesseractRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // Aplikacja Win64 potrzebuje 64-bitowej DLL; nazwa pliku zależy od Twojego buildu,
  // a DLL zależności lądują w tym samym folderze
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract.dll',
    'C:\OCR\tessdata', 'chi_sim+eng');   // używa THPDFTesseractOptions.Default
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;   // 300 DPI, MinimumConfidence 0.5
    // Pusta lista stron znaczy wszystkie; strony, które już niosą tekst, są pomijane
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' words accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFTesseractOptions.Default ustawia PageSegMode na tpsAuto, EngineMode na temDefault, TimeoutMilliseconds na 60 000 i MaxPixels na 16 777 216. Ten budżet pikseli ugryza wcześniej, niż ludzie oczekują. Strona US Letter przy domyślnych 300 DPI renderuje się do 2550 × 3300 pikseli, z grubsza 8,4 miliona, i mieści się. Podnieś tę samą stronę do 600 DPI: robi się 5100 × 6600, około 33,7 miliona pikseli, i silnik ją odrzuca z Invalid Tesseract DLL OCR request or pixel budget, zanim Tesseract w ogóle zobaczy obraz. Podnieś więc MaxPixels (sufit to 67 108 864) albo zostań przy 300 DPI, co dla tekstu głównego aż nadaje; każda strona jest też ograniczona do 32 767 pikseli
DLL jest ładowana przez LoadLibraryEx z flagami wyszukiwania obejmującymi własny folder biblioteki plus domyślne bezpieczne katalogi. Biblioteki obrazów, od których zależy Tesseract, mogą więc siedzieć obok niej i nigdy nie musisz ruszać PATH ani polegać na katalogu bieżącym. HotPDF nie pakuje ani nie pobiera runtime'u OCR ani żadnego modelu językowego; oba prowizjonujesz sam
Co zmienia ścieżka DLL względem tesseract.exe
Ten sam rozpoznawacz jest też dostępny przez adapter zewnętrznego tesseract.exe, który pisze BMP i parsuje TSV. Oba adaptery karmią jeden potok warstwy tekstu, więc mapowanie współrzędnych, filtrowanie pewności i zatwierdzenie all-or-nothing zachowują się identycznie. Różni się to, jak piksele wchodzą, jak słowa wychodzą i co się dzieje, gdy rozpoznawacz źle się zachowa
| Aspekt | Adapter tesseract.exe | Adapter DLL Tesseracta |
|---|---|---|
| Fabryka | HPDFCreateTesseractOCREngine | HPDFCreateTesseractDLLOCREngine |
| Piksele we | Plik BMP w prywatnym katalogu tymczasowym | 8-bitowy bufor skali szarości w pamięci |
| Słowa wy | TSV per słowo, ograniczony do 64 MiB | Iterator wyników, UTF-8 per słowo |
| Linie bazowe | Brak w TSV; potok je estymuje | Przekazywane z TessPageIteratorBaseline |
| Segmentacja strony i tryb silnika | overload THPDFTesseractOptions, wysyłany jako --psm i --oem | THPDFTesseractOptions, wysyłane do TessBaseAPISetPageSegMode i TessBaseAPIInit2 |
| Budżet pikseli | MaxPixels, gdy przekazano opcje | MaxPixels zawsze, plus 32 767 pikseli na bok |
| Timeout | Twardy: proces potomny jest zabijany | Kooperatywny: Tesseract musi sam zauważyć |
| Izolacja crasha i pamięci | Osobny proces | Brak, dzieli z Tobą przestrzeń adresową |
Jeden koszt zostaje przy DLL. Każde wywołanie Recognize tworzy własną instancję API i puszcza TessBaseAPIInit2, więc modele językowe są inicjalizowane przy każdej stronie. Cache plików zdejmuje ostrze z przeładowania, ale przy dużym zestawie modeli wielojęzycznych pozostaje największym stałym kosztem na stronę i jest naliczany do deadline'u rozpoznawania. Silnik DLL RapidOCR w procesie wybiera odwrotnie i trzyma swoje modele ONNX rezydentne przez całe życie silnika, podczas gdy problemy graniczne (ABI C, pożyczone bufory, natywna praca, której nie da się przerwać) należą do tej samej rodziny
Więc która trafia do produkcji? Dla desktopowego narzędzia albo zadania wsadowego przechodzącego przez kilkaset skanów DLL pasuje lepiej: bez odpalania procesu na stronę, bez tymczasowej bitmapy na dysku, z prawdziwymi liniami bazowymi dla pochyłych linii. Długotrwający serwer przyjmujący PDF-y od obcych powinien zostać przy tesseract.exe, bo natywny crash albo szalejące alokacje kładą tam jeden proces potomny zamiast Twojego serwisu
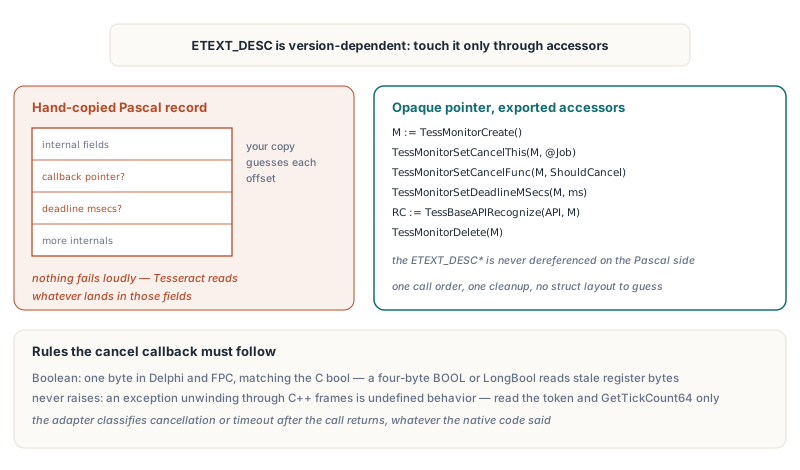
Dlaczego Delphi nie może skopiować struktury monitora Tesseracta?
Delphi nie może bezpiecznie zwierciadlić monitora postępu Tesseracta, bo ETEXT_DESC niesie pola wewnętrzne, które różnią się między buildami Tesseracta. Rekord przetłumaczony ręcznie z jednego nagłówka kładzie callback anulowania i deadline na tych offsetach, których używał tamten nagłówek. Odpal to przeciwko innemu buildowi i Tesseract czyta Twój wskaźnik callbacku z pola, które teraz znaczy coś innego, albo w ogóle nie znajduje deadline'u, a rozpoznawanie po prostu biegnie do końca
Dlatego adapter HotPDF traktuje monitor jako nieprzezroczysty wskaźnik i dotyka go tylko przez funkcje eksportowane: TessMonitorCreate, TessMonitorSetCancelThis, TessMonitorSetCancelFunc, TessMonitorSetDeadlineMSecs i TessMonitorDelete. Szkic poniżej to Twój własny kod wiążący, nie API HotPDF; jego deklaracje pasują do tych, które adapter rozwiązuje przez GetProcAddress
type
  // C: typedef bool (*TessCancelFunc)(void *cancel_this, int words);
  TTessCancelFunc = function(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
  TTessMonitorCreate = function: Pointer; cdecl;   // ETEXT_DESC*, nigdy nie wyłuskiwany
  TTessMonitorDelete = procedure(Monitor: Pointer); cdecl;
  TTessMonitorSetCancelFunc = procedure(Monitor: Pointer; Func: TTessCancelFunc); cdecl;
  TTessMonitorSetCancelThis = procedure(Monitor, CancelThis: Pointer); cdecl;
  TTessMonitorSetDeadlineMSecs = procedure(Monitor: Pointer; MSecs: Integer); cdecl;
  TTessBaseAPIRecognize = function(Handle, Monitor: Pointer): Integer; cdecl;

  // Twój własny stan zadania, nie typ HotPDF
  TOCRJob = record
    CancelRequested: Boolean;
    DeadlineTick: UInt64;
  end;
  POCRJob = ^TOCRJob;

function ShouldCancel(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
begin
  // Biegnie na stacku Tesseracta: czytaj flagę i zegar, nigdy nie podnoś wyjątku
  Result := (CancelThis = nil) or POCRJob(CancelThis)^.CancelRequested or
    (GetTickCount64 >= POCRJob(CancelThis)^.DeadlineTick);
end;

// Użycie, ze wskaźnikami funkcji rozwiązanymi przez GetProcAddress:
//   Monitor := MonitorCreate();
//   try
//     MonitorSetCancelThis(Monitor, @Job);
//     MonitorSetCancelFunc(Monitor, ShouldCancel);
//     MonitorSetDeadlineMSecs(Monitor, RemainingMs);
//     RC := BaseAPIRecognize(API, Monitor);
//   finally
//     MonitorDelete(Monitor);
//   end;
Szkic typizuje callback jako Boolean, jeden bajt w Delphi i Free Pascalu, co pasuje do C bool w TessCancelFunc. Czterobajtowy windowsowy BOOL i delphijski LongBool wyglądają na wymienne i są innym typem: gdy jedna strona zapisuje pojedynczy bajt, a druga czyta cztery, górne trzy bajty to to, co siedziało w rejestrze wcześniej, i fałsz może przyjść jako prawda. TessPageIteratorBoundingBox zwraca int, deklarowany po stronie Pascala jako Integer, więc czytaj typ C każdej zwracanej wartości zamiast zakładać jedną regułę dla całego API
Callback też nigdy nie podnosi wyjątków. Wyjątek Delphi rozwijający się przez ramki C++ Tesseracta to niezdefiniowane zachowanie. Callback HotPDF czyta tylko token anulowania i monotoniczną wartość GetTickCount64, a adapter zamienia wynik w diagnostykę anulowania albo timeoutu po powrocie TessBaseAPIRecognize. Sprawdzenie puszcza niezależnie od tego, czy natywny kod powrotu był zerem
Które natywne wskaźniki posiada strona Delphi?
Adapter DLL Tesseracta w HotPDF posiada trzy natywne obiekty na żądanie (instancję API, monitor i iterator wyników) i wszystko inne pożycza. Każde wywołanie Recognize tworzy własny zestaw i zwalnia go w bloku finally w stałej kolejności: TessResultIteratorDelete, potem TessMonitorDelete, potem TessBaseAPIDelete. Zwolnienie interfejsu silnika woła FreeLibrary na DLL
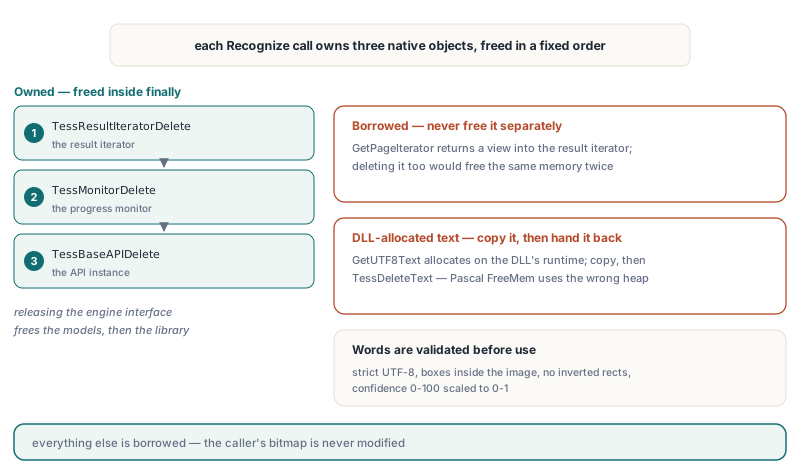
TessResultIteratorGetPageIteratorzwraca widok na iterator wyników, a nie nowy obiekt. Adapter używa go doTessPageIteratorBoundingBoxiTessPageIteratorBaselinei nigdy go nie zwalnia; skasowanie go dodatkowo zwolniłoby tę samą pamięć dwa razyTessResultIteratorGetUTF8Textzwraca string alokowany przez własny runtime DLL. Adapter go dekoduje i oddaje przezTessDeleteTextw blokufinally, bo pascalowskiFreeMemzwolniłby go na złej stercie- Tekst słowa przechodzi przez ścisłe dekodowanie UTF-8 z najpierw kontrolą długości. Słowo ze znakami kontrolnymi, zniekształconym UTF-8, boxem poza obrazem, odwróconym prostokątem albo pewnością poza zakresem 0–100 wywala żądanie; adapter nie łata go
- Tekst na żądanie jest ograniczony do 1 048 576 jednostek kodowych UTF-16, a liczba słów musi się zmieścić w budżecie, który
ApplyLoadedOCRTextLayerpodaje z każdą stroną
Pewność przychodzi jako 0–100 i jest skalowana do 0–1, więc THPDFOCRTextLayerOptions.MinimumConfidence znaczy to samo dla każdego silnika. Gdy Tesseract zgłasza linię bazową, oba końce są przekazywane, a dla słowa w przewadze pionowego szerokość boxu gra rolę wysokości tekstu. Bez linii bazowej potok warstwy tekstu spada z powrotem na swoją estymatę geometryczną, dokładnie jak przy wejściu TSV
Kontrola zakresów opcji enum, zanim dotrą do DLL
Fabryka kopiuje surowe bajty PageSegMode i EngineMode do Integer, zanim sprawdzi ich zakresy. Kompilator ma prawo zakładać, że zmienna enum zawsze trzyma zadeklarowaną wartość, więc test jak Ord(X) > Ord(High(T)) napisany wprost na enumie może zostać złożony do stałego fałszu. Te ordinaly docierają do DLL jako zwykłe inty: THPDFTesseractPageSegMode podąża za numeracją segmentacji strony Tesseracta od 0 do 13, a THPDFTesseractEngineMode za numeracją trybów silnika od 0 do 3. Rekord opcji wyczyszczony przez FillChar, czytany ze streama albo wypełniony z C++Builder przez rzutowanie na int może nieść bajt jak 200, a walidacja kopii zamienia to w EArgumentException w czasie fabryki. Fabryka odrzuca też tpsOSDOnly i tpsAutoOnly, które nie zwracają słów, i wymaga osd.traineddata dla tpsAutoOSD i tpsSparseTextOSD
Co faktycznie gwarantuje timeout rozpoznawania?
Timeout DLL Tesseracta jest kooperatywny: HotPDF może zatrzymać własną pracę i poprosić Tesseracta o stop, ale nie może zmusić kodu natywnego do powrotu. Zegar startuje z rozpoczęciem Recognize, więc konwersja do skali szarości i inicjalizacja modeli czerpią z tego samego budżetu co samo rozpoznawanie. Adapter sprawdza upływ czasu i token anulowania co 64 wiersze podczas konwersji skali szarości, po inicjalizacji i przed każdym słowem przy przechodzeniu wyników. Tuż przed TessBaseAPIRecognize podaje pozostałe milisekundy do TessMonitorSetDeadlineMSecs
Dziura siedzi wewnątrz wywołań natywnych. Tesseract konsultuje monitor tylko podczas rozpoznawania słów, więc wewnątrz TessBaseAPIInit2 albo analizy układu strony powolne ładowanie modelu albo patologiczny układ mogą przeskoczyć deadline, zanim timeout zostanie zgłoszony. Budżety pikseli i wyjścia też nie ograniczają własnego zużycia pamięci przez bibliotekę natywną. Gdy potrzebujesz workera, którego można zabić wprost, adapter procesowy jest do tego narzędziem
Segmentacja strony to miejsce, gdzie adapter DLL procentuje na niezręcznym wejściu. Formularze, etykiety i zeskanowane tabele z rozrzuconymi polami często rozpoznają się lepiej z tpsSparseText niż z segmentacją automatyczną, która próbuje składać kolumny i akapity, których tam nie ma. Timeout poniżej jest krótki jak na stronę formularza, a i tak musi pokryć inicjalizację modeli
procedure OCRFormPages(Doc: THotPDF; const Pages: array of Integer);
var
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  LayerOptions: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default;
  TessOptions.PageSegMode := tpsSparseText;  // rozrzucone pola, bez składania kolumn
  TessOptions.EngineMode := temLSTMOnly;     // wymaga modeli LSTM w tessdata
  TessOptions.TimeoutMilliseconds := 20000;  // obejmuje inicjalizację modeli
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract.dll',
    'C:\OCR\tessdata', 'eng+deu', TessOptions);

  LayerOptions := THPDFOCRTextLayerOptions.Default;
  LayerOptions.MinimumConfidence := 0.6;
  if not Doc.ApplyLoadedOCRTextLayer(Pages, Engine, LayerOptions, Info) then
    case Info.Status of
      otlsCancelled:
        Writeln('OCR cancelled, document unchanged');
      otlsEngineError:
        if Pos('timed out', string(Info.Diagnostic)) > 0 then
          Writeln('Tesseract timed out, document unchanged')
        else
          Writeln('Tesseract failed: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
Timeout wychodzi jako otlsEngineError z Tesseract DLL OCR timed out w diagnostyce. Token ustawiony przez THPDFOCRTextLayerOptions.CancellationToken wychodzi jako otlsCancelled. W obu przypadkach ApplyLoadedOCRTextLayer rozpoznaje każdą wybraną stronę, zanim ruszy zatwierdzanie, więc porażka na stronie 40 z 50 zostawia załadowany dokument dokładnie takim, jaki był. tpsSingleLine, tpsSingleBlock i tpsSparseText zmieniają tylko segmentację; żaden nie wyprostuje pochylonego skanu
Free Pascal i Lazarus: stare piksele i zgubiony chiński
Obie fabryki Tesseracta działają w Windows Free Pascal i buildach Lazarus Win32 i Win64, gdy pakiet Lazarus zostanie przebudowany dla architektury docelowej; ogólny port opisuje HotPDF na Free Pascal i Lazarus Win64. Obsługa wejścia to miejsce, gdzie FPC zachowuje się inaczej
LCL-owski TBitmap zapisywany przez scanline może zaktualizować swój raw image bez odświeżenia windowsowego uchwytu bitmapy, więc GetDIBits na tym uchwycie zwraca stare piksele. Objaw jest zgrywający: tekst narysowany wprost na bitmapie jest rozpoznawany, strona renderowana przez scanline nie daje żadnych słów. Pod FPC adapter DLL czyta migawkę świadomą formatu przez CreateIntfImage, która respektuje format pikseli i kolejność wierszy raw image'a. Build Delphi trzyma ścieżkę GetDIBits na prywatnej 24-bitowej kopii, a żaden build nie modyfikuje bitmapy wołającego
Adapter tesseract.exe spotyka inny problem. TStringList FPC trzyma stringi ANSI, więc przypisanie zdekodowanego tekstu TSV UTF-8 do Lines.Text gubi każdy znak chiński albo z płaszczyzny dodatkowej, którego systemowa strona kodowa ANSI nie umie przedstawić. Ścieżka FPC trzyma TSV jako bajty UTF-8, zrzuca BOM na poziomie bajtów i sama dekoduje każde słowo do UnicodeString. Adapter DLL problemu nigdy nie spotyka, bo dekoduje każde słowo wprost z iteratora
Adapter DLL Tesseracta jest dostarczany obok adapterów procesowych i wbudowanego silnika OCR w HotPDF dla Delphi, C++Builder i Free Pascal. Edycje i pobrania są wypisane na stronie komponentu HotPDF Delphi PDF