Potok, który nigdy nie zgłasza końca pliku, to osobliwy bug do wyśledzenia w funkcji OCR. Jeden wątek Twojej aplikacji czyta standardowe wyjście programu pomocniczego i czeka, aż ReadFile polegnie z ERROR_BROKEN_PIPE. Drugi wątek startuje tesseract.exe przez CreateProcess z bInheritHandles ustawionym na True, bo tak wręcza się procesowi potomnemu plik dla jego standardowego błędu. Zapisowy koniec potoku helpera był dziedziczalny, więc Tesseract ma teraz jego kopię, a wątek czytający wisi, aż Tesseract skończy swoją stronę — co, przy skanie 300 DPI z dwoma załadowanymi modelami językowymi, nie jest szybkie
Zewnętrzny rozpoznawacz przynosi więcej niż zawieszenie: co widzi potomek, co zrobić z połowicznie poprawnym wyjściem, jak zamienić pikselowe boxy w przeszukiwalny tekst PDF. Wbudowany silnik OCR z dopasowaniem szablonów celowo pokrywa maszynowo drukowane litery i cyfry ASCII. Nazwy z diakrytykami, chińskie umowy i archiwa mieszane językowo potrzebują wytrenowanych modeli językowych, a Tesseract to zwyczajowy kandydat, bo jest programem linii poleceń, który można zainstalować obok Twojego pliku wykonywalnego
Wpięcie Tesseracta w warstwę tekstu OCR HotPDF
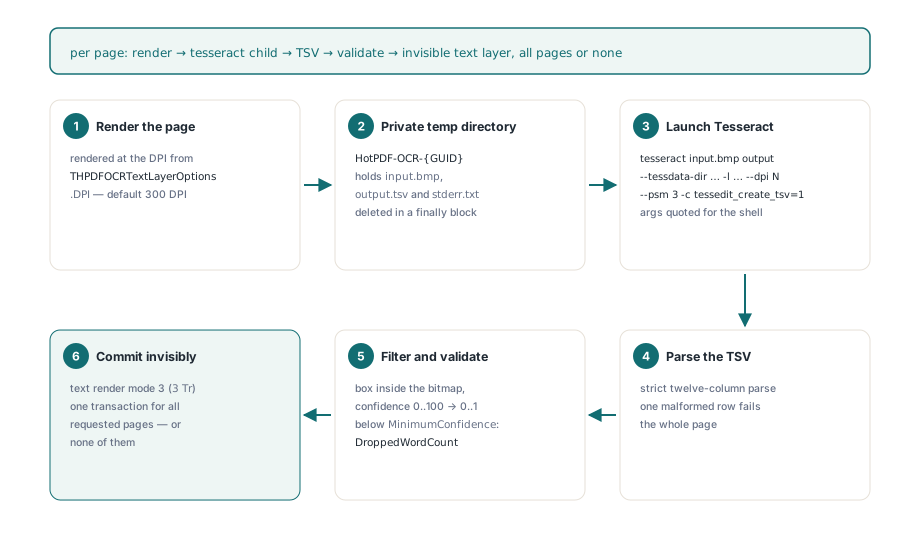
HotPDF owija lokalnie zainstalowany plik wykonywalny Tesseract jako IHPDFOCREngine przez HPDFCreateTesseractOCREngine w jednostce HPDFTesseractRecognition. Podajesz ten silnik do THotPDF.ApplyLoadedOCRTextLayer, które renderuje każdą żądaną stronę, puszcza Tesseract raz na stronę, filtruje słowa i zapisuje niewidoczną warstwę tekstu Unicode dla każdej żądanej strony w jednej transakcji — albo dla żadnej. Mapowanie współrzędnych, rotacja, filtrowanie pewności i komit to potok, którego wbudowany silnik już używa; zmienia się tylko rozpoznawanie
Fabryka podnosi EArgumentException, zanim jakakolwiek strona zostanie dotknięta. Plik wykonywalny i katalog tessdata muszą istnieć, timeout musi leżeć między 1 a 3 600 000 milisekund, a język może zawierać wyłącznie litery ASCII, cyfry, _ i +, bo kończy na linii poleceń: eng+chi_sim jest legitne, wartość z cudzysłowami albo spacjami to iniekcja czekająca na okazję. Drugi overload bierze rekord THPDFTesseractOptions. Jego Default daje --psm 3, --oem 3, 60 sekund na stronę i sufit 16 777 216 pikseli, i odrzuca tpsOSDOnly oraz tpsAutoOnly, dwa tryby, które nie zwracają słów
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFTesseractRecognition;

function MakeSearchable(const SourceFile, TargetFile: string;
  Token: THPDFCancellationToken): Boolean;
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default; // psm 3, oem 3, 60 s, 16 777 216 px
  TessOptions.TimeoutMilliseconds := 120000;    // dotyczy każdej strony
  // podnosi EArgumentException przy brakującym wykonywalnym albo folderze tessdata,
  // złym identyfikatorze języka albo opcjach poza ich zakresami
  Engine := HPDFCreateTesseractOCREngine(
    'C:\OCR\Tesseract\tesseract.exe',
    'C:\OCR\Tesseract\tessdata',
    'eng+chi_sim',                              // modele sklejone '+'
    TessOptions);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default; // 300 DPI, MinimumConfidence 0.5
    Options.CancellationToken := Token;
    // pusta lista stron znaczy wszystkie; strony, które już mają tekst, są pomijane
    Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
    if Result then
    begin
      Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
        ' words kept, ', Info.DroppedWordCount, ' below the threshold');
      Doc.SaveLoadedDocument(TargetFile);
    end
    else
      case Info.Status of
        otlsCancelled:      Writeln('Cancelled, document unchanged');
        otlsEngineError:    Writeln('Engine: ', string(Info.Diagnostic));
        otlsBudgetExceeded: Writeln('Budget: ', string(Info.Diagnostic));
      else
        Writeln(string(Info.Diagnostic));
      end;
  finally
    Doc.Free;
  end;
end;
Zrób arytmetykę pikseli raz. Strona A4 przy 300 DPI to około 2481 na 3508 pikseli, z grubsza 8,7 miliona, i mieści się. Strona A3 przy tej samej rozdzielczości to około 3508 na 4961, blisko 17,4 miliona, więc pada z diagnostyką budżetu pikseli i przebieg kończy się jako otlsEngineError. Overload biorący sam timeout w ogóle nie nakłada sufitu pikseli. Dla serwisu przyjmującego pliki z zewnątrz trzymaj overload z opcjami i podnoś MaxPixels (do 67 108 864) albo świadomie obniżaj THPDFOCRTextLayerOptions.DPI, gdy spodziewane są duże formaty
Na stronę silnik tworzy prywatny katalog HotPDF-OCR-{GUID} pod ścieżką temp, zapisuje bitmapę jako input.bmp i puszcza tesseract input.bmp output --tessdata-dir … -l … --dpi N --psm 3 -c tessedit_create_tsv=1, doklejając --oem, gdy ustawiono tryb silnika. Ścieżki są cytowane według reguł Windows dla ukośników odwrotnych i wbudowanych cudzysłowów, a --dpi niesie rozdzielczość renderu, więc Tesseract nigdy jej nie zgaduje. Tesseract i jego pliki .traineddata nie są w pakiecie; prowizjonowanie ich to robota aplikacji. Na naszych własnych maszynach testowych z Linuksem rozpoznawacz biegnie z pakietu na poziomie użytkownika — binarka, jej domknięcie bibliotek współdzielonych i folder tessdata — bo poleganie na /usr/bin/tesseract działa tylko tam, gdzie ktoś zainstalował pakiet systemowy
Czemu jeden zepsuty wiersz TSV opróżnia całą stronę?
Adapter Tesseracta wywala całą stronę przy pierwszym zniekształconym wierszu, bo częściowo sparsowana lista słów produkuje warstwę tekstu rozmijającą się z obrazem, a nic w zapisanym PDF nie mówi, których słów zabrakło. Wyjście musi dekodować się jako ścisłe UTF-8 bez wbudowanego NUL. Pierwsza linia musi równać się dwunastokolumnowemu nagłówkowi Tesseracta, od level do text, po zrzuceniu opcjonalnego znacznika kolejności bajtów. Każdy wiersz musi rozpaść się na dokładnie dwanaście pól, a podział staje po jedenastym tabulatorze, więc tabulator wewnątrz rozpoznanego tekstu ląduje w polu tekstu zamiast tworzyć trzynastą kolumnę, gdzie kontrola znaków kontrolnych spod niżej i tak go odrzuci
Tylko wiersze poziomu 5 są słowami; wiersze strony, bloku, akapitu i linii są pomijane, podobnie jak słowa puste albo czyste białe znaki. Słowo zawierające znak kontrolny (poniżej U+0020 albo od U+007F do U+009F) wywala stronę. Reszta potrzebuje geometrii integerowej, pewności parsowanej formatowaniem niezmiennym, żeby aplikacja w niemieckim locale nadal czytała 93.5, boxu w całości wewnątrz bitmapy i pewności od 0 do 100. Jedno ważne słowo po jednym zepsutym wierszu daje zero słów
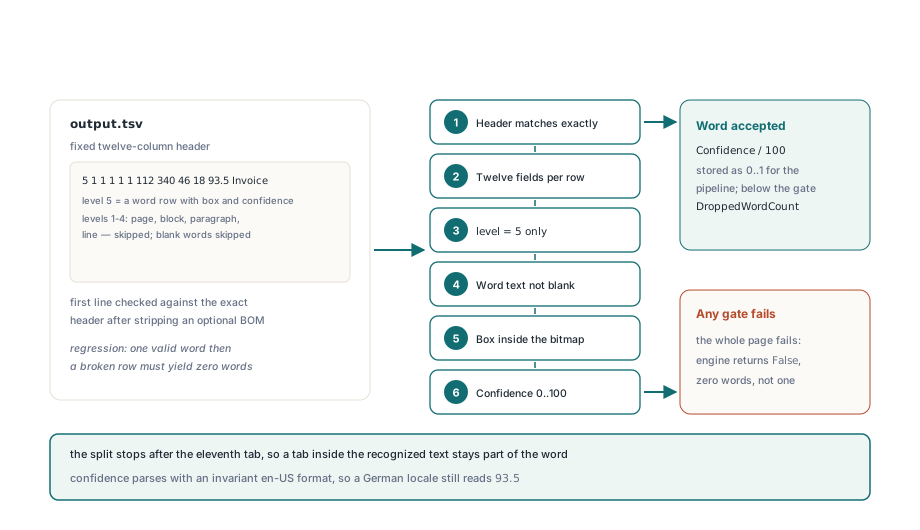
Jeden osobliwy wiersz wywala więc cały przebieg i zostawia każdą stronę nietkniętą. To właściwy handel. Ponowny bieg jest tani; przeszukiwalny PDF, w którym szukanie numeru faktury mija tę jedną stronę, która ma znaczenie, wychodzi zwykle miesiące później, w cudzych rękach
Ostatni krok spotyka też domyślny, którego możesz się nie spodziewać. Tesseract donosi pewność od 0 do 100, potok dzieli przez 100, a THPDFOCRTextLayerOptions.MinimumConfidence domyślnie wynosi 0,5, więc każde słowo poniżej 50 ląduje w Info.DroppedWordCount zamiast na stronie. Na czystym skanie ten próg jest sensowny. Na zasumionym faksie potrafi zdjąć dużą część tekstu, więc porównuj Info.ReceivedWordCount z Info.AcceptedWordCount, zanim go obniżysz
Puszczanie OCR ponownie na pliku, który już ma tekst
SkipPagesWithText jest domyślnie True i drugim razem łapie ludzi. Załóżmy, że partia była przetworzona z eng, a teraz potrzebuje eng+deu: każda strona niesie już niewidoczny tekst, więc Info.SkippedPageCount równa się liczbie stron. HotPDF znacznikuje zapisywany content stream jako własną warstwę OCR, a ReplaceExistingOCRTextLayer używa tego znacznika, by rozpoznać te strony ponownie, zrzucając starą warstwę i trzymając oryginalną treść strony
Options := THPDFOCRTextLayerOptions.Default;
Options.ReplaceExistingOCRTextLayer := True;  // podmień naszą wcześniejszą warstwę
Options.UseOptionalContentGroup := True;      // warstwa o nazwie 'OCR Text Layer'
Options.CancellationToken := Token;
if Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
  Writeln(Info.ReplacedPageCount, ' replaced, ',
    Info.SkippedPageCount, ' skipped, ',
    Info.RecognizedPageCount, ' recognized')
else
  Writeln(string(Info.Diagnostic));
Plik OCR-owany przez sterownik skanera takiego znacznika nie niesie, więc jego strony nadal liczą się jako strony z tekstem. Wyłączenie SkipPagesWithText ułożyłoby drugą niewidoczną warstwę na pierwszej, a każde trafienie w wyszukiwarce pokazałoby się dwa razy. Zostaw te pliki w spokoju
Które uchwyty dziedziczy proces Tesseracta?
Proces potomny Tesseracta dziedziczy od HotPDF dokładnie dwa uchwyty: jeden otwarty na NUL dla standardowego wejścia i wyjścia, i jeden dla stderr.txt w prywatnym katalogu. Wiszący potok spod wyżej pochodzi od samego CreateProcess: bInheritHandles = True jest wymagane, by przekazać standardowe uchwyty, a samo w sobie przekazuje każdy dziedziczalny uchwyt w hoście — potoki, pliki i zdarzenia otwarte przez niepowiązany kod włącznie. HotPDF używa STARTUPINFOEX z listą atrybutów niosącą PROC_THREAD_ATTRIBUTE_HANDLE_LIST i flagą EXTENDED_STARTUPINFO_PRESENT. bInheritHandles zostaje True, a mimo to przechodzą wyłącznie wypisane uchwyty
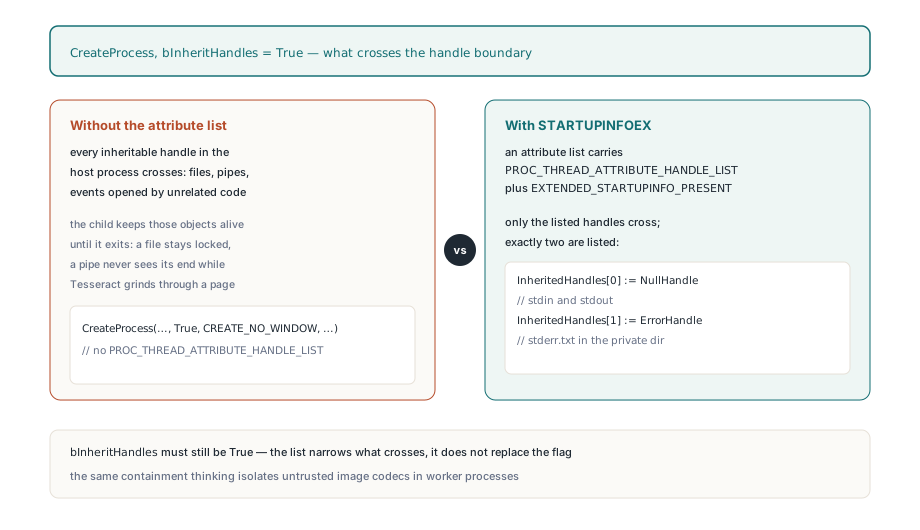
Ten sam wzorzec należy do każdego innego procesu potomnego, jaki startuje Twoja aplikacja, bo jeden launcher dziedziczący wszystko starczy, by zawiesić każdego czytelnika potoku w procesie:
// Wzorzec dla Twoich własnych wywołań CreateProcess (fragment: NullHandle, ErrorHandle,
// Exe, CommandLine, WorkDir i ProcessInfo są zadeklarowane gdzie indziej).
// Starsze RTL Delphi nie deklarują funkcji listy atrybutów; dodaj własne
// zewnętrzne deklaracje z kernel32, jeśli kompilator ich nie znajdzie
// Sprawdzaj każdy wynik BOOL w kodzie produkcyjnym
type
  TStartupInfoExRec = record
    StartupInfo: TStartupInfo;
    AttributeList: Pointer;
  end;
const
  HANDLE_LIST_ATTRIBUTE = $00020002;   // PROC_THREAD_ATTRIBUTE_HANDLE_LIST
  EXTENDED_STARTUP_FLAG = $00080000;   // EXTENDED_STARTUPINFO_PRESENT
var
  Startup: TStartupInfoExRec;
  HandleList: array[0..1] of THandle;
  Size: NativeUInt;
begin
  FillChar(Startup, SizeOf(Startup), 0);
  HandleList[0] := NullHandle;         // utworzony z bInheritHandle = True
  HandleList[1] := ErrorHandle;        // podobnie
  Size := 0;
  InitializeProcThreadAttributeList(nil, 1, 0, Size);
  GetMem(Startup.AttributeList, Size);
  InitializeProcThreadAttributeList(Startup.AttributeList, 1, 0, Size);
  UpdateProcThreadAttribute(Startup.AttributeList, 0, HANDLE_LIST_ATTRIBUTE,
    @HandleList[0], SizeOf(HandleList), nil, nil);
  Startup.StartupInfo.cb := SizeOf(Startup);
  // ... ustaw dwFlags i hStdInput / hStdOutput / hStdError jak zwykle ...
  CreateProcess(PChar(Exe), PChar(CommandLine), nil, nil,
    True,                              // nadal wymagane przy liście uchwytów
    CREATE_NO_WINDOW or EXTENDED_STARTUP_FLAG,
    nil, PChar(WorkDir), Startup.StartupInfo, ProcessInfo);
  // po wyjściu potomka: DeleteProcThreadAttributeList, FreeMem, CloseHandle
end;
Skrypty mostowe dokładają jeszcze jeden windowsowy szczegół. Launcher Pythona może wystartować drugi proces interpretera, i zakończenie procesu, który stworzyłeś, zostawia ten drugi biegnącym. Gdy silnik dostaje ścieżkę skryptu — jak adapter RapidOCR spod niżej — HotPDF startuje potomka zawieszonego, przypisuje go do job object z JOB_OBJECT_LIMIT_KILL_ON_JOB_CLOSE i dopiero go wznawia, więc zamknięcie joba kończy całe drzewo. Ta sama idea izolacji napędza izolowanie kodeków obrazów PDF w procesach roboczych, gdzie potomek jest niezaufany; tutaj potomek jest zaufany, ale Twój proces nie jest jedynym kodem trzymającym w nim uchwyty
Anulowanie, timeouty i komit wszystko-albo-nic
IHPDFOCREngine.Recognize zwraca jeden Boolean, i False pokrywa i „Tesseract padł”, i „użytkownik nacisnął Anuluj”. Adapter odpytuje token i swój timeout co 25 milisekund, dopóki Tesseract biegnie, i przy anulowaniu sprząta i zwraca False. Wzięte dosłownie czytałoby się jako otlsEngineError, więc ApplyLoadedOCRTextLayer sprawdza najpierw token zawsze, gdy Recognize zwróci False. Rozpoznawanie i budowa treści kończą się dla każdej żądanej strony, zanim transakcja dokumentu się otworzy, więc anulowanie na stronie 40 z 50 donosi otlsCancelled i zostawia wszystkie 50 stron załadowanymi. Pozostałe limity trzymają ten sam styl:
- Timeout biegnie od startu każdego wywołania
Recognize, więc domyślne 60 000 ms to limit per strona - Potomek wciąż biegnący przy timeoutcie albo anulowaniu jest zabijany i czekany do 5 sekund; prywatny katalog jest usuwany w bloku
finally, z ponawianiem kasowania do sekundy, bo pliki wyjściowe mogą zostać zablokowane krótko po końcu procesu output.tsvma sufit 64 MiB, astderr.txt1 MiB, sprawdzane w trakcie biegu potomka i po jego wyjściu- Słowa i jednostki kodowe UTF-16 na stronę są ograniczone tym, co zostaje z
MaxWordsPerPage,MaxTotalWordsiMaxTextCodeUnits; przekroczenie wywala przebieg zamiast obcinać listę - Niezerowy kod wyjścia wraca z do 4096 znaków
stderr.txt— najszybszy sposób, by się dowiedzieć, że brakuje pliku.traineddata
Jak niewidoczna warstwa tekstu wygląda wewnątrz strony
HotPDF zapisuje słowa w trybie renderowania tekstu 3 (ani wypełnienie, ani kreska, ISO 32000-1 §9.3.6), więc skan pozostaje widoczny, podczas gdy wyszukiwanie i kopiowanie pracują na słowach. Content stream otwiera BT z 3 Tr; każde słowo dostaje macierz Tm przy swojej linii bazowej, rozmiar czcionki równy wysokości boxa w pikselach razy 72 przez renderowe DPI i skalę Tz rozciągającą bieg do szerokości boxa. To rozciągnięcie trzyma podświetlenie wyszukiwania na słowie w obrazie
TSV ma boxy, ale nie ma linii bazowych, więc każda linia bazowa jest kładziona jedną piątą wysokości boxa nad dolną krawędzią. Między sąsiednimi słowami na linii od lewej do prawej w skryptach rozdzielanych spacjami, jak łacina czy cyrylica, rozciągnięta spacja wypełnia przerwę, więc skopiowany tekst zachowuje granice słów; chiński dostaje żadnej. Glify idą przez współdzieloną nieosadzoną czcionkę Type0 z kodowaniem Identity-H i generowaną mapą ToUnicode — jeden CID na odrębny skalar Unicode — i tak chiński, łacina z diakrytykami i znaki z płaszczyzny dodatkowej przeżywają kopiowanie i wyszukiwanie. Jeden bieg trzyma do 65 535 odrębnych skalarów, a ponieważ ISO 19005 wymaga czcionek osadzonych, wyjście PDF/A potrzebuje osobno osadzonej zgodnej czcionki. Aby sprawdzić wynik, zapisz, przeładuj i puść zwykłą ścieżkę z ekstrakcji tekstu z załadowanego PDF w Delphi; jeśli oczekiwane słowa wracają na oczekiwanych stronach, warstwa jest prawdziwa
RapidOCR i natywna DLL na tej samej umowie
Dla skanów w chińskim uproszczonym HPDFCreateRapidOCREngine(PythonExecutable, BridgeScript, ModelDirectory, TimeoutMilliseconds) reużywa tego samego runnera procesowego i parsera TSV. Ścieżka skryptu mostu idzie za wykonywalnym Pythona, a język jest zpięty na chi_sim. HotPDF dostarcza most jako tools/OCR/rapidocr_tsv.py; potrzebuje pakietów rapidocr i onnxruntime, lokalnych modeli ONNX i pliku czcionki, odmawia automatycznych pobrań i zapisuje TSV w kształcie Tesseracta; overload THPDFRapidOCROptions ustawia pliki modeli, liczniki wątków i sufit pikseli. Uniwersalna fabryka za oboma adapterami, HPDFCreateLocalTSVOCREngine w HPDFLocalTSVRecognition, przyjmuje każdy program biorący argumenty w stylu Tesseracta i zapisujący dwunastokolumnowy TSV, i dziedziczy listę uchwytów, timeout, anulowanie i budżety
HPDFCreateTesseractDLLOCREngine(LibraryPath, TessDataDirectory, Language) ładuje zamiast tego C API Tesseracta w procesie, zgłasza się jako Tesseract (native DLL), sprawdza z góry, że każdy żądany plik .traineddata istnieje, i mapuje anulowanie oraz timeout na własny monitor postępu Tesseracta. Oszczędza start procesu i powrotną drogę BMP na stronę; plik wykonywalny trzyma crashe i wzrost pamięci rozpoznawacza poza Twoją przestrzenią adresową. Dla desktopowego narzędzia pracującego na skanach użytkownika DLL jest w porządku. Dla serwisu połykającego dokumenty od obcych silnik linii poleceń to bezpieczniejszy wybór. Tak czy inaczej rozpoznawanie biegnie na Windows, jedna strona naraz, na wyrenderowanej bitmapie, więc wyprostuj i wyczyść trudne skany, zanim dotrą do silnika
Adaptery OCR, pisarz warstwy tekstu, renderer je karmiący i ekstrakcja sprawdzająca wyjście mieszkają wszystkie w jednym natywnym komponencie VCL dla Delphi i C++Builder. Jeśli Twoja aplikacja akwizycji albo archiwizacji potrzebuje wyjścia przeszukiwalnego PDF, komponent HotPDF Delphi PDF pokrywa wszystko poza silnikiem OCR, który instalujesz sam