W foncie TrueType trzymającym standardowy porządek glifów Makintosha słowo "Total" może siedzieć w strumieniu treści PDF jako <0037005200570044004F> Tj. Te pięć dwubajtowych wartości to numery glifów wewnątrz osadzonego fontu i nic w ciągu nie mówi, że rysują T, o, t, a i l. Przeczytasz te bajty jako UTF-16 i dostaniesz ciąg 7RWDO, podczas gdy strona sama pokazuje Total na ekranie, bo narysowanie glifa potrzebuje tylko mapowania kod-na-glif, a odzyskanie tekstu potrzebuje mapowania kod-na-Unicode, którego plik mógł nigdy nie nieść
Dlaczego wyciągnięty tekst wychodzi jako bełkot?
Strumień treści rejestruje kody znaków, a ich znaczenie mieszka całkowicie w foncie. Operatory Tj i TJ (ISO 32000-1 §9.4.3) niosą ciągi bajtów interpretowane przez cokolwiek, co wybrał poprzedzający Tf: bajt 0x41 to litera A pod WinAnsi, dowolny glif w foncie podzbioru albo połowa dwubajtowego CID w kompozytowym foncie CJK. ISO 32000-1 §9.10 traktuje ekstrakcję tekstu jako dokładnie ten problem dekodowania, mapując każdy kod z powrotem do Unicode z tego, co dostarcza słownik fontu, i mówi wprost, że zgodny plik nie musi dostarczyć dość informacji, żeby to zrobić
Ta klauzula stoi za każdym zgłoszeniem "kopiuj-wklej z tego PDF-a daje śmieci". Producent, który osadził font podzbioru bez tabeli /ToUnicode, zapisał poprawny plik, który renderuje się dobrze. Glify tam wszystkie są. Brakuje mapy odwrotnej, którą ekstraktor musi odbudować z dowodów drugorzędnych: zadeklarowanego kodowania fontu, nazw glifów, opublikowanych kolekcji znaków Adobe, tabeli cmap wewnątrz osadzonego programu fontu. Ile z tego API próbuje i co wręczy ci, gdy zawiedzie wszystko, to właśnie rozdziela w praktyce biblioteki ekstrakcji
Tekst w kolejności czytania przez ExtractLoadedPageText
HotPDF Delphi Component zwraca tekst wczytanej strony w kolejności czytania przez function ExtractLoadedPageText(PageIndex: Integer; out AText: UnicodeString): boolean. Indeksy stron są od zera, wynikiem jest natywny delphiowski UnicodeString, a funkcja zwraca False, gdy strona nie ma czytelnego strumienia treści, zamiast podnosić wyjątek. Działa na każdym PDF, który wczytasz: faktura przesłana mailem przez klienta, raport dostarczony przez biuro skanujące, umowa wyprodukowana przez softwar, którego nikt już nie potrafi nazwać
var
  Pdf: THotPDF;
  PageCount, I: Integer;
  PageText, AllText: UnicodeString;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('invoice.pdf');  // zwraca liczbę stron
    AllText := '';
    for I := 0 to PageCount - 1 do
      if Pdf.ExtractLoadedPageText(I, PageText) then
        AllText := AllText + PageText + #13#10;
  finally
    Pdf.Free;
  end;
end;
Dla całego dokumentu w jednym ciągu ExtractLoadedPagesText(PageRange, PageSeparator) bierze zakres liczony od jedynki, jak '1,3-5,7-' (pusty ciąg znaczy każdą stronę) i wstawia PageSeparator, domyślnie form feed #12, między strony. Duże dokumenty lepiej przechodzą przez ExtractLoadedPagesTextToStream, które pisze UTF-8 strona po stronie do TStream i zwraca, ile stron przetworzyło
Tekst trzyma to, co strona pokazuje. Glify, których środek pudełka wypada poza widocznym obszarem (pudło przycinania wewnątrz pudła mediów), są wypuszczane, więc znaki drukarskie na przyciętej stronie nie przeciekają do twojego indeksu. Tekst wewnątrz Form XObjects, które strona maluje, jest wliczany, przycięty do /BBox każdej formy. Znak namalowany dwa razy w tym samym miejscu, stara sztuczka na udawanie pogrubienia, jest czytany raz; udawane pogrubienie i zduplikowane glify w ekstrakcji tekstu przechodzi przez to, jak ten przypadek jest wykrywany
Łamania linii podążają za prostą regułą geometryczną. Nowa linia zaczyna się, gdy początek glifa przeskoczy kierunek pisania o więcej niż połowę wysokości tekstu, liczoną jako większa z wysokości od wzniesienia do zejścia tego glifa i poprzedniego glifa w jednostkach strony. Mierzenie pudełka glifa zamiast operandu rozmiaru w Tf to część, która się liczy: mnóstwo producentów wymiaruje tekst przez macierz tekstu i podaje 1 do Tf, a próg zbudowany na tym operandzie waliłby na każdym podniesionym indeksie górnym i kładł każdy znak obróconego tekstu na osobnej linii. Spacje działają tak samo. Tam, gdzie producent rozdziela słowa przesuwając pozycję tekstu korektą TJ albo Td zamiast pokazać spację, spacja jest dodawana, gdy przerwa po własnej szerokości poprzedniego glifa przekroczy 0.15 wysokości glifa, i nigdy między dwoma znakami chińskimi, japońskimi albo koreańskimi. Kody, których dekoder nie rozwiąże, stają się spacjami, więc granice słów przeżywają, nawet gdy pojedyncze glify nie. Poziomy tekst wychodzi w kolejności strumienia treści; pionowe biegi CJK są grupowane ponownie w kolumny czytane z prawej do lewej, z góry na dół. Spacje i łamania linii w tekście strony omawia te progi
Siatka, kolumny albo kolejność struktury
Gdy pozycja niesie znaczenie (tabele, formularze, listingi kodu, cokolwiek będziesz robić przez diff, grep albo parsować po kolumnie), lepszym wywołaniem jest ExtractLoadedPageTextLayout. Klastruje glify w linie bazowe, sortuje każdą linię po X i odtwarza poziomą i pionową pustkę na siatce znaków o stałej szerokości, wymiarowanej z mediany przyrostu glifa i rozmiaru czcionki strony. Szerokie przerwy na linii bazowej stają się biegami spacji, duże przerwy między liniami bazowymi — pustymi liniami
uses System.IOUtils;
...
var
  Grid: UnicodeString;
begin
  if Pdf.ExtractLoadedPageTextLayout(0, Grid) then
    TFile.WriteAllText('page1.txt', Grid, TEncoding.UTF8);
  // Kolumny, wcięcia i wyrównanie tabel przeżywają jako
  // spacje i puste linie na siatce znaków
end;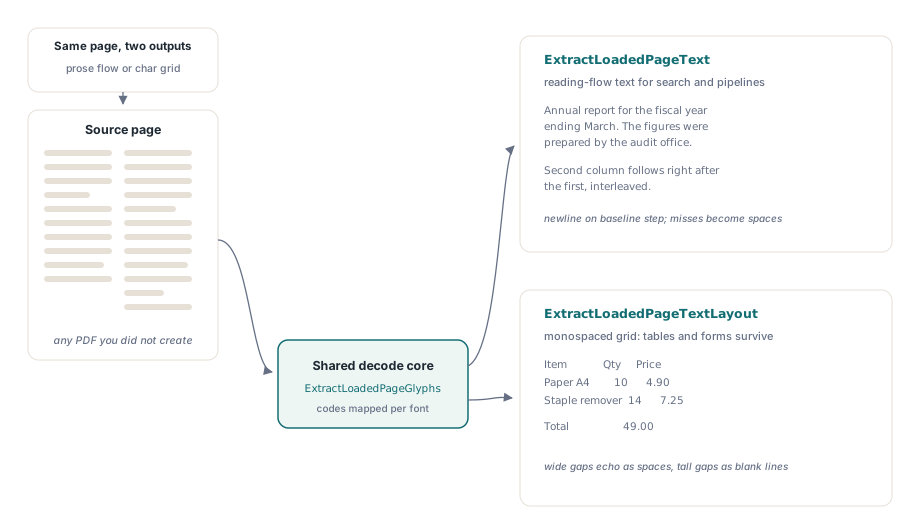
Oba wywołania dekodują przez tę samą machinerię, więc wybór jednej nie kosztuje nic w wierności. Czego siatka nie zrobi, to przepłynięcia prozy: dwukolumnowy artykuł wychodzi z obiema kolumnami obok siebie, wiernie, co jest dobre dla diff-a, a złe dla podsumowywacza. Dwa inne wywołania łatają tę lukę. ExtractLoadedPageTextColumns(PageIndex, AText, ColumnGapMultiplier) tnie każdy wiersz wszędzie tam, gdzie przerwa między sąsiednimi glifami przekracza mnożnik razy mediana przyrostu (domyślnie 3.0), i rozdziela kawałki tabulatorem. ExtractLoadedPageStructureText(PageIndex, AText, UntaggedGlyphCount) przechodzi drzewo struktury PDF-a z tagami (ISO 32000-1 §14.8.4) i zwraca biegi marked-content w kolejności autorskiej; zwraca False, gdy strona nie ma używalnego drzewa struktury, a UntaggedGlyphCount mówi ci, ilu glifów nie umiała umiejscowić
Dla tekstu, który będzie czytał człowiek albo model językowy, spróbuj najpierw kolejności struktury, a spadnij na ExtractLoadedPageText. Drzewo struktury to jedyny porządek zadeklarowany przez autora celowo, a każda metoda geometryczna jest przy tym porównaniu zgadywaniem. Zostaw siatkę robotom, w których kolumny są danymi. Ekstrakcja tekstu w kolejności struktury ma szczegóły dopasowywania marked content do drzewa
Jak HotPDF dekoduje kody znaków na Unicode
HotPDF Delphi Component rozwiązuje każdy kod znaku przez priorytetowy łańcuch zastępowania, a strategia, która nie umie odpowiedzieć, podaje kod następnej. CMap /ToUnicode fontu (ISO 32000-1 §9.10.3) idzie pierwsza, bo to jedyne mapowanie, które producent napisał specjalnie do ekstrakcji. Po niej przychodzą nazwy glifów z tablicy /Differences w /Encoding, czytane przez Adobe Glyph List; potem sama CMap /Encoding, osadzona jako strumień albo nazwana, gdzie nazwa Uni…-UTF16 znaczy, że kod już jest UTF-16. Fonty kompozytowe ciągną dalej przez kolekcje znaków Adobe (Adobe-GB1, Adobe-CNS1, Adobe-Japan1, Adobe-Korea1, Adobe-KR) od CID do Unicode, potem przez /CIDToGIDMap do tabeli cmap osadzonego programu fontu, czytanej od tyłu od glifa do Unicode. Proste fonty spadają na tabele WinAnsi, MacRoman, Standard i MacExpert, a na końcu na tę samą osadzoną cmap. Kod, który wyczerpie łańcuch, rozwiązuje się do 0
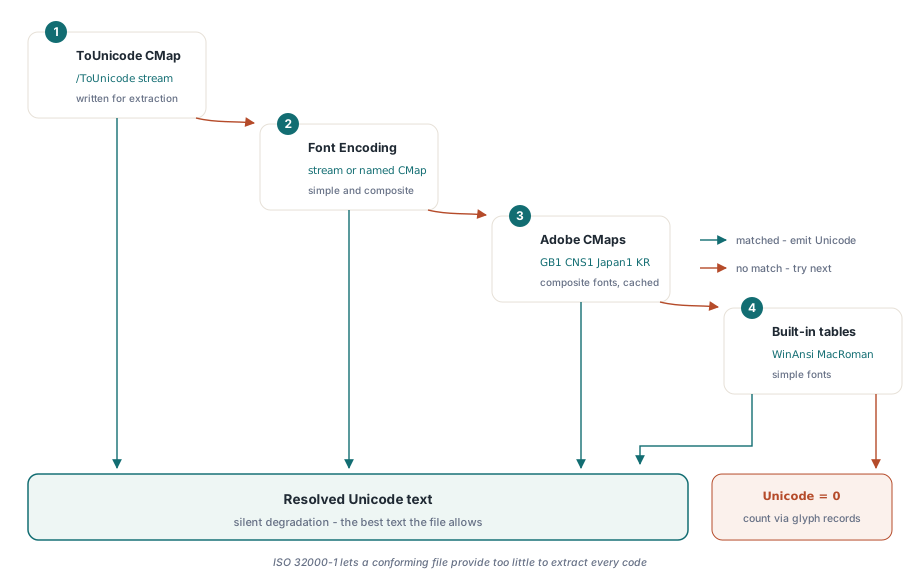
Krok osadzonej cmap to ten, który ratuje wiele fontów podzbiorów pływających bez /ToUnicode: program fontu zwykle wciąż zawiera własną cmap Unicode, a jej odwrócenie odzyskuje większość tekstu. To jednak rekonstrukcja. Dwa znaki Unicode dzielące jednego glifa wrócą oba jako ten, którego cmap wypisze, więc traktuj odzyskany tekst jako dobry do wyszukiwania i indeksowania i sprawdź go, zanim użyjesz go jako zapisu prawnego
Dane kolekcji Adobe żyją na dysku. HotPDF pływa z plikami CMap i cid2code.txt pod swoim folderem resources\CMap, parsuje każdy plik najwyżej raz na proces i cacheuje wynik; sama mapa Adobe-GB1 to z grubsza 2 MB tekstu, którego nie chcesz parsować per strona. Predefiniowane CMap istnieją też jako wbudowane tabele, więc font zakodowany nazwaną CMap, jak UniGB-UTF16-H, dekoduje się i bez folderu. Tabele CID-na-Unicode dla fontów CJK Identity-H folderu jednak potrzebują. Właściwość CMapResourcePath nazywa folder trzymający podfoldery kolekcji; pozostawiona pusta, HotPDF szuka resources\CMap obok pliku wykonywalnego i jeden-dwa poziomy nad nim
Pdf := THotPDF.Create(nil);
try
  // Folder zawierający Adobe-GB1-6, Adobe-CNS1-7, Adobe-Japan1-7 ...
  Pdf.CMapResourcePath := 'C:\MyService\resources\CMap';
  Pdf.LoadFromFile(FileName);
  ...
finally
  Pdf.Free;
end;
Ustaw ścieżkę jawnie w każdej usłudze, module ISAPI albo DLL wtyczki. W tych hostach ParamStr(0) nazywa proces hosta, który rzadko jest folderem, do którego deployowałeś, a brak folderu nie podnosi wyjątku; strony CJK po prostu wracają z dziurami tam, gdzie wypełniłyby tabele kolekcji. Kształtowanie tekstu pism złożonych w HotPDF spotyka ten sam rozdział kod-versus-glif w czasie pisania
Dwie pułapki składni CMap
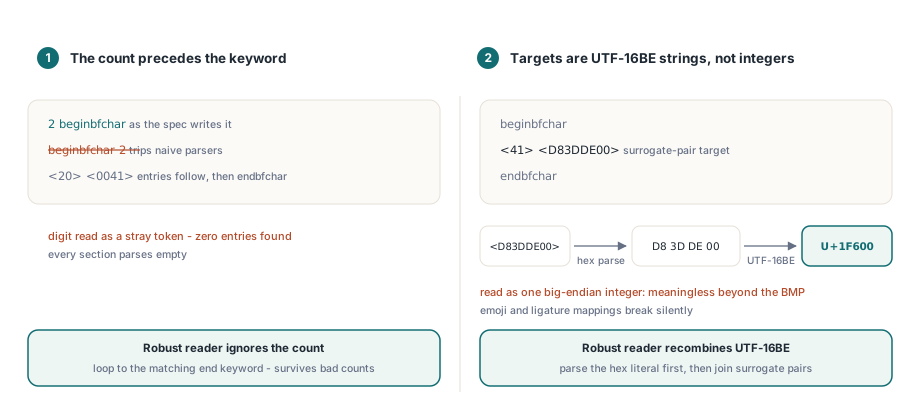
Pliki CMap wyglądają na trywialnie parsowalne, a dwa szczegóły wywracają większość pierwszych prób. Liczba rekordów przychodzi przed słowem kluczowym sekcji: sekcja czyta 2 beginbfchar, nigdy beginbfchar 2. Parser oczekujący liczby po słowie kluczowym połknie liczbę jako zbłąkany token, a potem znajdzie zero wpisów w każdej sekcji. Czytnik HotPDF ignoruje liczbę całkowicie i pętluje do pasującego endbfchar albo endbfrange, co przy okazji znosi prawdziwe pliki, których zadeklarowane liczby są złe
Druga pułapka: cele bfchar i bfrange to ciągi UTF-16BE. Cel <D83DDE00> znaczy U+1F600, parę surrogate, którą trzeba złożyć z powrotem w jeden punkt kodowy, a przeczytanie tych czterech bajtów jako big-endian liczby całkowitej daje bezsensowną wartość dla każdego znaku poza Basic Multilingual Plane, emoji włącznie. HotPDF parsuje literał hex na gołe bajty najpierw, a potem składa jednostki kodowe UTF-16BE, co obsługuje też wieloznakowe cele, jakie produkują mapowania ligatur, jak jeden glif fi mapowany na dwie litery
Zliczanie nierozwiązanych glifów przez ExtractLoadedPageGlyphs
ExtractLoadedPageGlyphs(PageIndex, AGlyphs) wystawia rekordy glifów pod spodem wywołań tekstowych jako THPDFGlyphArray. Każdy THPDFGlyphRecord niesie surowy Code, jego CodeByteWidth (1, 2 albo 4, rozstrzygane przez codespacerange CMap), rozwiązany punkt kodowy Unicode plus UnicodeSequence dla ligatur, aktywny FontKey i FontSize, początek X i Y w przestrzeni użytkownika, Advance, czteronarożnik glifa oraz GlyphEndX / GlyphEndY, koniec własnej szerokości glifa, od której mierzy reguła spacji. To dosyć na pozycjonowane podświetlanie albo własny algorytm układu
var
  Glyphs: THPDFGlyphArray;
  I, Unresolved: Integer;
begin
  if Pdf.ExtractLoadedPageGlyphs(0, Glyphs) then
  begin
    Unresolved := 0;
    for I := 0 to High(Glyphs) do
      if Glyphs[I].Unicode = 0 then
        Inc(Unresolved);
    if Unresolved > 0 then
      ShowMessageFmt('%d of %d glyphs have no Unicode mapping',
        [Unresolved, Length(Glyphs)]);
  end;
end;
Liczenie rekordów Unicode = 0 to uczciwy sposób oceny dokumentu, zanim zaufasz jego tekstowi dalej w potoku. Oczekuj, że liczba będzie się lekko różnić od tej, którą widzą wywołania tekstowe. To wywołanie zwraca każdy glif we własnym strumieniu treści strony, włącznie z tymi poza pudłem przycinania i duplikatami namalowanymi dla udawanego pogrubienia, i nie schodzi do Form XObjects. Każdy rekord trzyma dodatkowo TokenIndex, ItemIndex i ByteOffset, które wiążą znak z jego źródłowym operandem; wyszukiwanie i zamiana w istniejącym PDF jest zbudowana na tych trzech polach
Niektóre pliki nie mają tekstu do oddania. Skanowana strona to jeden duży obraz bez operatorów tekstu, więc ekstrakcja poprawnie zwraca pusty ciąg, a drogą naprzód jest OCR, zaczynając od wyciągania obrazów strony z wczytanego PDF. Zaszyfrowane dokumenty ekstrahują się normalnie, gdy tylko zostaną otwarte przez LoadFromFile(FileName, Password), bo strumienie są deszyfrowane, zanim interpreter je przeczyta. Strumienie fontów i treści są dekodowane tym samym łańcuchem filtrów co reszta wczytanego dokumentu, a strumień /ToUnicode, którego nie da się zdekodować, spada do następnej strategii, podczas gdy reszta strony nadal się ekstrahuje. Ten sam czytnik obiektów napędza edycję metadanych na wczytanych dokumentach, więc jeden przebieg przyjęcia może przeczytać tekst i naprawić metadane
Ekstrakcja w kolejności czytania, siatkowa, kolumnowa i w kolejności struktury, plus dostęp na poziomie glifów, wszystko płynie w HotPDF Delphi Component dla Delphi i C++Buildera jako goły Object Pascal bez zewnętrznych DLL-i i systemowych usług tekstowych, więc gdy dziwny plik wyląduje w twojej kolejce, możesz wejść krokowo w dekoder i zobaczyć, która strategia odpowiedziała za każdy kod