Masz PDF na dysku, klient zeskanował go ze stosu faktur i twoim zadaniem jest wyciągnąć obrazy stron z powrotem jako bitmapy do etapu OCR. Wczytujesz plik, znajdujesz obiekty XObject obrazów i dopiero wtedy odkrywasz część, o której nikt nie uprzedza: bajty w tych strumieniach nie są pikselami. To może być strumień JPEG, albo blok JPEG 2000 skompresowany falowo, albo przebieg faksu Group 4, albo rastr indeksowany ukryty za paletą i filtrem Flate. Obiekt obrazu zna swoją szerokość i wysokość, ale rzeczywiste próbki są zamknięte w filtrze wybranym przez producenta. Żeby dostać użyteczny TBitmap, trzeba ten filtr odwrócić, a PDF daje na to mniej więcej osiem różnych sposobów
Tą luką zajmuje się ExtractLoadedImage w HotPDF, natywnym komponencie PDF VCL dla Delphi i C++Buildera. Wylicza obiekty XObject obrazów w wczytanym dokumencie, raportuje, czym każdy jest, i dekoduje te, które potrafi, z powrotem do 24-bitowej bitmapy. Ciekawa nie jest powierzchnia API, bo to trzy metody. Ciekawe jest to, dlaczego osobna ścieżka dekodowania w ogóle musi istnieć i które filtry zamienia z powrotem w piksele
Dlaczego wczytane obrazy nie są jeszcze zdekodowane
Loader HotPDF jest zbudowany wokół wiernego przepuszczania danych. Gdy wywołujesz LoadFromFile, strumienie obrazów pozostają dokładnie takie, jak w pliku źródłowym: oryginalny filtr, oryginalne skompresowane bajty, oryginalny słownik. To celowe. Cały sens wczytywania dokumentu zwykle polega na kopiowaniu stron, scalaniu plików, stemplowaniu ich, zmienianiu uprawnień i zapisywaniu z powrotem, a przy tym wszystkim najtańszą i najbezpieczniejszą rzeczą jest pozostawienie każdego strumienia obrazu bez zmian. Dekodowanie każdego obrazu do rastra przy ładowaniu spaliłoby pamięć i CPU na pracę, której większość wywołań nigdy nie potrzebuje, a ponowne kodowanie przy zapisie pogorszyłoby obrazy, które powinny zostać skopiowane dosłownie
Skutek jest taki, że wczytany graf obiektów nie niesie żadnych pikseli. Obiekt obrazu, którego /Filter to /DCTDecode, trzyma bajty JPEG; HotPDF nigdy nie puścił na nich dekodera JPEG, bo nic w ścieżce kopiuj-i-przepisz tego nie potrzebowało. Kiedy więc naprawdę chcesz piksele, API ekstrakcji musi zrobić dekodowanie samo, od zera, dla tego filtra, którego akurat używa dany obraz. To ten sam powód, dla którego kodeki po stronie zapisu są niezależne od loadera: artykuł o dodawaniu obrazów JPEG 2000 do PDF-ów w Delphi opisuje, jak silnik JPX wpina się po stronie tworzenia, a API ekstrakcji wpina ten sam silnik w ścieżkę odczytu
Interfejs API z trzema metodami
Interfejs jest niewielki. GetLoadedImageCount zwraca liczbę image XObjectów zawartych w załadowanym dokumencie. GetLoadedImageInfo wypełnia rekord deskryptora dla jednego z nich według indeksu. ExtractLoadedImage zwraca zdekodowaną bitmapę albo nil wtedy, gdy nie potrafi zdekodować tego obrazu. Enumeracja jest oparta na indeksach i stabilna dla danego załadowania: wewnętrznie metoda przechodzi po tabeli obiektów pośrednich i zbiera każdy strumień, którego /Subtype daje się rozwiązać do /Image, więc indeks przekazywany do GetLoadedImageInfo jest tym samym indeksem, który przekazujesz do ExtractLoadedImage
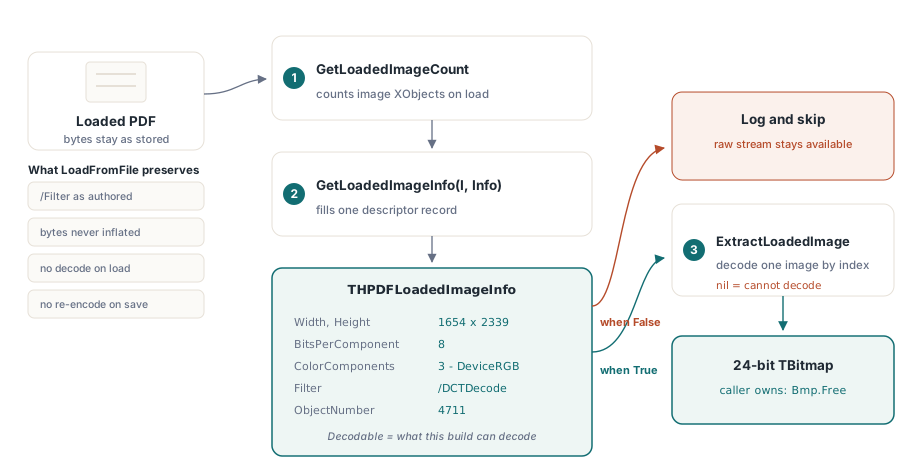
var
  Pdf: THotPDF;
  Info: THPDFLoadedImageInfo;
  Bmp: TBitmap;
  I, Count: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('scanned-invoices.pdf', '') <= 0 then
      Exit;
    Count := Pdf.GetLoadedImageCount;
    for I := 0 to Count - 1 do
    begin
      if not Pdf.GetLoadedImageInfo(I, Info) then
        Continue;
      if not Info.Decodable then
        Continue;                       // filtr lub przestrzeń barw nie jest obsługiwana
      Bmp := Pdf.ExtractLoadedImage(I);
      if Bmp <> nil then
      try
        Bmp.SaveToFile(Format('img_%d.bmp', [I]));
      finally
        Bmp.Free;                       // wywołujący jest właścicielem bitmapy
      end;
    end;
  finally
    Pdf.Free;
  end;
end;
Dwa szczegóły kontraktu mają tu znaczenie. Po pierwsze, zwrócony TBitmap musisz zwolnić samodzielnie; dokument go nie buforuje ani nie przejmuje własności. Po drugie, przed wywołaniem sprawdź Decodable, a po nim porównaj wynik z nil. Metoda nie zgłasza wyjątku przy nieobsługiwanym filtrze, tylko zwraca nil, a cichy nil w pętli wsadowej to dokładnie ten rodzaj błędu, przez który strona z tysiącstronicowego zadania znika niezauważona
Odczyt deskryptora przed dekodowaniem
THPDFLoadedImageInfo pozwala ustalić, czym jest obraz, bez zobowiązania się do pełnego dekodowania. Jego pola pochodzą bezpośrednio ze słownika obrazu: Width i Height w próbkach, BitsPerComponent, ColorComponents oraz ColorSpace opisujące interpretację po dekodowaniu (1 dla gray, 3 dla RGB, 4 dla CMYK), Filter jako nazwana kompresja, IsImageMask dla masek stencil, ObjectNumber dla bazowego obiektu pośredniego oraz Decodable
Ta ostatnia flaga jest tą uczciwą. Decodable ma wartość True tylko wtedy, gdy aktualna kompilacja potrafi rzeczywiście zamienić to konkretne połączenie filtra i przestrzeni kolorów na bitmapę. Koduje realną macierz obsługi, a nie życzenie: obraz, którego Filter nie jest rozumiany przez bieżącą kompilację, zgłasza Decodable = False, a ty możesz na tej podstawie logować, pomijać albo przełączyć się na własne wydobycie surowego strumienia. Traktuj to jako warunek wstępny, nie podpowiedź
// Zweryfikuj każdy obraz przed rozpoczęciem dekodowania
var
  Pdf: THotPDF;
  Info: THPDFLoadedImageInfo;
  I: Integer;
begin
  // ... Pdf loaded ...
  for I := 0 to Pdf.GetLoadedImageCount - 1 do
  begin
    if not Pdf.GetLoadedImageInfo(I, Info) then
      Continue;
    if Info.Decodable then
      // ExtractLoadedImage(I) will return a TBitmap
    else
      // nieobsługiwany filtr/przestrzeń barw: zapisz obiekt w logu i pomiń
      Writeln(Format('Image %d obj %d: %dx%d %s/%s not decodable',
        [I, Info.ObjectNumber, Info.Width, Info.Height,
         String(Info.Filter), String(Info.ColorSpace)]));
  end;
end;
Jeden szczegół implementacyjny potrafi ugryźć osoby budujące rekordy deskryptorów ręcznie. THPDFLoadedImageInfo zawiera dwa pola typu AnsiString, Filter i ColorSpace. Są to typy zarządzane z liczonymi referencjami, więc odruch polegający na zerowaniu rekordu przez FillChar(Info, SizeOf(Info), 0) jest tutaj błędny: nadpisuje referencję stringa bez jej zmniejszenia, co prowadzi do wycieku albo uszkodzenia stanu. HotPDF inicjalizuje rekord pole po polu właśnie z tego powodu, i jeśli kiedykolwiek skopiujesz ten wzorzec we własnym kodzie, zrób tak samo
Jeden dispatcher, osiem ścieżek filtrów
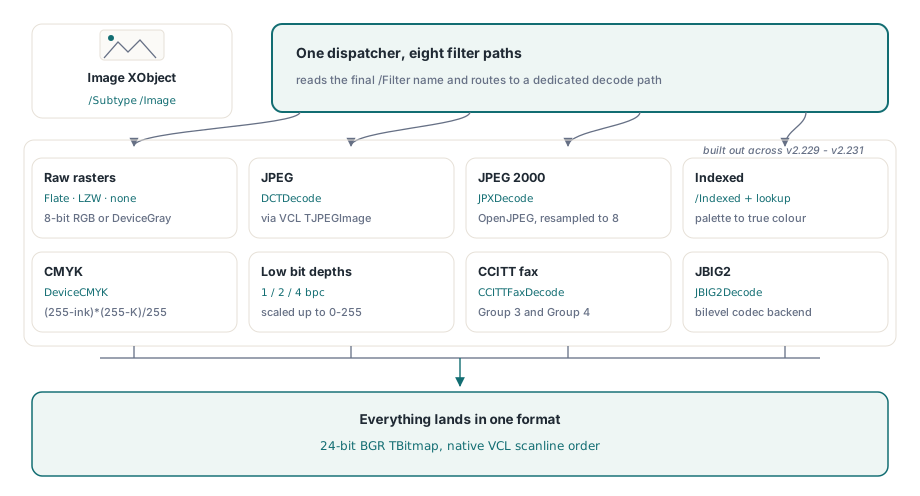
Powód, dla którego ekstrakcja w ogóle potrzebuje dispatchera, jest taki, że PDF nie ma formatu obrazu. Ma filtry, a §8.9.5 ISO 32000-1 pozwala image XObjectowi wskazać dowolny z nich w /Filter, przy czym interpretację próbek osobno określają /ColorSpace, /BitsPerComponent i opcjonalna tablica /Decode. ExtractLoadedImage czyta nazwę filtra i kieruje do dedykowanego dekodera dla każdego przypadku. Obsługiwany zestaw pokrywa osiem odrębnych ścieżek
- Surowe rastry (FlateDecode, LZWDecode lub bez filtra) w 8-bitowym DeviceRGB albo DeviceGray. Bajty są dekompresowane do upakowanego rastra, a jedyną transformacją jest zamiana kolejności kanałów, opisana niżej
- DCTDecode (JPEG). Strumień kodowy jest przekazywany do klasy
TJPEGImage, która rozwiązuje geometrię i kolor, a wynik jest przypisywany do 24-bitowej bitmapy - JPXDecode (JPEG 2000). Dekodowanie odbywa się przez backend OpenJPEG, czyli ten sam silnik opisany w artykule o JPEG 2000, a komponenty o dużej głębi bitowej są przeskalowywane w dół do 8 bitów
- Kolor indeksowany. Paleta jest odczytywana z tablicy
[/Indexed base hival lookup], a każda próbka jest rozwijana przez tabelę lookup do pełnego koloru - DeviceCMYK. Próbki czterokanałowe są konwertowane do RGB przy użyciu standardowego wzoru farba na białym
- DeviceGray i Indexed poniżej 8 bitów przy 1, 2 albo 4 bitach na komponent, rozpakowywane próbka po próbce i skalowane do zakresu 0–255
- CCITTFaxDecode, czyli filtry faksowe Group 3 i Group 4, dekodowane przez dedykowany backend T.4/T.6
- JBIG2Decode, czyli filtr bilevel o wysokim współczynniku kompresji, dekodowany przez zarejestrowany backend JBIG2 opisany od strony kodowania w artykule o natywnej kompresji JBIG2
Wszystko trafia do tego samego miejsca: 24-bitowej bitmapy BGR, ponieważ to właśnie natywnie przechowuje obiekt VCL TBitmap i tego oczekuje każdy dalszy konsument
Transformacje, które po cichu zmieniają piksele
Dwie z tych ścieżek obejmują transformacje, które łatwo subtelnie zepsuć, i warto je rozumieć, nawet jeśli nigdy nie dotykasz samego dekodera. Pierwsza to zamiana kolejności kolorów. Raster PDF DeviceRGB przechowuje próbki w kolejności red-green-blue, od górnego wiersza. Linia skanowania VCL 24-bit przechowuje je w kolejności blue-green-red. Zatem dekodowanie zwykłego obrazu RGB nie jest memcpy: pierwszy i trzeci bajt każdego piksela są zamieniane podczas zapisu do scanline. Jeśli zrobisz to odwrotnie, czerwienie i błękity zamienią się miejscami, co na teście w skali szarości wygląda dobrze, a na kolorowym katastrofalnie źle. Kolejność wierszy, o ile to ważne, przechodzi wprost: rastry PDF od góry do dołu pokrywają się z tym, że VCL traktuje ScanLine[0] jako górny wizualnie wiersz, więc pionowe odwrócenie nie jest potrzebne
Druga sprawa to CMYK. Obrazy PDF DeviceCMYK niosą cztery farby, a konwersja do RGB jest obliczeniem per kanał, a nie lookupem: każdy kanał wyjściowy to (255 - ink) * (255 - K) / 255. To przybliżenie urządzeniowe, a nie zarządzanie kolorem przez profil ICC, więc wynik jest wystarczająco poprawny do wyświetlania i ponownej rasteryzacji, ale nie jest właściwą drogą, jeśli potrzebujesz dokładności drukarskiej. Jeśli workflow wymaga wierności, traktuj wydobytą bitmapę jako podgląd i zachowaj oryginalny strumień CMYK dla potoku zarządzania kolorem
Ścieżka Indexed ukrywa własną pułapkę parsowania. Paleta w przestrzeni barw /Indexed może być przechowywana jako dosłowny string albo jako string szesnastkowy, a HotPDF przechowuje wartość stringa hex jako tekst szesnastkowy, a nie zdekodowane bajty. Gdy więc paleta jest stringiem hex, tabela lookup musi najpierw przejść przez dekodowanie hex na bajty; string dosłowny to już surowe bajty. Pominięcie tej gałęzi sprawia, że czterokolorowy obraz indeksowany wychodzi jako śmieci, bo każdy wpis palety jest czytany z niewłaściwej granicy bajtów
Łańcuchy filtrów: ostatni filtr należy do samego obrazu
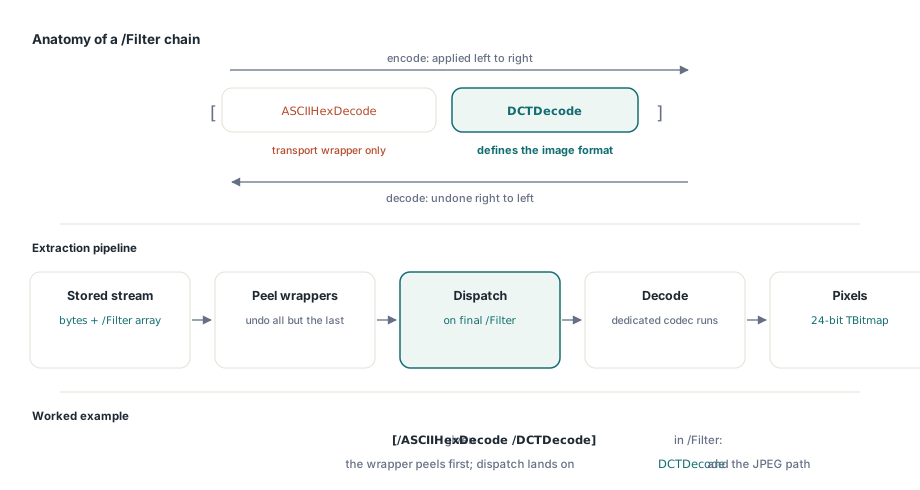
Pojedyncza nazwa /Filter to łatwy przypadek. PDF dopuszcza też łańcuch filtrów, gdzie strumień został kolejno przepuszczony przez kilka filtrów, wymienionych po kolei w tablicy /Filter takiej jak [/ASCII85Decode /FlateDecode] albo [/ASCIIHexDecode /DCTDecode] (ISO 32000-1 §7.4). Semantyka jest precyzyjna: przy kodowaniu filtry stosuje się od lewej do prawej, więc przy dekodowaniu odwracasz je od prawej do lewej, a ostatni filtr w tablicy jest tym, który faktycznie definiuje format obrazu. Poprzedzające filtry są tylko kodowaniami transportowymi owiniętymi wokół niego
Ekstraktor obsługuje to przez obieranie warstw. Zanim uruchomi się jakikolwiek dekoder obrazu, każdy filtr w łańcuchu poza ostatnim jest stosowany tak, aby wytworzyć wejście oczekiwane przez filtr końcowy, i dopiero wtedy następuje dispatch po tym ostatnim filtrze. Tak więc [/ASCII85Decode /DCTDecode] najpierw zdejmuje z strumienia ASCII85, a potem przekazuje wynik do ścieżki JPEG. [/FlateDecode] owinięte wokół surowego rastra najpierw dekompresuje dane, a potem uruchamia ścieżkę rastra. Dzięki temu osiem dekoderów może pozostać prostych. Żaden z nich nie musi wiedzieć o transportowych otoczkach ASCII85 czy hex, bo gdy dekoder widzi bajty, te otoczki są już usunięte. Oznacza to też, że łańcuch, którego końcowy filtr jest nieobsługiwany, kończy się czysto na etapie dispatchu zamiast w połowie
Co dostajesz z powrotem i kiedy użyć surowego strumienia
Dostajesz obraz bazowy, taki, jaki dekoduje jego własny strumień, a nie wynik złożony z nałożoną miękką maską. Komponenty JPEG 2000 głębsze niż 8 bitów są przeskalowywane do 8, co pasuje wyświetlaniu i OCR, a maska obrazu, jednobitowy stencil bez własnego koloru, jest opisywana przez IsImageMask, więc możesz traktować ją jak stencil, a nie fotografię. Obraz, którego końcowy filtr albo przestrzeń barw wypada poza zestaw powyżej, zwraca nil, i dlatego osłona Decodable należy do każdej pętli
Gdy potrzebujesz alfy, pełnej głębi bitowej albo wyjścia z zarządzaniem kolorem, surowy strumień wciąż tam siedzi w wczytanym grafie obiektów, razem z filtrem, i możesz wyciągnąć go bajt w bajt i podać własnemu, wyspecjalizowanemu kodekowi. To fallback, który projekt pass-through zachowuje celowo: oryginalne bajty nigdy nie są wyrzucane, więc najgorszy przypadek to tyle, że zdekodujesz je sam, a nie że danych brak. W większości realnych zadań obsługiwane osiem filtrów pokrywa jednak to, co faktycznie emitują skanery, pakiety biurowe i silniki raportowe, a pętla po GetLoadedImageCount z osłoną Decodable zamienia wczytany PDF z powrotem w folder bitmap w kilku liniach
Interfejs wydobywania obrazów z załadowanego dokumentu wraz z pełnym zestawem opisanych tu filtrów dekodowania jest dostarczany w HotPDF Delphi Component dla Delphi i C++Builder