TerminateThread wygląda jak oczywisty sposób na zatrzymanie wywołania OCR, które mieli jedną zeskanowaną stronę dłużej, niż UI jest gotów czekać. Dokumentacja Windows wyjaśnia, dlaczego to nie to: jeśli wątek docelowy trzyma lock sterty procesu, ten lock nigdy nie zostaje zwolniony, a następna alokacja na dowolnym innym wątku może zablokować się na zawsze. Skoro OCR działa w Twoim własnym procesie, jedynym bezpiecznym stopem jest kooperatywny, na punktach kontrolnych między etapami inferencji — i to jest cena za załadowanie modeli ONNX raz i utrzymanie ich ciepłymi
Alternatywa, którą większość zespołów Delphi próbuje najpierw, to proces potomny. Pythonowy worker na stronę można zabić w dowolnej chwili, co kusi, ale każde wywołanie startuje interpreter, importuje runtime i ładuje modele detekcji oraz rozpoznawania, zanim przeczyta pierwszy piksel. Załóżmy archiwizację 500 stron: ta praca startowa wykonuje się 500 razy, a deployment obejmuje teraz środowisko Python siedzące obok natywnego pliku wykonywalnego
Przeszukiwalny PDF ze skanów przez HPDFCreateRapidOCRDLLOCREngine
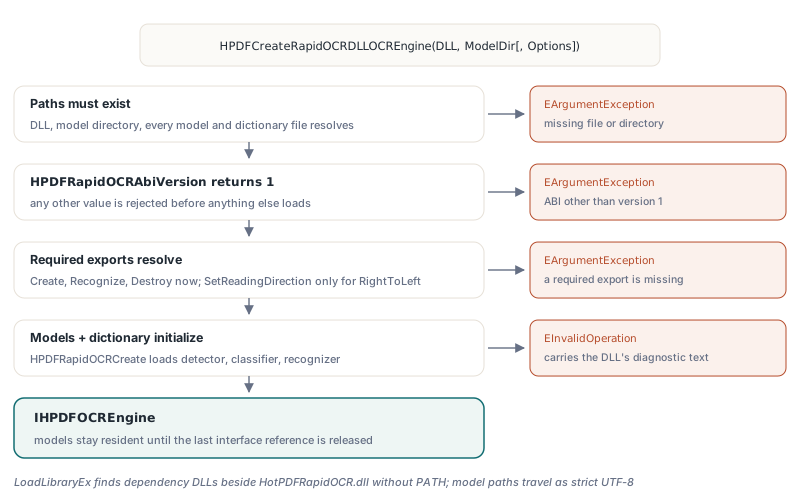
HotPDF puszcza RapidOCR w procesie przez HPDFCreateRapidOCRDLLOCREngine, zadeklarowane w jednostce HPDFRapidOCRRecognition. Fabryka ładuje HotPDFRapidOCR.dll, raz inicjalizuje modele detekcji ONNX, opcjonalnej klasyfikacji kąta i rozpoznawania, po czym zwraca IHPDFOCREngine. Ten silnik wpina się w THotPDF.ApplyLoadedOCRTextLayer dokładnie jak pozostałe silniki OCR: dokument renderuje każdą stronę, DLL odpala na niej inferencję na CPU, a wynik zostaje zatwierdzony jako niewidoczna warstwa tekstu Unicode. Bez Pythona, bez procesu potomnego. Adapter jest dostarczany dla buildów Delphi, C++Builder i FPC/Lazarus na Windows
Walidacja dzieje się w fabryce, zanim cokolwiek dotknie stronę. Każdy plik modelu i słownika musi się rozwiązać, HPDFRapidOCRAbiVersion musi zwrócić 1, a wymagane eksporty muszą istnieć, zanim HPDFRapidOCRCreate zbuduje modele. Błędy konfiguracji podnoszą EArgumentException; model, który odmawia załadowania, podnosi EInvalidOperation z własną diagnostyką DLL, na przykład ze słownikiem niepasującym do modelu rozpoznawania
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // Tu ładują się modele, poza każdym deadline'em rozpoznawania.
  // Nazwy względne z THPDFRapidOCRDLLOptions.Default rozwiązują się
  // względem katalogu modeli
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models');
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;  // 300 DPI, MinimumConfidence 0.5
    // pusta lista stron = wszystkie strony; SkipPagesWithText domyślnie True
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFRapidOCRDLLOptions.Default wymienia ch_PP-OCRv3_det_infer.onnx, ch_PP-OCRv3_rec_infer.onnx, ch_ppocr_mobile_v2.0_cls_infer.onnx i ppocr_keys_v1.txt, z jednym wątkiem CPU, limitem wejścia 16 777 216 pikseli i deadline'em 60 000 ms na wywołanie rozpoznawania. Dla innych pism THPDFRapidOCRDLLOptions.ForLanguage zostawia te domyślne i podmienia <profile>/recognition.onnx plus <profile>/dictionary.txt dla jednego z dziewięciu profilów, od chińskiego tradycyjnego i cyrylicy po arabski i dewanagari. Każdy silnik czyta jeden język; dobierz profil per strona albo per dokument. Czemu model i słownik zawsze podróżują w parze, opisuje artykuł o wielojęzycznych modelach RapidOCR i słownikach CTC w HotPDF
Silnik przedstawia się jako RapidOCR (native DLL) w Info.EngineName. Loguj ten string. Gdy ten sam serwis puszcza też adapter zewnętrznego procesu Tesseract albo wbudowany silnik OCR z dopasowaniem szablonów, to najszybszy sposób, by powiedzieć, który rozpoznawacz wyprodukował złą stronę
Dlaczego ABI C mówi tylko int32_t i bajtami UTF-8?
Granica HotPDFRapidOCR.dll używa integerów o stałej szerokości, surowych wskaźników i jawnych długości w bajtach, bo Delphi, C++Builder i Free Pascal nie dzielą z MSVC niczego poza konwencją wywołań C. std::string, std::vector albo wyjątek C++ niesie układ pamięci i model unwindingu należące do jednego kompilatora i jednej biblioteki runtime, a przepuszczenie czegokolwiek z tego do kodu Pascala kończy się zepsutym stackiem albo blokiem sterty zwolnionym przez niewłaściwy alokator
ABI w wersji 1 to krótka lista reguł. Każdy eksport jest cdecl i zwraca status int32_t: 1 dla sukcesu, 0 dla porażki. Każda funkcja, która może się nie udać, bierze bufor diagnostyczny należący do wołającego i jego rozmiar w bajtach, a DLL zapisuje wiadomość UTF-8 zakończoną NUL, obciętą do rozmiaru. Wewnątrz DLL każde ciało eksportu siedzi w try z i catch (const std::exception &), i catch (...). Błąd ONNX Runtime, asercja OpenCV albo zniekształcony słownik staje się statusem 0 plus tekstem
| Eksport | Rola | Kiedy adapter go rozwiązuje |
|---|---|---|
HPDFRapidOCRAbiVersion | Zwraca 1; każda inna wartość jest odrzucana | Zaraz po załadowaniu DLL |
HPDFRapidOCRCreate | Ładuje modele detekcji, opcjonalnej klasyfikacji i rozpoznawania oraz słownik | W fabryce |
HPDFRapidOCRRecognize | Puszcza jedną bitmapę i wysyła jedno wywołanie zwrotne na linię tekstu | W fabryce |
HPDFRapidOCRDestroy | Zwalnia instancję modeli | W fabryce |
HPDFRapidOCRSetReadingDirection | Opcjonalna kolejność wierszy od prawej do lewej | Tylko gdy ustawiono RightToLeft |
Eksport kierunku czytania jest rozwiązywany leniwie celowo, więc DLL zbudowana bez niego nadal obsługuje każde żądanie od lewej do prawej. Adapter ładuje bibliotekę przez LoadLibraryEx z flagami wyszukiwania obejmującymi własny folder DLL plus domyślne bezpieczne katalogi; zależności ONNX Runtime albo OpenCV położone obok HotPDFRapidOCR.dll zostają znalezione bez edycji PATH. Ścieżki modelu i słownika przechodzą granicę jako UTF-8, a DLL konwertuje je przez MultiByteToWideChar w trybie ścisłym, zanim otworzy pliki przez API szerokich znaków. Katalog modeli spod C:\Users\Łukasz albo cyrylicka nazwa użytkownika otwierają się normalnie
Jedna reguła mieszka w plikach budowania, nie w nagłówku. DLL linkuje ONNX Runtime i OpenCV statycznie, a projekt CMake domyślnie bierze statyczną release'ową CRT (/MT). Wmieszaj biblioteki statyczne skompilowane pod /MD i dostaniesz błędy linkera, jeśli masz szczęście, i dwie niezależne sterty, jeśli nie. Prowizjonuj biblioteki zbudowane w tym samym trybie CRT co DLL
Co się dzieje między TBitmap a linią tekstu?
HotPDF wręcza DLL niezależną, top-down kopię BGR wyrenderowanej strony, a DLL oddaje jedno wywołanie zwrotne na rozpoznaną linię. Tekst w tym wywołaniu jest pożyczony: wskaźnik jest ważny tylko do powrotu z callbacku, więc adapter kopiuje go na miejscu
W Delphi migawka pochodzi z prywatnego TBitmap wymuszonego na pf24bit i czytanego przez GetDIBits z ujemnym biHeight. To daje wiersze od góry do dołu, dopełnione do czterobajtowego wyrównania, a stride wędruje do DLL jako jawny argument. Na FPC adapter czyta przez CreateIntfImage. Bitmapa wołającego nie jest modyfikowana. Sprawdzenia rozmiaru biegną przed alokacją kopii: najwyżej 32 767 pikseli na bok i nie więcej niż MaxPixels łącznie, co domyślnie daje 16 777 216 i można podnieść do 67 108 864
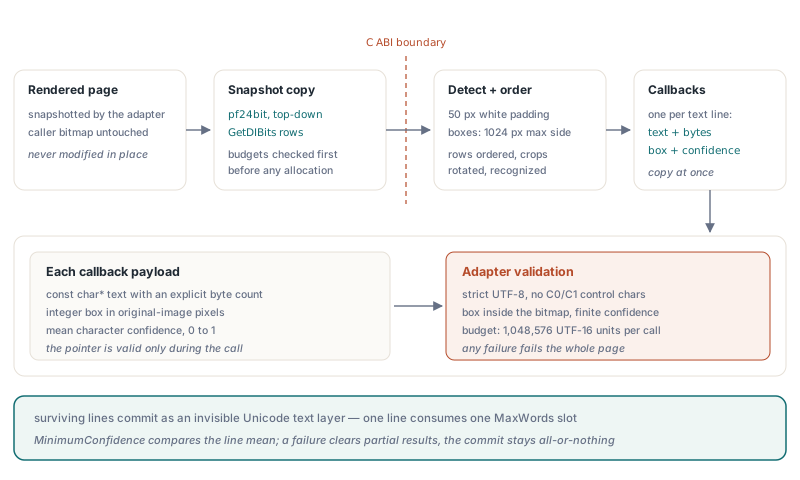
Wewnątrz DLL obraz dostaje 50-pikselową białą ramkę, regiony tekstu są wykrywane z dłuższym bokiem skalanym do najwyżej 1024 pikseli, a boxy są sortowane w poziome wiersze. Z włączonym klasyfikatorem kąta wycinek obraca się o 180 stopów tylko, gdy wynik do góry nogami przekroczy 0,9, co nie pozwala słabej predykcji przewrócić krótkich słów. Każda linia przychodzi potem jako const char*, liczba bajtów, integerowy box w pikselach oryginalnego obrazu i średnia pewność znaków. Adapter jest rygorystyczny co do tego, co przyjmuje:
- UTF-8 jest dekodowane z
MB_ERR_INVALID_CHARS, więc zniekształcona sekwencja bajtów wywala stronę zamiast sadzić znaki zastąpienia w przeszukiwalnej warstwie - Znaki kontrolne C0 i C1 są odrzucane; linie z samych białych znaków są pomijane
- Box musi leżeć wewnątrz bitmapy, a pewność musi być skończoną wartością od 0 do 1
- Tekst liczy się do
MaxTextCodeUnitsżądania, z twardym sufitem 1 048 576 jednostek UTF-16 na wywołanie; znaki spoza Basic Multilingual Plane kosztują dwie jednostki - Wyjątek Pascala wewnątrz callbacku jest tam łapany, przechowywany i zamieniany w zwrot 0, co każe DLL się zatrzymać; przechowana wiadomość staje się
Info.Diagnostic
Dwa z tych szczegółów mają znaczenie, gdy stroisz wyjście. Jednostką jest linia, nie słowo: każda linia bierze jeden slot MaxWords, Info.AcceptedWordCount i Info.DroppedWordCount liczą linie, a trafienie w wyszukiwarce podświetla cały box linii. I MinimumConfidence jest porównywane ze średnią pewnością znaków linii, więc jeden rozmazany znak wśród dwudziestu czystych rzadko topi linię. Podniesienie progu do 0,7 albo 0,8 gubi całe linie, nigdy pojedyncze znaki. Pusta strona kończy się sukcesem z zerem linii, a każda porażka wyrzuca wyniki częściowe, więc wielostronicowe zatwierdzenie zostaje all-or-nothing
Jeden silnik, jedna kopia modeli, jeden wołający naraz
Każdy silnik DLL RapidOCR posiada dokładnie jedną instancję modeli przez całe swoje życie, a wywołania Recognize na tym silniku są szeregowane sekcją krytyczną. To trzymanie referencji IHPDFOCREngine utrzymuje modele w pamięci, więc praca wsadowa powinna stworzyć silnik raz i używać go ponownie przy każdym dokumencie
procedure OcrBatch(const Files: TStrings; const OutputDir: string);
var
  Models: THPDFRapidOCRDLLOptions;
  Engine: IHPDFOCREngine;
  Doc: THotPDF;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
  I: Integer;
begin
  Models := THPDFRapidOCRDLLOptions.ForLanguage('ru-RU');
  Models.UseAngleClassifier := False;    // proste skany: bez modelu klasyfikatora
  Models.Threads := 4;                   // 1..64, przycinane do aktywnych procesorów
  Models.TimeoutMilliseconds := 120000;  // na wywołanie Recognize, kooperatywnie
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Options := THPDFOCRTextLayerOptions.Default;
  for I := 0 to Files.Count - 1 do
  begin
    Doc := THotPDF.Create(nil);
    try
      Doc.AutoLaunch := False;
      if (Doc.LoadFromFile(Files[I]) > 0) and
        Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
        Doc.SaveLoadedDocument(IncludeTrailingPathDelimiter(OutputDir) +
          ExtractFileName(Files[I]))
      else
        Writeln(Files[I], ': ', string(Info.Diagnostic));
    finally
      Doc.Free;
    end;
  end;
end;  // ostatnia referencja zwolniona: modele zniszczone, potem DLL wyładowana
Threads ustawia jednocześnie licznik wątków intra-op i inter-op każdej sesji ONNX w silniku, a DLL przycina go do liczby aktywnych procesorów. Dwa wątki dzielące jeden silnik nigdy nie puszczają inferencji równolegle; drugi czeka. To czekanie nie jest ślepym EnterCriticalSection. Adapter próbuje locka przez TryEnterCriticalSection, śpi 25 ms między próbami i przy każdej sprawdza token anulowania oraz deadline, więc żądanie w kolejce nadal da się anulować
Zegar deadline'u startuje z wejściem w Recognize, przed wzięciem locka. Czas w kolejce za inną stroną liczy się do TimeoutMilliseconds. Z czterema wątkami roboczymi na jednym silniku i deadline'em 60 sekund czwarta strona może wypaść na timeout, nie docierając nigdy do modelu. Daj zamiast tego każdemu workerowi własny silnik. Kosztuje jedną kopię modeli w pamięci na silnik, a ta pamięć kupuje przewidywalne timeouty i realną równoległość; dzielenie jednego silnika ma sens tylko, gdy żądania są tak rzadkie, że prawie nigdy się nie kolejkują
Dlaczego natywnego wywołania OCR nie da się zabić w środku inferencji?
Natywnego wywołania RapidOCR nie da się zabić w środku inferencji, bo biegnie ono na Twoim wątku, w Twoim procesie, w środku sesji ONNX Runtime, która nie ma API przerwania dla działającego Run. Anulowanie w adapterze DLL jest kooperatywne. DLL woła callback przerwania przed i po detekcji, po sklasyfikowaniu każdego wycinka i po każdej rozpoznanej linii, i zatrzymuje się na pierwszym punkcie kontrolnym, gdzie callback zwróci 0. Pojedynczy Run, który już wystartował, kończy się najpierw
Siłowe opcje są gorsze niż czekanie. TerminateThread zostawiłby lock sterty CRT, pulę wątków ONNX Runtime i stan OpenCV w tym, w czym akurat były. Wywołanie FreeLibrary, gdy wywołanie wciąż się wykonuje, odmapowuje kod siedzący na stacku. Niczego z tego nie da się uczynić bezpiecznym, więc adapter nigdy nie próbuje. Przekroczony deadline wraca jako otlsEngineError z diagnostyką timeoutu; anulowany token wraca jako otlsCancelled:
// Token tworzy wołający i dzieli go z wątkiem UI,
// który woła Token.Cancel, gdy użytkownik naciśnie Stop
function OcrWithStop(Doc: THotPDF; const Engine: IHPDFOCREngine;
  Token: THPDFCancellationToken): Boolean;
var
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Options := THPDFOCRTextLayerOptions.Default;
  Options.CancellationToken := Token;
  Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
  if not Result then
    case Info.Status of
      otlsCancelled:
        // zatrzymano na następnym etapie albo punkcie kontrolnym linii; dokument bez zmian
        Writeln('Cancelled');
      otlsEngineError:
        // obejmuje kooperatywne przekroczenie deadline'u i natywne diagnostyki
        Writeln('Engine: ', string(Info.Diagnostic));
      otlsBudgetExceeded:
        // osiągnięto limit strony, pikseli, słów albo treści w Options
        Writeln('Budget: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
To jest prawdziwy kompromis między adapterami procesowymi a DLL w procesie, i żadna ze stron nie wygrywa każdego wiersza:
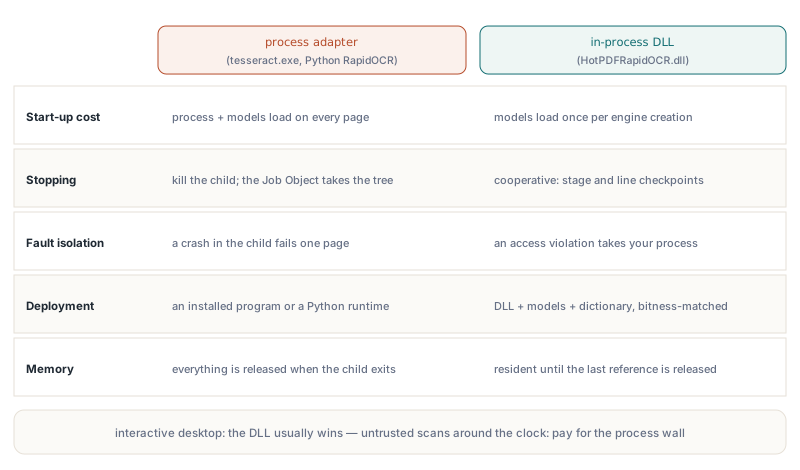
- Koszt startu: adaptery Tesseract i Python RapidOCR odpalają proces i ładują modele przy każdej stronie; DLL ładuje modele raz na silnik
- Zatrzymywanie: proces potomny da się zabić wprost, a pythonowy worker biegnie wewnątrz Job Object z kill-on-close, więc całe jego drzewo procesów idzie z nim; DLL zatrzymuje się na punktach kontrolnych etapów i linii
- Izolacja awarii: crash w
tesseract.exegubi jedną stronę; access violation wewnątrz DLL zabiera Twój proces ze sobą - Deployment: adaptery procesowe wymagają zainstalowanego programu albo środowiska Python; DLL potrzebuje samej siebie, swoich modeli i słownika, dopasowanych do bitowości aplikacji
- Pamięć: adapter procesowy zwalnia wszystko, gdy potomek wychodzi; silnik DLL trzyma modele rezydentne, dopóki ostatnia referencja interfejsu nie zniknie
Wybierz DLL dla interaktywnej aplikacji desktopowej, która OCR-uje stronę po stronie i potrzebuje responsywnego przycisku Stop wracającego w ciągu jednego etapu inferencji. Dla serwera połykającego niezaufane skany o każdej porze zapłać koszt startu na stronę i trzymaj granicę procesu; zmyślony obraz, który kładzie rozpoznawacz, powinien kosztować jedną stronę — i przy procesie potomnym kosztuje
Budowanie HotPDFRapidOCR.dll i wybór modeli
HotPDFRapidOCR.dll buduje się ze źródeł C++ w Native/RapidOCR przez MSVC, C++17, Windows SDK i CMake 3.20 lub nowszy. Helper tools/Build-HotPDFRapidOCR.ps1 bierze katalogi źródeł natywnych, ONNX Runtime i OpenCV plus -Platform Win32 albo Win64 i zapisuje wynik do Lib/Native/RapidOCR/<Platform>/. Buduj obie, jeśli wysyłasz obie. 32-bitowa aplikacja Delphi nie załaduje 64-bitowej DLL, a biblioteki statyczne, które prowizjonujesz, muszą pasować i do architektury docelowej, i do trybu CRT
Modele mają własne reguły kompatybilności. Detektor to DB text detector. Rozpoznawacz przyjmuje modele CTC w układzie NCHW o stałej wysokości wejścia 32 albo 48 i używa 48, gdy model deklaruje wysokość dynamiczną. Format modelu musi być taki, który statycznie linkowany ONNX Runtime rozumie; nowsze eksporty jak PP-OCRv5 mogą wymagać nowszego runtime'u i nieczytelny model wywala się przy inicjalizacji z diagnostyką. tools/Install-RapidOCRModels.ps1 instaluje pakiety PP-OCRv3 i PP-OCRv4 zweryfikowane względem przypiętych hashy SHA256, ze współdzielonym detektorem i klasyfikatorem pod nazwami plików, których oczekuje Default. Zostań przy tych pakietach, chyba że kontrolujesz też build runtime'u
Słownik musi być UTF-8 bez BOM, dokładnie w kolejności znaków modelu, a liczba jego wpisów musi pasować do klas wyjścia modelu. Końce linii CRLF są w porządku. Gdy model osadza własną listę znaków w metadanych, inicjalizacja modelu porównuje każdy wpis i jego pozycję z plikiem słownika, więc słownik, który ma jedynie właściwą długość, i tak wywali. DLL nigdy nie pobiera brakującego modelu
HotPDF pakuje natywny adapter RapidOCR razem z adapterami OCR opartymi o procesy, rendererem stron, który je karmi, i pisarzem niewidocznej warstwy tekstu Unicode, wszystko wewnątrz jednego natywnego komponentu VCL dla Delphi i C++Builder. Dla oprogramowania do akwizycji i archiwizacji, które musi produkować przeszukiwalny PDF na maszynach bez zainstalowanego Pythona, komponent HotPDF Delphi PDF zostawia do wdrożenia tylko DLL i jej pliki modeli