Faktura po rosyjsku przepuszczona przez rozpoznawacz, który ładuje model cyrylicy, a wciąż czyta chiński słownik znaków, wraca jako rzędy idealnie poprawnych znaków Han. Każda linia to poprawne UTF-8, każda trafia do przeszukiwalnej warstwy tekstowej, a wyszukanie dowolnego słowa z wydruku nie znajduje nic. Model zrobił swoją robotę. Rozpoznawacz CTC nigdy nie wypuszcza znaków, tylko numery klas, a plik słownika jest jedyną rzeczą, która mapuje klasę 1 204 na glif
Obok czają się trzy powiązane awarie, których pokaz w piśmie łacińskim nie ujawni: każda linia traci ostatni znak, tekst angielski przychodzi bez odstępów między słowami, a ramki arabskie wracają w kolejności od lewej do prawej. Każda z nich wywodzi się z reguły słownika, granicy pętli albo porządku sortowania, które łatwo ustawić prawie dobrze. Wszystkie cztery zaczynają się w tym samym miejscu: w kroku, który zamienia tag języka w model i słownik
Presety językowe RapidOCR w HotPDF: jeden tag, jedna przypięta para
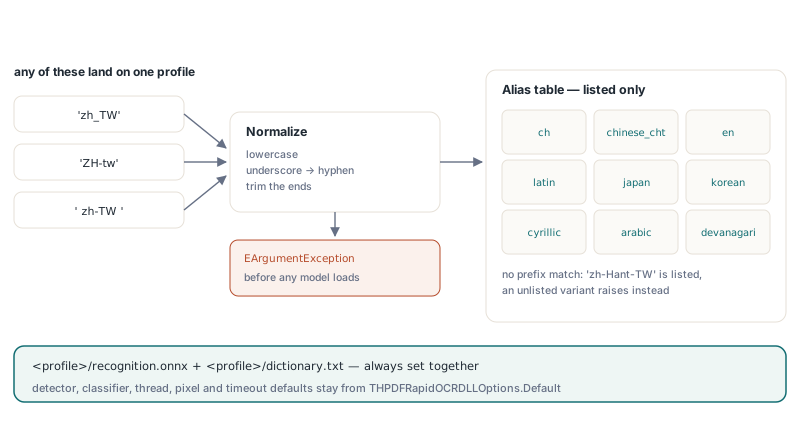
W HotPDF THPDFRapidOCRDLLOptions.ForLanguage zamienia tag języka w opcje wskazujące na <profile>/recognition.onnx i <profile>/dictionary.txt w podkatalogach katalogu modeli. Wszystko inne bierze się z THPDFRapidOCRDLLOptions.Default: współdzielony detektor, opcjonalny klasyfikator kąta, jeden wątek, budżet 16 777 216 pikseli na żądanie i timeout 60 sekund. Tag jest zapisywany małymi literami, podkreślniki zamieniają się w łączniki, a otaczające białe znaki są przycinane, więc 'zh_TW', 'ZH-tw' i ' zh-tw ' wskazują ten sam profil
Dopasowanie działa po jawnej liście aliasów, bez dopasowywania prefiksów. 'zh-Hant-TW' i 'zh-MO' przechodzą, bo są wypisane; 'pt-AO' nie, a ForLanguage podnosi EArgumentException, zanim jakikolwiek plik zostanie otwarty. Ta surowość jest celowa. Reguła prefiksowa po cichu wyśle 'zh-Hant-SG' albo przyszły tag do profilu, który dzieli z nim pierwsze dwie litery, a przy chińskim pierwsze dwie litery nie mówią nic o piśmie
| Profil | Języki | Przykładowe tagi | Kolejność ramek w wierszu |
|---|---|---|---|
ch | Chiński uproszczony i angielski | zh, zh-CN, zh-Hans, chi_sim | Od lewej do prawej |
chinese_cht | Chiński tradycyjny | zh-TW, zh-HK, zh-Hant, chi_tra | Od lewej do prawej |
en | Angielski | en, en-US, en-GB, eng | Od lewej do prawej |
latin | Francuski, niemiecki, hiszpański, portugalski, włoski, niderlandzki, turecki | fr, de, es-419, pt-BR, tr | Od lewej do prawej |
japan | Japoński | ja, ja-JP, jpn | Od lewej do prawej |
korean | Koreański | ko, ko-KR, kor | Od lewej do prawej |
cyrillic | Rosyjski, ukraiński, bułgarski, białoruski | ru, ru-RU, uk, bg | Od lewej do prawej |
arabic | Arabski, perski, urdu | ar, ar-SA, fa, ur | Od prawej do lewej |
devanagari | Hindi, marathi, nepalski | hi, mr, ne | Od lewej do prawej |
Adapter niczego nie pobiera. Pliki modeli prowizjonuje się raz, dołączonym helperem, na przykład tools/Install-RapidOCRModels.ps1 -Destination C:/OCR/models -Language ch,chinese_cht,cyrillic, albo z -Language All dla wszystkich dziewięciu profilów. Helper kładzie współdzielony detektor i klasyfikator pod nazwami plików, których oczekuje Default, a każdy profil we własnym folderze. Tworzenie silnika, granica DLL i wątki to temat artykułu o RapidOCR w procesie przez DLL; gdy pliki są na miejscu, skan w chińskim uproszczonym staje się przeszukiwalny tak
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeChineseScanSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Models: THPDFRapidOCRDLLOptions;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // ch/recognition.onnx + ch/dictionary.txt, współdzielony detektor i klasyfikator
  Models := THPDFRapidOCRDLLOptions.ForLanguage('zh-CN');
  // tu ładują się modele; silnik wykorzystuj ponownie między dokumentami
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Layer := THPDFOCRTextLayerOptions.Default;  // 300 DPI, MinimumConfidence 0.5
    // pusta lista stron = wszystkie strony; SkipPagesWithText zostawia strony z tekstem
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Layer, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines, ', Info.UniqueScalarCount, ' distinct characters');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
Dwie liczby z tego wyjścia trzeba czytać uważnie. Natywny potok raportuje jeden wynik na wykrytą linię tekstu, więc AcceptedWordCount liczy tu linie, a MinimumConfidence jest porównywany ze średnią pewnością znaków całej linii: linia ze średnią 0,45 spada w całości. UniqueScalarCount to liczba odrębnych skalarów Unicode, które warstwa tekstowa musiała zmapować do swojej czcionki i tablicy ToUnicode. Strona chińskiego tekstu głównego powinna spiąć tę liczbę daleko ponad kilkadziesiąt skalarów, których potrzebuje strona łacińska; wynik z rejonu łacińskiego przy chińskim skanie zwykle znaczy, że załadowano zły profil
Dlaczego podmiana samego modelu rozpoznawania produkuje bzdury?
Bo model i słownik to dwie połowy jednej tablicy przeszukiwań, a tylko słownik wie, co znaczą indeksy. Skieruj RecognitionModel na cyrillic/recognition.onnx, gdy CharacterDictionary wciąż wskazuje chiński plik, a model wypluje poprawne indeksy cyrylicy, które stary słownik przetłumaczy na losowe znaki Han. ForLanguage ustawia oba pola zawsze razem. Ręcznie składane opcje powinny trzymać się tej samej reguły: nigdy nie zmieniaj jednego bez drugiego
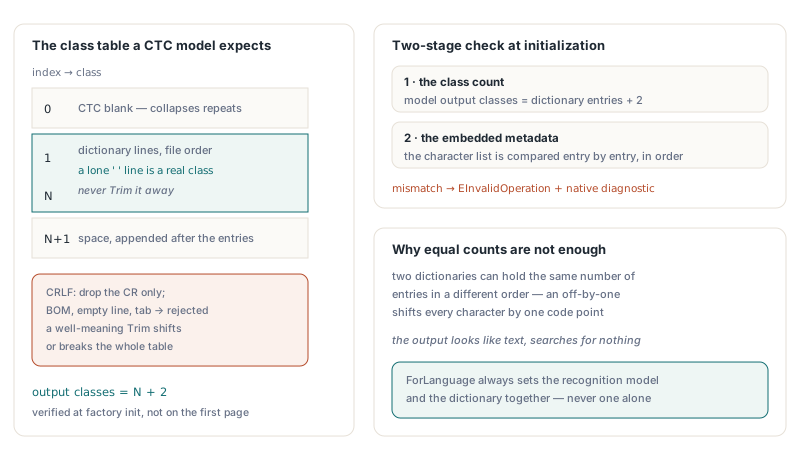
Zwyczajna straż, porównanie rozmiaru słownika z szerokością wyjścia modelu, jest konieczna i wciąż za mało. Dwa słowniki mogą mieć tyle samo wpisów w innej kolejności, a off-by-one przesuwa każdy znak o jedną pozycję. Dlatego DLL RapidOCR w HotPDF sprawdza dwa razy, gdy fabryka inicjalizuje rozpoznawacz. Liczba klas wyjścia modelu musi się równać wpisom słownika plus dwa. Potem, jeśli plik ONNX osadza listę metadanych character, każda linia słownika jest z nią porównywana po kolei. Każda z niezgodności każe HPDFCreateRapidOCRDLLOCREngine podnieść EInvalidOperation z natywną diagnostyką, więc błąd wychodzi na starcie, a nie w archiwum u klienta
To „plus dwa” bierze się z układu klas. Klasa 0 to blank CTC, klasy od 1 do N to linie słownika w kolejności z pliku, a klasa ostatnia to spacja. Niektóre słowniki niosą też własny wpis z samą spacją i ta linia musi przetrwać dokładnie tak, jak jest. Tu Trim stosowany w dobrej wierze wyrządza realne szkody: zamienia wpis spacji w pusty string i przesuwa albo łamie tabelę. DLL obcina końcowy powrót karetki, żeby pliki CRLF się ładowały, i odrzuca znacznik BOM UTF-8, pustą linię albo wpis z tabulatorem albo błądzącym CR
Jeśli utrzymujesz własne słowniki, kontrola przed wdrożeniem w skrypcie budowania albo deploymentu złapie te problemy wcześniej niż silnik. Funkcja poniżej to Twój własny kod, napisany tak, żeby lustrzanie powtarzać reguły spod wyżej
// Twój własny helper, nie API HotPDF: składa tabelę klas, jakiej oczekuje
// rozpoznawacz CTC, i odrzuca wady słownika, które odrzuca DLL
uses
  SysUtils, IOUtils;

function BuildCTCClassTable(const FileName: string): TArray<string>;
var
  Text, Entry: string;
  Lines: TArray<string>;
  I, Last: Integer;
begin
  Text := TEncoding.UTF8.GetString(TFile.ReadAllBytes(FileName));
  if (Text <> '') and (Text[1] = #$FEFF) then
    raise EArgumentException.Create('Dictionary must be UTF-8 without a BOM');
  Lines := Text.Split([#10]);
  Last := High(Lines);
  if (Last >= 0) and (Lines[Last] = '') then
    Dec(Last);                                   // znak nowej linii na końcu pliku
  if Last < 0 then
    raise EArgumentException.Create('Dictionary is empty');
  SetLength(Result, Last + 3);
  Result[0] := '';                               // klasa 0: blank CTC
  for I := 0 to Last do
  begin
    Entry := Lines[I];
    if (Entry <> '') and (Entry[Length(Entry)] = #13) then
      SetLength(Entry, Length(Entry) - 1);       // CRLF: zrzuć tylko CR
    if (Entry = '') or (Pos(#9, Entry) > 0) or (Pos(#13, Entry) > 0) then
      raise EArgumentException.CreateFmt('Invalid dictionary line %d', [I + 1]);
    Result[I + 1] := Entry;                      // nigdy Trim: ' ' to klasa
  end;
  Result[Last + 2] := ' ';                       // klasa finalna: spacja
  // Length(Result) musi się równać liczbie klas wyjścia modelu
end;
Zachłanne dekodowanie CTC i jego trzy pułapki graniczne
Zachłanne dekodowanie CTC wybiera klasę z najwyższym wynikiem w każdym kroku czasowym, zwija kolejne powtórzenia w jeden znak i wyrzuca blank. To blank pozwala naprawdę podwojonej literze przeżyć. Model rozpoznawania czyta linię tekstu jako sekwencję wąskich pionowych plasterków i dla każdego plasterka wypuszcza prawdopodobieństwo każdej klasy. Linia z AA中 może dać sekwencję argmax A A blank A 中 space: pierwsze dwa kroki A zwijają się w jeden, blank oddziela je od następnego A, a wyjście to AA中 z nienaruszoną spacją na końcu. Bez reguły blanka book i bok dekodowałyby się identycznie
Dekoder tak krótki sam zaprasza błędy off-by-one, a każdy błąd produkuje własny, rozpoznawalny objaw. Zatrzymaj wewnętrzną pętlę argmax jedną klasę za wcześnie i klasa spacji nigdy nie wygra, więc każda linia angielska czy łacińska wraca jako jedno długie słowo, a wyszukiwanie fraz przestaje działać. Zatrzymaj zewnętrzną pętlę o krok czasowy za wcześnie i ostatni znak każdej linii znika, co przy dwuznakowej etykiecie to połowa tekstu. Zapomnij pozwolić blankowi zresetować straż powtórzeń i podwojone znaki się zwijają: ll w hello albo reduplikowane 谢谢. Jeśli piszesz dekoder do własnego potoku, te trzy przypadki tworzą zwięzły zestaw testowy. Dekoder HotPDF obejmuje ostatnią klasę i ostatni krok, trzyma powtórzenia oddzielone blankiem i odrzuca wyniki, które nie są skończone albo wypadają poza zakres od 0 do 1, oraz każdą liczbę klas niezgodną ze słownikiem
// Ilustracja dla własnego potoku, nie API HotPDF: zachłanne
// dekodowanie CTC z poprawnymi granicami. Scores trzyma Steps * Classes
// prawdopodobieństw, po jednym wierszu na krok czasowy
function GreedyCTCDecode(const Scores: array of Single;
  Steps, Classes: Integer; const Characters: array of string): string;
var
  Step, C, Best, Previous: Integer;
  BestScore: Single;
begin
  if (Classes < 3) or (Length(Characters) <> Classes) or
    (Length(Scores) <> Steps * Classes) then
    raise EArgumentException.Create('Model output does not match the dictionary');
  Result := '';
  Previous := 0;                            // klasa 0 to blank CTC
  for Step := 0 to Steps - 1 do             // uwzględnij ostatni krok czasowy
  begin
    Best := 0;
    BestScore := Scores[Step * Classes];
    for C := 1 to Classes - 1 do            // uwzględnij ostatnią klasę (spację)
      if Scores[Step * Classes + C] > BestScore then
      begin
        Best := C;
        BestScore := Scores[Step * Classes + C];
      end;
    if (Best <> 0) and (Best <> Previous) then
      Result := Result + Characters[Best];
    Previous := Best;                       // blank resetuje straż powtórzeń
  end;
end;
Beam search z modelem językowym potrafi rozstrzygnąć niektóre niejednoznaczne plasterki, na których wykłada się dekodowanie zachłanne, za realny koszt w szybkości i w drugim zestawie plików do wersjonowania. Przy drukowanych dokumentach renderowanych w 300 DPI zachłanne dekodowanie to właściwy wybór domyślny, a dekoder to złe miejsce na rekompensowanie tego, czego model nie widzi. To samo dotyczy tabel podstawiania znaków. Jeśli model czyta literę z diakrytykiem jako jej podstawową formę, łatanie wyjścia tabelą zastąpień naprawia jeden język i łamie drugi. Zły znak w przeszukiwalnej warstwie jest gorszy niż brakujący, bo wyszukiwarka znajduje zły dokument zamiast żadnego, więc rozpoznany tekst trafia do PDF dokładnie tak, jak wyprodukował go model
Jak porządkowane są linie tekstu dla arabskiego od prawej do lewej?
DLL sortuje wykryte ramki tekstu od góry do dołu, grupuje ramki w jeden wiersz, gdy nakładają się pionowo na co najmniej połowę wysokości niższej z nich, i porządkuje każdy wiersz od lewej do prawej, albo od prawej do lewej, gdy ustawiono RightToLeft. Znaki wewnątrz rozpoznanej linii nigdy nie są odwracane. Grupowanie w wiersze ma znaczenie, bo detektory często rozcinają jedną wizualną linię na kilka ramek — etykietę i wartość rozdzielone szeroką przerwą — a naiwne sortowanie po górnej współrzędnej przeplatałoby je z następną linią za każdym razem, gdy górne krawędzie różnią się o piksel albo dwa
Profil arabski to jedyny, przy którym ForLanguage ustawia RightToLeft := True, co każe DLL porządkować każdy wiersz po prawych krawędziach ramek, startując od prawego marginesu. To cały efekt. Tekst, który model zwraca dla linii, jest już w logicznym porządku Unicode — w kolejności, w jakiej czyta go i wpisuje arabski czytelnik — i to jest też porządek, jakiego oczekują ekstrakcja tekstu z PDF i wyszukiwanie. Odwrócenie stringa po to, żeby w debugerze Delphi „wyglądał dobrze”, połamałoby wyszukiwanie, kopiowanie, wklejanie i czytniki ekranu. Wyświetlanie dwukierunkowe i kształtowanie glifów to domena przeglądarki PDF
Jeden silnik obsługuje jeden profil językowy i nie ma automatycznej detekcji pisma. Dokument mieszający pisma potrzebuje jednego silnika na profil, każdy aplikowany do swoich stron. ApplyLoadedOCRTextLayer bierze jawną listę stron i zatwierdza każde wywołanie jako osobną transakcję, więc porażka na stronach arabskich wycofuje to wywołanie, nie dotykając już zapisanej warstwy chińskiej
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

function CreateRapidEngine(const Tag: string): IHPDFOCREngine;
var
  Models: THPDFRapidOCRDLLOptions;
begin
  // podnosi EArgumentException dla taga spoza listy, zanim jakikolwiek model się załaduje
  Models := THPDFRapidOCRDLLOptions.ForLanguage(Tag);
  Models.MaxPixels := 33554432;          // miejsce na strony A3 przy 300 DPI
  Result := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
end;

procedure OCRMixedArchive(Doc: THotPDF);
var
  Chinese, Arabic: IHPDFOCREngine;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Chinese := CreateRapidEngine('zh-TW');  // profil chinese_cht
  Arabic := CreateRapidEngine('ar-SA');   // profil arabic, RightToLeft = True
  Layer := THPDFOCRTextLayerOptions.Default;
  if not Doc.ApplyLoadedOCRTextLayer([0, 1, 2], Chinese, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
  if not Doc.ApplyLoadedOCRTextLayer([3], Arabic, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
end;
Linia z MaxPixels nie jest tam przypadkiem. Domyślny budżet 16 777 216 pikseli na żądanie pokrywa A4 i US Letter w 300 DPI z zapasem. Arkusz A3 przy 300 DPI wychodzi około 3508 na 4961 pikseli, z grubsza 17,4 miliona, więc takie żądanie zostaje odmówione, a Info.Diagnostic zgłasza nieprawidłowe żądanie albo budżet pikseli. Podnieś MaxPixels do sufitu 67 108 864 albo obniż THPDFOCRTextLayerOptions.DPI dla dużych formatów. Kolejność od prawej do lewej idzie przez eksport DLL HPDFRapidOCRSetReadingDirection, który adapter wyszukuje tylko przy ustawionym RightToLeft; build DLL bez tego eksportu nadal obsługuje profile od lewej do prawej, a próba stworzenia silnika arabskiego podnosi wtedy EArgumentException z nazwą brakującego eksportu
Przypięte pakiety modeli i co musi przejść własna para
DLL RapidOCR w HotPDF linkuje statycznie zbudowany ONNX Runtime, więc czyta wersje formatu plików ONNX, które ten runtime rozumie, i nic nowszego. Nowsze eksporty modeli mogą celować w świeższy format; taki plik zostaje odrzucony przy tworzeniu silnika z natywną diagnostyką. To powiązanie jest powodem, dla którego każdy pakiet językowy wskazuje jeden konkretny rozpoznawacz i słownik, które ładują się i przechodzą sprawdzian klas pod dołączonym runtime'em, i dla którego pakiety nigdy nie są „najnowsze”
Install-RapidOCRModels.ps1 egzekwuje to powiązanie na dysku. Każdy plik w manifeście niesie hash SHA256. Istniejący plik o innym hashu zatrzymuje instalację i zostaje na miejscu do przeniesienia albo usunięcia, a każde pobranie zapisywane jest pod nazwą tymczasową i rusza na pozycję dopiero po zgrywającym się hashu. To blokuje cichą wersję problemu ze słownikiem: ktoś ręcznie kopiuje nowszy recognition.onnx do folderu profilu, liczba klas zbiegiem okoliczności się zgadza, a pierwszym sygnałem kłopotów jest klient mówiący, że wyszukiwanie nie znajduje słów, które widać gołym okiem. Jeśli instalujesz z -SkipClassifier, ustaw UseAngleClassifier := False w opcjach, bo Default oczekuje pliku klasyfikatora, a tworzenie silnika sprawdza, czy on istnieje
Rozpoznawacz sprawdza też kształt wejścia modelu w czasie ładowania. Akceptuje wejście float NCHW o stałej wysokości 32 albo 48 pikseli lub wysokość dynamiczną, którą puszcza jako 48. Model wyeksportowany z inną stałą wysokością wywala tworzenie silnika komunikatem „Unsupported recognition model input or output shape”
Dla pisma, którego żaden z dziewięciu profilów nie pokrywa, RecognitionModel i CharacterDictionary mogą wskazywać Twoje własne pliki, i każdy z powyższych sprawdzianów nadal obowiązuje. Niedopasowana para wywali się przy tworzeniu silnika, w Twoim przebiegu testowym. Dla stron, gdzie żaden profil RapidOCR nie pasuje, adapter Tesseract do przeszukiwalnego PDF wpina się w to samo wywołanie ApplyLoadedOCRTextLayer, a przy formularzach ASCII drukowanych maszynowo wbudowany silnik OCR z dopasowaniem szablonów nie potrzebuje wcale plików modeli
Presety językowe, natywny adapter RapidOCR i warstwa tekstowa OCR są wszystkie w składzie HotPDF Delphi PDF Component dla projektów Delphi, C++Builder i FPC/Lazarus na Windows