Pole znajdź w przeglądarce podświetla "Acme Corp" na stronie 2 faktury, a wyszukiwanie bajtowe po zdekompresowanym strumieniu strony dla tych samych dziewięciu znaków wraca puste. Dla samego pierwszego słowa strumień może trzymać coś w rodzaju <0024004600500048> Tj: dwubajtowe kody glifów w osadzonym foncie podzbioru, z luką między dwoma słowami wyprodukowaną przez offset pozycjonujący zamiast znaku spacji. Zamiana tej nazwy znaczy: zdekodować te kody na Unicode, dopasować tam, wrócić do dokładnych bajtów, które wyprodukowały trafienie, i zapisać nowe kody, które ten sam font rozumie. Gdy podzbiór nigdy nie zawierał glifu, którego potrzebuje nowy tekst, nie ma kodów do zapisania
Żądania stojące za tym to zwykła konserwacja dokumentów. Firma zmienia nazwę, a trzy tysiące zarchiwizowanych faktur wciąż niosą starą. Szablon kontraktu wyszedł z zeszłoroczną datą wygaśnięcia. Wycofany numer części musi stać się swoim następcą w każdej karcie katalogowej. W edytorze tekstu każde z tych to trzydzieści sekund; w PDF każde wpada na to, jak strony są faktycznie przechowywane
Co strona PDF przechowuje zamiast tekstu
Strona PDF trzyma pozycjonowane glify, nie edytowalny tekst. Według ISO 32000-1 §9.4 strumień zawartości steruje operatorami pokazywania tekstu jak Tj i TJ, które malują sekwencje kodów znaków na pozycjach ustawionych przez macierz tekstu. Te kody są indeksami do dowolnego kodowania, które deklaruje bieżący font. Droga z powrotem do czytelnych znaków może iść przez CMap /ToUnicode (§9.10.3), /Encoding z tablicą /Differences albo łańcuch mapowań CID dla fontów Type0. Nie ma obiektu akapitu i przepływu tekstu, a nic nie zobowiązuje producenta do przechowywania jednego widocznego słowa jako jednego stringa: [(Ac) -12 (me)] TJ to zupełnie zwyczajny sposób kernowania słowa
Zamiana dokłada drugie wymaganie ponad samo dekodowanie. Ekstraktor tekstu może wyrzucić pozycje bajtowe, gdy ma już Unicode. Zamieniacz ich potrzebuje, bo musi wiedzieć, które bajty którego operandu łańcuchowego wyprodukowały każdy glif, żeby przepisać dokładnie ten zakres i nie ruszać niczego więcej. Dlatego zwykły StringReplace po bajtach strumienia to złe narzędzie nawet na plikach, które z przypadku używają kodowania WinAnsi. Nie ma pojęcia, który ( należy do stringa, a który Tf wybiera font, który nadaje tym bajtom znaczenie
Przeszukiwanie zdekodowanej sekwencji glifów
HotPDF Delphi Component przeszukuje wczytany dokument przez SearchLoadedPageText i SearchLoadedDocumentText, które dopasowują igłę do zdekodowanej sekwencji glifów Unicode każdej strony, nigdy do surowych bajtów strumienia. Trafienie jest więc trafieniem niezależnie od tego, jak font je zakodował. Przy dekodowaniu każdy glif zapisuje operand łańcuchowy, element tablicy TJ i przesunięcie bajtowe, z których przyszedł — na tym polega później krok zamiany. Ten sam interpreter glifów napędza API opisane w artykule o ekstrakcji tekstu z wczytanego PDF w Delphi; wyszukiwanie po prostu zachowuje pozycje źródłowe, które ekstrakcja wyrzuca
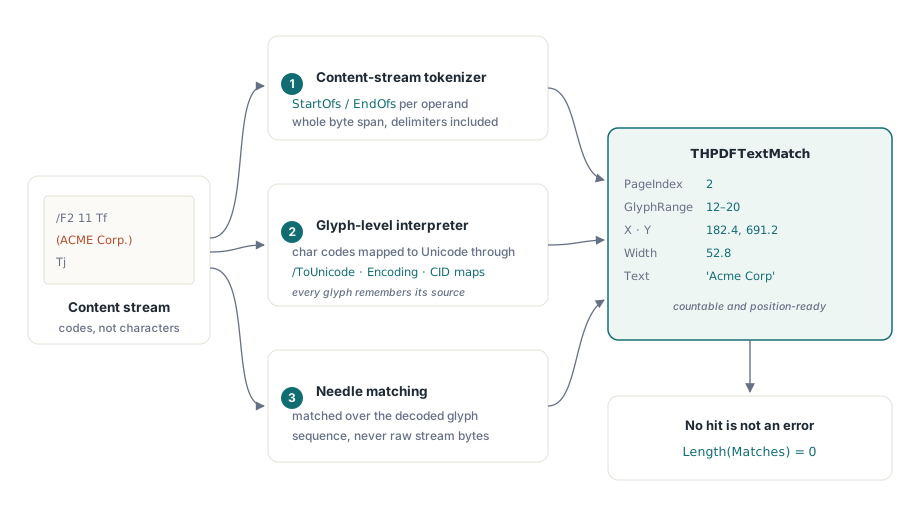
Każde trafienie wraca jako rekord THPDFTextMatch: PageIndex, domknięty zakres glifów w GlyphStart i GlyphEnd, początek w przestrzeni użytkownika w X i Y, Width trafienia, źródłowe TokenIndex i ItemIndex oraz dopasowany Text. PageIndex liczy od zera. Igła, która nie występuje, daje pustą tablicę i wynik True, więc kod wołający nie potrzebuje specjalnego przypadku na "nic nie znaleziono"
var
  Pdf: THotPDF;
  Matches: THPDFTextMatchArray;
  I: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoices-2025.pdf') > 0 then
      if Pdf.SearchLoadedDocumentText('Acme Corp', False, Matches) then
        for I := 0 to High(Matches) do
          WriteLn(Format('page %d at (%.1f, %.1f), width %.1f: "%s"',
            [Matches[I].PageIndex + 1, Matches[I].X, Matches[I].Y,
             Matches[I].Width, Matches[I].Text]));
  finally
    Pdf.Free;
  end;
end;
To, czy ta pętla coś wypisze, zależy przed wszystkim innym od spacji. Tekst wyszukiwania jest budowany z glifów, które strona faktycznie maluje, po jednym znaku na glif, a offset TJ, który wizualnie rozdziela dwa słowa, jest liczbą w tablicy, a nie glifem. Producent, który ustawia luki między słowami offsetami zamiast znaku spacji, da "AcmeCorp" w sekwencji glifów, a igła "Acme Corp" się nie dopasuje. Gdy widoczna fraza uparcie nie chce się dopasować, szukaj najpierw jej najdłuższego pojedynczego słowa i spójrz na Text tego, co wróci
Wielkość liter to druga rzecz do sprawdzenia. Przy CaseSensitive ustawionym na False buildy od Delphi XE2 wzwyż porównują znaki przez Unicode'owe proste mapowanie na małe litery, niezależne od locale, więc É pasuje do é, a greckie albo cyryliczne wersaliki do swoich minuskuł. Buildy starszymi kompilatorami foldują tylko A–Z. Mapowanie to jeden znak na jeden znak, co trzyma każdą pozycję igły wyrównaną do dokładnie jednego glifu; konsekwencja: ß nie pasuje do SS. Dla flowów UI całych słów SearchLoadedPageTextWholeWord wyrzuca trafienia siedzące wewnątrz dłuższego słowa, a GetLoadedSearchHitRect zamienia trafienie w pojedynczy prostokąt do rysowania podświetlenia
Wyszukiwanie i zamiana działają oba na własnych strumieniach /Contents strony. Tekst malowany wewnątrz Form XObject — tam gdzie wiele narzędzi wkłada stemplowane nagłówki i stopki — mieszka w osobnym strumieniu, który strona wywołuje przez Do, i jest poza obiema operacjami
Przepisywanie dopasowanych bajtów przez ReplaceLoadedDocumentText
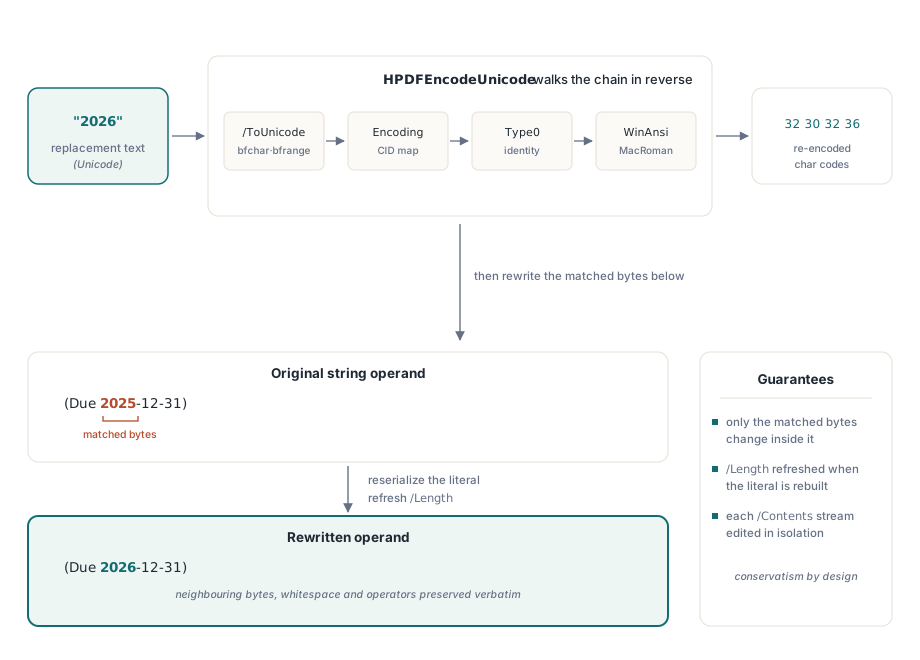
ReplaceLoadedPageText i ReplaceLoadedDocumentText przepisują każde wystąpienie igły, puszczając dekodowanie fontu w tył. Każdy znak zamiennika jest wyszukiwany tym samym łańcuchem, którego używa dekoder, tylko od końca: wpisy bfchar i bfrange w /ToUnicode, mapowania CID dla fontów Type0, mapowania tożsamościowe i predefiniowane tablice WinAnsi oraz MacRoman. Powstałe kody znaków są zapisywane z powrotem jako literał łańcuchowy albo string szesnastkowy, gdy jakikolwiek bajt wypada poza drukowalnym ASCII, według tych samych reguł ucieczki, które czyta parser strumienia zawartości
Zmieniają się tylko bajty pokryte dopasowaniem. Niedopasowane bajty w tym samym operandzie, biel między tokenami, komentarze i każdy otaczający operator przechodzą nietknięte. Zamiana bca wewnątrz abcabc daje a + zamiennik + bc. Zamiennik może być krótszy albo dłuższy od igły, a każdy strumień w tablicy /Contents strony jest przetwarzany osobno, więc strona zostaje dobrze uformowana. Gdy dopasowanie rozciąga się na kilka operandów łańcuchowych, jak Hello zapisane jako [(He) -20 (llo)] TJ, zamiennik jest zapisywany do operandu, w którym dopasowanie się zaczyna, a dopasowane bajty są usuwane z operandów następnych
var
  Pdf: THotPDF;
  Rewrites: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('contract-draft.pdf') > 0 then
    begin
      if Pdf.ReplaceLoadedDocumentText('2025-12-31', '2026-12-31',
        True, Rewrites) then
        WriteLn(Format('%d operand rewrites', [Rewrites]));
      Pdf.SaveLoadedDocument('contract-final.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
Strona nie jest składana na nowo. PDF nie ma przepływu tekstu, więc zamiennik szerszy od oryginału po prostu bierze więcej miejsca w poziomie i może wpaść w to, co namalowano po jego prawej; pozycja następnego glifu była ustalona przez producenta i się nie rusza. Daty, stringi wersji, numery części i poprawki pisowni podobnej długości to robota, dla której ta metoda powstała. Przeredagowanie akapitu wymagałoby składania wszystkiego dalej w dół na nowo, więc ta zmiana należy do dokumentu źródłowego
Dlaczego podzbiór czcionki nie weźmie znaków, których nigdy nie zawierał?
Znak zamiennika, którego osadzony podzbiór nigdy nie zawierał, nie ma kodu znaku, do którego można wrócić. Gdy producent robi podzbiór fontu, jego CMap /ToUnicode i kodowanie pokrywają wyłącznie glify, których oryginalny dokument użył, a kontury glifów wszystkiego innego po prostu nie ma w pliku. Jeśli dokument nigdy nie wydrukował wersalnego E w tym foncie, żadna sekwencja bajtów go nie wybierze. To ograniczenie siedzi w pliku, nie w narzędziu robiącym zamianę
ReplaceLoadedDocumentText traktuje niekodowalny zamiennik zachowawczo: jeśli jakikolwiek pojedynczy znak nie da się zakodować z powrotem, całe to wystąpienie jest pomijane. Nie ma wyjątku ani półzamienionego stringa, a oryginalny tekst pozostaje czytelny. W przykładzie z datą powyżej cyfra 6 musi istnieć gdziekolwiek w tym samym foncie, żeby przepisanie się udało. Załóżmy, że font drukował tylko "2025" i kilka sum zamówień bez szóstki: daty zostają po staremu
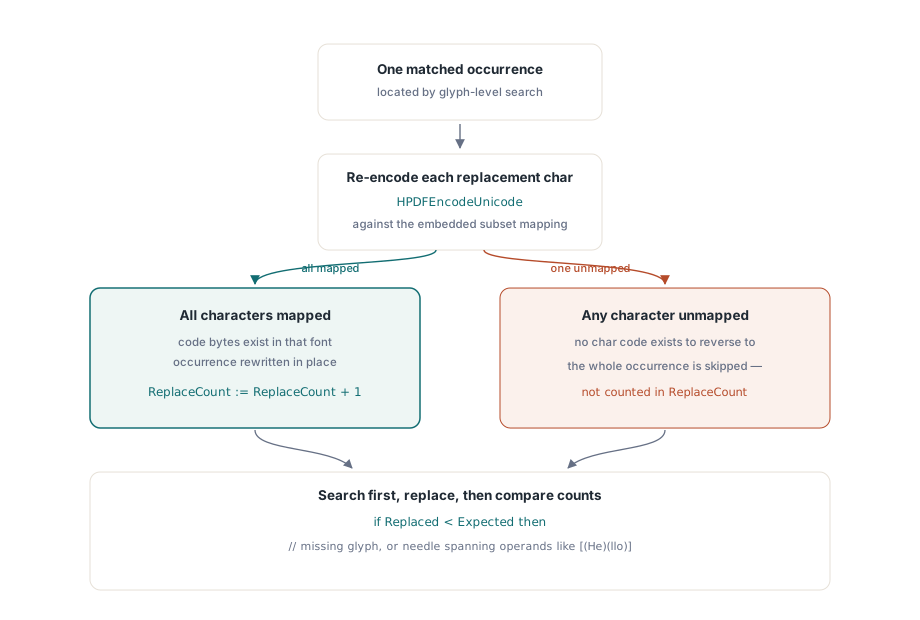
ReplaceCount raportuje przepisania operandów, a dopasowanie rozciągnięte na kilka operandów może stanowić więcej niż jedno przepisanie. Licznik niższy od liczby trafień nadal znaczy, że coś zostało pominięte, ale dokładną odpowiedź daje ponowne wyszukanie po zamianie. Cokolwiek drugie wyszukiwanie znajdzie, to to, co zostało — ze stroną i pozycją w pakiecie
procedure ReplaceAndAudit(Pdf: THotPDF; const OldText, NewText: UnicodeString);
var
  Before, After: THPDFTextMatchArray;
  Rewrites, I: Integer;
begin
  // Ponowne wyszukiwanie działa tylko, gdy NewText samo nie zawiera OldText
  Pdf.SearchLoadedDocumentText(OldText, True, Before);
  Pdf.ReplaceLoadedDocumentText(OldText, NewText, True, Rewrites);
  Pdf.SearchLoadedDocumentText(OldText, True, After);
  WriteLn(Format('%d found, %d operand rewrites, %d left',
    [Length(Before), Rewrites, Length(After)]));
  for I := 0 to High(After) do
    WriteLn(Format('  left on page %d at (%.1f, %.1f)',
      [After[I].PageIndex + 1, After[I].X, After[I].Y]));
end;
Gdy podzbiór jest za krótki: podgląd i zastosowanie z nowym fontem
Dla wystąpień, których metoda bajtowa nie umie zakodować, PreviewLoadedPageTextReplacement i ApplyLoadedPageTextReplacement idą inną drogą: usuwają dopasowane glify i rysują zamiennik na miejscu fontem, który wybierzesz, w oryginalnym rozmiarze i na oryginalnej linii bazowej. Domyślne THPDFLoadedTextReplacementOptions bierze Arial w rozmiarze fontu dopasowanego tekstu, wymiaruje pudełko na szerokość dopasowanego tekstu i trzyma Atomic włączonym. Pojedyncze odrzucone dopasowanie na stronie cofa wtedy pozostałe. Podgląd zwraca plan z jednym wynikiem na dopasowanie, każdy z Status i, przy odrzuceniu, z Reason
var
  Opts: THPDFLoadedTextReplacementOptions;
  Plan, Applied: THPDFLoadedTextReplacementPlan;
  I: Integer;
begin
  // Pdf to wczytany THotPDF; PageIndex to strona liczona od zera, którą oflagował audyt
  Opts := THPDFLoadedTextReplacementOptions.Default;
  Opts.Appearance.FontName := 'Arial';
  Opts.Appearance.OverflowPolicy := ltopShrinkToFit;
  Opts.Appearance.MinFontSize := 6;
  if not Pdf.PreviewLoadedPageTextReplacement(PageIndex, 'Acme Corp',
    'Apex Corporation', True, Opts, Plan) then
    for I := 0 to High(Plan.Results) do
      if Plan.Results[I].Status = ltrsRejected then
        WriteLn(Format('match %d at (%.1f, %.1f): %s',
          [I, Plan.Results[I].X, Plan.Results[I].Y, Plan.Results[I].Reason]));
  if (Plan.RejectedCount = 0) and (Plan.ReadyCount > 0) then
  begin
    Pdf.ApplyLoadedPageTextReplacement(Plan, Applied);
    WriteLn(Format('%d of %d matches applied',
      [Applied.AppliedCount, Applied.MatchedCount]));
  end;
end;
Powody odrzucenia warto wypisywać, bo mapują się wprost na geometrię strony. Dopasowanie przechodzące z jednej linii tekstu do następnej jest odrzucane, podobnie tekst pionowy. Przy domyślnej polityce przepełnienia ltopReject zamiennik, który nie mieści się w szerokości dopasowania, też jest odrzucany. ltopShrinkToFit schodzi z rozmiarem w dół ku MinFontSize — dlatego przykład go ustawia dla zamiennika o pięć znaków dłuższego od igły. Zamiennik zawierający znaki, których wybrany font nie umie pokazać, również jest odrzucany
Plan niesie odcisk palca zawartości strony i fontów. Gdy cokolwiek zmieni stronę między podglądem a zastosowaniem, ApplyLoadedPageTextReplacement podnosi EInvalidOpException zamiast pisać do strony, której podgląd nigdy nie widział. Strony z niewyważonymi parami q/Q albo BT/ET i dokumenty zawierające pola podpisów podnoszą EArgumentException; podpisane dokumenty wołają o aktualizacje przyrostowe, żeby podpisana rewizja została nienaruszona
Zamiana bajtowa idzie pierwsza, a ścieżka podmiany fontu biegnie tylko na stronach, gdzie audyt nadal znajduje stary tekst. Bajtowe przepisanie zachowuje oryginalny font, jego metryki i kerning, więc edytowany tekst zgadza się z sąsiadami w linii. Ścieżka podglądu rysuje inną czcionką, a w linii złożonej fontem kondensowanym albo szeryfowym uważny czytelnik zobaczy zmianę. Gdy celem jest zniknięcie tekstu, a nie jego przeredagowanie, prawdziwe usuwanie zawartości to lepsze narzędzie; redakcja i przebudowa wczytanych PDF w Delphi opisuje tę drogę
Co się zmienia w zapisanym pliku
Strumień zawartości edytowany przez ReplaceLoadedPageText jest zapisywany nieskompresowany. Strumień jest dekodowany do edycji, a gdy przebudowane bajty są zapisywane z powrotem, jego wpisy /Filter i /DecodeParms są wyrzucane, a /Length odświeżana. PDF jest poprawny i renderuje się normalnie; kosztem jest większy plik za każdy edytowany strumień. Zadanie seryjne po tysiącach faktur powinno zaplanować ten wzrost albo puścić po tym przebieg kompresji
Ścieżka podglądu i zastosowania zmienia trochę więcej. Aplikowana strona dostaje jeden nowy, nieskompresowany strumień zawartości w miejscu oryginalnego /Contents, plus własną kopię słownika zasobów z dodanym fontem zamiennika. Wszystko inne w dokumencie zostaje w spokoju: nietknięte strumienie zachowują kompresję, istniejące fonty i obrazy nie są przepisywane, a strony bez trafień nigdy nie są otwierane do zapisu. Jak przepisane obiekty lądują w strukturze odsyłaczy przy zapisie, opisuje artykuł o strumieniach obiektów i aktualizacjach przyrostowych w HotPDF
Wyszukiwanie, bajtowa zamiana, podgląd i zastosowanie zamiennika, ekstrakcja i redakcja biegną na tym samym interpreterze strumieni zawartości, od Delphi 5 po bieżące RAD Studio, bez zewnętrznych zależności. Odwołania do metod, opcje zamiany i build próbny są na stronie produktu HotPDF Delphi Component