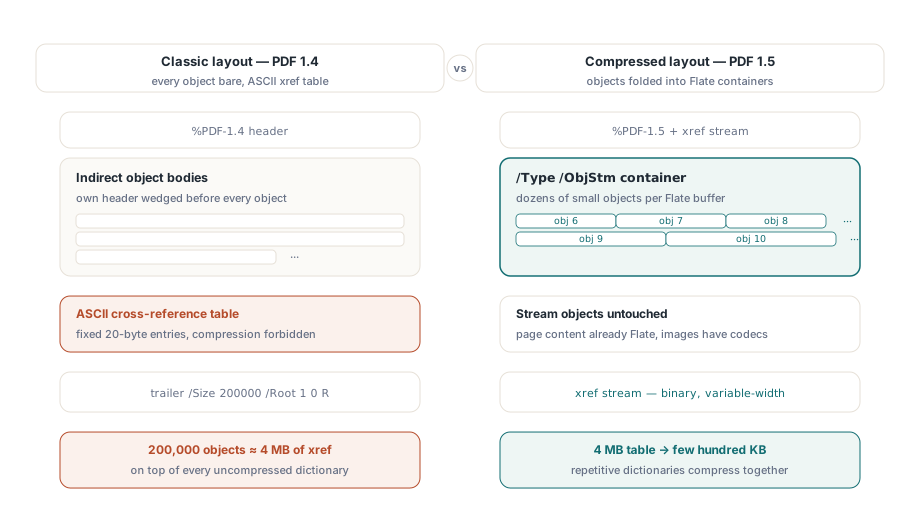
PDF 1.5 wprowadził dwie struktury składowania, których wcześniejszy format pliku nie potrafił wyrazić: strumień obiektów i strumień odsyłaczy. Strumień obiektów to jeden kontener skompresowany metodą Flate, oznaczony /Type /ObjStm, który mieści wiele małych obiektów pośrednich upakowanych jeden za drugim, zamiast rozsypywać je po ciele pliku. Strumień odsyłaczy to tablica wyszukiwania pliku przepisana jako skompresowane dane binarne z polami o zmiennej szerokości, w miejsce tablicy ASCII o stałej szerokości, która zamykała każdy PDF aż do wersji 1.4. Podróżują razem. Gdy obiekty zostaną zwinięte do strumienia, stara tablica tekstowa nie potrafi już ich zaadresować, więc binarny xref musi jej towarzyszyć
Zestaw to z klasycznym układem, a koszt, który to usuwa, staje się łatwy do dostrzeżenia. W pliku PDF 1.4 każdy obiekt pośredni siedzi nieskompresowany za własnym nagłówkiem obj, a tablica na końcu wydaje dokładnie 20 bajtów ASCII na wpis, bez prawa do kompresji. Dokument z 200 000 obiektów niesie mniej więcej 4 MB danych odsyłaczy, zanim narysowany zostanie choćby jeden glif, a na tym piętrzą się wszystkie nieskompresowane ciała słowników. PDF 1.5 atakuje obie liczby naraz: słowniki zwijają się do kontenerów Flate, a tablica o rozmiarze 4 MB kurczy się do kilkuset kilobajtów danych binarnych. ISO 32000-1 definiuje obie struktury w §7.5.7 i §7.5.8
Gdzie faktycznie ląduje oszczędność
Strumienie obiektów dotykają wyłącznie obiektów niebędących strumieniami, więc kompresują strukturę, a nie piksele. Treść stron była kompresowana metodą Flate już przed 1.5, a dane obrazów niosą własne kodeki, i dlatego broszura gęsta od obrazów ledwie drgnie. Pliki, które się zapadają, to te gęste od struktury: AcroForms z tysiącami słowników pól, głębokie drzewa konspektu, elementy struktury oznaczonego PDF. Te obiekty są maleńkie, liczne i niemal identyczne wzajemnie, a właśnie tę powtarzalność wykorzystuje Flate, gdy siedzą w jednym buforze, a nie rozrzucone po ciele pliku z wciśniętymi między nie nagłówkami
Łatwo nie docenić, jak dużo starego pliku stanowi narzut. Archiwum formularzy, które wchłonęło lata edycji, potrafi wydać znacznie ponad połowę swoich bajtów na nagłówki słowników, wypełnienie xref i rewizje, na które żaden czytnik nigdy nie spojrzy. Dwie opisane tu funkcje odzyskują pierwsze dwa z tych kosztów. Trzeci, nagromadzone rewizje, ustępuje dopiero przy zagęszczaniu, gdy plik nie musi już pamiętać własnej historii
W HotPDF włączasz obie przez parę właściwości, a to, jak od siebie zależą, znaczy więcej niż kolejność, w jakiej je zapiszesz:
var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.FileName := 'catalog-2026.pdf';
    Pdf.UseXRefStream := True;      // binarny xref, warunek konieczny dla ObjStm
    Pdf.UseObjectStreams := True;   // pakuj obiekty do /Type /ObjStm
    Pdf.BeginDoc;
    Pdf.CurrentPage.SetFont('Arial', [], 11);
    Pdf.CurrentPage.TextOut(50, 760, 0, 'Compressed structure demo');
    Pdf.EndDoc;                     // emituje kontenery XRefStm + ObjStm
  finally
    Pdf.Free;
  end;
end;
UseObjectStreams wymaga UseXRefStream ustawionego na True. Do skompresowanego obiektu dociera się przez wpis xref typu 2, który zapisuje numer strumienia obiektów plus indeks, a klasyczny 20-bajtowy wiersz tekstowy nie ma gdzie przechować tej pary. Dlatego samo UseObjectStreams nie robi nic widocznego; działającą konfiguracją są obie flagi ustawione przed BeginDoc. Ustaw je po BeginDoc, a HotPDF już zobowiązał się do starszego układu
Dlaczego obie są domyślnie wyłączone
HotPDF zostawia obie właściwości jako False od razu po wyjęciu z pudełka, a powód ujawnia się w integracjach ze starym kodem dalej w łańcuchu. Czytnik rozumiejący wyłącznie PDF 1.4 nie ogłasza, że nie radzi sobie ze skompresowanymi obiektami. Napotyka strumień xref, nie znajduje żadnego ze słów kluczowych zwiastuna, których oczekuje, i zgłasza uszkodzoną tablicę odsyłaczy albo po prostu odmawia otwarcia pliku. Jeśli twoje wyjście płynie do starzejącej się bramki faksowej, drukarki sprzętowej z wbudowanym interpreterem albo parsera, który ktoś napisał pod specyfikację 1.4 dekadę temu, trzymaj obie flagi wyłączone dla tego kanału i pogódź się z większym plikiem. Dla składowania archiwalnego i dostarczania przez sieć, gdzie każda główna przeglądarka czyta PDF 1.5 od dwudziestu lat, ich włączenie to kompresja niemal za darmo
Jest jeszcze efekt drugiego rzędu, o którym warto powiedzieć zespołowi wsparcia. Gdy słowniki zostaną upakowane w strumienie obiektów, porównywanie dwóch wygenerowanych plików bajt po bajcie przestaje cokolwiek znaczyć, ponieważ zmiana jednego pola potrafi ponownie skompresować cały kontener i przetasować wszystko po nim. Porównuj takie pliki po treści obiektów, a nie porównaniem binarnym
Aktualizacje przyrostowe i przesunięcia bajtowe, które chronią
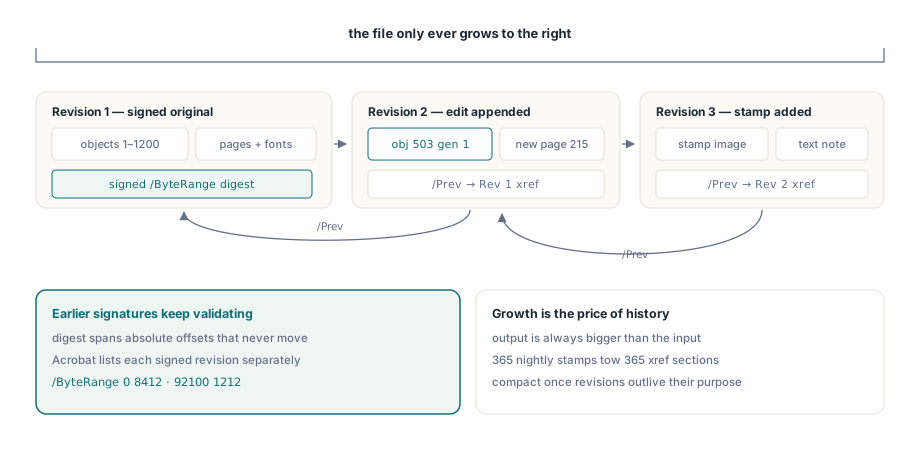
Podpis cyfrowy obejmuje jawny /ByteRange: dwa przedziały pliku fizycznego, podane jako bezwzględne przesunięcia bajtowe, z których wzięto skrót CMS. Przepisz plik, choćby na coś wyglądającego identycznie na ekranie, a wszystkie te przesunięcia się przesuną. Skrót przestaje pasować, a podpis czyta się jako zepsuty. To dokładnie ten problem, który ISO 32000-1 §7.5.6 rozwiązuje aktualizacjami przyrostowymi. Nowe i zmienione obiekty są dopisywane za istniejącym %%EOF, a potem zapisywana jest świeża sekcja odsyłaczy, której wpis /Prev wskazuje wstecz na poprzednią. Oryginalne bajty nigdy nie zostają naruszone, więc podpisana rewizja pozostaje weryfikowalna, a Acrobat może przedstawić każdą podpisaną rewizję osobno w panelu podpisów
HotPDF udostępnia to przez własny punkt wejścia:
Pdf.BeginIncrementalUpdate('contract-signed.pdf');
Pdf.AddPage;
Pdf.CurrentPage.SetFont('Arial', [], 10);
Pdf.CurrentPage.TextOut(50, 760, 0, 'Addendum recorded 2026-06-11');
Pdf.SaveIncrementalUpdate('contract-updated.pdf');  // dopisuje wyłącznie różnicę
Dwie rzeczy podkładają ludziom nogę. BeginIncrementalUpdate musi dostać nazwę oryginalnego pliku, ponieważ dopisywana sekcja xref zapisuje przesunięcia mające sens wyłącznie względem dokładnie tych oryginalnych bajtów; wskaż mu kopię przemianowaną albo zapisaną na nowo, a przesunięcia opisują plik, który już nie istnieje. A zapis jest z konstrukcji tylko dopisujący, więc wyjście jest zawsze większe od wejścia. Ten przyrost nie jest marnotrawstwem do wystrojenia. To ta sama właściwość, która pozostawia wcześniejsze podpisane rewizje nietknięte
Modyfikowanie wczytanego pliku idzie przez LoadFromFile
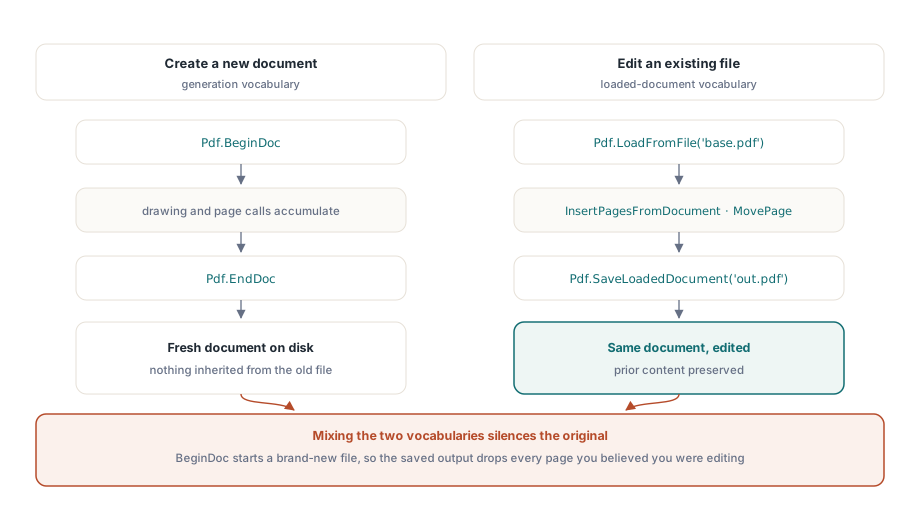
Programiści, którzy poznali HotPDF najpierw przez jego API generowania, wpadają zwykle na pewną ścianę. BeginDoc otwiera zupełnie nowy dokument, co jest złym narzędziem, gdy zamierzasz zmienić dokument już istniejący. Edycja istniejącego pliku biegnie zamiast tego przez wywołania wczytanego dokumentu:
PageCount := Pdf.LoadFromFile('base.pdf');
Pdf.InsertPagesFromDocument(OtherDoc, '1-3', 5);  // strony 1-3 po stronie 5
Pdf.MovePage(2, 5);
Pdf.SaveLoadedDocument('modified.pdf');
Pomieszaj te dwa światy, a objawem będzie plik wyjściowy zawierający twoją nową treść i nic z oryginału, ponieważ BeginDoc ochoczo zbudował świeży dokument obok tego, który myślałeś, że edytujesz. Czytaj LoadFromFile z SaveLoadedDocument jako jedno słownictwo, a BeginDoc z EndDoc jako drugie. Procedura sięgająca po oba wobec tego samego pliku jest niemal zawsze błędna
Kiedy zagęścić dopisywany plik
Zapisywanie tylko przez dopisywanie niesie powolny koszt. Nocne zadanie stemplujące jeden wiersz statusu na tym samym pliku PDF produkuje 365 rewizji w ciągu roku, a każda rewizja ciągnie za sobą nową sekcję xref. Gdy ta historia przeżyje swoją użyteczność i żaden podpis w pliku nie musi przetrwać, możesz spłaszczyć całość, serializując ją ponownie ścieżką wczytanego dokumentu:
Pdf.LoadFromFile('stamped.pdf');
Pdf.SaveLoadedDocument('compacted.pdf');
Ten ponowny zapis jest pełnym przepisaniem. Celowo wyrzuca wcześniejsze rewizje i psuje każdy podpis wciąż obecny w pliku, więc postaw go za tą samą bramką polityki, którą stosujesz do każdego innego kroku destrukcyjnego. Jedna produkcyjna zasada, która się broni: zagęszczaj, gdy liczba rewizji przekroczy próg albo gdy dopisany narzut urośnie ponad jakiś udział pliku bazowego, i nigdy nie zagęszczaj dokumentu, którego panel podpisów ma cokolwiek w środku
Sprawdzanie wyjścia, zanim ruszy w świat
Weryfikacja tej pary funkcji jest przyjemnie konkretna. Otwórz wynik w Adobe Acrobat i potwierdź trzy punkty: właściwości dokumentu zgłaszają PDF 1.5 albo nowszy, gdy strumienie obiektów są włączone; panel podpisów nadal waliduje każdą wcześniej podpisaną rewizję po aktualizacji przyrostowej; a liczba stron i zakładki przeszły cykl wczytania, modyfikacji i zapisu bez uszczerbku. Dla wyjścia archiwalnego przepchnij plik dodatkowo przez veraPDF, ponieważ skompresowany xref to dokładnie ten rodzaj struktury, któremu ścisły walidator przygląda się uważniej, niż kiedykolwiek przyjrzy się wyrozumiała przeglądarka. Jeśli twoja praca obejmuje też bardzo duże wejścia, metody inspekcji z naszego omówienia Direct File API dla procesów z dużymi plikami PDF naturalnie łączą się z zapisem przyrostowym, a mechanika podpisów stojąca za powyższymi zakresami bajtów jest dogłębnie opisana w artykule o podpisach cyfrowych i PAdES w HotPDF
Obie funkcje są dostarczane jako część komponentu HotPDF dla Delphi oraz C++Builder, obok API generowania, formularzy, szyfrowania i podpisywania omawianych gdzie indziej na tym blogu. Strona produktu linkuje pełne odniesienie do API, jeśli chcesz zestawić powyższe wywołania z własnym potokiem dokumentów