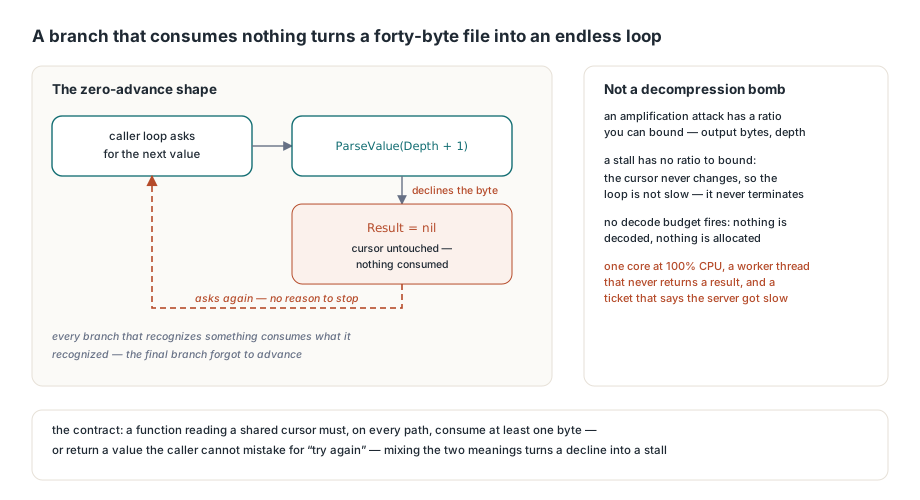
Parser zawiesza się na uszkodzonym PDF-ie, gdy jakaś gałąź odczyta bajt, odmówi jego obsługi i wróci bez przesunięcia kursora. Pętla wywołująca nie widzi postępu ani powodu do zatrzymania, więc kręci się w nieskończoność. HotPDF dostarczył dokładnie ten defekt w trzech niezależnych parserach, wszystkie osiągalne z wejść poniżej pięćdziesięciu bajtów
To klasa ataków denial-of-service, którą warto nazwać osobno, bo nie wygląda jak ta, przed którą wszyscy już się zabezpieczają. Nie ma dekompresji, nie ma wzrostu alokacji, nie ma presji na pamięć, która uruchomiłaby watchdog. Proces po prostu siedzi na stu procentach jednego rdzenia z garścią bajtów w buforze. Jeśli dodałeś budżet dekodowania po lekturze o amplifikacji zagnieżdżonych filtrów i bombach PDF, tu on nie zadziała: nic nie jest dekodowane i nic nie jest alokowane. Inna awaria, inna poprawka
Dlaczego czterdziestobajtowy plik kosztuje więcej niż bomba dekompresyjna?
Bo koszt w ogóle nie zależy od rozmiaru wejścia. Atak amplifikacyjny ma współczynnik, który da się ograniczyć: cap na bajty wyjścia, cap na głębokość rekurencji, a najgorszy przypadek staje się skończony. Pętla zerowego postępu nie ma żadnego współczynnika do ograniczenia. Warunek pętli jest funkcją kursora, który się nigdy nie zmienia, więc to nie jest wolne działanie, tylko brak terminacji, i żaden limit rozmiaru po stronie wywołującej tego nie złapie. To czyni go też wyjątkowo paskudnym operacyjnie. Crash daje ci stack trace, brak pamięci daje wpis w logu, a zablokowany parser daje wątek roboczy, który nigdy nie zwraca wyniku, żądanie, które nigdy nie dostaje timeoutu, bo nikt niżej nie wie, że się w ogóle zaczęło, i ticket, że we wtorek serwer nagle zwolnił. Przyczyna strukturalna ma zawsze ten sam kształt. Tokenizator lub parser wartości ma łańcuch gałęzi kluczowany bieżącym bajtem. Każda gałąź, która coś rozpoznaje, konsumuje to, co rozpoznała. Potem jest gałąź końcowa albo strażnik przed łańcuchem, który zwraca wartość dla bajtów, których nikt nie zaadoptował, a autor traktuje go jako ścieżkę błędu, nie jako krok skanowania. Ścieżki błędów zwracają. Kroki skanowania przesuwają kursor. Gdy jedna funkcja musi być jednym i drugim, to właśnie przesunięcie zostaje zapomniane
Parser obiektów: dwa ograniczniki, których nikt nie skonsumował
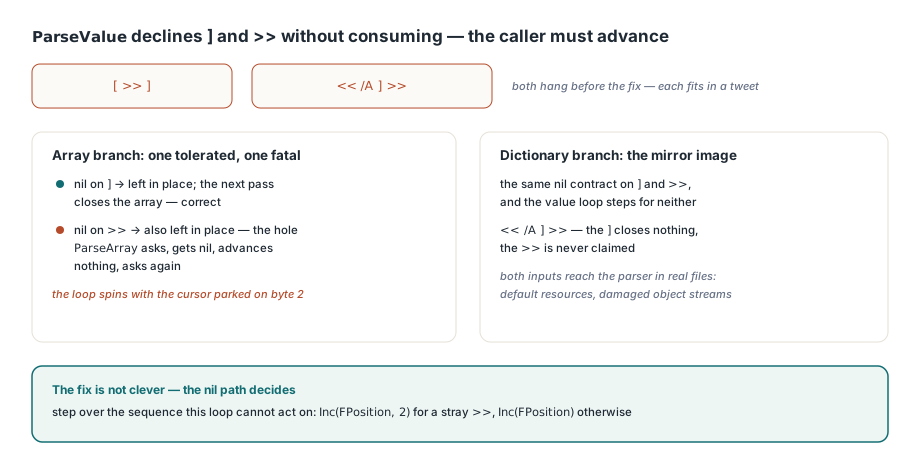
W HPDFParser metoda THPDFSpanObjectParser.ParseValue na starcie odrzuca dwie sekwencje bajtów. Zgodnie z sekcją 7.3 normy ISO 32000-1 wartość nie może zaczynać się od ] ani >>, bo to zamyka kontener zamiast otwierać wartość, więc ParseValue zwraca nil dla obu bez ich konsumowania. To poprawny kontrakt i cały ciężar przesuwania spada na wywołującego. Gałąź tablicy wypełniła połowę zobowiązania: przy wyniku nil sprawdzała ], zostawiała go na miejscu, żeby następny przebieg zamknął tablicę, i przeskakiwała wszystko inne — z tym że sprawdzenie było napisane tak, że zbłąkane >> też zostawało na miejscu. Więc [ >> ] wisi, bo ParseArray prosi o wartość, dostaje nil, nie przesuwa niczego i pyta dalej. Gałąź słownika miała lustrzaną dziurę i << /A ] >> wisi tak samo. Oba wejścia są na tyle poprawne, żeby dotrzeć do parsera, i na tyle krótkie, żeby zmieścić się w jednym tweecie
uses
  HPDFObjs, HPDFParser;

procedure ProbeParserStalls;
var
  Stats: THPDFParserViewStatistics;
  Arr: THPDFArrayObject;
  Dict: THPDFDictionaryObject;
begin
  // Przed poprawką żadne z poniższych wywołań nie zwracało sterowania
  Arr := HPDFParserParseSimpleArrayWithStatistics('[ >> ]', Stats);
  Arr.Free;
  WriteLn('array errors=', Stats.ErrorCount, ' valid=', Stats.Valid);

  Dict := HPDFParserParseSimpleDictionaryWithStatistics('<< /A ] >>', Stats);
  Dict.Free;
  WriteLn('dict errors=', Stats.ErrorCount, ' valid=', Stats.Valid);
end;
Poprawka nie jest sprytna i o to chodzi: ścieżka nil musi wprost zdecydować, na którą z dwóch nieskonsumowanych sekwencji bieżąca pętla potrafi zareagować, i przeskoczyć tę drugą
Value := ParseValue(Depth + 1);
if Value = nil then
begin
  RecordError;
  // ParseValue zwraca nil zarówno dla ']', jak i '>>', nie konsumując
  // ich. ']' kończy tablicę przy następnym przebiegu, ale samotny '>>'
  // wewnątrz tablicy trzeba pominąć, bo inaczej parsowanie nigdy nie ruszy dalej
  if (FPosition < FLength) and StartsWithPair('>', '>') then
    Inc(FPosition, 2)
  else if (FPosition < FLength) and (CharAt(FPosition) <> ']') then
    Inc(FPosition);
  Continue;
end;
Jeszcze jedna rzecz zasługuje tu na uwagę. THPDFSpanObjectParser.RecordError tylko zwiększa ErrorCount w THPDFParserViewStatistics; niczego nie ogranicza. Parser ustawia HPDFParserMaximumDepth na 64, żeby obciąć zagnieżdżanie, ale nie ma odpowiednika sufitu na liczbę błędów, a licznik, którego nikt nigdy nie czyta, to przepuszczony wyłącznik awaryjny. Nawet po przywróceniu przesuwania wejście produkujące jeden błąd na bajt przegryzie duży obiekt w tempie, które zasługuje na wcześniejsze wyjście zamiast pełnego przejścia. Sprawdzaj Valid na rekordzie statystyk po każdym parsowaniu i traktuj duży ErrorCount jako powód, żeby przestać ufać obiektowi, a nie tylko jako diagnostykę
Ten sam kształt w tokenizatorze CMap i czytniku XFDF
HPDFCMapReader.NextToken niósł identyczny defekt w gałęzi awaryjnej. Funkcja zwraca TCMapTok i obsługuje <, ( i / w dedykowanych gałęziach; wszystko inne spada do „czytaj do białego znaku lub ogranicznika". Gdy bajt startowy sam jest ogranicznikiem ze zbioru z sekcji 7.2.2 normy ISO 32000-1, ta pętla wykonuje się zero razy, token wraca pusty, a wywołujący prosi o ten sam token ponownie. Z sześciu znaków, które mogą tam trafić, tylko [ był wcześniej przechwytywany przez obsługę bfrange, więc zbłąkane ), >, ], { lub } gdziekolwiek w CMap ToUnicode wystarczało, żeby zablokować ekstrakcję tekstu
// keyword lub liczba: czytaj aż do białego znaku lub delimitera
StartP := P;
while (P <= Len) and (not IsCMapWhiteSpace(Text[P]))
  and (not IsCMapDelimiter(Text[P])) do
  Inc(P);
// Delimiter, którego nie obsługuje żadna z powyższych gałęzi (samotny ')', '>',
// '[', ']', '{' lub '}'), zostawiłby P w miejscu i zwrócił
// pusty keyword, więc wywołujący prosiłby o ten sam token w nieskończoność
if P = StartP then
  Inc(P);
AKeyword := Copy(Text, StartP, P - StartP);
Result := ctKeyword;
Strona XFDF miała wariant o innym pochodzeniu i tym samym efekcie. HPDFXFDFXml.ParseElement na początku ustawia Result := P, gdy P wciąż wskazuje otwierający <, i dopiero potem zwiększa lokalny kursor, więc każde wcześniejsze wyjście zwraca pozycję wejścia, chyba że najpierw nadpisze Result. Deklaracja doctype według sekcji 2.8 XML 1.0 albo cokolwiek innego bez parsowalnej nazwy tagu, jak <1a>, szło wyjściem, które nigdy nie aktualizowało Result, i pętla elementów potomnych dostawała tę samą pozycję, którą sama przekazała. Pętla atrybutów miała trzy kolejne takie miejsca, bo ReadName, pomijanie białych znaków i obsługa = odrzucają bajt, który nie jest znakiem nazwy, białym znakiem ani jednym z =, >, /, i żadna z nich go nie konsumowała. Sąsiednia naprawa CDATA przenosiła odpowiedzialność zamiast dodawać strażnika: sekcja CDATA według sekcji 2.7 XML 1.0 zaczyna się od <, więc pętla potomna przekazywała ją do ParseElement, który potem czytał nazwę tagu z zawartości sekcji. Rozpoznanie jej w pętli potomnej przez IsCDATAStart i kopiowanie bajtów do bufora tekstu aż do IsCDATAEnd to poprawny podział, a stary skip był też o jeden bajt za krótki, bo marker liczy osiem bajtów od !
Zadeklarowane liczniki, które przeżywają dane
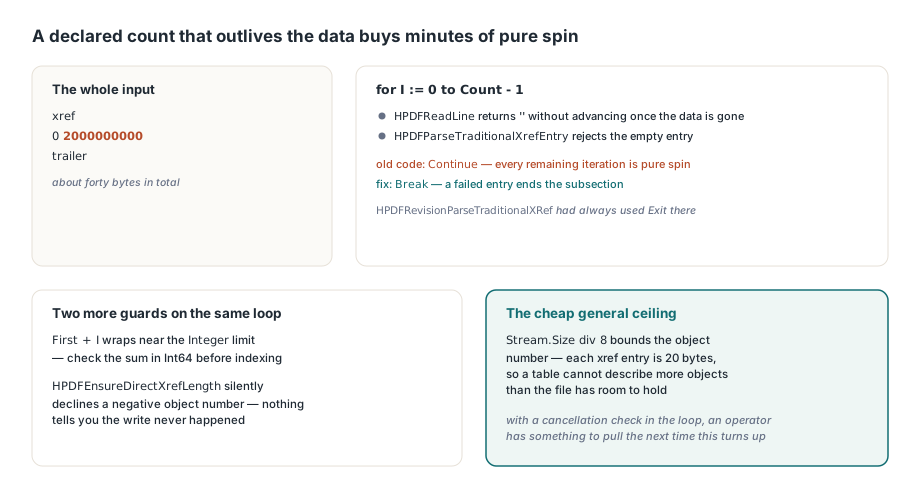
Późniejsza wersja ujawniła ten sam wzorzec z drugiej strony, i to jest wariant najprawdopodobniej obecny w twoim własnym kodzie. Nagłówek podsekcji cross-reference według sekcji 7.5.4 normy ISO 32000-1 to para first count, a oba parsery klasycznego xref w HotPDF kręciły po nim pętlą for I := 0 to Count - 1, używając Continue zamiast Break, gdy wpis się nie parsował. To wygląda jak tolerancja na jedną złą linię. Nie jest: HPDFReadLine zwraca pusty string bez przesuwania, gdy dane się skończą, a HPDFParseTraditionalXrefEntry natychmiast odrzuca pusty wpis, więc każda pozostała iteracja zadeklarowanego licznika to czysty spin. Arytmetyka jest bezlitosna — nagłówek xref\n0 2000000000\ntrailer plus minimalna otoczka to około czterdziestu bajtów, a kupuje dziesiątki sekund obciążonego rdzenia bez żadnego sprawdzania anulowania w pętli. Trop siedział w tym samym unicie, bo HPDFRevisionParseTraditionalXRef zawsze używał w tym miejscu Exit. Gdy dwie funkcje parsują tę samą gramatykę i nie zgadzają się co do tego, czy nieudany wpis kończy podsekcję, jedna z nich jest forkiem, który przestał dostawać poprawki — ten sam sygnał, który widać w obsłudze hybrydowego cross-reference, gdzie klasyczna tabela i strumień opisują te same obiekty
if not HPDFParseIntegerPair(Line, First, Count) then
  Exit;
for I := 0 to Count - 1 do
begin
  Entry := HPDFReadLine(XrefData, P);
  // W przeciwnym razie zadeklarowana liczba większa niż rozmiar tabeli zapętliłaby się w nieskończoność
  // tu, bez danych do odczytania
  if not HPDFParseTraditionalXrefEntry(Entry, EntryOffset, GenNum, InUse) then
    Break;
  // Pierwsza pochodzi z nagłówka podsekcji, więc suma zawija się dla
  // zadeklarowanego początku blisko limitu Integer, a funkcja powiększania
  // silently refuses a negative index
  if (First < 0) or (Int64(First) + I > MaxInt) then
    Break;
  ObjNumber := First + I;
  if (ObjNumber < 0) or (Int64(ObjNumber) > Stream.Size div 8) then
    Break;
  HPDFEnsureDirectXrefLength(State, ObjNumber);
  // ... zapisz wpis ...
end;
Oba ograniczenia za Break należą do tej samej naprawy. HPDFEnsureDirectXrefLength odmawia rozszerzenia tablicy dla ujemnego numeru obiektu i nic o tym nie mówi, a First + I zawija się przy zadeklarowanym starcie blisko limitu Integer, więc ujemny indeks dociera do zapisów poniżej. Sufit na numer obiektu Stream.Size div 8 to tania, ogólna odpowiedź, bo żadna klasyczna tabela cross-reference nie może opisać więcej obiektów, niż plik ma miejsca, a każdy nagłówek twierdzący inaczej opisuje plik, który nie istnieje. Jeśli ręcznie naprawiasz uszkodzoną tabelę, ta sama logika działa z drugiej strony, a to teren opisany w notatkach o diagnozowaniu i naprawianiu ręcznie edytowanych plików PDF
Jak udowodnić, że poprawka na zawieszenie faktycznie działa?
Uruchamiając stary kod, nie czytając go ponownie. Zakleszczenie to jedna z niewielu klas defektów, w których poprawkę można zweryfikować sygnałem binarnym bez instrumentacji, bo proces albo wraca, albo nie, a rozumowanie o przepływie sterowania to dokładnie ta umiejętność, która wyprodukowała błąd w pierwszej kolejności. Mechanikę warto skopiować. Wyciągnij rewizję sprzed poprawki zmienianych unitów do katalogu scratch, a potem skompiluj jedną małą sondę ze ścieżką poszukiwań unitów ustawiającą ten katalog przed prawdziwą biblioteką: dcc32 -U<scratchdir>;<Lib> probe.dpr. Kompilator bierze stare źródła dla wszystkiego, co znajdzie pierwsze, i bieżące źródła dla reszty, więc jedna binarka sondy ćwiczy stary parser przeciw reszcie biblioteki. Uruchom ją pod timeoutem — czterdzieści sekund to hojnie — i traktuj kod wyjścia 124 jako asercję. Potem wycofuj unity z katalogu scratch pojedynczo i przebudowuj. Wszystkie trzy zakleszczenia odtworzyły się w ten sposób, każde przypisane konkretnemu unitowi, i wszystkie trzy zniknęły, gdy poprawione źródła wróciły na ścieżkę, kosztem jednej kompilacji na unit
Dwie pułapki warto znać, zanim spróbujesz. Ścieżka poszukiwań unitów jest po cichu pobłażliwa: podaj -U ścieżkę w stylu Unix z shella, jak $PWD, a kompilator zignoruje ten katalog bez słowa, co znaczy, że twoja sonda skompilowała się przeciw bieżącym źródłom i przeszła z niewłaściwego powodu. Najpierw przekonwertuj ścieżkę do natywnej formy Windows. Drugie: katalog scratch nie niesie plików include, więc potrzebujesz też -I<Lib> dla HotPDF.inc, inaczej build padnie w sposób wyglądający jak problem ze źródłami, nie ze ścieżką. I bądź szczery co do tego, czego metoda ci nie daje: potwierdza, że konkretne wejście przestało wisieć na konkretnym buildzie, i nie mówi nic o wejściach, których nie wymyśliłeś. Defekty zerowego postępu znajduje się fuzzingiem albo czytaniem każdej gałęzi każdego tokenizatora, nie testami regresyjnymi pisanymi po fakcie
Co audytować we własnych parserach
Wielokrotnego użytku reguła to kontrakt, nie pozycja z checklisty. Każda funkcja czytająca współdzielony kursor musi na każdej ścieżce, wliczając ścieżki błędów, albo skonsumować co najmniej jeden bajt, albo zwrócić wartość, której wywołujący nie pomyli z „spróbuj jeszcze raz". Zmieszanie tych dwóch znaczeń w jednym nilu albo jednym pustym tokenie to właśnie to, co zamienia odmowę w zakleszczenie. Audytuj kształt, nie symptom. Znajdź każdą pętlę, której terminacja zależy od kursora należącego do innej funkcji, i zapytaj, co się dzieje, gdy ta funkcja odrzuca bieżący bajt. Znajdź każdą gałąź awaryjną napisaną jako „czytaj do X" i zapytaj, co robi, gdy kursor już siedzi na X. Znajdź każdą pętlę ograniczoną licznikiem pochodzącym z pliku, nie z danych, i spraw, żeby nieudany element kończył pętlę zamiast pomijać iterację. Tam, gdzie ta sama gramatyka jest parsowana w dwóch miejscach, zrób diff, bo jedno z nich dostanie poprawkę, której drugie nie ma. I wstaw sprawdzanie anulowania do każdej pętli, która może działać przez liczbę iteracji podaną przez wywołującego, żeby operator miał co pociągnąć, gdy następny taki przypadek wyląduje w produkcji
Opisane tu parsery są dostępne w bieżącym HotPDF Delphi Component dla Delphi i C++Builder, z wystawionymi rekordami statystyk i limitami głębokości, żeby twoje własne utwardzanie mogło na nich budować