HotPDF potrafi zapisać wczytany dokument w formie diagnostycznej, zaprojektowanej do odczytu i edycji przez człowieka, a następnie naprawić plik po dokonaniu edycji. SaveLoadedDocumentDiagnostic zapisuje dokument z deterministycznym porządkiem kluczy słownika, gdzie każdy obiekt jest zwykłym obiektem pośrednim, bez strumieni obiektów, bez strumienia odsyłaczy krzyżowych i bez linearyzacji. RepairDiagnosticDocument odbudowuje następnie przesunięcia bajtowe, długości strumieni, tabelę odsyłaczy krzyżowych i trailer, które twoja edycja unieważniła
Ta para funkcji istnieje dla jednego przepływu pracy: zrozumienia lub naprawienia tego, co naprawdę znajduje się wewnątrz PDF. Każdy programista, który debugował problem z renderowaniem, chciał otworzyć plik, zmienić jedną liczbę w jednym słowniku i zobaczyć wynik. W zwykłym PDF jest to niemożliwe, ponieważ treść jest skompresowana w strumienie obiektów, a każdy wstawiony bajt przesuwa przesunięcia, które tabela odsyłaczy krzyżowych rejestruje z dokładnością co do bajtu
Co odróżnia zapis diagnostyczny?
Sześć ustawień zmienia się razem. Klucze słowników są zapisywane w deterministycznej kolejności, więc dwa zapisy tego samego dokumentu dają porównywalne pliki. Tryb wyjścia diagnostycznego opisuje strukturę adnotacjami. Wymuszony jest pełny ponowny zapis, więc nic nie jest przenoszone jako nietknięta rewizja przyrostowa. Linearyzacja jest wyłączona, ponieważ zlinearyzowany plik jest zorganizowany z myślą o przeglądarce internetowej, a nie o czytelniku. Strumienie odsyłaczy krzyżowych są wyłączone, więc tabela jest zwykłym tekstem. A strumienie obiektów są wyłączone, więc żaden obiekt nie jest ukryty wewnątrz skompresowanego kontenera
Wynikiem jest plik, którego nagłówek niesie znacznik diagnostyczny obok zwykłej sygnatury %PDF-, a którego treść można przeglądać w dowolnym edytorze. Obiekty pojawiają się jeden po drugim, słowniki są czytelne, a strumienie treści znajdują się tam, gdzie można je znaleźć. Narzędzie naprawcze sprawdza obecność tego znacznika i odrzuca pliki, które go nie mają, ponieważ zwarta struktura zwykłego PDF nie jest czymś, co powinien próbować interpretować naprawiacz działający na zakresach bajtów

uses
  HPDFDoc;

var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoice.pdf') <= 0 then
      Exit;
    // Czytelny, jeden obiekt na blok, nic ukrytego w strumieniach obiektów
    Pdf.SaveLoadedDocumentDiagnostic('invoice-diagnostic.pdf');
  finally
    Pdf.Free;
  end;
end;
Dlaczego edycja psuje plik i co trzeba odbudować?
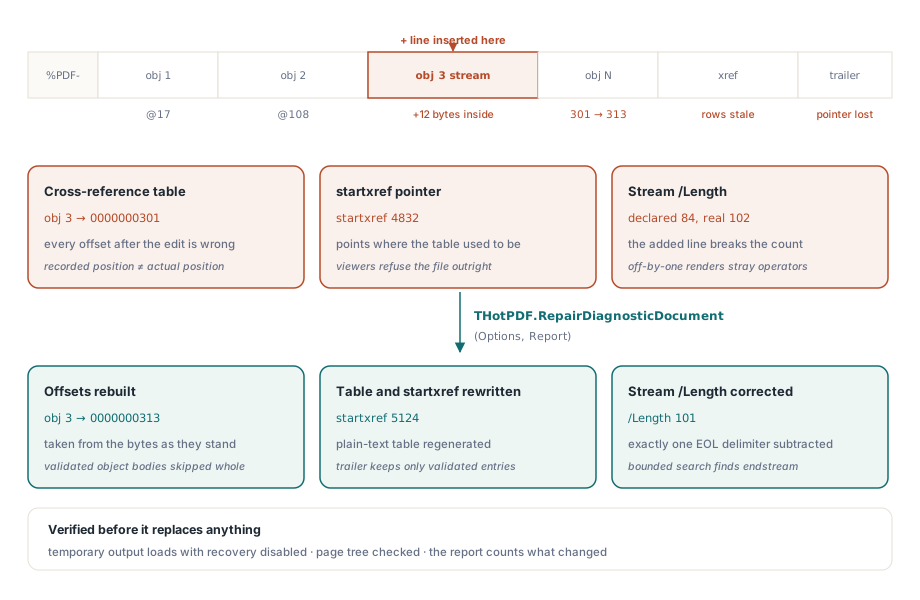
Trzy elementy w PDF kodują pozycje bajtowe lub liczby bajtów. Tabela odsyłaczy krzyżowych mapuje każdy numer obiektu na przesunięcie bajtowe. Wartość startxref na końcu pliku wskazuje tę tabelę. A każdy słownik strumienia niesie /Length, mówiące, ile bajtów zajmuje treść strumienia
Zmień jeden znak w dowolnym miejscu przed końcem pliku, a przesunięcia następujące po nim staną się błędne. Dodaj linię do strumienia treści, a jego /Length również będzie błędne. Większość przeglądarek odrzuci taki plik, a te, które go odzyskują, robią to przez skanowanie, co raczej ukrywa błąd, niż go naprawia. Naprawa odbudowuje wszystkie trzy elementy na podstawie tego, co bajty faktycznie teraz mówią
var
  Options: THPDFDiagnosticRepairOptions;
  Report: THPDFDiagnosticRepairReport;
begin
  Options := THPDFDiagnosticRepairOptions.Default;
  Options.VerifyOutput := True;         // wczytaj wynik przed zastąpieniem

  if THotPDF.RepairDiagnosticDocument('invoice-diagnostic.pdf',
       'invoice-fixed.pdf', Options, Report) then
    Writeln(Format('%d objects, %d streams, %d lengths corrected, ' +
      '%d xref rows rebuilt, %d pages verified',
      [Report.ObjectCount, Report.StreamCount,
       Report.RepairedStreamLengthCount, Report.RebuiltXRefEntryCount,
       Report.VerifiedPageCount]))
  else
    Writeln(Format('repair failed (%d): %s',
      [Ord(Report.Status), string(Report.Diagnostic)]));
end;
Kopiuj bajty, nie serializuj ponownie
Decyzją projektową, która czyni to narzędzie godnym zaufania, jest to, że nigdy nie wczytuje ono dokumentu, by zapisać go ponownie od zera. Kopiuje zakresy bajtów obiektów, które zwalidowało, zmienia tylko błędne wartości /Length i odbudowuje wokół nich tabelę, trailer i startxref
Wczytanie i ponowna serializacja byłyby dużo prostsze do zaimplementowania, ale po cichu zmieniałyby rzeczy. Nieznana składnia obiektów zostałaby znormalizowana, sekwencje ucieczki w łańcuchach zostałyby przepisane w formie preferowanej przez zapisujący, a już zakodowane ładunki strumieni mogłyby zostać przekodowane. Dla narzędzia diagnostycznego jest to nie do przyjęcia: zmieniłeś jedną liczbę, więc diff powinien pokazać jedną liczbę, a nie tysiąc przypadkowych zmian formatowania. Jeśli chcesz wiedzieć dokładnie, co zmieniło się między dwoma plikami, to jest problem porównania, opisany w porównywaniu dwóch plików PDF pod względem struktury i pikseli

Dwie reguły parsowania zapobiegające fałszywym obiektom
Skaner działający na zakresach bajtów napotyka oczywistą pułapkę: tekst wyglądający jak nagłówek obiektu może pojawić się wewnątrz ładunku strumienia albo wewnątrz łańcucha znaków. Naiwne skanowanie wygenerowałoby wiersz odsyłacza krzyżowego wskazujący na środek strumienia treści, a wynikowy plik byłby uszkodzony w nowy, jeszcze bardziej mylący sposób
HotPDF unika tego, pomijając cały zakres bajtów każdego zwalidowanego obiektu, korzystając z jego zarejestrowanego przesunięcia końcowego, dzięki czemu nic wewnątrz treści obiektu nigdy nie jest brane pod uwagę jako kandydat. Między obiektami dozwolone są tylko białe znaki PDF i komentarze; wszystko inne oznacza, że region nie został zrozumiany i jego bajty nie mogą trafić do wyniku
Długości strumieni wymagają równie dużej ostrożności. Rzeczywista długość ładunku wyklucza znak końca linii, który zapisujący wstawia przed endstream. Gdy zadeklarowana długość trafia dokładnie na znacznik, deklaracja jest akceptowana. Gdy tak się nie dzieje, naprawiacz wykonuje ograniczone przeszukiwanie w poszukiwaniu pary endstream i endobj i odejmuje dokładnie jeden ogranicznik: CR, LF albo CRLF. Pomylenie się tutaj o jeden bajt daje plik, który otwiera się i renderuje stronę z jednym zabłąkanym operatorem na końcu swojego strumienia treści
Co trailer może zachować
Odbudowany trailer nie jest kopią starego. /Size, /Prev i /XRefStm opisują poprzedni układ pliku i są ponownie obliczane albo odrzucane. Przetrwają wyłącznie wpisy, których cele zostały zwalidowane: /Info, /ID i /Encrypt. A /Root musi wskazywać dokładnie jeden obiekt Catalog — nie zero i nie kilka, co zwykle jest efektem pliku złożonego przez kopiowanie i wklejanie bloków obiektów
Bezpieczeństwo wyjścia jest obsłużone tak, jak powinno być w narzędziu działającym na plikach, na których ludziom zależy. Wynik jest zapisywany do pliku tymczasowego w katalogu docelowym, a następnie weryfikowany przez wczytanie go zwykłą ścieżką z wyłączonym odzyskiwaniem odsyłaczy krzyżowych, więc plik, który otwiera się tylko dzięki odzyskiwaniu, liczy się jako niepowodzenie. Dopiero po zweryfikowaniu drzewa stron plik tymczasowy atomowo zastępuje plik docelowy. Nieudana naprawa nigdy nie nadpisuje istniejącego wyniku
Limity i uczciwe kody błędów
Trzy limity ograniczają pracę: bajty wejściowe, liczbę obiektów kandydujących i maksymalny numer obiektu, domyślnie 8 GiB, dwa miliony i dwa miliony. Limit numeru obiektu ma większe znaczenie, niż mogłoby się wydawać, ponieważ rzadka tabela z kilkoma obiektami ponumerowanymi w miliardach w przeciwnym razie ogromnie rozdęłaby odbudowaną tabelę odsyłaczy krzyżowych. Klasyczne tabele odsyłaczy krzyżowych odrzucają też przesunięcia wymagające więcej niż dziesięciu cyfr dziesiętnych, co jest ograniczeniem formatu, a nie wyborem implementacyjnym
Niepowodzenia zgłaszają konkretny status, a nie wartość logiczną: nieprawidłowe argumenty, źródło zbyt duże, plik nie jest plikiem diagnostycznym, przekroczony limit obiektów, nieprawidłowy obiekt, zduplikowany obiekt, brakujący katalog, nieprawidłowy trailer, błąd wyjścia lub niepowodzenie walidacji. Każdy odpowiada innej poprawce. Zduplikowany obiekt oznacza, że wkleiłeś blok obiektu dwukrotnie. Brakujący katalog zwykle oznacza, że obiekt niosący /Type /Catalog został uszkodzony. Niepowodzenie walidacji oznacza, że struktura jest teraz spójna, ale drzewo stron się nie wczytuje, co zwykle jest efektem tablicy /Kids zedytowanej niezgodnie z jej /Count
Dwie praktyczne uwagi zamykają temat. Zachowaj plik diagnostyczny, nie tylko naprawiony, aby kolejna edycja zaczynała się od czytelnej podstawy. I nie wysyłaj wyjścia diagnostycznego do użytkowników końcowych: jest ono większe niż zwykły zapis, ponieważ nic nie jest skompresowane w strumienie obiektów, a produkcyjną ścieżką dla zwartego pliku jest zwykła ścieżka zapisu opisana w strumieniach obiektów i aktualizacjach przyrostowych. Gdy celem jest znalezienie błędu, a nie jego zmiana, zautomatyzowana ścieżka w automatyzacji raportów preflight daje odpowiedź szybciej niż czytanie bajtów
Zapis diagnostyczny, naprawa, preflight i porównywanie działają na tym samym modelu wczytanego dokumentu w Delphi i C++Builder; pełną listę funkcji znajdziesz na stronie komponentu HotPDF PDF dla Delphi