Dwa PDF-y wyprodukowane przez ten sam generator raportów z tych samych danych, jedna runda apart, rzadko zgadzają się bajt w bajt. Binarny diff rozświetla tabelę odniesień krzyżowych, numery obiektów i często programy fontów, podczas gdy oba pliki drukują dokładnie te same strony. Porównanie wyrenderowanych pikseli wygląda jak lekarstwo, dopóki ktoś nie doda strony tytułowej: od tej chwili każda strona siedzi jedną pozycję dalej niż jej odpowiedniczka, a pikselowy sprawdzian strona po stronie raportuje cały dokument jako zmieniony. Porównanie warte automatyzacji musi odpowiedzieć na dwa różne pytania — co zmieniło się wewnątrz pliku i czy czytelnik by to zobaczył — i musi wiedzieć, która strona jednego pliku odpowiada której stronie drugiego
Dlaczego dwa wyglądające identycznie PDF-y różnią się bajt w bajt?
Większość bajtowego szumu pochodzi z rozliczeń, których czytelnik nigdy nie widzi. Numery obiektów są rozdawane w takiej kolejności, w jakiej piszący akurat emituje obiekty. Wiele generatorów buduje podzbiory fontów w kolejności pierwszego użycia glifów, więc nieco inne przejście produkuje inne kody glifów, a więc i inne bajty strumienia treści, dla tego samego widocznego tekstu. Offsety odniesień krzyżowych przesuwają się za każdym razem, gdy cokolwiek wcześniej w pliku zmienia długość, co dzieje się prawie zawsze
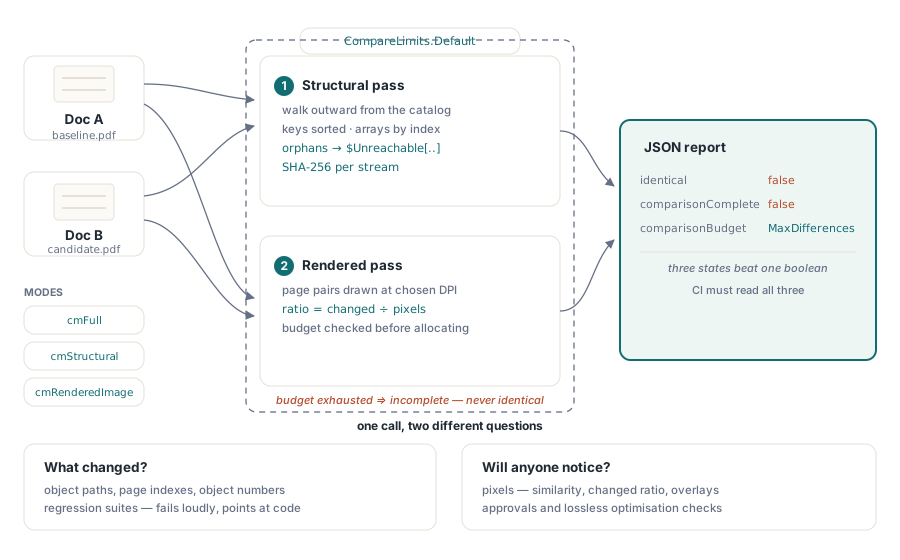
Numery obiektów są więc bezużyteczne jako tożsamość między dwoma plikami. THPDFDocComparison w HotPDF nazywa każdy obiekt ścieżką, która pierwszy dochodzi do niego w przejściu wszerz od katalogu dokumentu. Klucze słowników są odwiedzane w kolejności bajtowej, a elementy tablic po indeksie, co czyni przejście deterministycznym: zasób fontu na pierwszej stronie kończy typowo jako coś w rodzaju $Catalog/Pages/Kids[0]/Resources/Font/F1 w obu plikach, cokolwiek za numer obiektu dał mu każdy generator. Nietypowe bajty w kluczu są escapowane jako #xx, a ścieżka dłuższa niż MaxPathBytes jest ucinana i kończona haszem pełnej ścieżki, więc dwie długie ścieżki dzielące prefiks pozostają rozróżnialne
Każdy obiekt dostaje potem sygnaturę SHA-256 nad własną zawartością. Referencja pośrednia wnosi tylko fakt, że referencja tam siedzi — nigdy numer obiektu, na który wskazuje — a cel jest kolejkowany do osobnego podpisania. Przenumerowanie każdego obiektu w pliku nie produkuje więc żadnych różnic. A gdy jeden słownik fontu się zmieni, raport nazywa ścieżkę tego fontu jako objectChanged zamiast flagować stronę, słownik zasobów i drzewo stron nad nim. Obiekt, którego sygnatura pasuje, ale ścieżka się przesunęła (strona przeniesiona do innej gałęzi drzewa stron, powiedzmy), pokazuje się jako objectMoved; reszta to objectInserted albo objectDeleted
Obiekty, do których żadna ścieżka od katalogu nie dociera, są nadal podpisywane — pod syntetyczną ścieżką jak $Unreachable[42:0], niosącej numer obiektu i generację. Osierocona treść to realna różnica między dwoma plikami, nawet jeśli żadna przeglądarka nigdy jej nie pokaże. Dane strumieni są hashowane w kawałkach po 64 KB prosto ze strumienia, a pozycja strumienia jest potem odkładana z powrotem, więc porównanie dwóch dużych plików nie znaczy trzymania kopii każdego strumienia w pamięci
Wyrównywanie stron, gdy w jednym dokumencie doszło do wstawienia
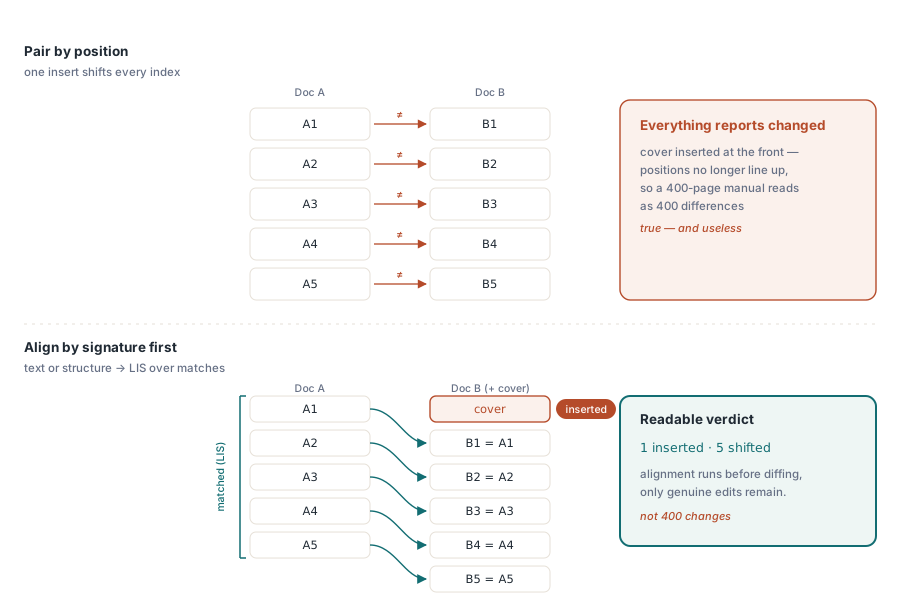
Parowanie strony 1 ze stroną 1 i strony 2 ze stroną 2 jest poprawne tylko do chwili, gdy coś zostanie wstawione. Ze świeżą okładką z przodu parowanie pozycyjne raportuje każdą stronę jako zmienioną — technicznie prawda, która recenzentowi nie mówi niczego
Każdy tryb oglądający strony wyrównuje je najpierw. Każda strona dostaje sygnaturę z wyekstrahowanego tekstu; strony bez tekstu do wyekstrahowania spadają do sygnatury słownika strony plus jej strumienia treści. Strony o dokładnie pasujących sygnaturach są parowane, a porównanie bierze potem najdłuższy rosnący podciąg tych par, uporządkowany ich pozycją w drugim pliku. Pary wewnątrz tego podciągu tylko się przesunęły razem z wstawieniem albo usunięciem. Pary poza nim naprawdę były przetasowane i raportowane są jako pageMoved. Cokolwiek, co w ogóle nie pasowało, jest parowane po kolei jako pageChanged, a każdy nadmiar staje się pageInserted albo pageDeleted. Dla 400-stronicowego podręcznika z jedną nową kartą tytułową wpisy na poziomie stron schodzą do pojedynczego pageInserted, tam gdzie parowanie pozycyjne wyprodukowałoby 400 zmian. Przebieg obiektowy działa po ścieżce, więc przesunięte obiekty stron typowo pojawiają się tam nadal jako objectMoved, a filtrowanie po polu type rozdziela je od prawdziwych edycji
Wyrównane pary dostają jedno sprawdzenie więcej w trybach strukturalnych. Słownik strony jest podpisywany drugi raz bez /Contents, /Resources i /Parent, i jeśli ta sygnatura się różni, para jest raportowana jako pageChanged ze szczegółem page metadata changed. To łapie stronę, której tekst jest identyczny, ale /MediaBox albo /Rotate się ruszył — zmianę, którą wyrównanie oparte tylko na tekście sparowałoby i przepuściło machnięciem ręki
Puszczanie porównania strukturalnego i czytanie werdyktu
Porównanie bierze dwie wczytane instancje THotPDF i tryb, po czym zwraca raport JSON jako AnsiString. cmStructural puszcza przejście obiektów i stron, cmRenderedImage puszcza przebieg pikselowy, cmFull puszcza oba, a cmPageCount, cmPageText i cmObjectCount to lżejsze kontrole do testów dymnych. Compare używa domyślnych limitów i opcji; CompareWithLimits i CompareWithOptions biorą twoje własne
uses
  Classes, SysUtils, HPDFDoc, HPDFDocCompare;

function CompareFiles(const BaselineFile, CandidateFile: string): AnsiString;
var
  DocA, DocB: THotPDF;
begin
  Result := '';
  DocA := THotPDF.Create(nil);
  DocB := THotPDF.Create(nil);
  try
    if (DocA.LoadFromFile(BaselineFile) <= 0) or
       (DocB.LoadFromFile(CandidateFile) <= 0) then
      raise Exception.Create('Could not load one of the files');
    Result := THPDFDocComparison.Compare(DocA, DocB, cmStructural);
    with TFileStream.Create('diff.json', fmCreate) do
    try
      if Result <> '' then
        WriteBuffer(Result[1], Length(Result));
    finally
      Free;
    end;
  finally
    DocB.Free;
    DocA.Free;
  end;
end;
Raport wozi trzy fakty najwyższego poziomu, które pojedynczy boolean rozmyłby w jedną plamę. identical jest prawdziwe tylko, gdy nie odnotowano żadnej różnicy i porównanie się skończyło. comparisonComplete mówi, czy się skończyło. differencesTruncated mówi, czy lista została ucięta, przy czym differenceCount trzyma prawdziwą sumę, a reportedDifferenceCount liczbę faktycznie wypisanych. Gdy przejście trafia w limit, wpis comparisonBudget w tablicy differences mówi, czy ucięto przejście stron, czy przejście obiektów
Kilka rzeczy ustawia comparisonComplete na false: ucięte przejście stron albo obiektów, referencja pośrednia, która nie rozwiązuje się w jednym z plików, więcej różnic niż pozwala MaxDifferences, strona, której struktury (albo, w cmPageText, tekstu) nie da się przeczytać, i niedokończony przebieg pikselowy. Każda z nich wymusza też identical na false; API nie raportuje równości z przejścia, które stanęło za wcześnie. Brama CI musi więc odróżniać dwa rodzaje porażki:
uses
  SysUtils, HPDFJobJSON;

// Zwraca True tylko dla zakończonego porównania bez różnic;
// w innym wypadku drukuje powód. Brama sama to twój kod
function DiffGatePasses(const Report: AnsiString): Boolean;
var
  Parser: THPDFJSONParser;
  Root, Diffs, Item: THPDFJSONValue;
  I: Integer;
begin
  Parser := THPDFJSONParser.Create(Report);
  try
    Root := Parser.Parse;
  finally
    Parser.Free;
  end;
  try
    Result := Root.GetBool('identical');
    if Result then
      Exit;
    if not Root.GetBool('comparisonComplete') then
      Writeln('INCOMPLETE: a limit or unreadable input stopped the comparison');
    Writeln(Format('%d difference(s), %d listed',
      [Root.GetInt('differenceCount'), Root.GetInt('reportedDifferenceCount')]));
    Diffs := Root.GetArr('differences');
    if Diffs <> nil then
      for I := 0 to Diffs.ItemCount - 1 do
      begin
        Item := Diffs.Item(I);
        Writeln(Item.GetStr('type'), '  ', Item.GetStr('detail'), '  ',
          Item.GetStr('pathA'), ' -> ', Item.GetStr('pathB'));
      end;
  finally
    Root.Free;
  end;
end;
Traktuj „niekompletne" jako osobny wynik budowania. Zadanie mapujące je na „różne" wysyła inżynierów na polowanie za regresją, która jest naprawdę zniekształconym wejściem albo limitem ustawionym za nisko, a zadanie mapujące je na „same" przepuszcza ucięte przejście przez wydanie
Co trzyma przejście w ryzach na plikach, których nie ty wyprodukowałeś?
THPDFStructuralCompareLimits.Default jest wymiarowany pod prawdziwe dokumenty: 250 000 obiektów, 2 000 000 śledzonych referencji, 250 000 stron, głębokość zagnieżdżenia 128, 10 000 wypisanych różnic, 64 MB odczytu z pojedynczego strumienia i 512 MB ze wszystkich strumieni razem, 1 MB na wartość łańcucha albo nazwy, 4 096 bajtów na ścieżkę i sufit 16 MB na zserializowany raport. Pole zerowe albo ujemne spada do swojego domyślnego, więc częściowo wypełniony rekord nigdy nie staje się nieograniczonym. Rekord wozi też CancellationToken i zdarzenie Checkpoint, które porównanie sprawdza między jednostkami pracy, łącznie w trakcie renderowania stron
uses
  SysUtils, HPDFDoc, HPDFDocCompare, HPDFTypes;

function CompareForRelease(DocA, DocB: THotPDF;
  Token: THPDFCancellationToken): AnsiString;
var
  Limits: THPDFStructuralCompareLimits;
  Options: THPDFRenderedCompareOptions;
begin
  Limits := THPDFStructuralCompareLimits.Default;
  Limits.MaxDifferences := 200;              // trzyma listing krótkim; differenceCount nadal liczy wszystkie
  Limits.MaxTotalStreamBytes := 128 * 1024 * 1024;
  Limits.CancellationToken := Token;         // inny wątek może zawołać Token.Cancel

  Options := THPDFRenderedCompareOptions.Default;
  Options.DPI := 150;                        // domyślnie 72
  Options.ColorSpace := rccLuminance;        // porównuj jasność, ignoruj przesunięcia tylko odcienia
  Options.ColorTolerance := 2;               // delty 1-2 poziomów nie są liczone
  Options.MinimumSimilarity := 0.9995;
  Options.MaxChangedPixelRatio := 0.0005;
  Options.GenerateHeatmaps := True;
  Options.HeatmapDirectory := 'diff-overlays';

  try
    Result := THPDFDocComparison.CompareWithOptions(DocA, DocB, cmFull,
      Limits, Options);
  except
    on EHPDFOperationCancelled do
      Result := '';                          // anulowane: nie ma raportu
  end;
end;
Anulowanie wypycha EHPDFOperationCancelled z wywołania zamiast zwracać częściowy raport. Anulowane porównanie nie ma raportu do oddania, i wyjątek jest tym, jak API to mówi. Opcje renderowania dostają tę samą normalizację co limity. DPI jest zaciśnięte do 2 400, ColorTolerance do 0–255, TileSize do 8–1 024, a próg podobieństwa albo proporcji poza 0–1 (albo NaN) po cichu wraca do domyślnego
Przebieg pikselowy szacuje rozmiar bitmapy każdej strony z jej wymiarów i żądanego DPI, zanim cokolwiek wyrenderuje, i sprawdza potem rzeczywistą bitmapę względem MaxPixelsPerPage jeszcze raz, więc strona z bzdurną geometrią nie przemyka obok szacunku. Koszt rośnie z kwadratem DPI. Dla dokumentu ze stron US Letter, 612 na 792 punkty, przy domyślnych 72 DPI każda para stron kosztuje około 0,97 miliona pikseli, a domyślne MaxTotalPixels równe 500 milionów pokrywa ponad 500 par. Przy 300 DPI pojedyncza para to około 16,8 miliona pikseli, a budżet wyczerpuje się po 29 parach. Przebieg odnotowuje wtedy wpis renderBudget, oznacza tę stronę jako budgetExceeded i staje, zostawiając renderComparisonComplete na false
Jak podobne jest wystarczająco podobne?
Przy opcjach domyślnych przebieg pikselowy żąda dokładnego dopasowania: ColorTolerance 0, MinimumSimilarity 1.0 i MaxChangedPixelRatio 0. Surowość na starcie trzyma decyzję o poluzowaniu jawną: ktoś musi ją zapisać, a potok powinien rozluźnić progi dopiero, gdy zobaczy, jak szum antyaliasingu wygląda w jego własnych renderach
Per piksel delta w trybie rccRGB to największa różnica wśród kanałów czerwonego, zielonego i niebieskiego; w trybie rccLuminance to różnica luminancji Rec. 709. Piksel liczy się jako zmieniony, gdy jego delta przekracza ColorTolerance. Liczba podobieństwa to wynik podobieństwa strukturalnego (SSIM) policzony nad luminancją całej strony naraz. Para jest similar tylko, gdy proporcja zmienionych pikseli jest na poziomie MaxChangedPixelRatio lub poniżej, a podobieństwo na poziomie MinimumSimilarity lub powyżej. Dwa progi, bo garść mocno złych pikseli w kodzie kreskowym i blade zabarwienie na całej stronie to różne porażki, i każdy przepływ pracy toleruje je inaczej. Sprawdziany progów używają wartości niezaokrąglonych; sześć miejsc po przecinku w JSON trzyma raporty stabilnymi od rundy do rundy
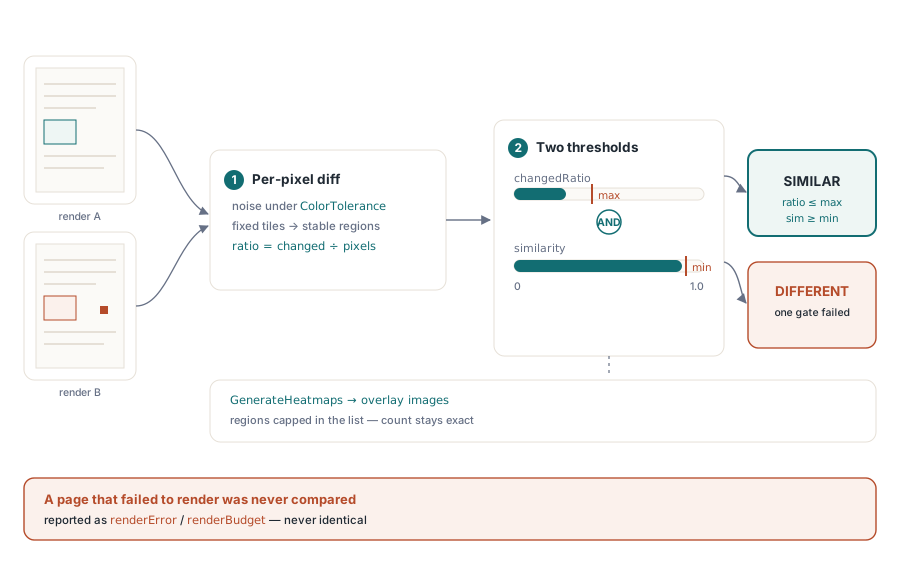
Zmienione piksele są grupowane w regiony na siatce kafelków o stałym rozmiarze — domyślnie 64 piksele w kwadrat — sklejanych przez czterech sąsiadów brzegowych. Każdy region w changedRegions podaje swoją ramkę otaczającą, liczbę zmienionych pikseli i największą deltę. Wypisanych jest najwyżej MaxChangedRegions (domyślnie 256); changedRegionCount nadal raportuje prawdziwą liczbę, a gdy lista jest ucięta, ustawiane jest changedRegionsTruncated, a przebieg pikselowy liczy się jako niekompletny. Przy włączonym GenerateHeatmaps każda strona ze zmienionymi pikselami dostaje PNG o nazwie jak page-000003-diff.png w HeatmapDirectory: strona z pierwszego pliku ze zmienionymi pikselami zabarwionymi od żółci (ledwo ponad tolerancję) do czerwieni (maksymalna delta), a jej ścieżka pojawia się w raporcie jako overlayPath
Porażki są raportowane, nigdy nie połykane. Wyjątek renderera, brakująca bitmapa albo zła wielkość strony stają się wpisem renderError z komunikatem, wpis strony dostaje status error, a renderComparisonComplete schodzi na false. Dwa rendery o różnych wymiarach pikselowych dostają status sizeMismatch i różnicę renderedImageSize wypisującą oba rozmiary. Strona, której nikt nie zdołał porównać, nigdy nie liczy się jako identyczna
Gdzie w potoku pasuje każdy tryb
Przebieg pikselowy paruje strony stricte po indeksie — strona i ze stroną i — do krótszego dokumentu. Wyrównanie stron chodzi w każdym trybie poza cmPageCount i cmRenderedImage. Z wstawioną okładką sam cmRenderedImage flaguje każdą stronę za nią, a cmFull daje ci wyrównanie ze swojej strukturalnej połówki obok tamtych pozycyjnych wyników pikselowych. Czytaj najpierw werdykt strukturalny i ufaj wynikom pikselowym tylko, gdy listy stron się układają
Puszczaj cmStructural przy każdej budowie. Jest tani, podaje ścieżkę, indeks strony i numery obiektów, których to dotyczy, a nieoczekiwany objectChanged wskazuje prosto na kod, który go wyprodukował. Trzymaj cmFull z mapami cieplnymi dla kandydatów wydawniczych i do sprawdzania, czy przebieg optymalizacji naprawdę był bezstratny — gdy ktoś jest pod ręką, by obejrzeć nakładki. cmPageText pasuje do dokumentów, gdzie liczy się tylko słowo. Recenzja na poziomie znaczników to inna opcja: eksport stron PDF do SVG daje tekstowy widok, który zwykłe narzędzia diff umieją przeczytać, a kontrole w automatyzacji raportów preflight pokrywają pytania o zgodność, na które żaden z trybów porównawczych nie zamierza odpowiadać
Porównanie, preflight i renderowanie pracują wszystkie na tym samym wczytanym dokumencie THotPDF, więc jedno wczytanie może obsłużyć wszystkie trzy. Wszystko, co komponent pokrywa dla deweloperów Delphi i C++Buildera, jest na stronie komponentu PDF HotPDF dla Delphi